
Atrex Kernel Agent (AKA): 프로덕션급 GPU 커널 개발을 위한 오케스트레이션 에이전트 시스템
요약
Atrex Kernel Agent (AKA)는 평가자가 소유한 연산자를 측정되고 최적화된 GPU 커널로 변환하는 오케스트레이션 에이전트 시스템입니다. AKA는 코딩, 프로파일링, 정확성 검사, 성능 검증 등 복잡한 과정을 감독자(supervisor)의 통제 하에 조정합니다. 이 시스템은 NVIDIA, AMD, T-Head PPU를 지원하며 다양한 코딩 에이전트를 백엔드로 통합하여 프로덕션급 GPU 커널 개발을 자동화합니다.
핵심 포인트
- GPU 커널 개발 전 과정을 오케스트레이션하는 에이전트 시스템입니다.
- 코딩, 검증, 성능 테스트 등 복잡한 단계를 감독자가 관리합니다.
- NVIDIA, AMD, T-Head PPU를 포함한 다양한 GPU 환경을 지원합니다.
- Claude, Codex 등 여러 코딩 에이전트를 백엔드로 통합하여 사용 가능합니다.
프로덕션급 GPU 커널 개발을 위한 오케스트레이션 에이전트 시스템
</div>개요 (Overview)
Atrex Kernel Agent (AKA)는 평가자(evaluator)가 소유한 연산자(operator)를 측정되고 최적화된 GPU 커널로 변환합니다. AKA는 코딩 에이전트, GPU 프로파일링, 정확성 검사, 성능 검증, Git 격리, 복구 및 최종 패키징을 조정하며, 수락(acceptance)과 종료(termination) 과정을 기계적인 감독자(mechanical supervisor)의 통제 하에 유지합니다.
최적화 애플리케이션은 orchestrator/optimize.py 또는 설치된 aka optimize 명령을 통해 실행할 수 있습니다. 둘 다 Core를 통해 애플리케이션을 선택하며, 내부 long_horizon/ 패키지가 에피소드 엔진을 제공합니다. 감독자(supervisor)는 평가자가 지원하는 V0을 설정하고, 활성화된 경우 프레임워크 네이티브 V1을 설정합니다. 코딩 에이전트들은 격리된 Git 작업 트리에서 빠르거나, 전체 또는 목표 에피소드를 탐색합니다. 감독자는 정확성, 프로덕션 정책, 성능 검증 및 승진(promotion)을 담당하며, 모든 결과는 검증되지 않은 후보가 기존의 것을 대체하지 못하도록 기록됩니다.
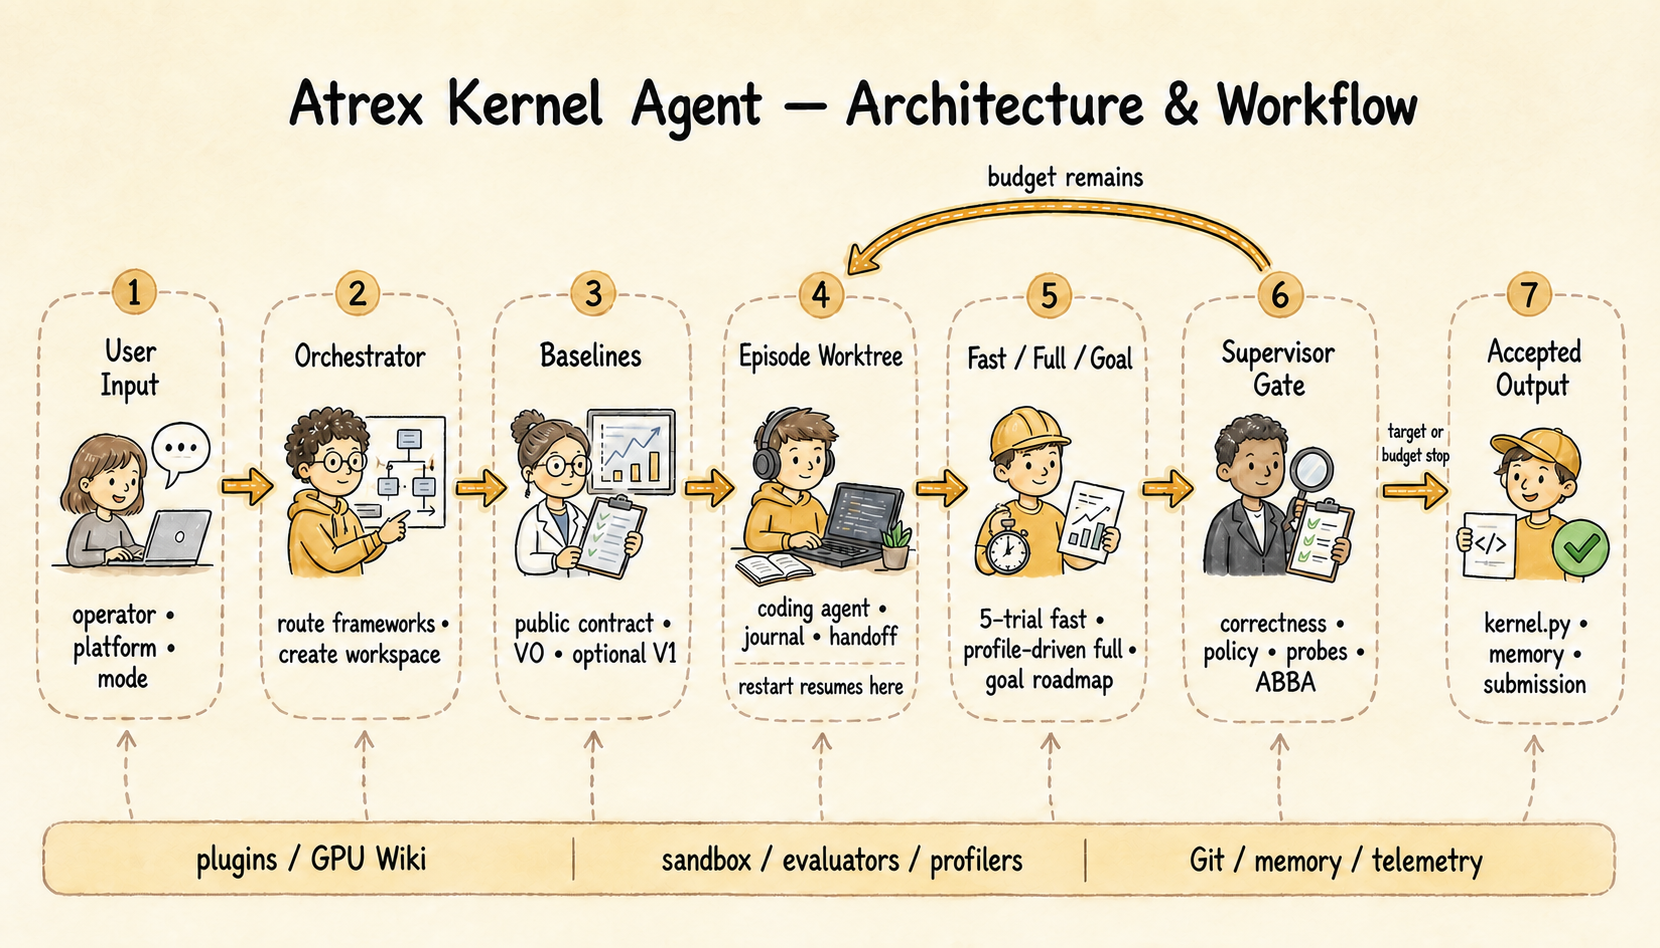
AKA는 다음을 지원합니다:
- SOL-ExecBench와 네이티브 Atrex-Bench 오퍼레이터 레이아웃;
- 격리된 샌드박스 실행을 통한 NVIDIA, AMD, 그리고 T-Head PPU (zwm890p) 타겟 지원;
- 환경 자동 복구 기능을 갖춘 게이트웨이 및 Bubblewrap-격리 OpenSSH GPU 실행;
- Triton, CuteDSL, CUDA, FlyDSL, TileLang 캠페인 지원;
- Claude, Qoder, Codex, 그리고 Pi 코딩 에이전트 백엔드 지원;
- 리더보드 및 장애 발생 시 안전한(fail-closed) 프로덕션 모드;
- 추적 가능한 출처 표기(attribution)를 갖춘 자동 로컬 플러그인 및 구조화된 GPU Wiki 검색 기능;
- 프로덕션 모드 수치 탐지(numerical probes) 및 모드별 성능 검증;
- 재개 가능하며, Git 격리 최적화를 통해 표준 측정 기록을 유지합니다.
Agate 평가에서 두 개 이상의 GPU를 요청하는 경우, 프로덕션 소스 정책 검사(source-policy inspection)는 자동으로 비활성화됩니다. GPU 개수는 평가자의 benchmark_contract.distributed_evaluation (torchrun, nccl, world_size >= 2)에서 가져오며, 이는 Agate의 num_gpus를 제출하는 데 사용된 것과 동일한 계약입니다. 이러한 캠페인은 자체 작성 프레임워크 변환 없이 통신 라이브러리와 검증된 V0을 재사용할 수 있습니다. 정확성(Correctness), 수치 탐지, 성능 확인 및 불변의 평가 입력은 여전히 강제됩니다. 단일 GPU 및 SSH 캠페인은 소스 정책 검사를 유지합니다. 유효하지 않은 분산 계약은 오류이며, 오퍼레이터 이름이나 후보 종속성 선언이 이러한 예외를 허용하지 않습니다. 소스 정책 결정은 비공개 평가자 메타데이터 또는 재개 시 커밋된 V0 메타데이터(V0 이전의 원래 오퍼레이터 디렉토리)에 따라 캠페인별로 고정됩니다. 후보 작업 공간에서 메타데이터를 생성하거나 편집하는 것은 이 결정을 변경할 수 없습니다. distributed_evaluation 키가 없는 레거시 메타데이터는 hardware.required_gpus가 여러 GPU를 설명하더라도 단일 GPU 제출 및 소스 검사를 유지합니다. 명시적인 분산 계약은 제공된 모든 hardware.required_gpus 값(1 포함)이 그 world_size와 일치하도록 요구합니다.
ATREX_SANDBOX_ATREX_BENCH_VERSION과 ATREX_SANDBOX_REQUIREMENTS_FILE은 Agate 런타임을 고정(pin)할 수 있습니다. 후자는 명시적 파일 오류와 함께 UTF-8로 읽힙니다. CLI를 통해 타이핑된 요청을 재현할 때, 요구사항 파일이 여전히 구성되어야 하며 파싱된 내용이 요청과 일치해야 합니다. 누락되거나 변경된 고정값은 다른 런타임을 조용히 사용하는 대신 오류를 발생시킵니다.
뉴스 (News)
-
[2026-09] 리더보드에서 실제 워크로드로: Qwen3.8-Max의 핵심 추론 연산자 가속화 (위챗): AKA는 세 가지 주요 연산자군(three key operator families) 전반에 걸쳐 **60개의 실제 워크로드 형태(real-world shapes)**에서 모든 전문가 구현체보다 낮은 평균 지연 시간(average latency)을 제공하며, 프로덕션/공식 기준선 대비 최대 1.55배의 속도 향상을 달성했습니다.
-
[2026-09] 저희는 재개 가능한 빠른(fast), 전체(full), 목표 에피소드(goal episodes)를 갖춘 Atrex Kernel Agent v0.3.0을 출시했으며, 네이티브 Atrex-Bench 및 다중 프레임워크 프로덕션 캠페인, Claude, Qoder, Codex, Pi 백엔드를 포함합니다. 또한 복구 기능이 있는 격리된 SSH GPU 실행, PPU 프로파일링, 플러그인 기반 GPU Wiki 검색, 그리고 프로덕션 모드 보충 수치 탐사(supplemental numerical probes) 기능을 추가했습니다. 자세한 내용은 v0.3.0 릴리스 노트를 참조하십시오.
-
[2026-08] 저희는 단일 오케스트레이션 워크플로우에 통합하고 레거시 경로 및 중복 컨텍스트를 제거함으로써 Atrex Kernel Agent를 간소화하여 더 작은 컨텍스트 크기와 낮은 토큰 사용량을 구현했습니다.
-
[2026-07] 저희는 Qwen3.8이 **SOL-ExecBench FlashInfer 연산자 최적화 리더보드(operator optimization leaderboard)**에서 1위를 차지하는 데 기여했습니다.
-
[2026-07] 오케스트레이션된 클린 세션 루프, 네이티브 SOL-ExecBench 연산자 워크플로우, Triton-to-Gluon 변환 지원 및 보다 완전한 NVIDIA 프로파일링 툴체인을 갖춘 Atrex Kernel Agent v0.2.0을 출시했습니다. [릴리스]
-
[2026-07] 저희는 논문 Atrex를 발표했습니다: Are LLM-Generated GPU Kernels Production-Ready? A Trace-Driven Benchmark and Optimization Agent.
-
[2026-06] GPU Wiki 지식 기반, 프로파일링 주도 최적화 워크플로우, 프로파일링 도구 및 참조 템플릿을 포함하는 초기 오픈 소스 버전인 Atrex Kernel Agent v0.1.0을 출시했습니다. [Release]
빠른 시작 (Quick Start)
사전 요구 사항 및 오케스트레이션된 최적화 루프의 완전한 실행 예제는 빠른 시작 가이드를 참조하십시오.
또는 이 저장소에서 Claude Code, Codex 또는 Qoder와 같은 코딩 에이전트를 시작하고 AKA 최적화 작업을 실행하도록 요청할 수 있습니다. 다음 프롬프트를 권장합니다:
Use AKA's orchestrator/optimize.py to start one optimization task for atrex-bench/xx. Put the workspace under ~/aka-opt, set the platform to H20, use the local sandbox, use claude as the Agent CLI, set max-iters to 300, specify cuda as the framework, and run in production mode.
문서화 (Documentation)
| 문서 | 내용 |
|---|---|
| 빠른 시작 | 설정, 명령어, 캠페인 단계, 구성 및 출력 |
| ... | |
python orchestrator/optimize.py --help를 실행하여 공식 CLI 인터페이스와 기본값을 확인하십시오. |
OpenSSH를 통해 접근 가능한 GPU 서버의 경우, 전용 저권한 계정을 사용하고 명시적인 --framework와 함께 user@gpu-host --sandbox-ssh user@gpu-host --sandbox-ssh-gpu 0을 전달하십시오. AKA는 Agent, Git, 메모리 및 에피소드 상태를 로컬에 유지하며, 샌드박스 허용 목록(allowlist)만 새로운 원격 임시 디렉터리로 전송하고, 필수적으로 네트워크가 차단된 Bubblewrap 네임스페이스 내에서 실행한 후 요청된 아티팩트를 복사하여 가져옵니다. 읽기 전용 venv 또는 도구 체인 트리(toolchain trees)를 최소 시스템 마운트 외부에서 사용하려면 --sandbox-ssh-runtime-bind를 사용하십시오. 런타임 소스는 원격 심볼릭 링크 해석 후 민감한 호스트 경로와 비교되며, 할당된 물리적 NVIDIA GPU만 보이고; capability-node 할당이 지원될 때까지 MIG 실행은 실패(fail closed)합니다. 원격 환경이 GPU 상태 프로브에 실패하면 AKA는 중단하고 활성 작업 트리(worktree)를 보존하며, 서버가 복구된 후 원래 명령을 재개하는 분리형 모니터(detached monitor)를 시작합니다. Quick Start: Isolated OpenSSH GPU host를 참조하십시오. 생성된 stop-recovery.sh는 또한 복구된 최적화기(optimizer)를 중지하고, 명시적으로 recover.sh가 실행될 때까지 자동 복구를 비활성화합니다. 복구 모니터는 재시작된 최적화기와 함께 유지됩니다: 예상치 못한 종료는 상태 폴링 및 자동 재시작으로 돌아가는 반면, 오직 영속적으로 깨끗한 0 종료(zero exit)만이 복구를 완료합니다.
감사의 글 (Acknowledgements)
AKA는 다음을 포함하여 많은 오픈 소스 프로젝트를 기반으로 구축되었고 학습했습니다:
- GPU 커널 프로젝트: CUTLASS, cutex, cuLA, FlashAttention, FlashInfer, FlyDSL, Triton, DeepGEMM, LeetCUDA, FlashMLA, Composable Kernel, cute-gemm, hpc-ops, AIter, quack, 그리고 TileLang.
- 지식 및 에이전트 도구: KernelWiki, modern-gpu-programming-for-mlsys, ncu-report-skill, humanize, AKO4ALL, 그리고 KDA.
인용 (Citation)
AKA가 작업에 유용하다면, 다음 Atrex 논문을 인용해 주세요:
@misc{atrex2026,
  title         = {Are LLM-Generated GPU Kernels Production-Ready? A Trace-Driven Benchmark and Optimization Agent},
  author        = {Lingyun Yang and Yuxiao Wang and Shenghao Liang and Linfeng Yang and Daocheng Ying and Chunbo You and Rui Zhang and Luping Wang and Yinghao Yu and Guodong Yang and Liping Zhang},
...
애플리케이션 프레임워크 (Application framework)
기존 스크립트는 인자(arguments)와 기본 동작을 유지합니다. Core, Contracts, Bootstrap 및 Optimization 패키지를 설치한 후, 새로운 명령어는 다음과 같습니다:
aka optimize --repo-root /path/to/aka -- \
  --op-dir /path/to/problem --platform L20N --framework Triton
--repo-root는 일치하는 AKA 체크아웃을 선택하며, --op-dir은 네이티브 Atrex-Bench 또는 SOL 문제를 선택합니다. 설치 및 애플리케이션 선택 가이드와 핵심 인터페이스(Core interface)를 참조하십시오.
라이선스 (License)
Apache License 2.0에 따라 라이선스가 부여됩니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub GameDev의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기