Insights
AI가 자동으로 큐레이션·번역·정리하는 기술 동향 피드입니다.
© 2026 Molayo
AI가 자동으로 큐레이션·번역·정리하는 기술 동향 피드입니다.
본 페이지의 콘텐츠는 AI가 공개된 소스를 기반으로 자동 수집·요약·번역한 것입니다. 원 저작권은 각 원저작자에게 있으며, 각 게시물의 “원문 바로가기” 링크를 통해 원문을 확인할 수 있습니다. 저작권자의 삭제 요청이 있을 경우 신속히 조치합니다.
CERN LHC의 jet tagging을 위해 AMD Versal AI Engine에 최적화된 양자화된 Transformer 구현을 제안합니다. Python 모델 설명으로부터 Vitis 그래프 코드를 자동 생성하는 재사용 가능한 소프트웨어 프레임워크를 소개합니다.
불완전한 전송 환경에서도 렌더링이 가능한 동적 가우시안 스플래팅(Dynamic Gaussian Splatting) 연구를 소개합니다. 데이터 누락 상황에서도 이미지 품질 저하를 최소화하며, 시공간 클러스터와 부분 의존성 그래프를 통해 효율적인 렌더링과 전송을 구현합니다.
Blended Chart Surfaces는 기하학적 처리에 최적화된 새로운 명시적 표면 표현 방식을 제안합니다. 기존 신경망 방식의 한계를 넘어, 전역적 매끄러움과 미분 가능성을 보장하면서도 복잡한 위상을 효율적으로 표현합니다.
MOCHI는 노이즈가 포함된 다수 인간-사물 상호작용(MHOI) 데이터를 개선하기 위한 2단계 프레임워크입니다. 확산 기반 노이즈 최적화와 단일 인물 동작 사전 정보를 활용하여 물리적으로 타당하고 정교한 전신 동작 시퀀스를 생성합니다.
FllumaOne은 실행 가능한 Python 프로그램과 커널 검증된 피처 히스토리를 포함하는 코드 네이티브 멀티모달 CAD 데이터셋입니다. 10만 개의 승인된 샘플을 통해 CAD 재구성, 프로그램 합성, B-Rep 분석 등 다양한 설계 연구를 지원합니다.
Edit3DGS는 2D 지시어 가이드 확산 모델과 3D Gaussian Splatting을 결합하여 동적인 3D 머리 편집을 수행하는 프레임워크입니다. 텍스트를 통해 표정, 속성, 외형을 세밀하게 수정하며, 시간적 일관성을 유지하는 고충실도 아바타 생성을 지원합니다.

순환 제조 공급망 최적화를 위해 메타 학습과 지속적 학습을 결합한 '메타 최적화 지속적 적응' 방식을 제안합니다. 정책 변화로 인한 파괴적 망각 문제를 해결하고, 새로운 제약 조건에 신속하게 대응하는 에이전트 아키텍처를 탐구합니다.
Qwen-35B-A3 모델을 PPO 학습을 통해 자동 조사 및 자율 에이전트용으로 최적화한 SIQ-1 모델을 소개합니다. 검증 가능한 보상을 활용한 PPO 학습의 효과를 입증하며, 주요 벤치마크에서 뛰어난 성능을 보여줍니다.
Princeton 연구팀의 GEO(Generative Engine Optimization) 연구를 통해 AI 답변 인용률을 높이는 구조화된 콘텐츠의 중요성을 분석합니다. FAQ Schema와 같은 구조화된 데이터가 RAG 기반 AI 모델의 정보 추출 효율을 극대화함을 입증합니다.

기존 가중치 학습(IWL)의 파괴적 망각 문제를 해결하기 위해 모듈러 메모리 설계를 제안합니다. ICL의 신속한 적응력과 IWL의 안정적인 업데이트 능력을 결합하여 지속 학습 에이전트를 구현하는 프레임워크를 다룹니다.
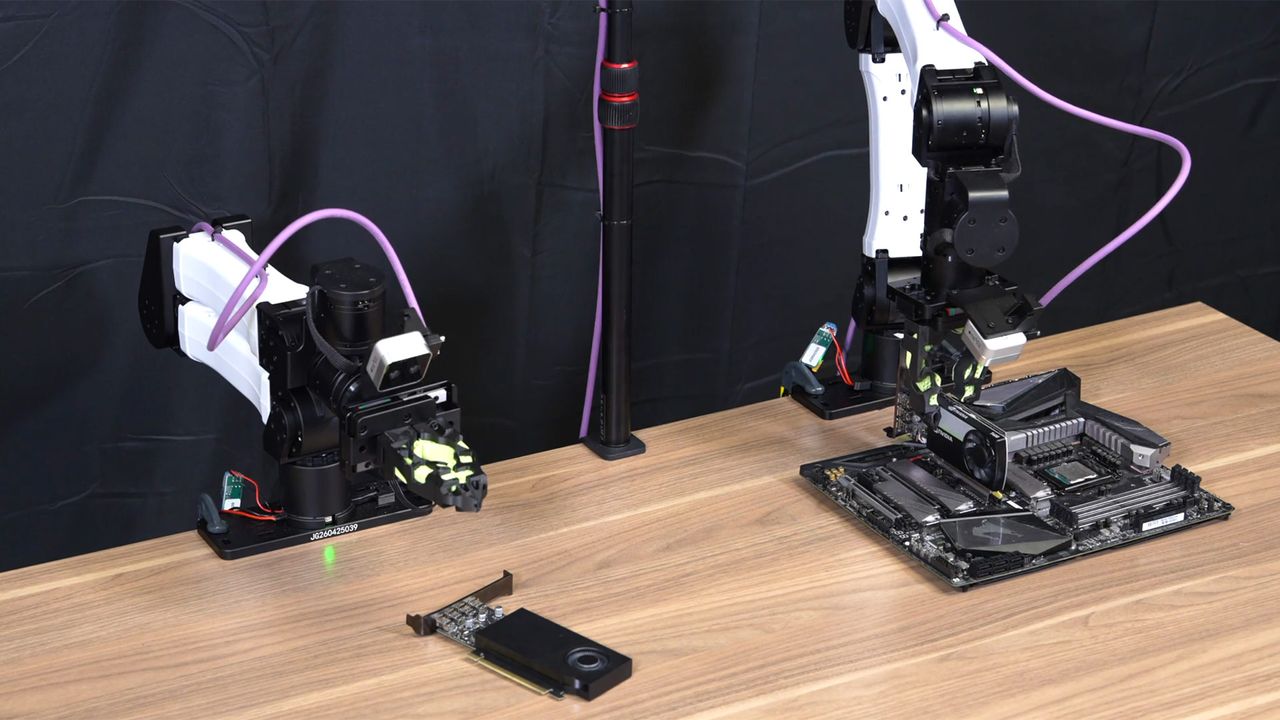
Nvidia가 물리적 세계에서 스스로 학습하고 정교한 작업을 수행하는 에이전트형 로봇 기술인 ENPIRE를 공개했습니다. 이 기술은 코딩 에이전트가 로봇 군단을 제어하며 시각적 단서 탐색, 논문 학습, 하드웨어 직접 시도 등을 통해 스스로 정책을 개선하는 것이 특징입니다.

세포 자동자(Cellular Automata) 개념을 신경망과 결합한 신경 세포 자동자(NCA)의 원리와 고해상도 구현 방법을 다룹니다. PyTorch를 활용하여 복잡한 패턴을 생성하는 고해상도 NCA의 구현 과제와 픽셀 셔플 기술을 소개합니다.

과학자들이 100경 제곱킬로미터 이상의 면적을 포괄하는 거대한 균사체 네트워크를 발견했습니다. 이 네트워크는 식물의 70%와 공생하며 토양으로 운반되는 CO2의 40억 톤을 형성하는 중요한 역할을 합니다.

1세제곱밀리미터 크기의 뇌 조직을 전체 스캔하기 위해 1.4페타바이트에 달하는 방대한 데이터가 필요함을 설명합니다. 이는 4K 영화 14,000개 분량에 해당하는 엄청난 규모의 데이터 처리 기술을 요구합니다.

LoopCoder-v2는 18T 토큰으로 학습된 7B 모델로, 단 2번의 루프만으로 SWE-bench Verified에서 64.4점을 기록하며 대형 모델을 능가합니다. 또한 VibeThinker-3B는 3B 파라미터로 AIME26 및 LeetCode에서 압도적인 추론 성능을 보여줍니다.

NVIDIA의 ZPPO는 소형 모델이 과거의 어려운 질문을 통해 학습할 수 있도록 돕는 새로운 방법론입니다. BCQ와 NCQ를 통해 프롬프트 내에 교사를 유지함으로써 온폴리시 학습을 보존하며, 3B 규모의 VibeThinker-3B 모델은 이를 통해 프런티어 추론 수준의 성능을 달성했습니다.

신경망 가중치를 그래프 데이터베이스와 유사한 방식으로 쿼리할 수 있는 새로운 접근 방식을 소개합니다. 모델 내부의 가중치 구조를 탐색하고 분석하는 효율적인 방법을 제안합니다.

로봇의 사회적 내비게이션 연구, 데이터셋 및 방법론을 정리한 큐레이션 목록입니다. 또한 Claude Code와 Codex를 위한 에이전트 최적화 React Native 기술에 대한 정보도 포함되어 있습니다.

GPT-4o-mini 모델을 활용해 반려동물 쇼핑 질문에 대한 AI 추천 패턴을 분석한 연구 결과입니다. 분석 결과, AI의 추천 빈도와 실제 상점의 AI 준비도 사이에는 양의 상관관계가 없으며 오히려 반대 경향을 보였습니다.
OpenAI가 신규 모델 출시 전 실서비스 대화 로그를 활용해 문제 행동을 예측하는 'Deployment Simulation' 기법을 공개했습니다. 벤치마크와 실제 서비스 간의 괴리를 줄이기 위해 합성 테스트 대신 130만 건의 실제 로그를 재생하여 모델의 본연의 거동을 측정합니다.