
벡터 검색이 데이터 타입이 되었지만, 돈의 계산법은 사라지지 않았다
요약
벡터 검색 기능이 독립적인 데이터베이스에서 일반 DB의 컬럼 타입으로 통합되는 추세가 강해지고 있습니다. 이는 기존 엔진들이 HNSW와 같은 알고리즘을 도입하며 운영 복잡성을 줄였기 때문입니다. 결국, 시스템 성능과 비용은 벤더 로고보다 메모리 관리 및 압축 기술에 의해 결정됩니다.
핵심 포인트
- 벡터 검색이 전용 DB에서 일반 DB의 컬럼 타입으로 통합되는 추세입니다.
- Elasticsearch, pgvector 등 기존 엔진들이 HNSW를 도입하며 기능을 흡수했습니다.
- 실제 운영 환경에서는 벡터 조회 외에도 필터링, 점수 계산 등이 결합됩니다.
- 시스템 비용은 벤더에 의존하기보다 메모리 및 압축 기술에 의해 결정됩니다.
STORE
벡터 검색이 데이터 타입이 되었지만, 돈의 계산법은 사라지지 않았다
몇 년 동안 모든 AI 스택에는 주 저장소 옆에 전용 벡터 데이터베이스가 있어야 할 것처럼 보였습니다 (필요한 소수의 경우). 그 순간은 지났습니다. 근사 최근접 이웃 검색(Approximate nearest-neighbor search)은 이제 어디에나 있으며, 대부분의 경우 팀이 이미 운영하고 있는 데이터베이스—Postgres, Elasticsearch, OpenSearch, ClickHouse, MongoDB, Redis—의 컬럼 타입 중 하나입니다. 그리고 “이것을 위해 새로운 데이터베이스가 필요한가”라는 질문은 대체로 스스로 답합니다: 필요 없다.
무너지지 않은 것은 비용 계산법이었습니다. 벡터 검색이 데이터 타입이 된다는 것은 별도의 시스템을 구축하는 대신, 기존 엔진에 밀집된 임베딩(dense embeddings)을 저장하고 일반 필터링, 조인 및 어휘적 점수 산정과 함께 근사 최근접 이웃(ANN) 인덱스로 쿼리한다는 의미입니다. 이는 운영상의 표면적(operational surface)을 제거할 뿐, 물리적인 법칙까지 제거하지는 않습니다. 규모가 커지면, 청구서는 각 벡터가 메모리에 차지하는 바이트 수, 얼마나 공격적으로 압축하느냐, 그리고 어디에서 RAM에서 떨어져 나가는지에 의해 결정되며—이 중 거의 어느 것도 상자에 붙은 벤더의 로고에 의존하지 않습니다.
전용 데이터베이스 카테고리는 이미 운영 중인 엔진으로 축소되었다
전용 벡터 데이터베이스는 실제로 존재했던, 실제 엔지니어링을 기반으로 한 카테고리였습니다. Pinecone은 2021년에 관리형 서비스를 출시하며 사실상 이 분야의 명칭을 정립했고; Milvus, Weaviate, Qdrant가 비슷한 시기에 등장했습니다. 당시 주장은 설득력이 있었습니다: 범용 데이터베이스에는 좋은 ANN 인덱스가 없었기 때문에, 의미론적 검색(semantic search)은 목적에 맞게 제작된 공간이 필요했다.
기존 기업들은 그 격차를 빠르게 메웠다. Elasticsearch는 Lucene의 HNSW 구현을 기반으로 계층적 탐색 가능한 작은 세계(Hierarchical Navigable Small World, HNSW) 그래프 알고리즘을 이용한 근사 k-최근접 이웃(k-NN) 기능을 출시했다. OpenSearch는 1.0 버전부터 k-NN 플러그인을 탑재해 왔다. 그리고 pgvector는 2023년 8월의 0.5.0 버전을 통해 HNSW를 추가하며, 일반적인 Postgres 인스턴스를 신뢰할 수 있는 벡터 저장소로 변모시켰다. MongoDB Atlas Vector Search는 2023년 12월에 일반 사용 가능(GA) 상태에 도달했다. Redis는 이미 2022년에 RediSearch 2.4를 통해 벡터 유사도를 노출했다. ClickHouse는 25.8 버전에서 HNSW 벡터 유사도 인덱스를 GA로 출시했다. 동일한 알고리즘인 HNSW가 어디에나 나타나는 이유는, 재구축 단계 없이 95% 이상의 재현율(recall)을 제공하기 때문이다.
이러한 통합세가 지속되는 이유는 단순히 종이 위의 기능 동등성 때문이 아니다. 실제 운영 환경에서의 검색은 순수한 벡터 조회인 경우가 드물다. 유용한 시스템들은 텍스트 기반 점수 계산(lexical scoring), 구조화된 필터(테넌트, 언어, ACL, 최신성) 및 집계 기능을 밀집 검색(dense retrieval)과 결합하고, 종종 병합된 세트를 재순위 지정한다. 이 모든 것이 벡터 옆에 존재하기를 원한다. 별도의 벡터 데이터베이스는 이중 쓰기(dual writes), 두 번째 일관성 모델, 그리고 새벽 3시에 누군가 설명해야 할 또 다른 무언가를 강요한다. 이미 운영 중인 엔진이 임베딩을 하나의 필드로 담을 수 있을 때, 독립적인 시스템은 재현율 이상으로 자신을 입증해야 하며, 보통 그렇게 할 수는 없다.
비용을 실제로 좌우하는 것: 메모리가 모든 이야기다
HNSW는 포인터 추적(pointer chasing)을 통해 탐색해야 하는 그래프이며, 이 탐색이 빠르려면 그래프와 그 벡터가 RAM에 위치해야 한다. 노드가 디스크로 넘어가기만 해도, 지연 시간은 거리 계산보다는 페이지 폴트(page faults)에 의해 지배된다. 따라서 대규모에서 벡터 검색의 주요 비용은 메모리이며, 메모리는 벡터 개수와 차원의 곱에 비례하여 증가한다.
인메모리 HNSW 인덱스의 벡터당 메모리 사용량은 명확하게 정의되어 있습니다. OpenSearch는 이를 벡터당 1.1 × (4 × 차원 + 8 × M) 바이트로 문서화합니다. 여기서 4 × 차원은 float32 벡터 자체이며, 8 × M은 그래프의 노드당 연결 오버헤드이고, 1.1은 대략 10%의 여유분입니다. 그 결과는 문서 개수뿐만 아니라 차원성(dimensionality)이 하드웨어 등급을 결정한다는 것입니다.
실제 수치는 직관적이지 않습니다. OpenAI의 text-embedding-3-large가 출력하는 1536차원의 float32 벡터 1백만 개는 그래프 오버헤드를 제외하고 약 6.1 GB를 차지합니다. 이 크기의 벡터 1천만 개는 예측 가능한 지연 시간(latency)을 위해 모두 RAM에 상주해야 하므로, 순수하게 벡터만을 위한 공간으로 대략 60 GB가 필요합니다. 이것이 바로 벡터 기능을 용량 계획 문제로 전환시키는 수치입니다.
그래프 구조는 이 문제를 더욱 복잡하게 만듭니다. HNSW는 모든 레이어에서 이웃 목록(neighbor lists)을 저장하기 때문에, 인덱스는 IVFFlat의 셀당 평면 저장 방식이 1.1배 근처에 머무르는 것과 달리, 원본 벡터 크기의 2~5배까지 커질 수 있습니다. 이것이 느린 벡터 검색에 대한 본능적인 대응(더 많은 샤드 추가, 더 높은 재현율(recall) 설정, 더 큰 ef_search 사용 등)이 종종 상황을 악화시키는 이유입니다. 각 레버는 메모리 압력, 팬아웃(fan-out), 또는 쿼리당 CPU 부하를 추가하며, 대규모에서는 가장 느린 샤드가 p99 지연 시간을 결정합니다. 재현율 대비 처리량(throughput) 곡선은 가파르고 비선형적입니다. 표준 ANN 벤치마크에서 HNSW의 재현율을 95%에서 100%로 끌어올리는 것은 처리량을 약 7배 소비할 수 있습니다. 마지막 두 포인트의 재현율을 확보하는 것이 보통 전체 파이프라인에서 가장 비용이 많이 드는 부분이 되며, 사용자가 눈치채기 힘든 경우가 많습니다.
곡선을 휘게 만드는 레버: 양자화(Quantization)와 계층화(Tiering)
메모리가 비용이라면, 우리는 확실히 압축을 사용하여 이를 줄일 수 있습니다. 양자화는 제어 가능한 수준의 정밀도를 포기하는 대신 각 벡터의 크기를 크게 줄이며, 보통 저렴한 스토리지에 보관된 전체 정밀도(full-precision) 벡터를 사용하여 상위 후보들을 재순위화(re-ranks)하는 리스코어링(rescoring) 단계와 함께 사용됩니다. 진정한 비용 절감이 발생하는 곳이 바로 이곳이며, 이는 주로 공급업체 선택과 무관합니다.
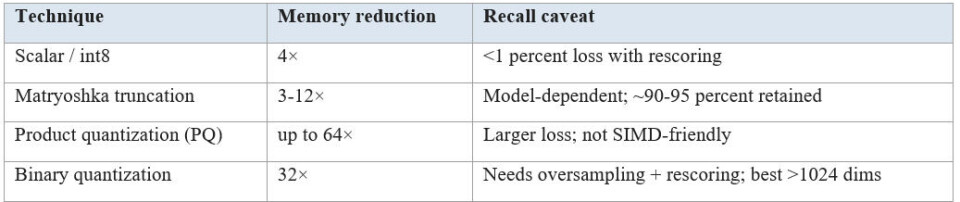
이러한 기술들은 공격성(aggressiveness) 순으로 쌓여갑니다:
이 수치들은 구체적입니다. Lucene의 int8 스칼라 양자화(scalar quantization)는 메모리를 약 75% 절감하며, 리스코어링을 위해 원본 벡터를 디스크에 보관합니다. 각 차원을 단일 비트로 압축하는 이진 양자화(Binary quantization)는 최대 32배까지 도달하며, 오버샘플링(oversampling)이 적용된 고차원 임베딩에서 잘 작동합니다. Qdrant는 4배 오버샘플링을 거친 1536차원 OpenAI 임베딩에 대해 0.98의 recall@100을 보고했습니다. Elasticsearch의 Better Binary Quantization은 138M × 1024차원의 데이터셋 크기를 약 535GB에서 약 19GB로 줄입니다.
다른 핵심 요소는 모든 벡터가 RAM에 있어야 할 필요가 없다는 점을 인정하는 것입니다. 디스크 기반 ANN(Approximate Nearest Neighbor)은 인덱스의 대부분을 SSD에 보관하고 메모리에는 압축된 복사본만 유지합니다. Microsoft의 DiskANN은 단일 64GB 머신과 SSD를 사용하여 10억 개의 포인트를 95% 이상의 recall로 인덱싱하며, 초당 수천 건의 쿼리를 처리합니다. 오브젝트 스토리지 계층(Object-storage tiers)은 이를 더욱 확장합니다. Amazon의 S3 Vectors는 지연 시간(latency)을 가격과 교환함으로써 대규모 벡터 데이터셋에서 최대 90% 낮은 비용을 목표로 합니다. 이 트레이드오프는 실제적이며 측정 가능합니다: OpenSearch의 디스크 기반 모드는 인메모리 경로가 24ms인 것에 비해 p90 지연 시간이 96ms를 보였습니다. 에이전트형 검색(agentic retrieval)처럼 수 초에 걸친 추론 루프 내에서 사용된다면 무시할 만하지만, 인터랙티브 자동 완성(interactive autocomplete)에는 치명적입니다. 10억 개 규모의 벡터 검색 설계 이동은 계층화(tiering)입니다. 즉, RAM 기반 HNSW를 사용하는 '핫' 벡터와 디스크 또는 오브젝트 스토리지에 양자화된 '콜드' 벡터를 분리하는 것입니다. 반면 AWS S3 Vectors나 Turbopuffer 같은 일부 솔루션은 여전히 이 두 세계 모두의 장점을 누릴 수 있게 합니다. 즉, 적절한 성능과 낮은 비용으로 대규모 벡터 검색을 가능하게 하는 것입니다.
자체 관리형(Self-Managed) 대 관리형(Managed) 경계가 실제로 무너지는 지점
엔진들이 동일한 알고리즘과 동일한 압축 도구 키트에 수렴함에 따라, 자체 관리형과 관리형을 결정하는 문제는 더 이상 '기능'의 문제가 아닙니다. 둘 다 HNSW를 수행할 수 있고, 모두 양자화(quantize)할 수 있으며, 모두 계층화(tier)할 수 있습니다. 이 경계는 세 가지 것을 누가 소유하느냐에 달려있습니다: 메모리 크기 계산법(memory-sizing math), 리스코어링 및 지연 시간 급락 구간(latency cliff), 그리고 핫 티어와 콜드 티어 간의 라우팅입니다.
관리형 서비스(Managed services)는 프로비저닝 문제를 흡수함으로써 가치를 창출합니다. 이들은 RAM 용량을 조정하고 벡터 트래픽을 전용 노드에 격리하여 운영 쿼리와 간섭하지 않게 하며 – MongoDB가 Vector Search GA와 함께 전용 검색 노드를 출시한 이유가 바로 이것입니다 – 그리고 콜드 티어(cold-tier)에서 데이터를 가져오는 과정을 단일 API 뒤에 숨깁니다. 사용자가 일부 제어 장치(knobs)를 포기하고 일정 마진을 지불하지만, 실패 모드(failure modes)의 소유권을 내려놓게 됩니다.
셀프 관리형(Self-managed) 방식은 모든 제어 장치를 제공하며, 잘못 사용하는 데 따르는 비용까지도 함께 가져옵니다. 사용자는 M, ef_construction, 그리고 ef_search를 설정하고; 양자화 스킴(quantization scheme)과 오버샘플링 비율(oversampling ratio)을 선택하며; 재구축 주기(rebuild cadence)를 결정합니다. 또한 날카로운 단점들도 물려받게 됩니다: 페이지 폴트(page-fault)가 모든 순회 단계에서 발생하는 온디스크 HNSW 인덱스에 대한 콜드 쿼리, 데이터 분포 변화에 따라 드리프트하는 재현율(recall), 그리고 과도한 샤딩(over-sharding)을 테일 지연 시간 함정으로 만드는 팬아웃 수학(fan-out math) 등입니다.
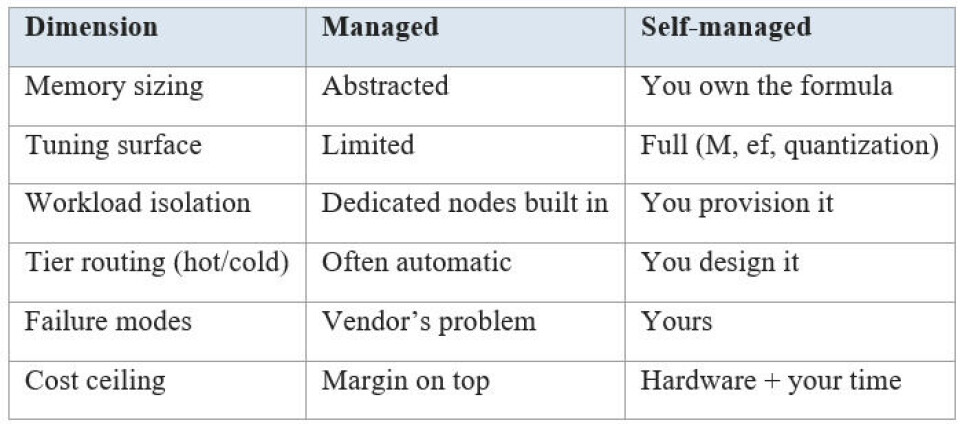
결정의 동인은 거의 기술 자체가 아닙니다. 그것은 두 가지 질문에 달려 있습니다. 벡터 데이터가 이미 운영 스토어에서 실행되고 있습니까 – 이 경우 컬럼을 추가하는 것이 완전히 새로운 시스템 하나를 피하게 해줍니다 – 그리고 비용 상한선 대비 지연 시간 SLO(Service Level Objective)는 무엇입니까? 엄격한 20밀리초 미만의 대화형 예산과 소규모 운영 인력을 가진 팀은 보통 관리형 핫 티어(managed hot tier)가 더 적합합니다. 이미 Postgres나 OpenSearch를 규모 있게 운영하고 있고, 용량 계획을 담당할 충분한 인력(headcount)이 있으며, 양자화 및 계층화 곡선(quantization-and-tiering curve)을 직접 제어하려는 팀은 셀프 관리형으로 가져가는 것이 더 많은 이점을 얻을 것입니다. 다른 방향이 아니라 워크로드에 맞는 엔진을 선택하십시오.
다음은 핵심 시사점입니다:
- 독립적인 벡터 데이터베이스 카테고리는 상당 부분 해체되었습니다. 프로덕션 검색 요구 사항은 레스칼 스코어링(lexical scoring) 및 필터와 함께 벡터가 위치해야 하므로, ANN이 이제 Postgres (pgvector), Lucene 엔진, ClickHouse, MongoDB, 그리고 Redis의 네이티브 데이터 타입이 되었습니다.
· 메모리(Memory)가 지배적인 비용 요소입니다. 인메모리 HNSW 인덱스는 벡터당 약 1.1 × (4 × 차원 + 8 × M) 바이트가 필요하며, 1536차원의 10M 벡터는 그래프 오버헤드를 제외하고도 대략 60 GB를 사용합니다.
· 재현율(recall) 대 처리량(throughput) 곡선은 비선형적입니다. 재현율의 마지막 몇 포인트를 추구하는 것은 처리량을 수 배로 떨어뜨릴 수 있으며, '노브를 올리는 것'은 보통 역효과를 냅니다.
· 양자화(Quantization)와 계층화(tiering)는 비용을 조절하는 레버리지이며, 대부분 공급업체에 독립적입니다. int8 (4배), Matryoshka 절단(3~12배), 이진 양자화(binary quantization) (32배), 그리고 디스크/오브젝트 스토리지 계층(최대 ~90% 저렴하며, 지연 시간 비용이 발생함) 등이 있습니다.
· 자체 관리형(Self-managed)과 관리형(Managed)의 차이는 기능 자체가 아니라 소유권에 관한 것입니다. 관리형은 크기 산정 수학 및 격리(isolation)를 처리해 주고; 자체 관리형은 모든 노브와 모든 실패 모드를 제공합니다. 데이터가 이미 어느 스토어에 존재하며 지연 시간 예산과 비용 상한선이 어떠한지에 따라 결정하십시오.
Itamar Syn-Hershko**는 The Next Platform의 오랜 독자이자 통찰력 있는 코멘터입니다. (네, 저희가 사용하는 새로운 CMS가 댓글 기능을 망가뜨렸다는 것을 알고 있습니다. 이 문제를 해결하기 위해 팀과 협력하고 있습니다.) Syn-Hershko는 대불황(Great Recession) 시절 Yayasoft에서 소프트웨어 개발자로 일했으며, CLucene 검색 엔진 프로젝트의 공동 관리자이자 개발자였고, Hibernating Rhinos에서는 RavenDB의 리드 개발자였습니다. 이후 Forter의 시니어 스태프 소프트웨어 엔지니어로 근무하며, Forter의 실시간 사기 방지 시스템에 사용되는 Elastic 기반의 신원 인증 부분을 구축했습니다. 2016년에는 고객의 데이터 분석 워크로드를 지원하는 BigData Boutique의 설립자이자 최고 기술 책임자(CTO)였으며, 이 분야는 여전히 지속적인 관심을 받고 있습니다. 또한 2024년에는 고객이 에이전트 기반 AI 애플리케이션을 사용할 수 있도록 데이터베이스를 현대화하는 NeverBlink AI의 설립자가 되었습니다.
만약 무언가에 대해 마음속에 걸리는 것이 있고 기술적 역량이 있다면, 저는 언제나 기꺼이 당신에게 이야기를 할 발판(soapbox)을 제공해 드릴 준비가 되어 있습니다. 연락 주십시오.
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기