
VisualWebBench
요약
VisualWebBench는 웹 시나리오에서 멀티모달 LLM(MLLM)의 이해 및 접지(grounding) 능력을 평가하기 위해 설계된 포괄적인 벤치마크입니다. 이 프레임워크는 139개 웹사이트와 1.5K개의 인스턴스를 포함하며, QA 스타일로 통일되어 다양한 MLLM의 성능 비교를 용이하게 합니다. 최근 업데이트된 MultiUI 데이터셋을 통해 UI 관련 및 Doc/OCR/차트 이해 작업까지 향상시켰습니다.
핵심 포인트
- 웹 시나리오에 특화된 MLLM 평가 벤치마크입니다.
- 139개 웹사이트와 87개 하위 도메인을 포괄합니다.
- 캡셔닝, OCR, 액션 예측 등 7가지 핵심 작업을 포함합니다.
- MLLM의 접지 능력 및 저해상도 이미지 처리 한계를 보여줍니다.
VisualWebBench
이 레포지토리는 논문 VisualWebBench: How Far Have Multimodal LLMs Evolved in Web Page Understanding and Grounding?의 평가 프레임워크를 담고 있습니다.
업데이트
- [2024/10/18]: 웹UIs를 사용하여 텍스트 기반 LLM으로 합성된 7.3M개의 일반 멀티모달 명령어인 🤗 MultiUI를 소개하여, UI 관련 및 Doc/OCR/차트 이해 작업을 모두 향상시켰습니다.
- [2024/4/17]: Gemini 1.5 Pro의 결과를 업데이트했습니다.
서론
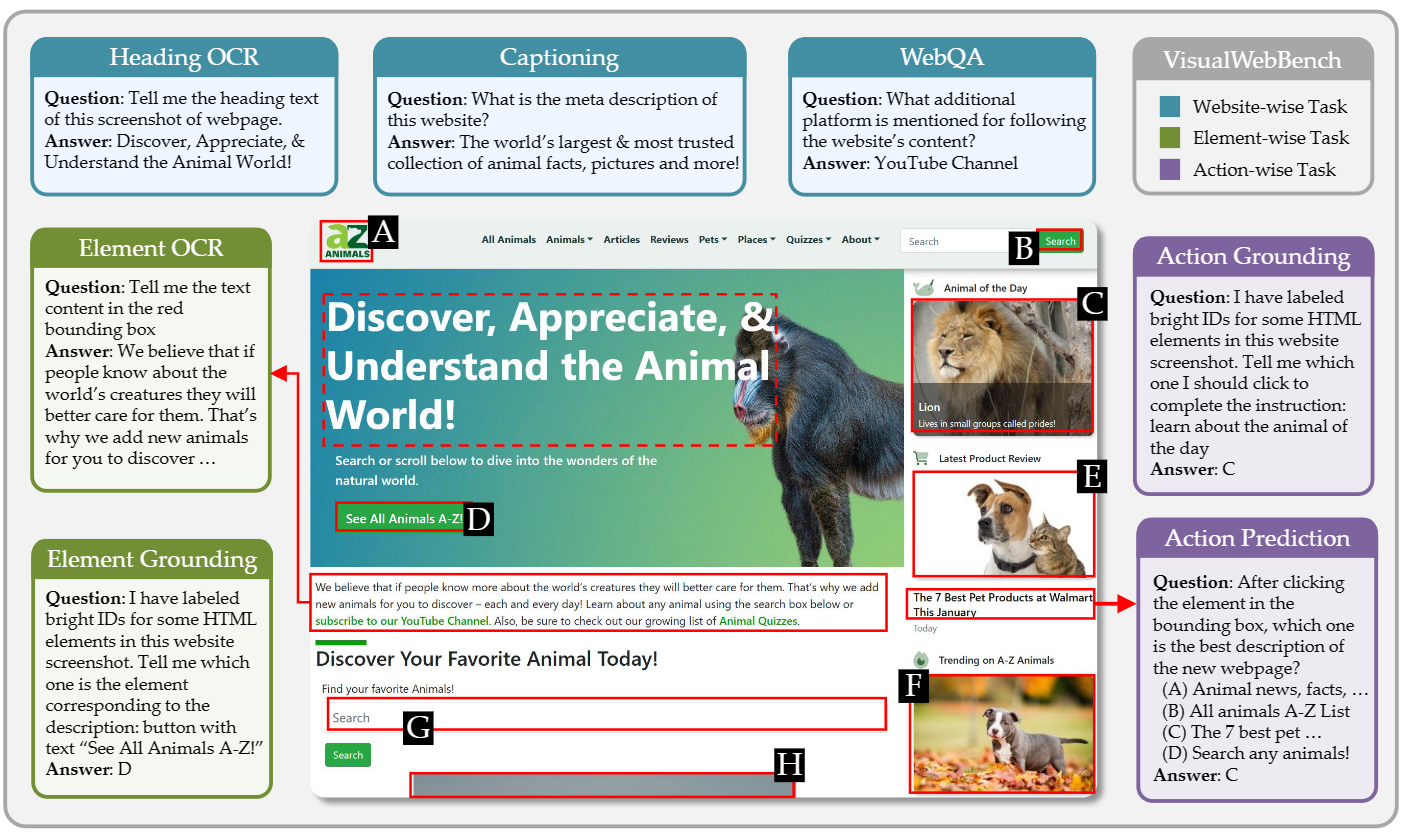
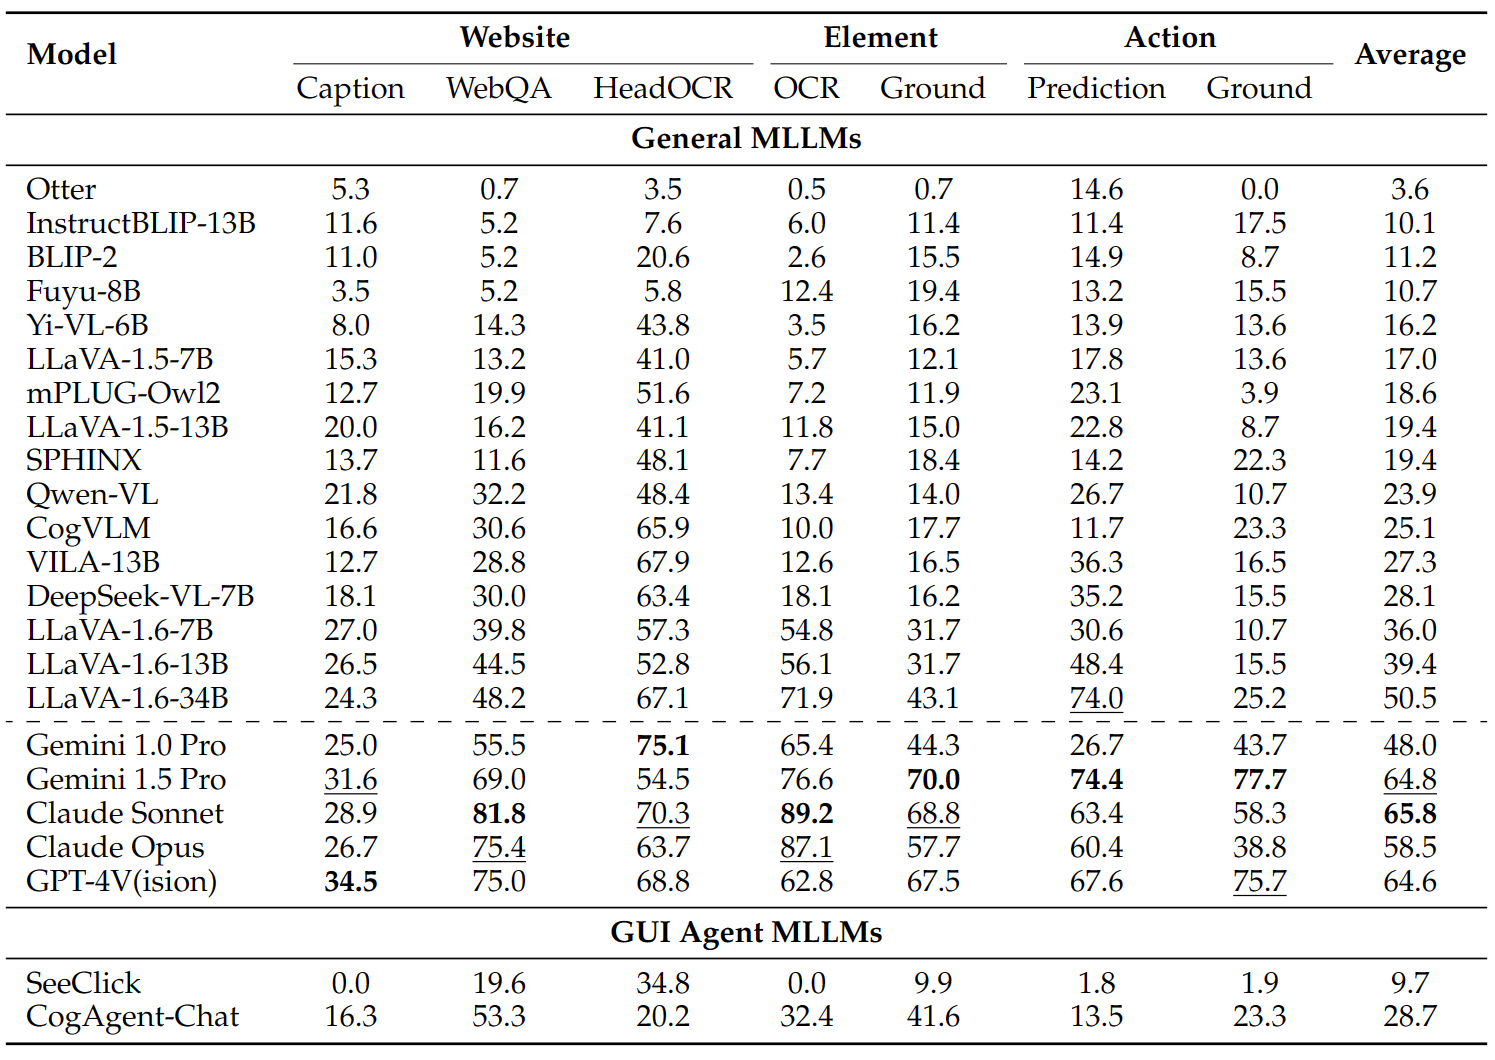
저희는 VisualWebBench를 소개합니다. 이는 웹 시나리오에서 MLLM의 이해 및 접지(grounding) 능력을 평가하도록 설계된 멀티모달 벤치마크입니다. VisualWebBench는 일곱 가지 태스크로 구성되어 있으며, 139개의 실제 웹사이트에서 수집된 1.5K개의 인간이 선별한 인스턴스로, 87개의 하위 도메인을 포괄합니다. 저희는 VisualWebBench를 사용하여 14개의 오픈 소스 MLLM, Gemini Pro, Claude 3, 그리고 GPT-4V(ision)을 평가했으며, 상당한 어려움과 성능 격차를 발견했습니다. 추가 분석 결과, 현재 MLLM의 한계점들, 특히 텍스트가 풍부한 환경에서의 부적절한 접지 능력과 저해상도 이미지 입력에 대한 낮은 성능이 확인되었습니다. 저희는 VisualWebBench가 연구 커뮤니티에 귀중한 자원이 될 것이며, 웹 관련 애플리케이션을 위한 더욱 강력하고 다재다능한 MLLM 개발에 기여할 것이라고 믿습니다.
벤치마크 구성
저희는 웹 도메인에서 MLLM의 역량을 평가하기 위해 설계된 포괄적인 멀티모달 벤치마크인 VisualWebBench를 소개합니다. 웹 브라우저와의 인간 상호작용 과정에서 영감을 받은 VisualWebBench는 캡셔닝(captioning), 웹페이지 QA, 헤딩 OCR, 엘리먼트 OCR, 엘리먼트 그라운딩(element grounding), 액션 예측(action prediction), 그리고 액션 그라운딩(action grounding)이라는 웹 작업에 필요한 핵심 능력과 연결된 일곱 가지 작업을 포함합니다. 벤치마크는 총 1.5K개의 인스턴스로 구성되어 있으며, 모두 QA 스타일로 통일하여 다양한 MLLM의 성능을 평가하고 비교하기 쉽습니다.
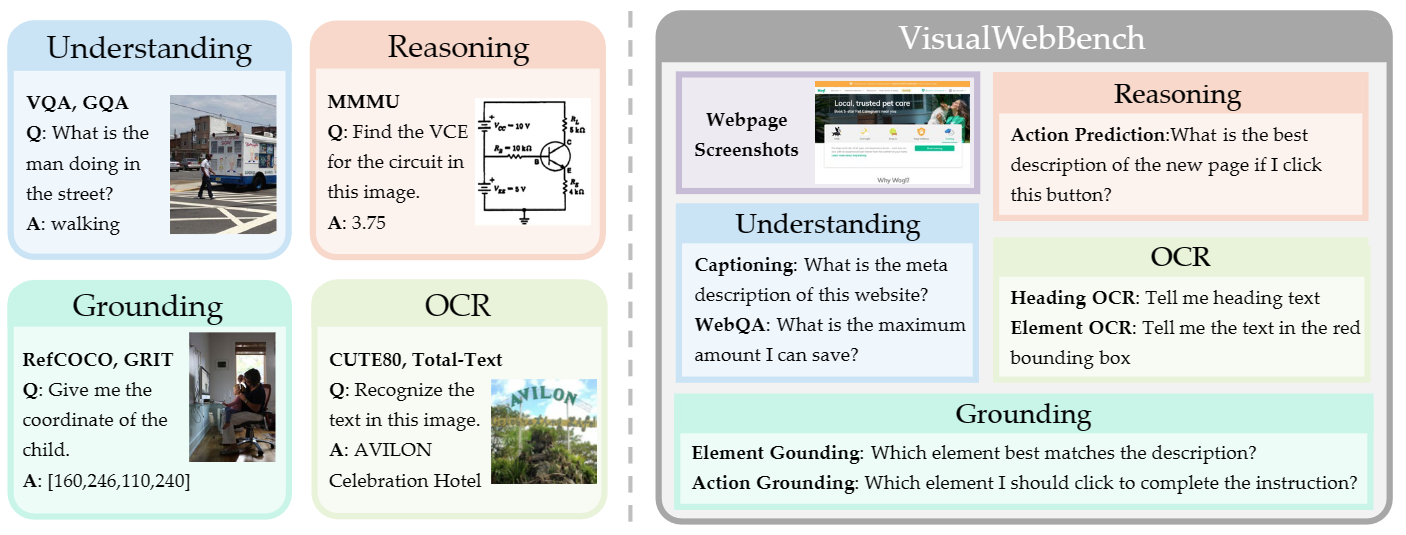
제안하는 VisualWebBench는 다음과 같은 특징을 가집니다:
- 포괄성(Comprehensiveness): VisualWebBench는 139개의 웹사이트와 1.5K개의 샘플에 걸쳐, 여행, 스포츠, 취미, 라이프스타일, 동물, 과학 등 12가지 다른 도메인과 87개의 서브도메인을 포괄합니다.
- 다중 세분성(Multi-granularity): VisualWebBench는 웹사이트 수준, 엘리먼트 수준, 액션 수준의 세 가지 레벨에서 MLLM을 평가합니다.
- 다중 작업(Multi-tasks): VisualWebBench는 MLLM의 이해력, OCR, 그라운딩 및 추론 능력을 평가하기 위해 설계된 일곱 가지 작업을 포함합니다.
- 높은 품질(High quality): 품질은 세심한 인간 검증과 큐레이션 노력을 통해 보장됩니다.
Alt text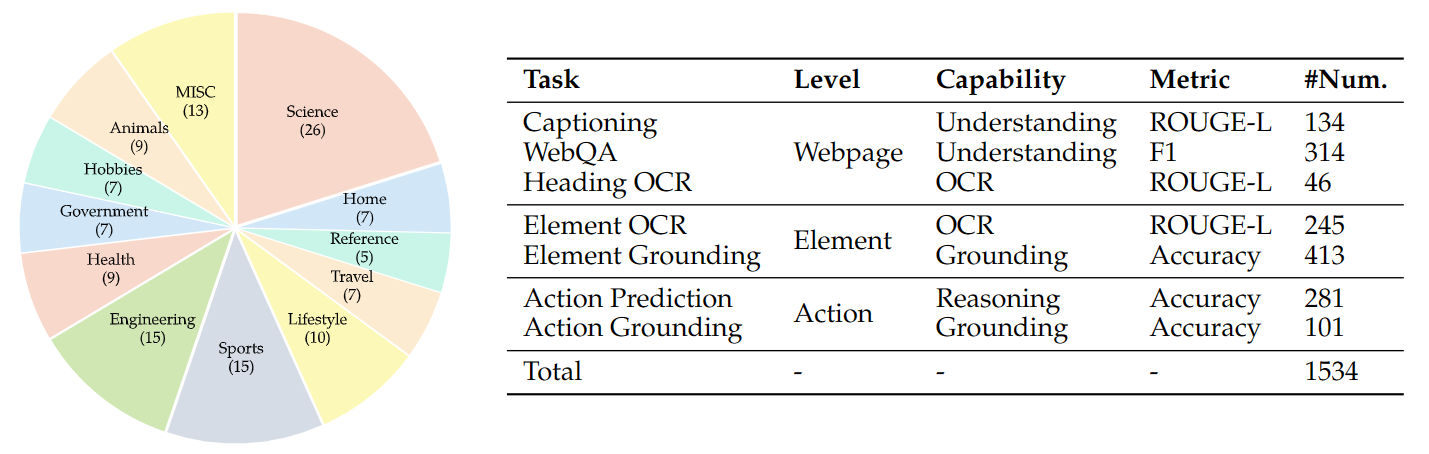
평가
저희는 GPT-4V, Claude, Gemini, 그리고 LLaVA 1.6 시리즈에 대한 평가 코드를 제공합니다.
자세한 내용은 run.sh를 참조하십시오.
실험 결과는 다음과 같습니다:
모델 추가 방법
model_adapters에서 모델 어댑터(adapter)를 구현합니다. 예시는model_adapters/llava_adapter.py를 참고하십시오.run.py를 수정하여 사용자의 모델을 추가합니다.configs에 설정 파일(config file)을 작성합니다.
문의처
- Junpeng Liu: [email protected]
- Yifan Song: [email protected]
- Xiang Yue: [email protected]
인용
본 작업이 도움이 되었다면, 다음 논문을 인용해 주십시오:
@misc{liu2024visualwebbench,
      title={VisualWebBench: How Far Have Multimodal LLMs Evolved in Web Page Understanding and Grounding?},
      author={Junpeng Liu and Yifan Song and Bill Yuchen Lin and Wai Lam and Graham Neubig and Yuanzhi Li and Xiang Yue},
...
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub AI Research의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기