2026년 7월 31일 - Link Blog
smevals - 모델, 프롬프트 및 하네스 (harnesses)를 평가하기 위한 소규모 평가 스위트 (eval suite). 저는 Jesse Vincent의 Prime Radiant 응용 AI 연구소와 함께 다양한 모델의 역량에 대한 질문에 답하는 데 도움이 될 이 평가 (evals) 프레임워크를 구축해 왔습니다.
그 결과물은 다양한 모델 구성에 대해 소규모 평가 스위트를 실행하고 결과를 채점할 수 있는 새로운 도구인 smevals입니다.
이 블로그 포스트는 해당 도구에 대해 자세히 설명합니다. 10초 요약 버전은 다음과 같습니다:
- 코딩 에이전트에게
run uvx smevals docs 명령어를
실행하여 도구를 학습하도록 하세요 (이 명령은 README를 출력합니다) - 그 다음 에이전트에게 평가 스위트를 구축하도록 요청하세요.
몇 개의 YAML 파일이 포함된 디렉토리 형태인 평가 (eval)를 생성하고 나면, 다음과 같이 모델에 대해 실행할 수 있습니다:
uvx smevals run path-to-eval/ -m gpt-5.5 -m claude-opus-4.6
실행 (Runs)은 채점 (grading) 작업과 별개로 취급됩니다. 다음과 같이 (정의된 체크 세트에 따라) 실행 결과를 채점할 수 있습니다:
uvx smevals grade path-to-eval/
그 다음, 로컬호스트 웹 서버를 실행하여 결과를 탐색할 수 있습니다:
uvx smevals serve path-to-eval/
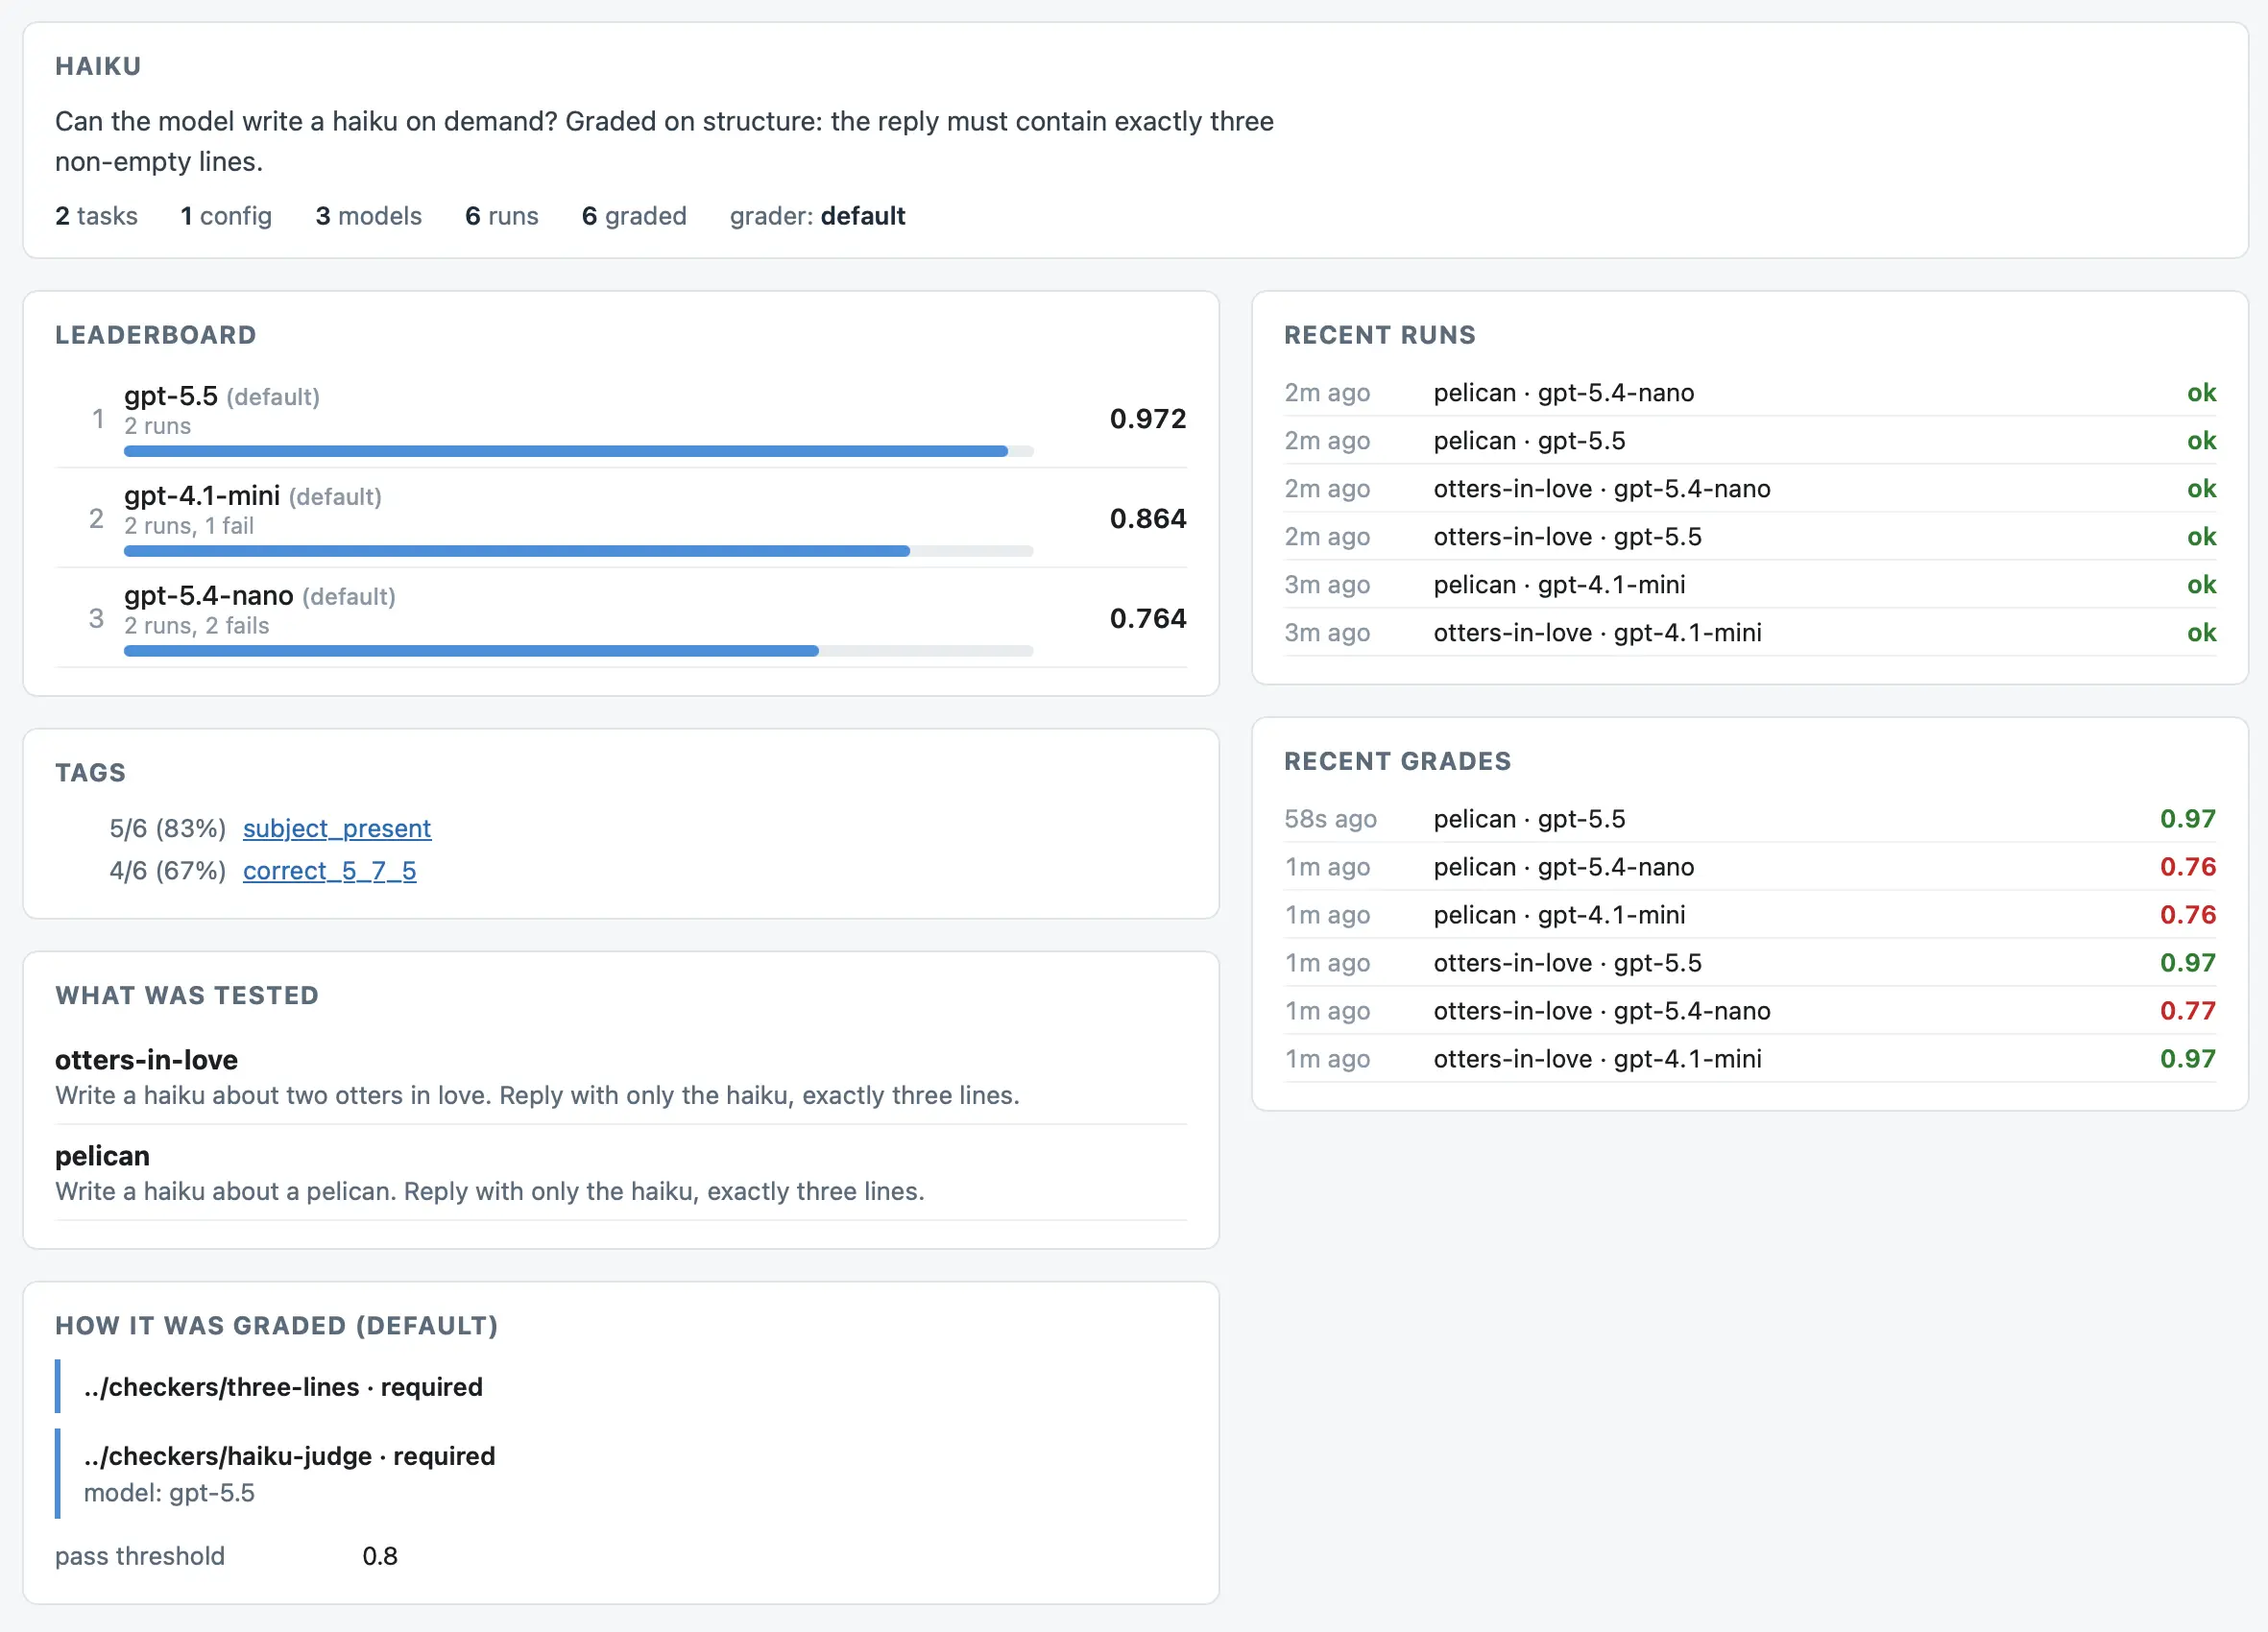
또는 smevals build 명령어를 실행하여 해당 보고서를 정적 HTML로 빌드할 수 있으며, 이를 어디든 호스팅할 수 있습니다. 다음은 모델이 하이쿠 (haikus)를 얼마나 잘 쓰는지 평가하기 위해 제가 구축한 평가 스위트의 예시입니다.
Screenshot of an evaluation dashboard for a haiku-writing benchmark, testing whether models can reply with exactly three non-empty lines. A header describes the eval, with panels below showing a leaderboard ranking three GPT models by score, lists of recent runs and recent grades, tag pass rates, the two haiku prompts that were tested, and details of the graders used with a 0.8 pass threshold.
저는 수년 동안 평가 (evals)에 대해 제가 선호하는 접근 방식을 찾아내기 위해 노력해 왔습니다. smevals는 이 아이디어에 대한 저의 세 번째 반복이며, 저에게는 적절하게 느껴집니다. 앞으로 이를 더 확장하고 제 자신의 프로젝트들에 적용해 보는 것을 기대하고 있습니다.
최근 기사
- OpenAI가 Hugging Face를 대상으로 수행한 의도치 않은 사이버 공격은 실제로 일어난 공상 과학이다 - 2026년 7월 22일
- Claude Code 팀의 Cat 및 Thariq와의 Fireside Chat - 2026년 7월 21일
- Kimi K3, 그리고 pelican 벤치마크에서 우리가 여전히 배울 수 있는 것 - 2026년 7월 16일