
ScaleDown과 Deep Agents를 활용한 장기 실행 에이전트 구축하기
요약
본 글은 장기 실행 에이전트 구축 시 필수적인 컨텍스트 관리 문제를 해결하기 위해 ScaleDown의 제약 디코딩 모델(CDMs)을 활용하는 방법을 다룹니다. ScaleDown은 요약, 압축, 추출 등 특정 작업에 특화되어 일반 LLM보다 빠르고 저렴하게 작동합니다. LangChain 및 Deep Agents를 위한 미들웨어를 제공하며, LangSmith에서도 지원되어 에이전트의 컨텍스트 관리를 효율적으로 돕습니다.
핵심 포인트
- ScaleDown은 제약 디코딩 모델(CDMs)을 사용하여 빠르고 저렴한 컨텍스트 처리를 가능하게 합니다.
- 요약, 압축, 추출 등 특정 작업에 특화된 네 가지 모델을 제공합니다.
- LangChain 및 Deep Agents 통합 미들웨어를 통해 에이전트의 컨텍스트 관리가 용이해졌습니다.
- 최대 1M 토큰 입력을 처리할 수 있어 긴 기록이나 문서를 한 번에 다룰 수 있습니다.
주요 요점
- 장기 실행 에이전트를 구축하려면 지속적인 컨텍스트 관리가 필요하며, 최신(frontier) LLM으로 이러한 결정을 내리는 것은 느리고 비용이 많이 듭니다. ScaleDown의 제약 디코딩 모델(Constrained Decoding Models, CDMs)은 이를 더 빠르고 저렴하게 만듭니다.
langchain-scaledown
에이전트에서 ScaleDown 모델을 쉽게 사용할 수 있게 하며, 요약(summarization), 도구 결과 압축(tool result compression), 추출(extraction)을 위한 미들웨어를 함께 제공합니다. 또한, ScaleDown은 이제 LangSmith LLM Gateway에서도 지원되므로 호출 기록이 추적되고 사용량 및 속도 제한에 포함됩니다.
장기 실행 에이전트 구축의 핵심은 컨텍스트 관리 기술입니다: 어떤 정보를 컨텍스트 창에 넣을지, 그리고 언제 넣을지를 결정하는 것입니다. 이는 오래된 히스토리를 요약하고, 큰 도구 결과를 압축하며, 긴 입력에서 적절한 데이터를 추출하는 것을 의미합니다. 이 모든 단계는 '결정' 과정입니다. 역사적으로 우리는 이러한 과정을 LLM으로 처리해 왔는데, 장기 실행 에이전트가 필요로 하는 규모에서는 느리고 비용이 많이 듭니다.
이러한 결정을 더 빠르고 저렴하게 만들기 위해, 이제 langchain-scaledown 통합과 ScaleDown의 제약 디코딩 모델(CDMs)을 위한 LangSmith LLM Gateway 지원을 갖게 되었습니다. 범용 LLM이 토큰 단위로 임의의 문자열을 작성하는 반면, CDM은 특정 작업을 위해 훈련되었으며 목록에서 레이블을 가져오거나 입력의 특정 구간과 같이 해당 작업이 허용하는 답변만 반환합니다. 이는 모델을 훨씬 작고, 빠르고, 저렴하게 만듭니다: ScaleDown에 따르면 이들은 이러한 좁은(narrow) 작업에서 최신 모델보다 200배 더 빠르고 467배 더 저렴하다고 보고합니다.
이 통합에는 LangChain 및 Deep Agents를 위한 세 가지 미들웨어가 포함됩니다. 하나는 오래된 히스토리를 요약하고, 하나는 큰 도구 결과를 압축하며, 하나는 대화에서 구조화된 데이터를 추출합니다. 본 게시물에서는 ScaleDown 모델이 무엇인지, 그리고 에이전트의 컨텍스트를 줄이는(scale down) 데 이를 어떻게 사용할 수 있는지 다룹니다.
ScaleDown은 어떤 모델을 제공하나요?
ScaleDown은 네 가지 모델을 가지고 있으며, 각각 단일 작업에 대해 훈련되었기 때문에 일반 목적 LLM보다 훨씬 효율적일 수 있습니다:
**요약(Summarize)**은 긴 텍스트를 짧게 요약합니다.**압축(Compress)**은 컨텍스트 블록을 질문과 관련된 부분으로 줄입니다.**추출(Extract)**은 텍스트에서 설명하는 필드를 뽑아내고, 각 필드에는 신뢰도 점수와 원본에서의 위치가 포함됩니다.**분류(Classify)**는 정의한 레이블에 대해 텍스트를 점수화하고 각각의 확률을 반환합니다. 분류가 이루어진 이유에 대한 자연어 설명을 반환할지 여부를 결정할 수 있습니다.
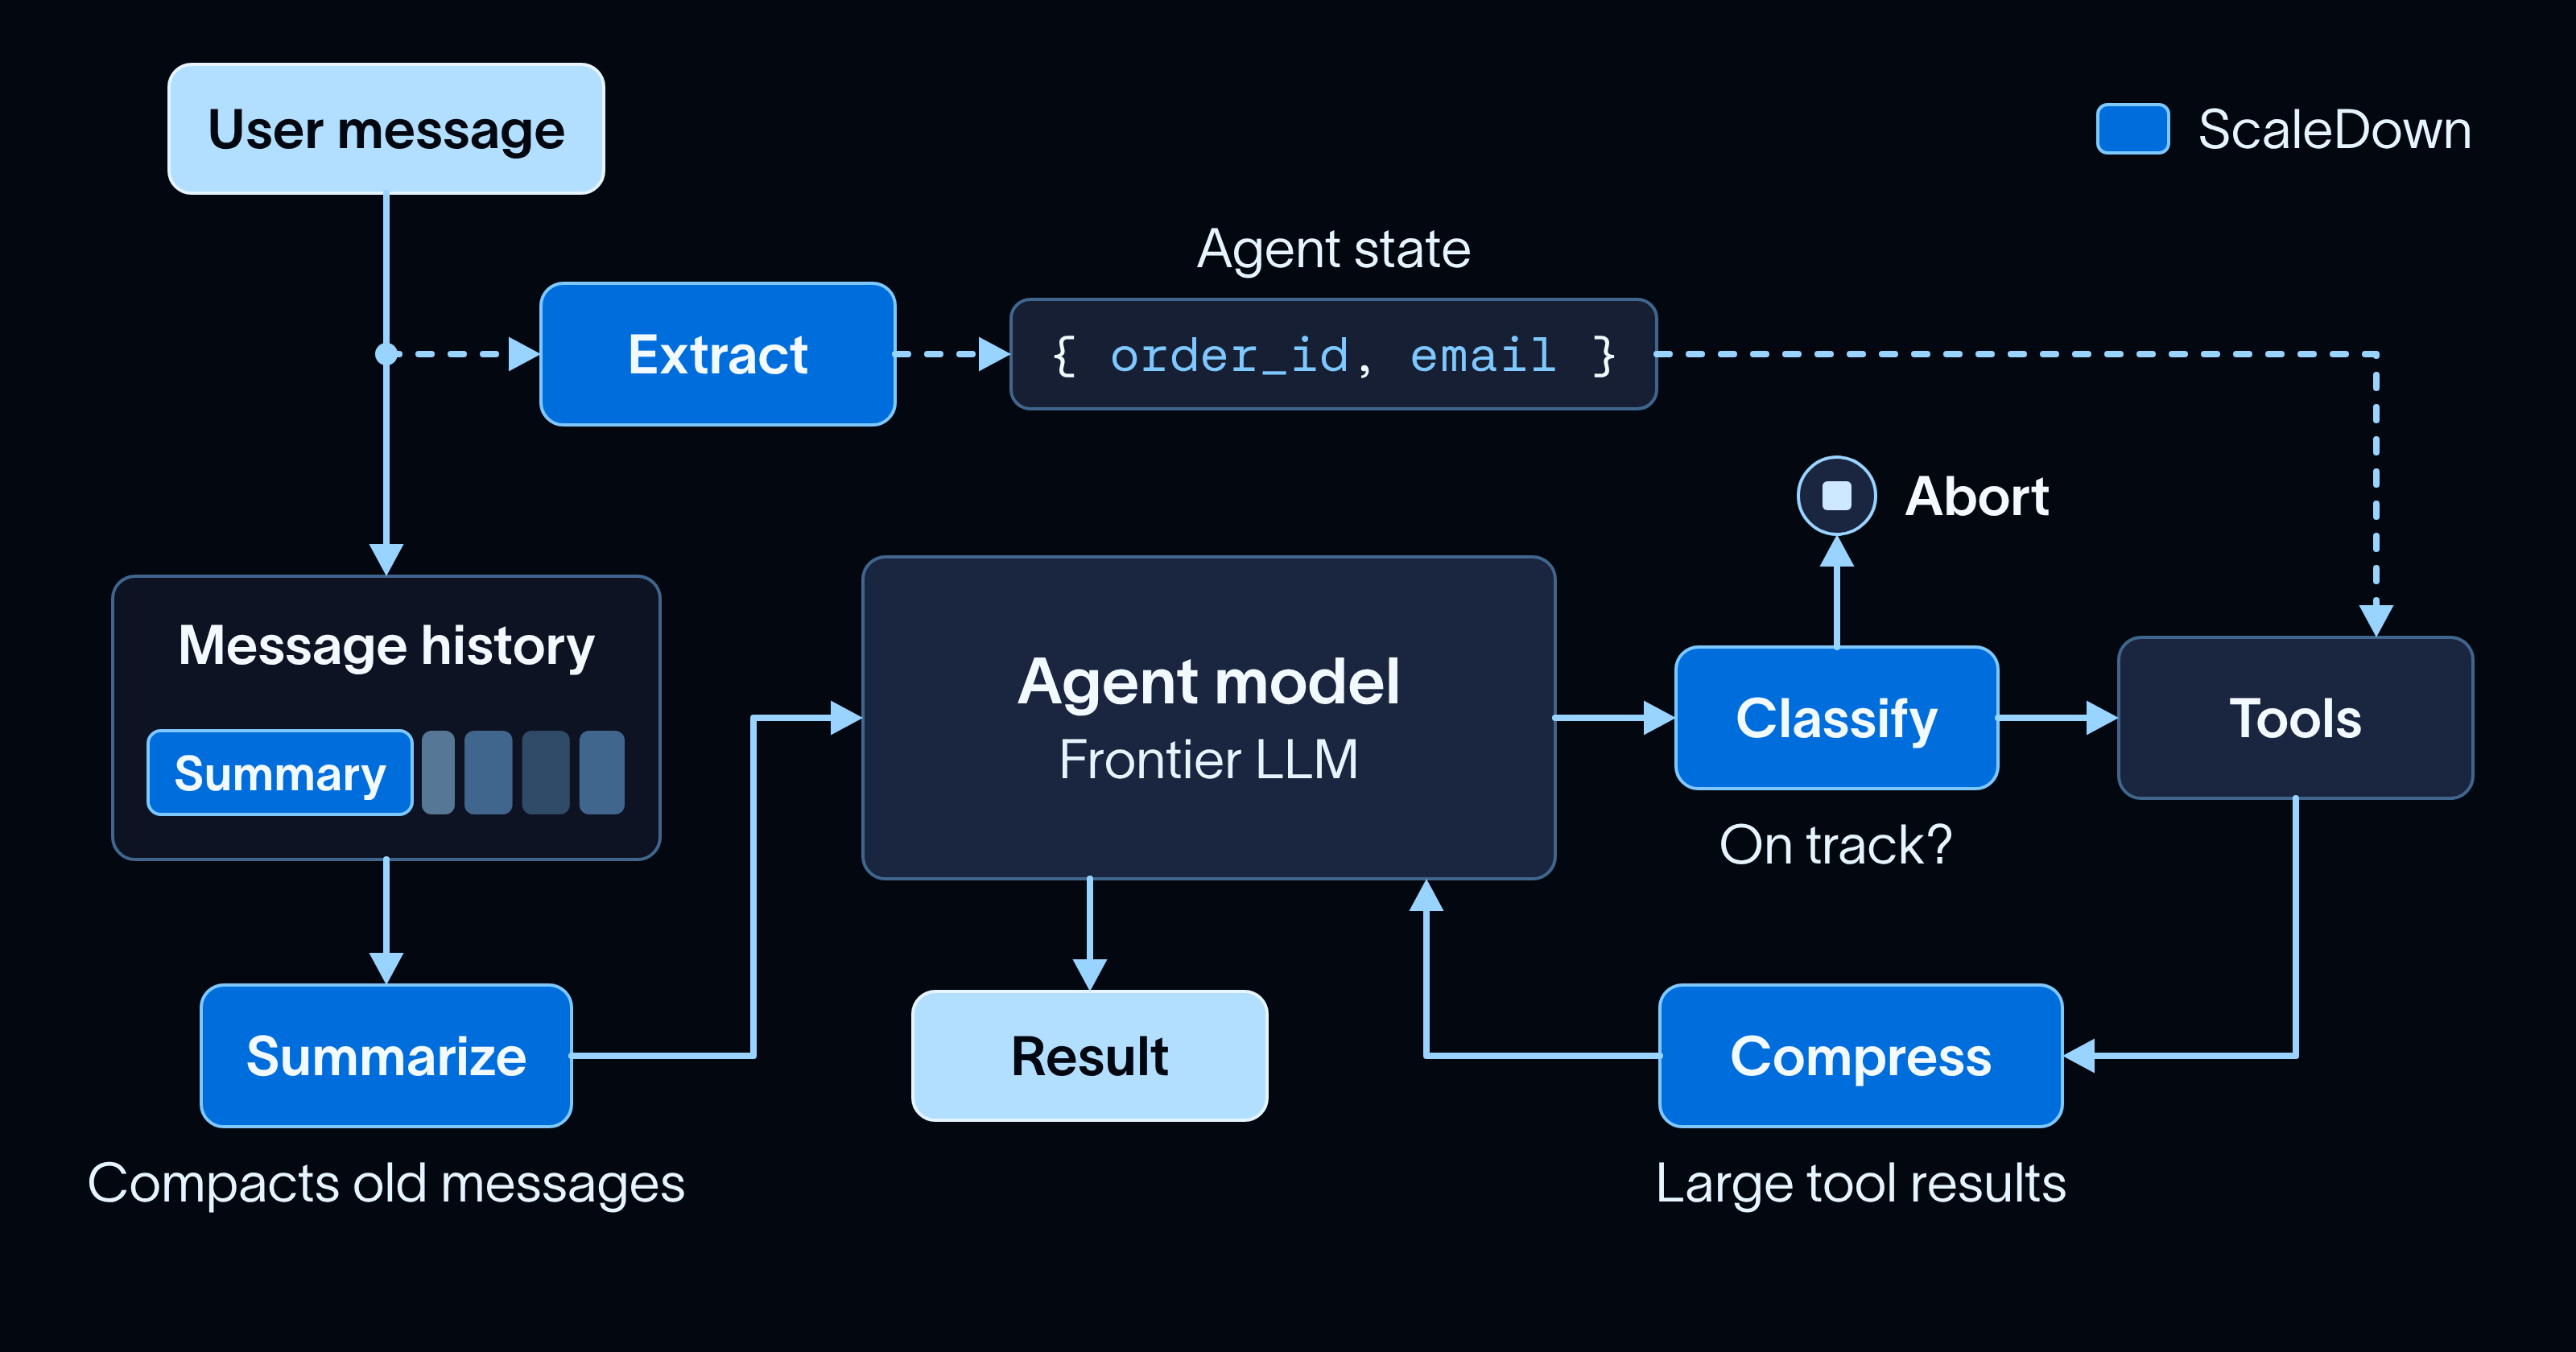
모든 모델은 최대 1M 토큰의 입력을 처리할 수 있으므로, 전체 계약서, 긴 정책 페이지, 또는 1시간 분량의 에이전트 기록을 청킹(chunking) 없이 한 번의 호출로 담을 수 있습니다. 또한 이들은 **멀티모달(multimodal)**입니다: Extract, Summarize, 그리고 Classify는 비정형 텍스트 외에도 이미지와 스캔된 PDF를 직접 처리하므로, 스크린샷이나 스캔된 인보이스도 입력으로 사용할 수 있습니다.
ScaleDown 자체 벤치마크에서 GPT-5.5, GPT-5.4 Mini, 그리고 GPT-5.4 Nano의 평균을 공용 데이터셋에 측정했을 때, Summarize는 41배 저렴하고 2.7배 빠르며, Compress는 138배 저렴하고 1.8배 빠르면서도 두 경우 모두 정확도가 더 높습니다.
만약 Jev와 같은 의사결정 모델을 사용해 본 적이 있다면, ScaleDown Classify가 익숙하게 느껴질 것입니다: 둘 다 확률과 함께 유형화된 답변을 반환합니다. Jev는 텍스트만 처리하며 질문당 최대 32K 토큰의 상태를 받습니다. Classify는 이미지 포함 최대 1M 토큰을 처리하며, 각 결정에 한 문장의 이유를 추가로 제공합니다. 에이전트가 레이블을 기반으로 티켓을 라우팅하거나 실행을 중단할 때, 이 이유 설명은 왜 그런지 알려주어 에이전트를 디버깅하기 쉽게 만듭니다.
메시지 기록 요약
장기 실행 에이전트는 기록(history)이 결국 컨텍스트 창 크기를 초과하기 때문에 요약 기능이 필요합니다. 1시간 동안 작업해 온 코딩 에이전트의 경우, 수십 개의 파일 읽기 및 도구 출력 기록을 가지고 있지만, 그중 대부분은 더 이상 문장 그대로 필요하지 않습니다. 이들을 다른 최신 모델 호출로 요약하는 것은 기록이 가득 찰 때마다 비용과 지연 시간을 추가합니다.
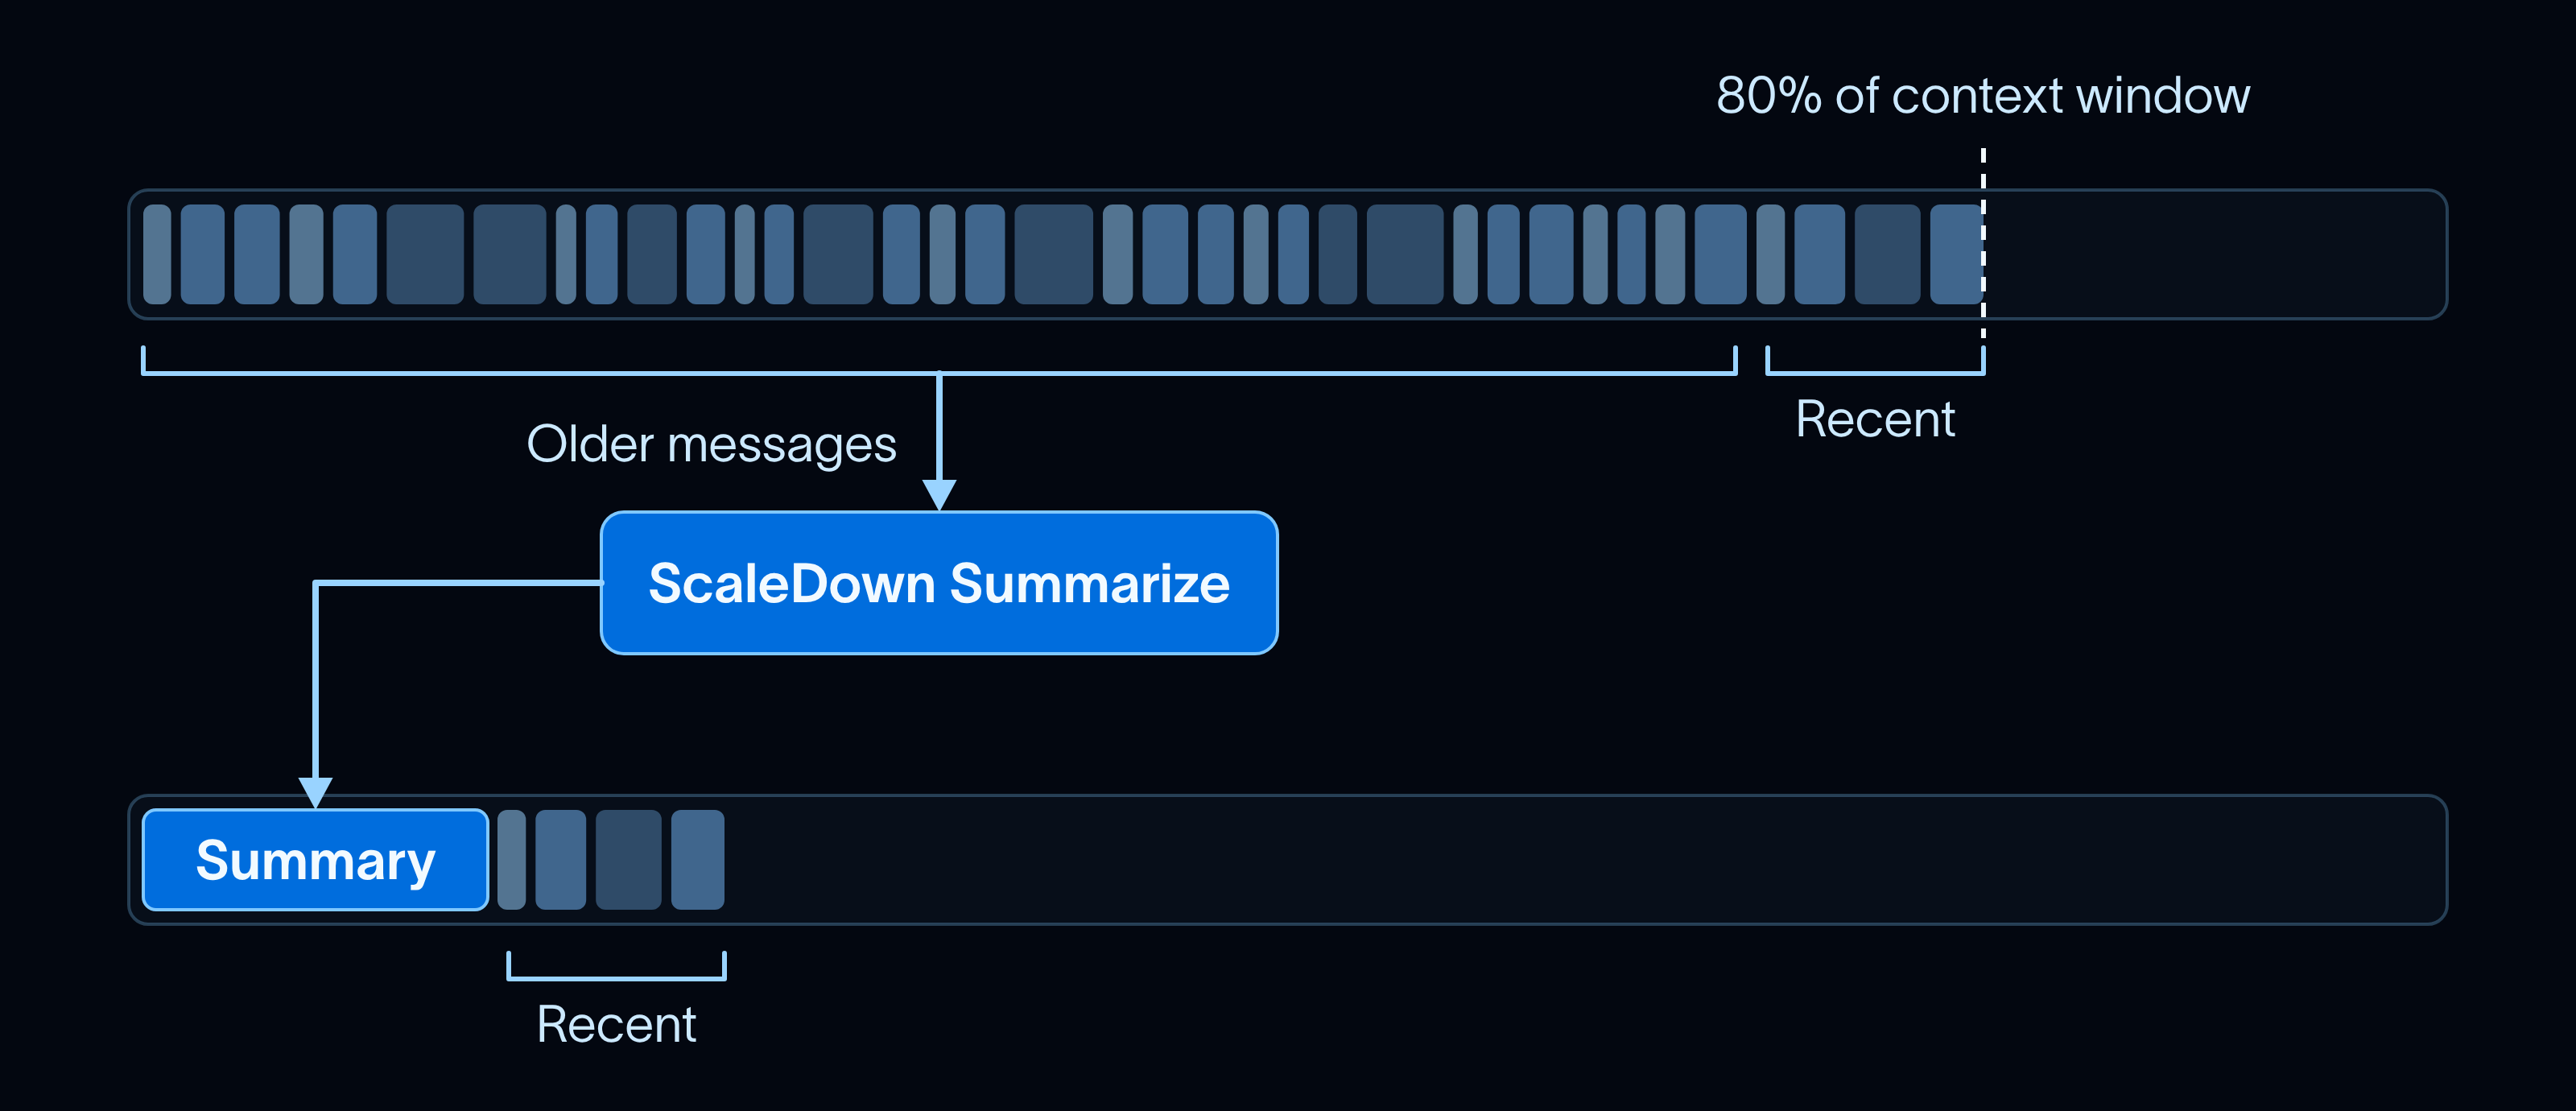
ScaledownSummarizationMiddleware는 Deep Agents의 내장 요약 미들웨어(middleware)를 대체합니다. 이는 동일한 trigger와 keep
요약할 시점과 보존할 최근 메시지를 결정하는 옵션이 있으며, ScaleDown은 이 요약을 작성합니다:
from deepagents import create_deep_agent
from langchain_scaledown import ScaledownSummarizationMiddleware
agent = create_deep_agent(...)
에이전트는 계획 및 코드 작성을 위한 자체 모델을 유지합니다. 요약만 ScaleDown으로 이동하며, 기본적으로 LangChain의 요약 프롬프트와 동일한 섹션(의도(intent), 요약(summary), 아티팩트(artifacts), 다음 단계(next steps))을 반환합니다. 만약 ScaleDown 호출이 실패하면 미들웨어는 히스토리를 그대로 유지하고 에이전트는 계속 실행됩니다. 이와 동일한 미들웨어는 LangChain의 create_agent에서도 작동합니다.
도구 결과 압축
장기 실행 에이전트는 많은 도구를 호출하며, 모든 큰 결과는 나머지 실행 동안 컨텍스트에 남아 있습니다. 가져온 웹 페이지는 에이전트가 단지 한 단락만 필요할 때 수만 자까지 늘어날 수 있습니다. 이후의 모든 단계에서 이 토큰들에 대해 다시 비용을 지불하게 되며, 컨텍스트가 채워짐에 따라 에이전트는 과제에 집중하는 능력이 떨어집니다.
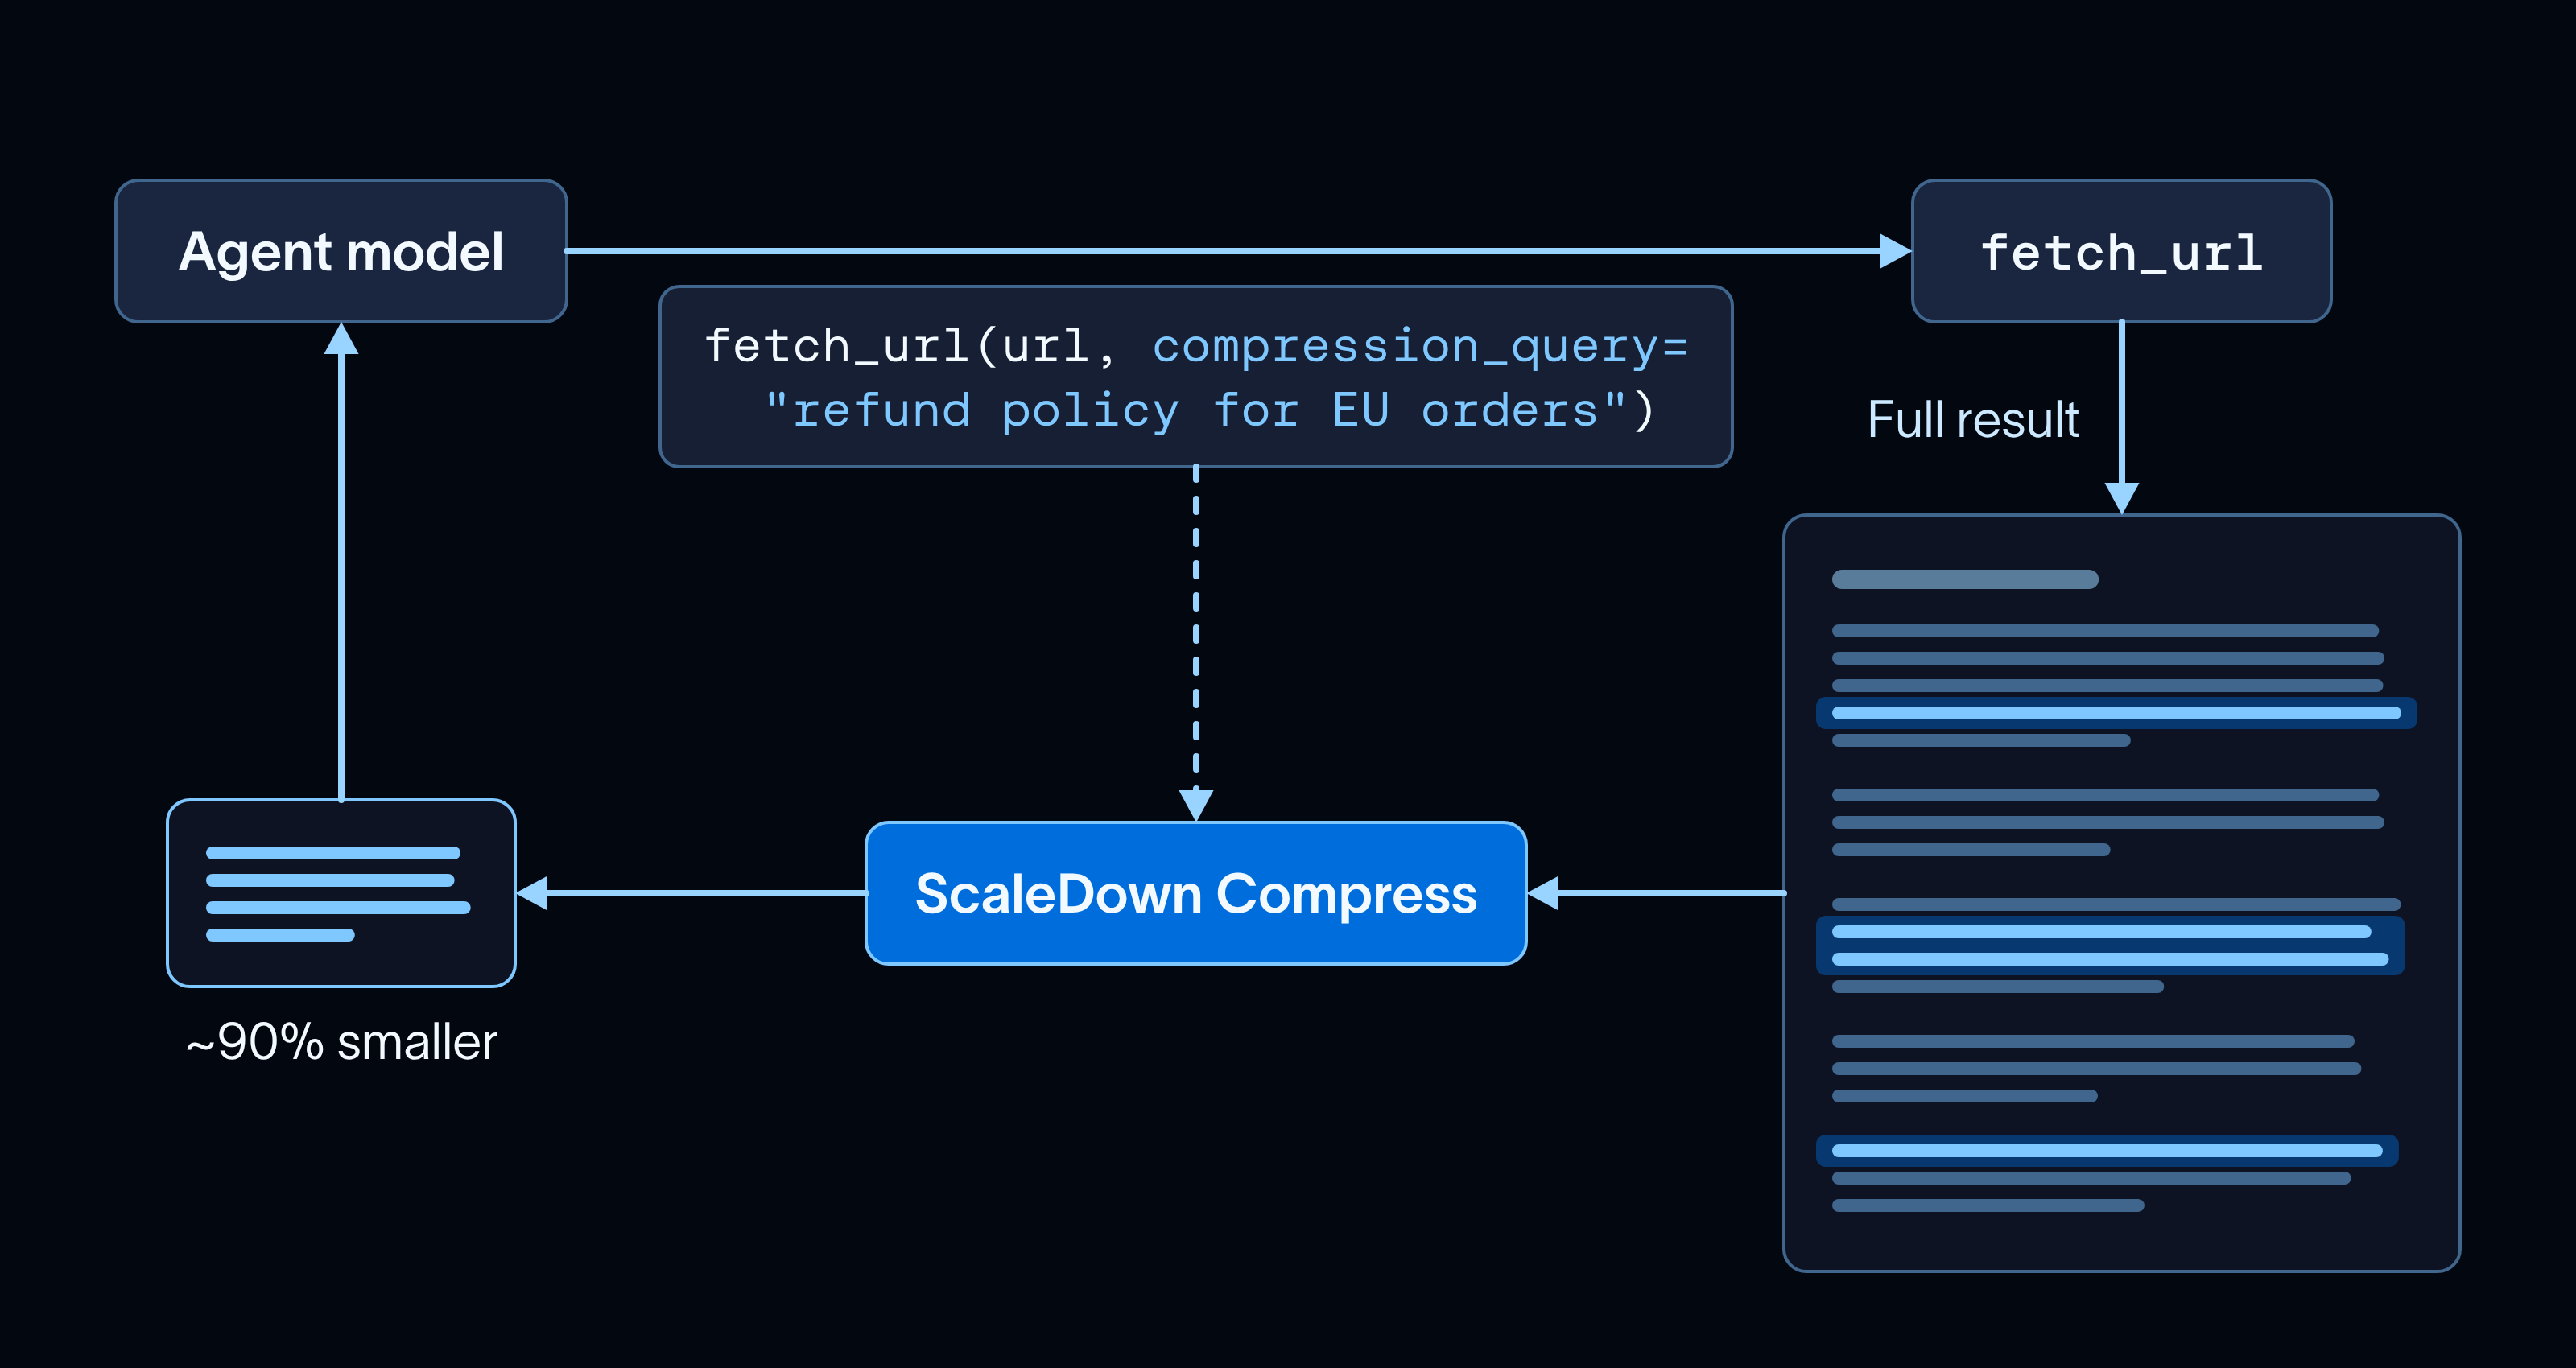
ScaledownToolCompressionMiddleware는 도구에 선택적 compression_query 매개변수를 추가합니다. 모델이 결과의 일부만 필요할 때, 도구 호출 시 compression_query를 채웁니다. 예를 들어 `
구조화된 데이터 추출 (Extracting structured data)
에이전트는 읽은 내용에서 ID, 날짜 또는 다음 도구 호출에 필요한 필드와 같은 특정 값을 지속적으로 뽑아냅니다. 이러한 추출 과정은 에이전트 루프 내부에 위치하므로, 매 턴마다 지연 시간을 추가하지 않을 만큼 충분히 빠르면서도, 도구가 그 값을 그대로 사용할 수 있을 만큼 정확해야 합니다.
예를 들어, 지원 에이전트가 티켓을 제출하기 전에 주문 번호, 오류 메시지 및 고객의 이메일 주소가 필요합니다. 메인 모델이 이를 도구 인수로 채울 수는 있지만, 오류 코드를 패러프레이징하거나 이메일 주소를 정확하게 복사하는 대신 오타를 낼 수 있습니다.
ScaledownExtractionMiddleware는 이 단계를 ScaleDown에 맡깁니다. 사용자는 각 필드를 일반 언어로 설명하고, Extract가 텍스트에서 값을 복사합니다. 필드는 레이블 세트일 수도 있으며, 이 경우 ScaleDown이 Classify를 통해 답변하여 이슈 유형별로 티켓을 라우팅할 수 있습니다. 실행의 첫 번째 모델 호출 전에, 미들웨어는 사용자 메시지를 Extract에 보내고 해당 필드를 scaledown_extraction 아래 에이전트 상태에 저장하며, 여기서 도구들이 이 값을 읽을 수 있습니다:
from deepagents import create_deep_agent
from langchain.tools import ToolRuntime, tool
from langchain_scaledown import ScaledownExtractionMiddleware
...
Extract는 오직 사용자 메시지만 읽고 에이전트의 답변은 절대 읽지 않기 때문에, 모든 값은 고객이 실제로 말한 것입니다. 체크포인터(checkpointer)를 사용하면 추출 과정이 각 턴마다 재실행되므로, 고객이 세부 정보를 추가함에 따라 기록이 채워집니다. 예를 들어, *
장기 실행 에이전트에서 주의해야 할 한 가지 상태는 '드리프트(drift)'입니다. 이는 동일한 실패하는 도구 호출을 반복하거나 비생산적인 순환에 갇히는 것을 의미합니다. 이를 위한 사전 구축된 미들웨어는 없지만, 자체 커스텀 미들웨어를 통해 모든 ScaleDown 모델을 호출할 수 있습니다. 여기서는 모델 호출 후 실행되는 회로 차단기(circuit breaker)를 소개합니다. 이 차단기는 히스토리를 ScaleDown Classify에 전송하고, 경로에서 벗어났다고 판단되면 실행을 중지시킵니다:
import os
import requests
from deepagents import create_deep_agent
...
Classify는 각 레이블에 대한 확률을 반환하므로, 차단기가 작동하기 전에 얼마나 자신감을 가져야 하는지를 사용자가 선택할 수 있습니다. 이 모델의 한 줄짜리 이유(reason)가 최종 메시지에 표시되므로, 왜 실행이 중지되었는지 알 수 있습니다. 좀 더 부드러운 버전은 첫 번째 트리거에서 실행을 종료하지 않습니다. 대신 그 이유를 대화에 추가하여 방향 전환을 위한 자극제(nudge)로 사용하고, 에이전트가 다시 드리프트할 때만 중지시킵니다.
이 네 가지 섹션은 ScaleDown 모델이 적용될 수 있는 몇 가지 지점을 보여주며, 이 목록은 포괄적이지 않습니다. 추출(extract)/요약(summarize)을 긴 도구 결과에 실행하거나, 런타임 모델 라우팅을 위한 분류(classification)와 같이 조합하여 사용할 수 있습니다. ScaleDown Cookbook을 확인하여 다양한 유형의 데이터 전반에 걸쳐 CDM 모델을 사용하는 다른 방법들을 살펴보세요.
LangSmith LLM Gateway에서의 ScaleDown
The LangSmith LLM Gateway를 사용하면 하나의 LangSmith API 키로 여러 제공업체의 모델을 호출하고, 모든 호출을 추적하며, 지출 및 속도 제한을 강제할 수 있습니다. 이제 ScaleDown은 /scaledown 경로에서 직접적인 모델 접근 제공업체 중 하나가 되었습니다.
관리자는 한 번 SCALEDOWN_API_KEY로 워크스페이스의 제공업체 비밀(provider secrets)에 ScaleDown 키를 추가합니다. 그런 다음 langchain-scaledown을 게이트웨어를 가리키도록 설정하고 LangSmith 키로 인증합니다:
export SCALEDOWN_BASE_URL="https://gateway.smith.langchain.com/scaledown"
export SCALEDOWN_API_KEY="$LANGSMITH_API_KEY"
각 ScaleDown 호출은 LangSmith 트레이스로 표시되며, 다른 모델 호출과 동일한 제한에 포함됩니다.
ScaleDown을 사용하지 말아야 할 때
개방형 생성을 위해 일반 목적의 LLM을 유지합니다. 예를 들어 코드를 작성하거나 답장을 초안 작성하고 계획을 세우는 등의 작업입니다. 이는 저희 Jev 포스트에서 제시한 '기본적으로 저렴하게, 예외적인 경우에만 최첨단 기술 사용' 접근 방식을 따릅니다. 즉, 어려운 부분에는 대규모 일반 목적 LLM을 사용하고, 그 주변의 고빈도 단계에는 전문화된 모델을 사용하는 것입니다.
ScaleDown은 매 턴마다 실행하기에 충분히 빠르고 저렴하므로, 에이전트가 컨텍스트 관리가 의존하는 구조적 결정을 내릴 때 메인 루프를 느리게 하거나 그 부분에 대해 최첨단 비용을 지불할 필요 없이 수행할 수 있습니다. 장기 실행 에이전트에서는 이러한 결정들이 거의 매 턴마다 발생하므로, 절감액이 빠르게 쌓입니다.
시작하기
통합 기능을 설치하고 ScaleDown API 키를 설정하세요:
uv pip install -U langchain-scaledown
export SCALEDOWN_API_KEY="..."
새로운 ScaleDown 계정은 50M 무료 토큰을 받습니다. ScaleDown 통합 문서는 각 미들웨어의 구성 옵션을 다루고 있습니다. langchain-scaledown을 사용해보고, LangChain 포럼, X 또는 GitHub에서 의견을 알려주세요.
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기