
LangSmith에서 AI 검색을 이용해 행동별 에이전트 트레이스 검색하기
요약
LangSmith에 AI Search 기능이 추가되어, 사용자가 'PII 유출'이나 '좌절 여부'와 같은 자연어 질문을 통해 에이전트 트레이스를 의미론적으로 검색할 수 있게 되었습니다. 이 기능을 통해 복잡하고 방대한 에이전트 트레이스 데이터에서 특정 행동 패턴이나 문제를 쉽게 찾아내고, 에이전트 성능 개선에 활용할 수 있습니다.
핵심 포인트
- 자연어 질문으로 트레이스의 의미를 이해하여 검색 가능
- PII 유출, 사용자 좌절 등 복잡한 행동 패턴 탐지 용이
- LangSmith가 트래젝토리 정규화를 통해 컨텍스트 블랏 감소
- AI Search는 기존 필터와 결합하여 강력한 검색 기능 제공
핵심 요약
- 이제 AI Search를 사용하면 '사용자가 좌절했는지?', 'PII가 유출되었는지?'와 같이 트레이스의 의미론적 이해를 기반으로 대화를 찾을 수 있습니다.
- 일반 언어로 행동을 설명하면, 빠른 의사 결정 모델이 트레이스를 읽고 해당 행동이 발생한 트레이스를 반환합니다.
- LangSmith는 쿼리 결과를 빠르게 제공하고 컨텍스트 블랏(context bloat)을 줄이기 위해 트래젝토리(trajectories)를 사용하여 트레이스를 정규화합니다.
에이전트 트레이스는 크고, 멀티모달하며, 정보 밀도가 높습니다. 사용자 입력, 에이전트의 응답 방식, 논리적 실패와 같은 핵심 세부 정보를 포착합니다. 이 때문에 트레이스는 사용자 행동을 이해하고 에이전트 성능을 개선하는 데 독보적으로 가치 있지만, 기존 데이터 플랫폼은 이러한 대용량의 비정형 페이로드(payload)를 처리하도록 설계되지 않았습니다.
트레이스 데이터를 유용하게 만들기 위해서는 팀들이 전체 수명 주기(full lifecycle)를 지원할 수 있는 인프라가 필요합니다. 즉, 대용량 실행을 수집하고 저장하며, 트레이스를 유연하게 쿼리하고, 주석(annotations)과 같은 디버깅, 제품 분석 및 운영 워크플로우를 위한 보기(views)로 변환하는 것입니다. 이것이 바로 저희가 LangSmith에서 트레이스 데이터에 특화하여 구축한 데이터베이스인 SmithDB와, 최근 팀들이 자신들의 트레이스 위에 맞춤형 보기를 만들 수 있게 해주는 Custom Apps를 만든 이유입니다.
오늘, 저희는 자연어를 사용하여 트레이스를 쿼리하는 새로운 방법인 AI Search를 추가합니다.
AI Search를 구축한 이유
각 트레이스는 사용자 입력, 에이전트 추론(reasoning), 도구 호출(tool calls) 및 응답을 포함하며, 이는 에이전트가 어디에서 잘 수행하고 어디에서 실패하는지 이해하는 데 필요한 모든 정보입니다. LangSmith를 사용하는 팀들은 종종 평가 데이터셋을 위한 예시나 주석 대기열의 검토자를 위해 에이전트 트레이스를 마이닝하여 발견합니다.
하지만 적절한 트레이스를 발견하는 것은 번거로울 수 있습니다. 'PII가 유출되었는지?' 또는 '사용자가 좌절했는지?'와 같은 질문은 태그나 메타데이터와 같은 단일 트레이스 속성에 깔끔하게 매핑되지 않으며, 전체 텍스트 검색(full-text search)으로도 답변할 수 없습니다. 이는 트레이스 내용에 대한 이해를 필요로 합니다. 지금까지는 이를 위해 미리 평가자(evaluator)를 설정하거나 트레이스를 수동으로 검토해야 했습니다.
이것이 바로 AI Search를 구축한 이유입니다. 찾고자 하는 행동을 설명하면 LangSmith가 해당 행동이 발생했던 트레이스를 반환합니다. 이를 통해 '건초 더미 속의 바늘' 같은 트레이스를 찾아내고, 문제가 되는 패턴을 임시적으로 검색할 수 있습니다.
검색 가능한 내용
트레이스 콘텐츠에 나타나는 모든 것을 검색할 수 있습니다. 작업을 완료했다고 말했지만 실제로는 그렇지 않은 에이전트를 찾거나, 답변에 좌절하거나 거부감을 느낀 사용자를 찾거나, PII(개인 식별 정보)가 유출된 모델 요청을 찾거나, 구독 취소를 시도하는 사람을 찾을 수 있습니다. 제품 팀은 '지원하지 않는 통합 요청', '경쟁사 언급', 또는 '온보딩에 혼란스러워하는 사용자'와 같은 내용을 검색하여, 사용자의 언어로 제품이 어느 부분에서 부족한지 확인할 수 있습니다.
AI Search는 기존에 사용하던 필터와도 함께 작동하므로, 오류가 발생한 트레이스만으로 검색을 실행하거나 특정 태그를 가진 트레이스만으로 검색할 수도 있습니다.
구축 방법
모델이 모든 트레이스를 읽어야 하는 이유
벡터 검색(Vector search)은 정확한 단어 대신 의미로 검색하는 일반적인 방식입니다. 이는 사용자의 질의와 각 트레이스를 임베딩(embedding), 즉 텍스트가 무엇에 관한 것인지를 포착하는 짧은 숫자 목록으로 변환합니다. 그런 다음 질의의 임베딩과 가장 가까운 임베딩을 가진 트레이스를 반환합니다. 이는 청구 관련 대화 찾기와 같은 주제 검색에는 잘 작동합니다. 하지만 임베딩은 전체 트레이스를 하나의 작은 벡터에 담기 때문에, 이 압축 과정에서 손실이 발생할 수 있습니다. 질의와 관련된 중요한 세부 정보가 손실될 수 있다는 뜻입니다. 에이전트가 작업을 성공적으로 수행한 트레이스와 단순히 그렇게 했다고만 말한 트레이스는 거의 동일한 임베딩을 가질 수 있습니다. 이 둘을 구분하려면, 질문과 함께 트레이스의 실제 단어를 읽는 모델이 필요하며, 그래야 무엇이 일어났는지 추론할 수 있습니다.
최근까지 검색 시점에서 이를 수행하는 것은 너무 느리고 비용이 많이 들었습니다. Fast decision models가 이 문제를 해결했습니다. 이 모델들은 입력에 대한 하나의 좁은 질문에 대해 빠르고 저렴하게 답변하여 대규모로 실행할 수 있게 했습니다. AI Search는 결정 모델 추론(decision model inference)을 에이전트 관찰 가능성(agent observability)을 위한 데이터 계층인 SmithDB와 결합합니다. 트레이스(traces)가 도착함에 따라, SmithDB는 이를 궤적(trajectories)으로 변환합니다. 검색을 실행하면 필터가 후보군을 좁히고, 결정 모델이 남아 있는 각 궤적을 설명과 비교하여 확인합니다.
트레이스는 크고 다양한 형식으로 존재함
트레이스는 OpenAI 및 Anthropic SDK, LangChain, LangGraph, Vercel AI SDK, OpenTelemetry 등 여러 소스에서 옵니다. 각각 메시지를 약간 다르게 기록합니다. 또한 트레이스는 중복되는 경향이 있습니다. 에이전트는 종종 모든 LLM 호출(LLM call)마다 대화 기록을 다시 전송하므로, 첫 번째 메시지가 그 이후의 모든 호출에 다시 나타납니다.
SmithDB는 이러한 트레이스를 세션별 궤적으로 변환합니다. 궤적은 에이전트 작업의 정제된 보기(distilled view)입니다: 각 메시지, 도구 호출(tool call), 도구 결과가 한 번씩 나열됩니다. SmithDB는 트레이스가 도착함에 따라 이를 구축하고 모든 지원되는 형식을 동일한 형태로 만듭니다.
AI Search는 원시 트레이스 대신 궤적을 분석합니다. 모든 형식이 동일한 궤적 형태를 가지기 때문에, 하나의 검색이 다른 SDK로 구축된 에이전트 전반에서 작동할 수 있습니다. 중복 메시지를 제거하면 컨텍스트 블랏(context bloat)이 줄어들어 검색 속도가 빨라집니다. 또한 궤적은 전체 세션을 다루므로,
일부 트레이스는 이처럼 작은 샘플에서도 백만 토큰을 넘었습니다. 희귀한 행동을 검색한다는 것은 많은 대화 내용을 읽어야 함을 의미하므로, AI Search는 정기적으로 이러한 크기의 데이터에 직면하며 모든 토큰을 읽을 수 없습니다.
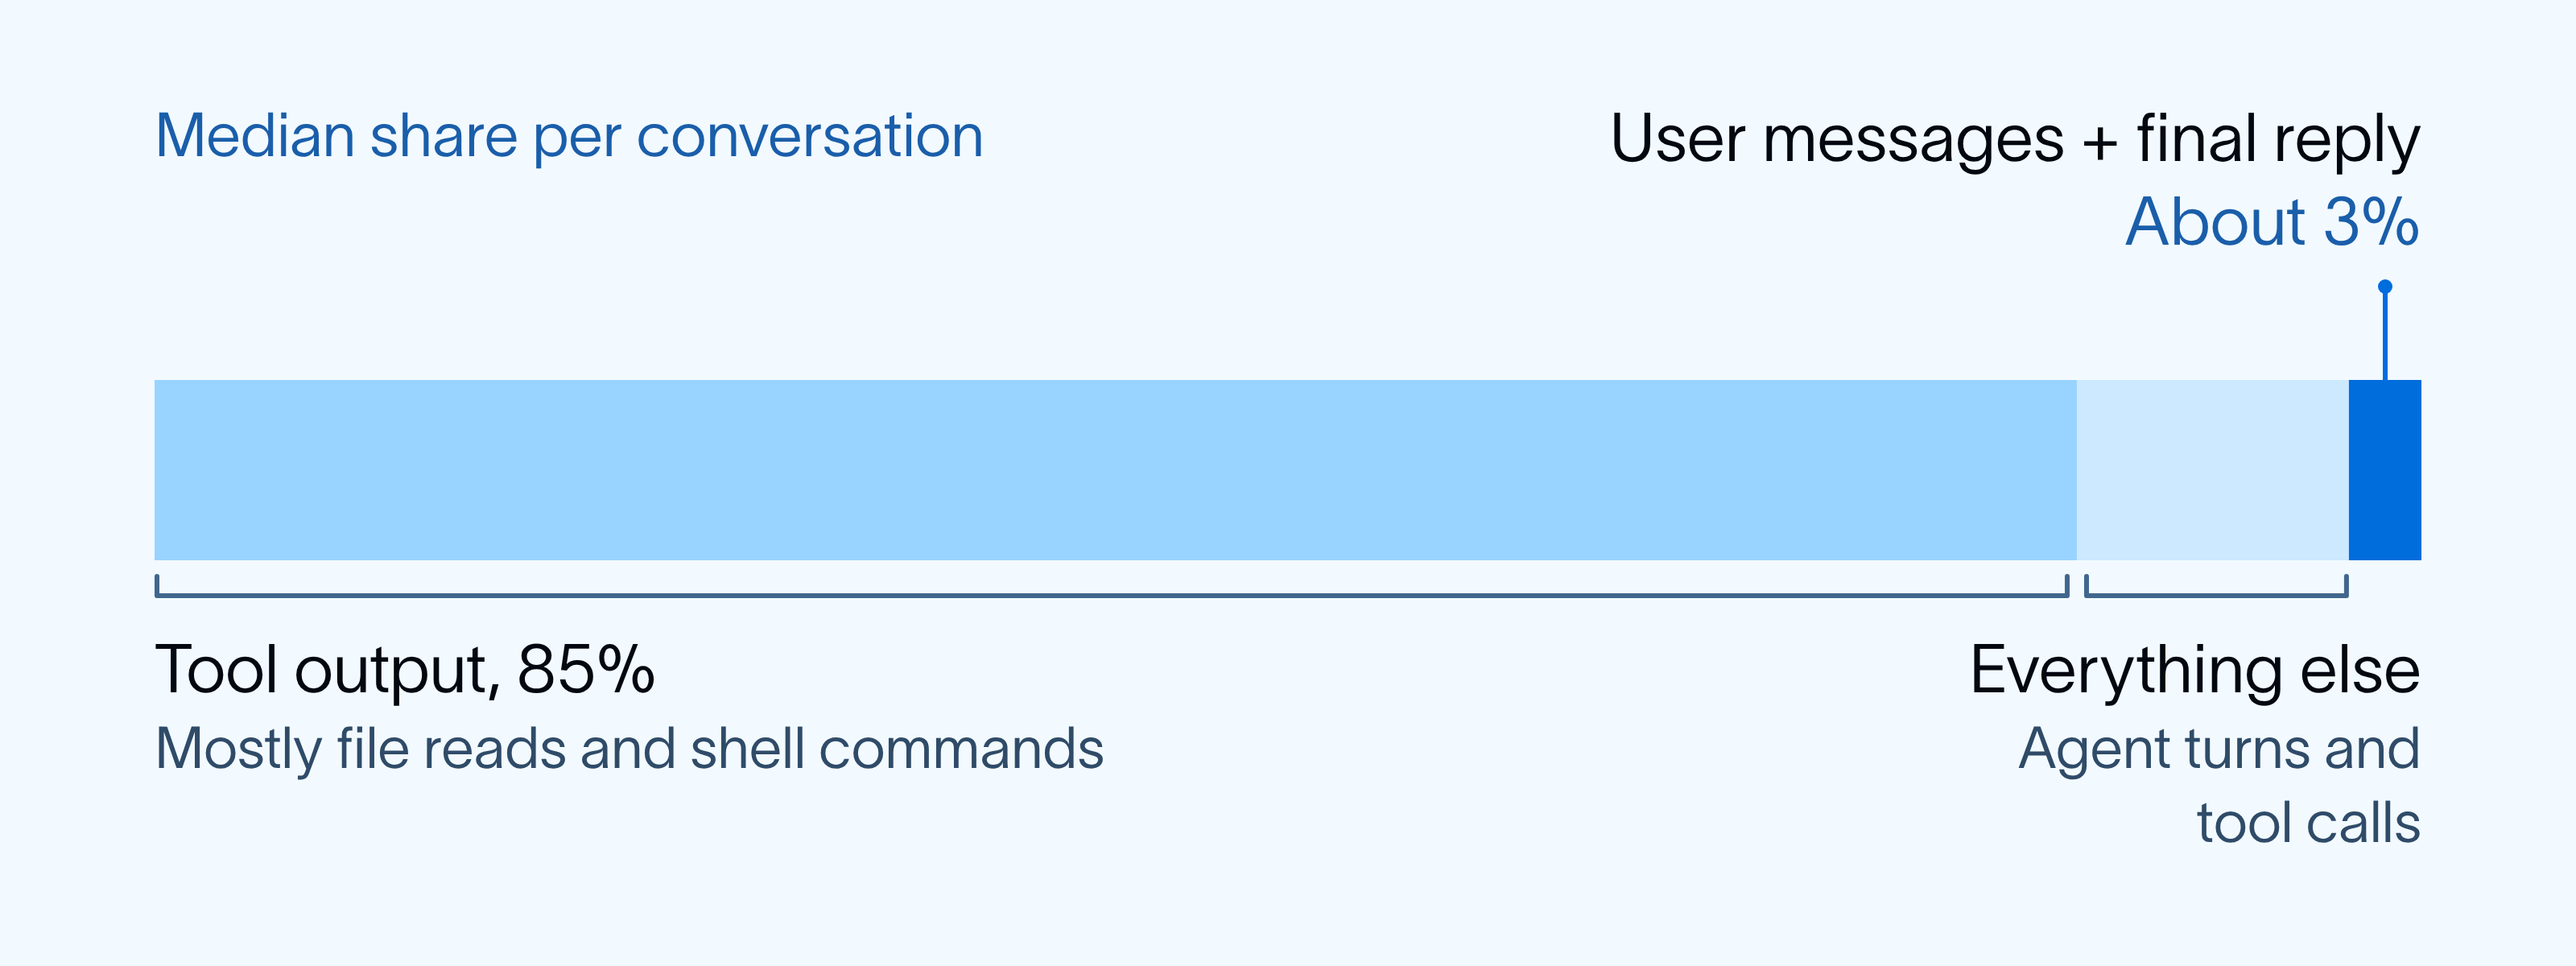
하지만 대부분의 질문은 그 모든 토큰이 필요하지 않습니다. 많은 질문은 사용자가 무엇을 요청했고 에이전트가 어떻게 응답했는지에 관한 것입니다. 중간값 대화에서 72K 토큰 중 약 2K는 사용자 메시지와 에이전트 답변에서 나왔습니다. 약 85%는 주로 파일 읽기 및 셸 명령어와 같은 도구 출력(tool output)이었습니다.
각 트레이젝토리(trajectory)는 우선순위에 따라 채워지는 고정 토큰 예산(token budget)을 받습니다. 사용자 메시지와 사용자에 대한 에이전트 답변이 가장 먼저 들어갑니다. 나머지 예산은 모든 다른 항목, 즉 중간 AI 메시지(에이전트의 추론 및 도구 호출), 도구 결과(tool results), 시스템 메시지에 할당됩니다. 다음 메시지가 일부만 맞으면, 예산을 채우도록 잘리고 그 이후 내용은 버려집니다.
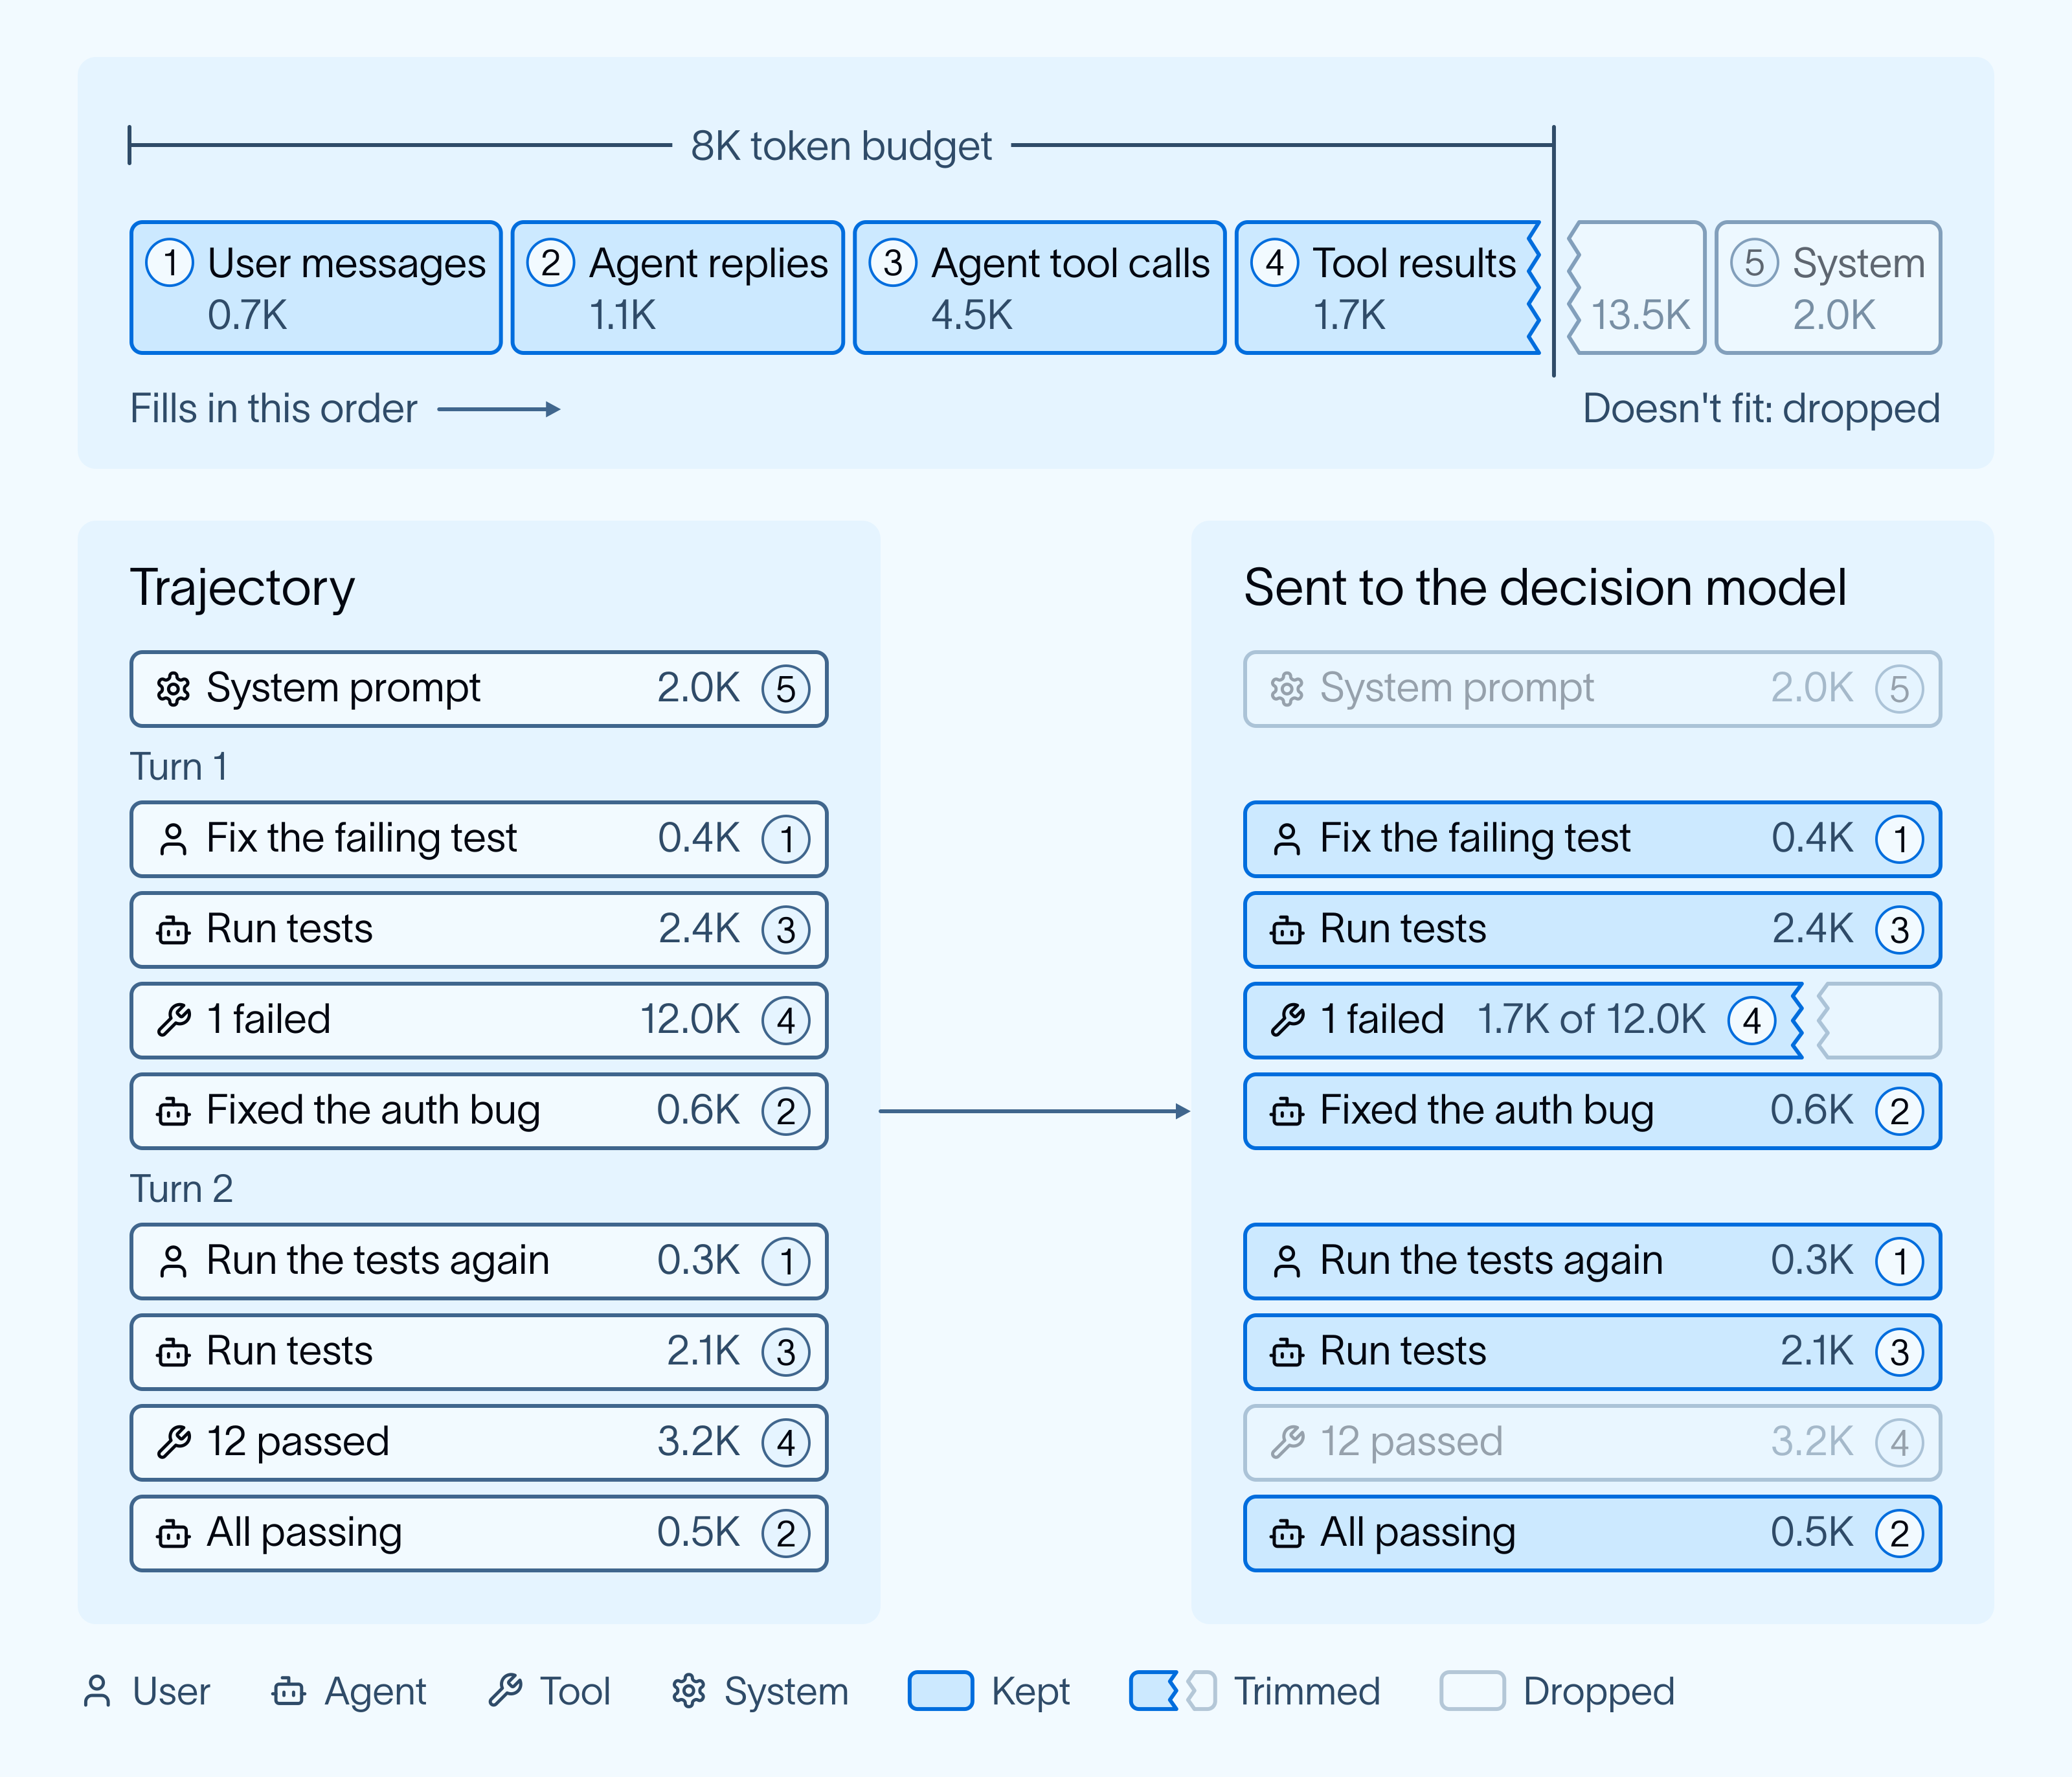
대규모 환경에서 검색 속도 유지하기
SmithDB는 방대한 양의 에이전트 트레이스 데이터를 수집하고 스캔하도록 구축되었습니다. 검색을 실행할 때, 구조화된 필터(structured filters)가 먼저 후보군을 좁힙니다. 그런 다음 결정 모델(decision model)은 남아 있는 각 트레이젝토리를 설명과 비교하며, 이를 여러 개 병렬로 처리합니다. 모델이 한 배치(batch)의 트레이젝토리를 확인하는 동안, SmithDB는 이미 다음 배치를 가져와 준비하고 있습니다. 일치 항목은 발견되는 즉시 스트리밍되어 돌아오므로 전체 스캔을 기다릴 필요가 없습니다.

향후 계획
저희는 사람들이 어떤 질문을 가장 많이 하는지 여전히 학습 중입니다. 분류하기 가장 어려운 대화는 미묘한 차이가 있는 경우입니다. '사용자가 포기했다'와 '사용자가 필요한 것을 얻고 떠났다'를 구분하는 것은 긴 트레이젝토리의 몇 번의 턴(turn)에 달려 있을 수 있습니다. 저희는 트레이스 기반으로 조정된 모델이 이 둘을 더 신뢰성 있게 구별할 수 있는지 확인하고 싶습니다.
토큰 예산은 답변이 사용자나 에이전트가 말한 내용에서 발견될 때 잘 작동합니다. 다른 질문들은 다른 증거를 필요로 합니다. 도구 오류를 무시하는 에이전트는 도구 결과에만 나타납니다. 저희는 질문을 기반으로 컨텍스트를 선택하고, 모델이 확신하지 못할 때 표시되는 신호를 탐색하여 더 많은 컨텍스트와 함께 두 번째 패스를 할 수 있도록 하는 방법을 모색하고 있습니다.
또한, 단순히 일치하는 목록을 넘어 유사한 결과를 그룹화하거나 공통점을 요약하는 것도 원합니다.
시작하기
AI Search는 GCP의 US, EU 및 APAC 리전에서 LangSmith Cloud에 추가 비용 없이 공개 베타로 제공됩니다. 조직 관리자는 설정에서 이를 활성화할 수 있으며, 그러면 트레이싱 페이지에 표시됩니다. AI Search 문서를 참조해 주십시오. 어떤 것을 검색하고 싶은지 알려주세요.
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기