
LangSmith에 새롭게 추가된 기능: Engine v2, 관리형 Deep Agents, 파인튜닝 및 기타
요약
LangSmith에 새롭게 추가된 기능들을 통해 에이전트 개발 라이프사이클 전반을 강화했습니다. Engine v2는 레드팀잉 및 확장 이슈 감지 기능을 제공하여 문제 발생을 사전에 예방합니다. 또한, 관리형 Deep Agents와 파인튜닝 기능을 활용해 사용자 메모리 기반의 전문적인 에이전트를 쉽게 구축하고 배포할 수 있습니다.
핵심 포인트
- Engine v2로 프로덕션 전 문제 사전 감지 및 자동 테스트 가능
- 관리형 Deep Agents로 메모리와 웹 검색 기능 통합하여 에이전트 개발 용이화
- 에이전트 트래젝토리를 파인튜닝 데이터로 활용해 전문성 강화
- Custom Apps 기능을 통해 워크플로우별 사용자 지정 UI 구축 가능
주요 요약
에이전트 문제 사전 감지. LangSmith Engine v2는 레드팀(red teaming), 확장된 이슈 감지, 자동 수정 검증 기능을 도입했습니다.
ID 범위 인증과 메모리를 사용한 에이전트 실행. 관리형 Deep Agents를 통해 에이전트를 쉽게 구축하고 배포할 수 있으며, 이제 사용자 레벨의 메모리와 내장 웹 검색 기능도 포함합니다.
에이전트 세션을 파인튜닝 데이터로 활용. Trajectories는 트레이스(traces)에 대한 새로운 대화형 뷰입니다. LangSmith Fine-Tuning은 이 트래젝토리(trajectories)를 사용하여 모델을 전문적인 작업에 맞게 조정합니다.
에이전트 데이터를 위한 사용자 지정 UI 구축. Custom Apps 기능을 통해 팀들은 주석 큐나 실험과 같은 워크플로우를 위한 사용자 지정 LangSmith 인터페이스를 구축하고 게시할 수 있습니다.
이번 주, 수백 명의 AI 엔지니어들이 Interrupt NYC에 모여 도메인별 에이전트를 프로덕션 환경으로 가져가는 방법과 최신 LangSmith 발표 내용을 들었습니다.
저희의 최신 릴리스는 팀들이 통제력과 유연성을 가지고 구축하고, 에이전트의 지능을 증폭시키며, 강력한 거버넌스를 보장하는 에이전트 개발 라이프사이클의 두 가지 핵심 축, 즉 런타임(runtime) 및 관측 가능성+평가(observability + evaluations)에 초점을 맞추고 있습니다.
관측 가능성(Observability)과 평가(Evals)는 팀들이 에이전트의 동작을 이해하고, 품질을 측정하며, 사용함에 따라 에이전트를 개선하는 데 도움을 줍니다. (※ 원문에는 'help teams understand behavior, measure quality, and improve agents they more they are used.'로 문법적 오류가 있으나, 의미를 살려 번역했습니다.)
위에 위치한 지능 계층(intelligence layer)은 비즈니스 로직, 트레이스, 평가 및 프로덕션 데이터를 활용하여 이 에이전트 개발 루프를 가속화합니다.
저희가 출시한 내용은 다음과 같습니다.
LangSmith Engine v2: 에이전트 문제 사전 감지 및 수정 사항 신속 배포
에이전트를 개선하는 것은 여러 단계의 과정입니다. 일반적인 워크플로우는 엔지니어가 문제를 발견하고, 근본 원인을 파악하며, 해결책을 제안하고, 테스트하고, 배포한 다음, 회귀(regressions)를 모니터링하는 것을 필요로 합니다.
우리는 LangSmith Engine을 에이전트 개발 라이프사이클의 각 단계에서 작업을 자동화하는 인플랫폼(in-platform) 에이전트로 구축했습니다. 지난 5월 출시된 이후, Engine은 이미 엔지니어들이 수만 개의 문제를 진단하기 위해 6천만 개 이상의 트레이스(traces)를 분석하는 데 도움을 주었습니다.
Engine v2는 문제 감지, 테스트 및 검증에 있어 주요 발전을 소개합니다.
레드팀잉(Red Teaming)으로 선제적인 문제 해결
새로운 Red Teaming 기능은 문제가 프로덕션 환경에 나타나기 전에 이를 감지하는 데 도움을 줍니다. 프로덕션 트레이스와 저장소를 사용하여, Engine은 아직 프로덕션에서 나타나지 않은 잠재적 문제에 대한 가설을 생성하고, 이 가설들을 테스트하며, 확인된 실패 사례를 검토용으로 제시할 수 있습니다.
찾기 어려운 문제 감지
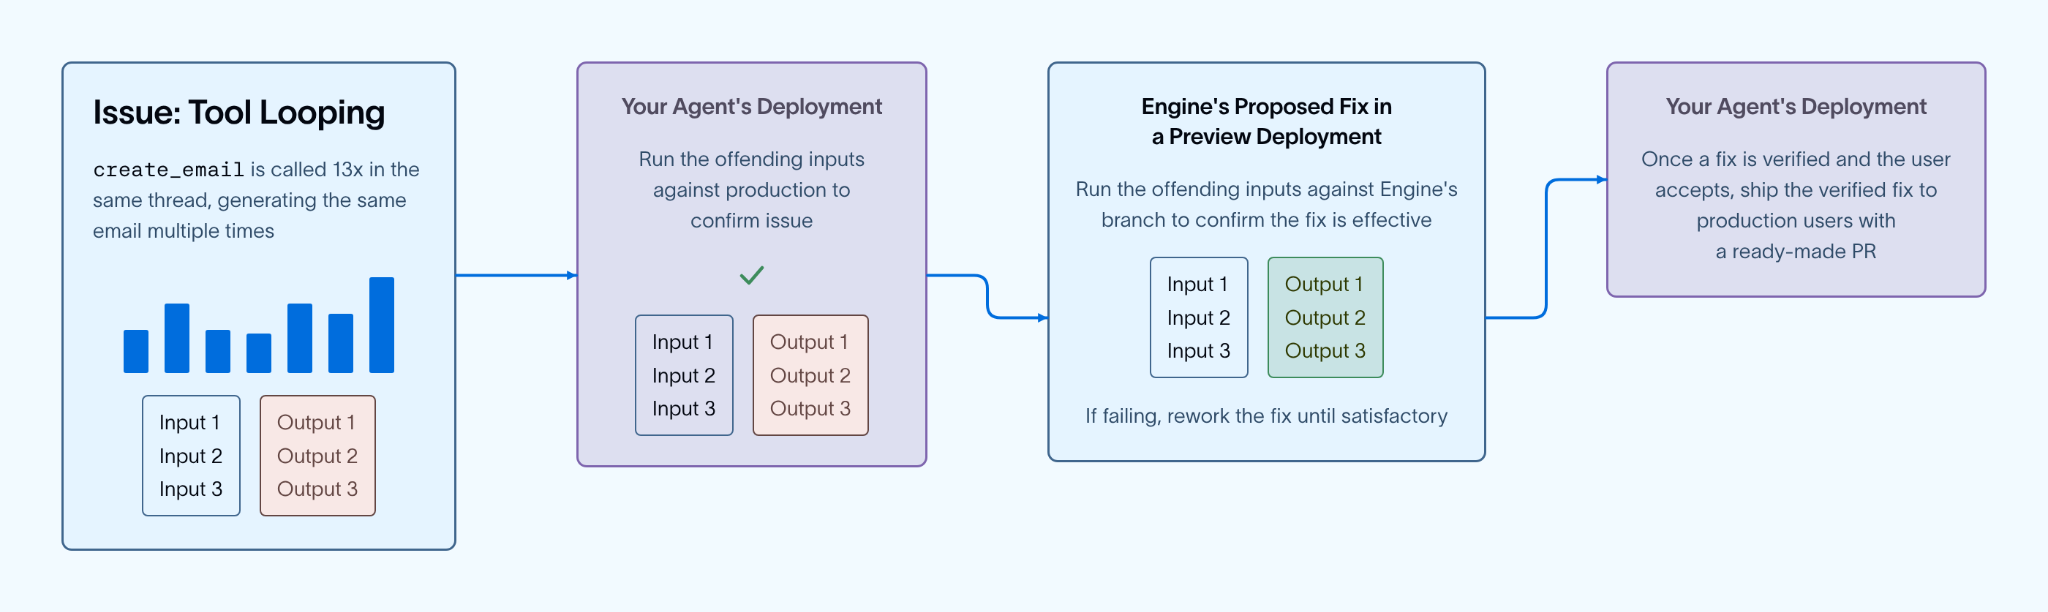
Engine은 이제 더 많은 유형의 문제를 감지합니다. 오류 및 충족되지 않은 사용자 요청 외에도, 에러율(error rate), 지연 시간(latency), 비용 전반에 걸친 성능 추세는 물론, 반복적인 도구 호출이나 불필요하게 긴 트랙궤적(trajectories)과 같은 비효율적인 에이전트 작업도 식별할 수 있습니다.
제안된 수정 사항 자동 테스트
LangSmith Deployment에서 실행되는 에이전트의 경우, Engine은 이제 인간의 검토 및 배포 전에 제안된 수정 사항을 검증할 수 있습니다. Engine v2는 문제가 발생한 입력(offending inputs)으로 에이전트를 실행하여 문제를 확인합니다. 그런 다음 광범위한 평가 세트(eval set)를 대상으로 후보 수정 사항들을 테스트하여 문제를 해결하는 것을 찾습니다. Engine이 만족스러운 수정 사항을 갖게 되면, 최종 사용자에게 제시되며, 사용자는 원클릭으로 PR(Pull Request)을 열어 빠르게 배포할 수 있습니다.
셀프 호스팅(self-hosted) LangSmith의 다음 릴리스에서는 Engine에 대한 BYOK(Bring Your Own Key)를 지원할 예정입니다.
Managed Deep Agents v0.8: 새로운 인증, 메모리 및 채널
Managed Deep Agents는 Deep Agents 하니스(harness)와 관리형 인프라를 결합하여, 비즈니스 로직을 프로덕션의 에이전트로 전환하는 가장 쉬운 방법을 제공합니다.
최신 릴리스에서는 팀들이 프로덕션에서 에이전트를 실행할 때 직면하는 네 가지 과제, 즉 에이전트 메모리, 인증(authentication), 채널 및 도구 관리를 다루었습니다.
ID 범위의 인증 및 메모리
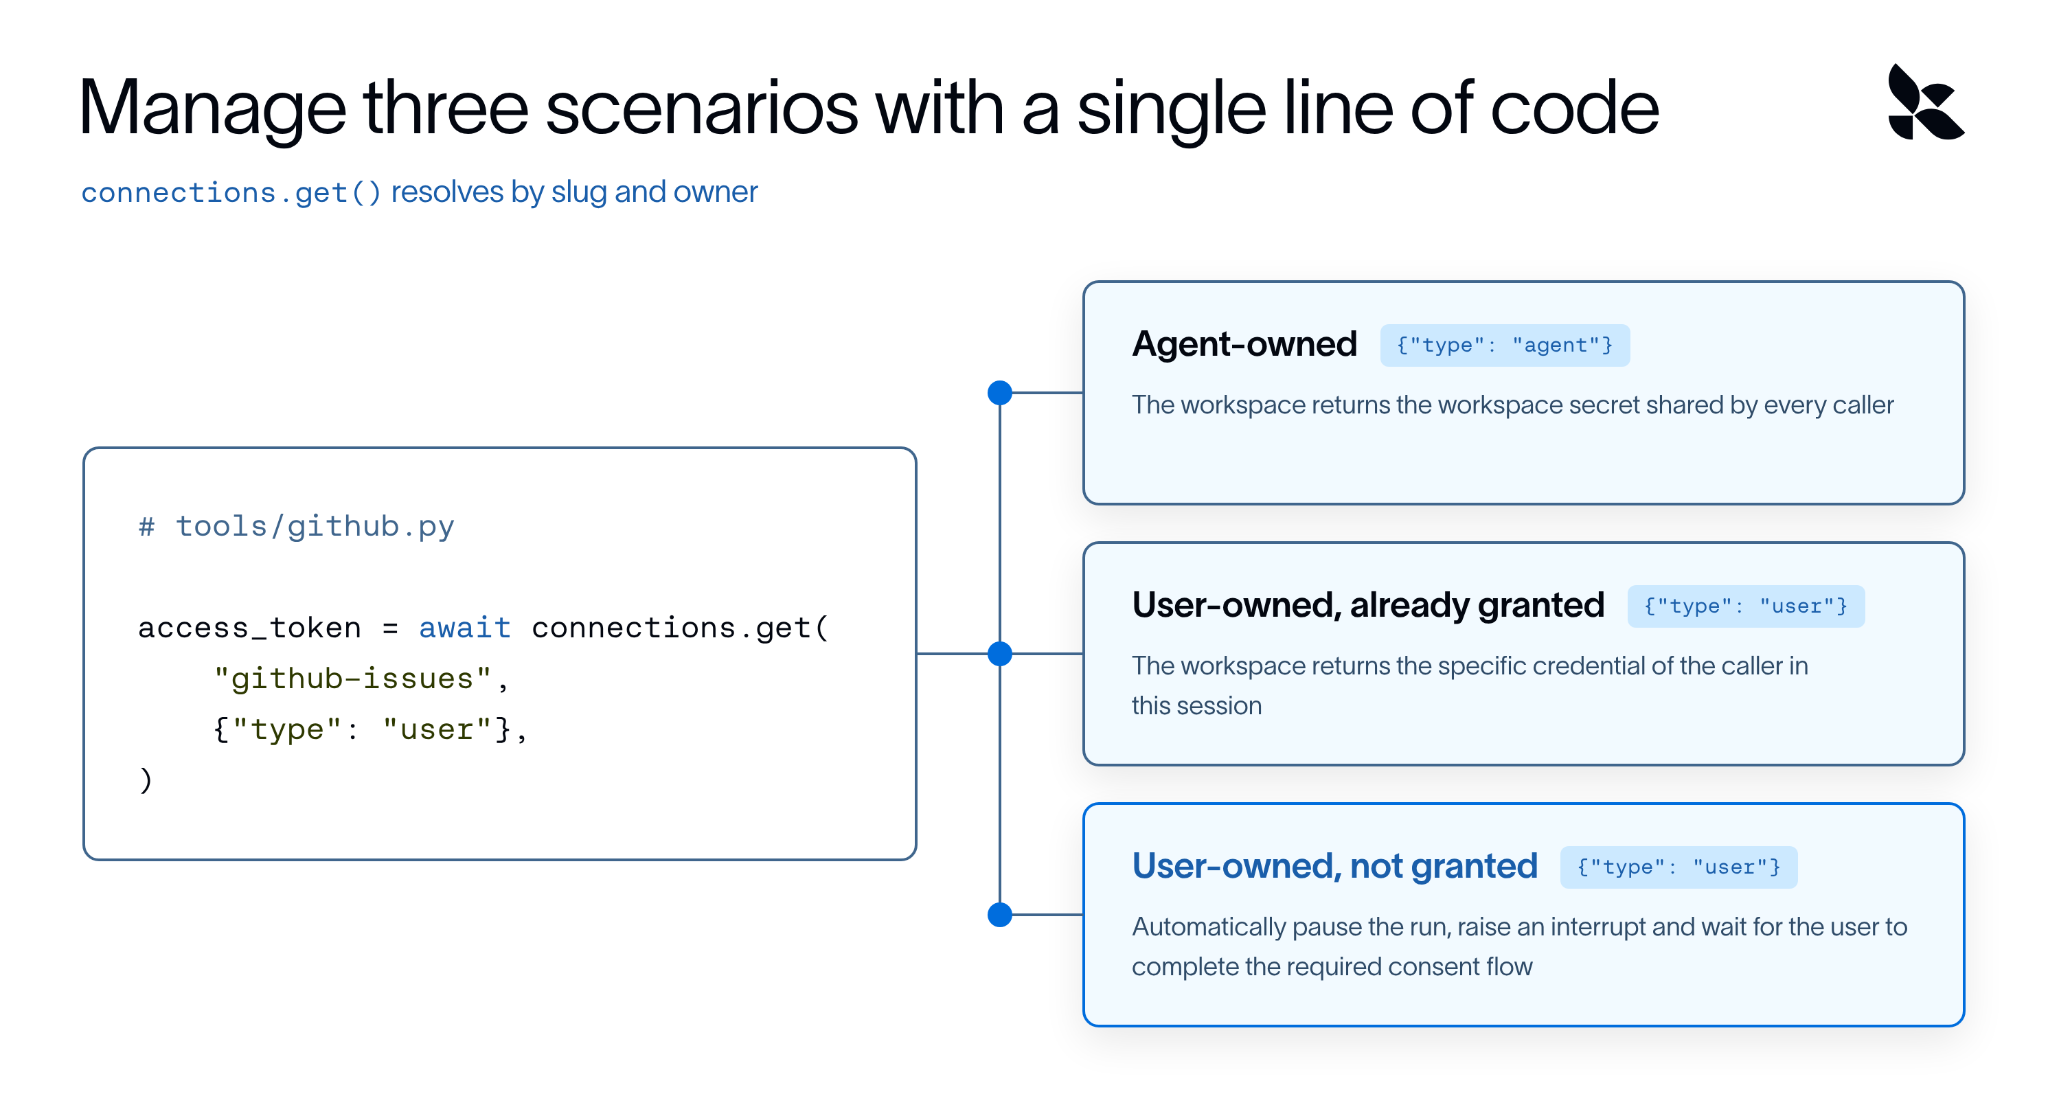
관리형 Deep Agents는 이미 영구적인 에이전트 메모리를 지원했으며, 이제 각 인증된 사용자별로 컨텍스트를 저장할 수 있는 새로운 사용자 레벨 메모리를 도입하게 되어 기대가 큽니다. 이 새로운 계층은 호출자 특정 컨텍스트를 저장하는 공간을 제공하며, 이는 공유되는 에이전트 레벨 메모리와 분리됩니다.
런타임은 계층 간에 콘텐츠를 복사하지 않으며, 사용자 레벨 정보가 대화에 유출되지 않도록 각 수준에서 접근 정책을 정의할 수 있습니다.
관리형 Deep Agents는 또한 외부 연결(예: GitHub 및 Notion)을 위해 에이전트 소유와 사용자 소유의 자격 증명(credentials)을 모두 지원합니다.
새로운 채널 및 확장된 기능
에이전트는 사용자가 이미 있는 곳에서 작동할 때 가장 잘 작동합니다. 따라서 파일 전송 기능을 포함하도록 Slack 지원을 확장하여, 사용자들이 로그, 스프레드시트, 계약서, 스크린샷 및 기타 파일을 에이전트에게 직접 보낼 수 있게 되었습니다.
새로운 HTTP 채널 지원은 팀들이 JSON 웹훅을 보낼 수 있는 모든 서비스에 에이전트를 연결할 수 있도록 합니다. 이는 여러 채널에 존재하는 고객 대면 에이전트에게 특히 유용합니다.
내장 웹 검색
웹 검색은 가장 일반적인 에이전트 도구 중 하나이므로, 이를 관리형 Deep Agents에 직접 구축하기로 결정했습니다.
관리형 Deep Agents 0.8 버전에는 사전 구축된 도구로서 웹 검색이 포함됩니다. Parallel을 기반으로 하는 내장 웹 검색 기능은 팀들이 별도의 공급업체 계정, API 키 또는 사용자 지정 도구를 설정할 필요 없이 에이전트에게 최신 정보에 접근할 수 있게 합니다.
LangSmith 트래젝토리(Trajectories): 에이전트 세션 및 추적 데이터 쉽게 탐색하기
장시간 실행되는 에이전트는 하나의 세션에 여러 턴, 도구 호출, 재시도 및 서브 에이전트 핸드오프가 포함될 수 있어 디버깅하기 어려울 수 있습니다. 전체 트레이스는 길고 중첩되어 원하는 내용을 파악하는 데 필요한 정보보다 더 많은 경우가 많습니다.
이러한 이유로 우리는 에이전트 세션을 대화 형식으로 볼 수 있는 LangSmith Trajectories를 출시했습니다. 트래젝토리(Trajectory)는 메인 에이전트와 모든 서브에이전트에서 나온 인간, AI 및 도구의 메시지를 취합하여 시간 순서대로 보여줍니다. 그 결과 팀들이 동작이 변경되거나 깨진 지점을 빠르게 파악할 수 있어 디버깅 속도가 빨라집니다.
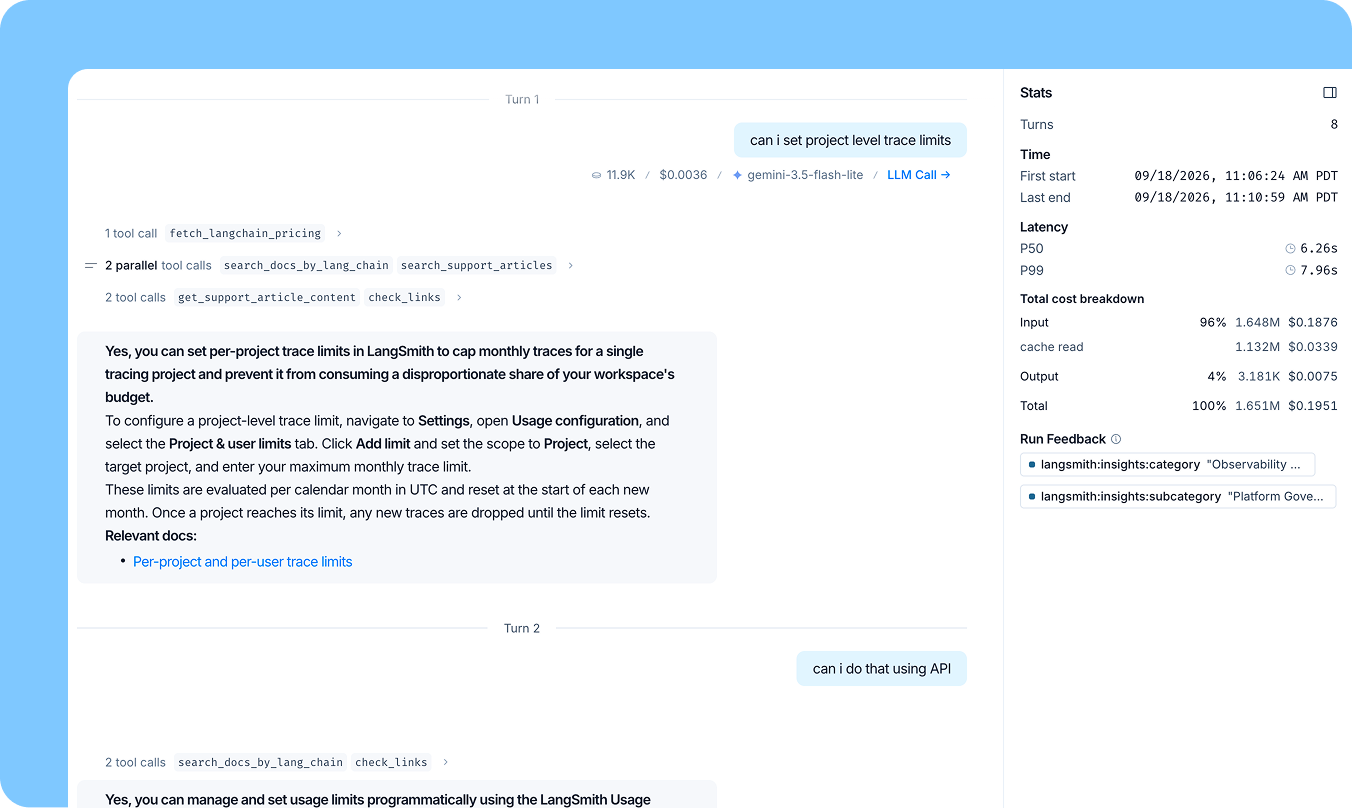
트래젝토리는 또한 리뷰 워크플로우를 더 쉽게 만듭니다. SME(Subject Matter Expert)의 검토는 에이전트 정확도에 매우 중요하지만, 종종 이 검토자들이 에이전트를 만든 사람이 아닙니다. 트래젝토리는 실행 메타데이터나 기타 세부 사항을 분석할 필요 없이 점수를 매기고, 플래그를 지정하고, 주석을 달 수 있는 읽기 쉬운 세션 뷰를 제공합니다.
트래젝토리는 개선 루프의 핵심적인 부분입니다. LangSmith 온라인 평가 도구(online evaluators)는 트래젝토리를 점수화하여 세션 전반에 걸친 에이전트 동작을 판단하는 데 더 나은 입력을 제공합니다.
LangSmith 파인튜닝: 전문 작업을 위한 오픈 모델 사후 훈련
우리는 팀들이 직접 파인튜닝 파이프라인을 구축할 필요 없이, 파인튜닝된 오픈 소스 모델의 이점을 누릴 수 있도록 LangSmith Fine-Tuning을 개발했습니다. 자체 데이터와 지능으로 훈련된 모델은 종종 범용 프론티어 모델(frontier model)만큼 또는 그 이상으로 지정된 작업을 수행할 수 있으며, 비용과 지연 시간 측면에서도 훨씬 효율적입니다.
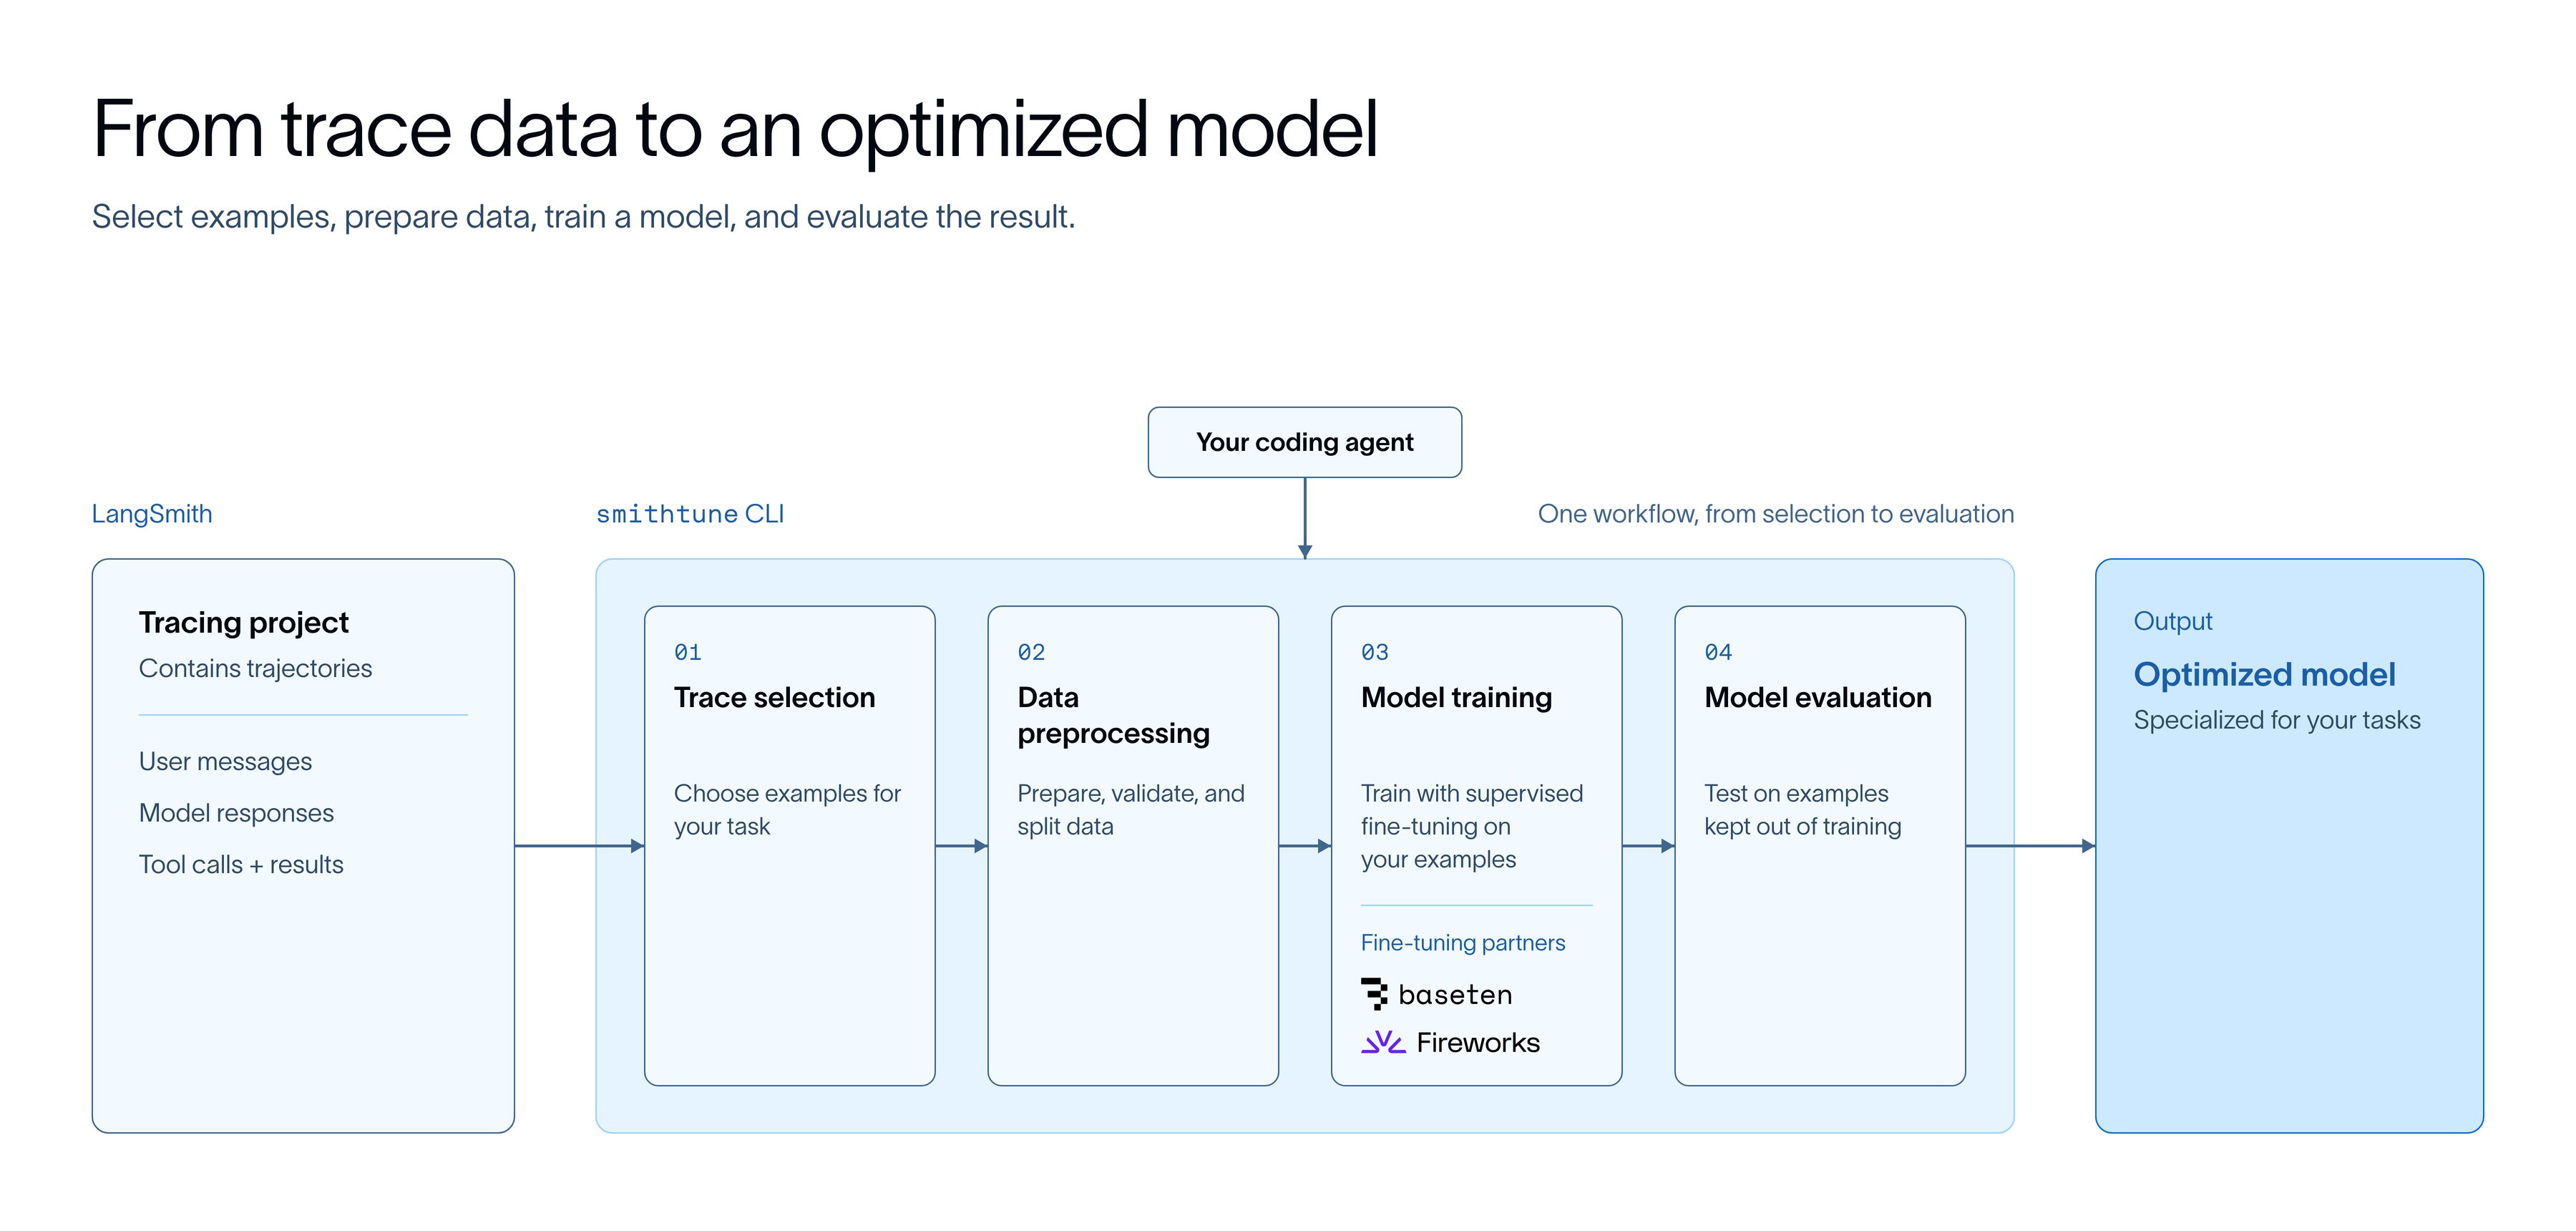
LangSmith Fine-Tuning은 팀이 고품질의 작업 예시를 사용하여 오픈 모델을 훈련하는 지도 학습 파인튜닝(Supervised Fine-Tuning, SFT)을 수행할 수 있도록 지원합니다. LangSmith Fine-Tuning CLI인 smithtune는 트래젝토리를 유용한 훈련 데이터로 변환하고, 전체 파인튜닝 프로세스를 처리합니다:
- 트래젝토리로부터 데이터셋 구축 및 준비
- Baseten 또는 Fireworks를 사용한 모델 훈련
- LangSmith를 이용한 결과 평가
- 미세 조정된 모델 제공 및 애플리케이션 연결
우리는 자체적으로 워크플로우의 품질을 평가하기 위해 SmithTune을 내부적으로 벤치마킹했으며, 그 결과에 대해 매우 기대하고 있습니다.
커스텀 앱: 에이전트 데이터 주변으로 맞춤형 인터페이스 구축
모든 팀이 에이전트 데이터를 다르게 검토합니다. LangSmith는 트레이스(trace) 검토, 실험 비교, 주석 달기(annotation), 평가 분석과 같은 일반적인 워크플로우를 위한 기본 인터페이스를 제공합니다. 하지만 고객들로부터 자신들의 워크플로우와 품질 기준에 맞춰 데이터와 상호작용할 수 있는 더 맞춤화된 방법을 원한다는 의견을 들었습니다.
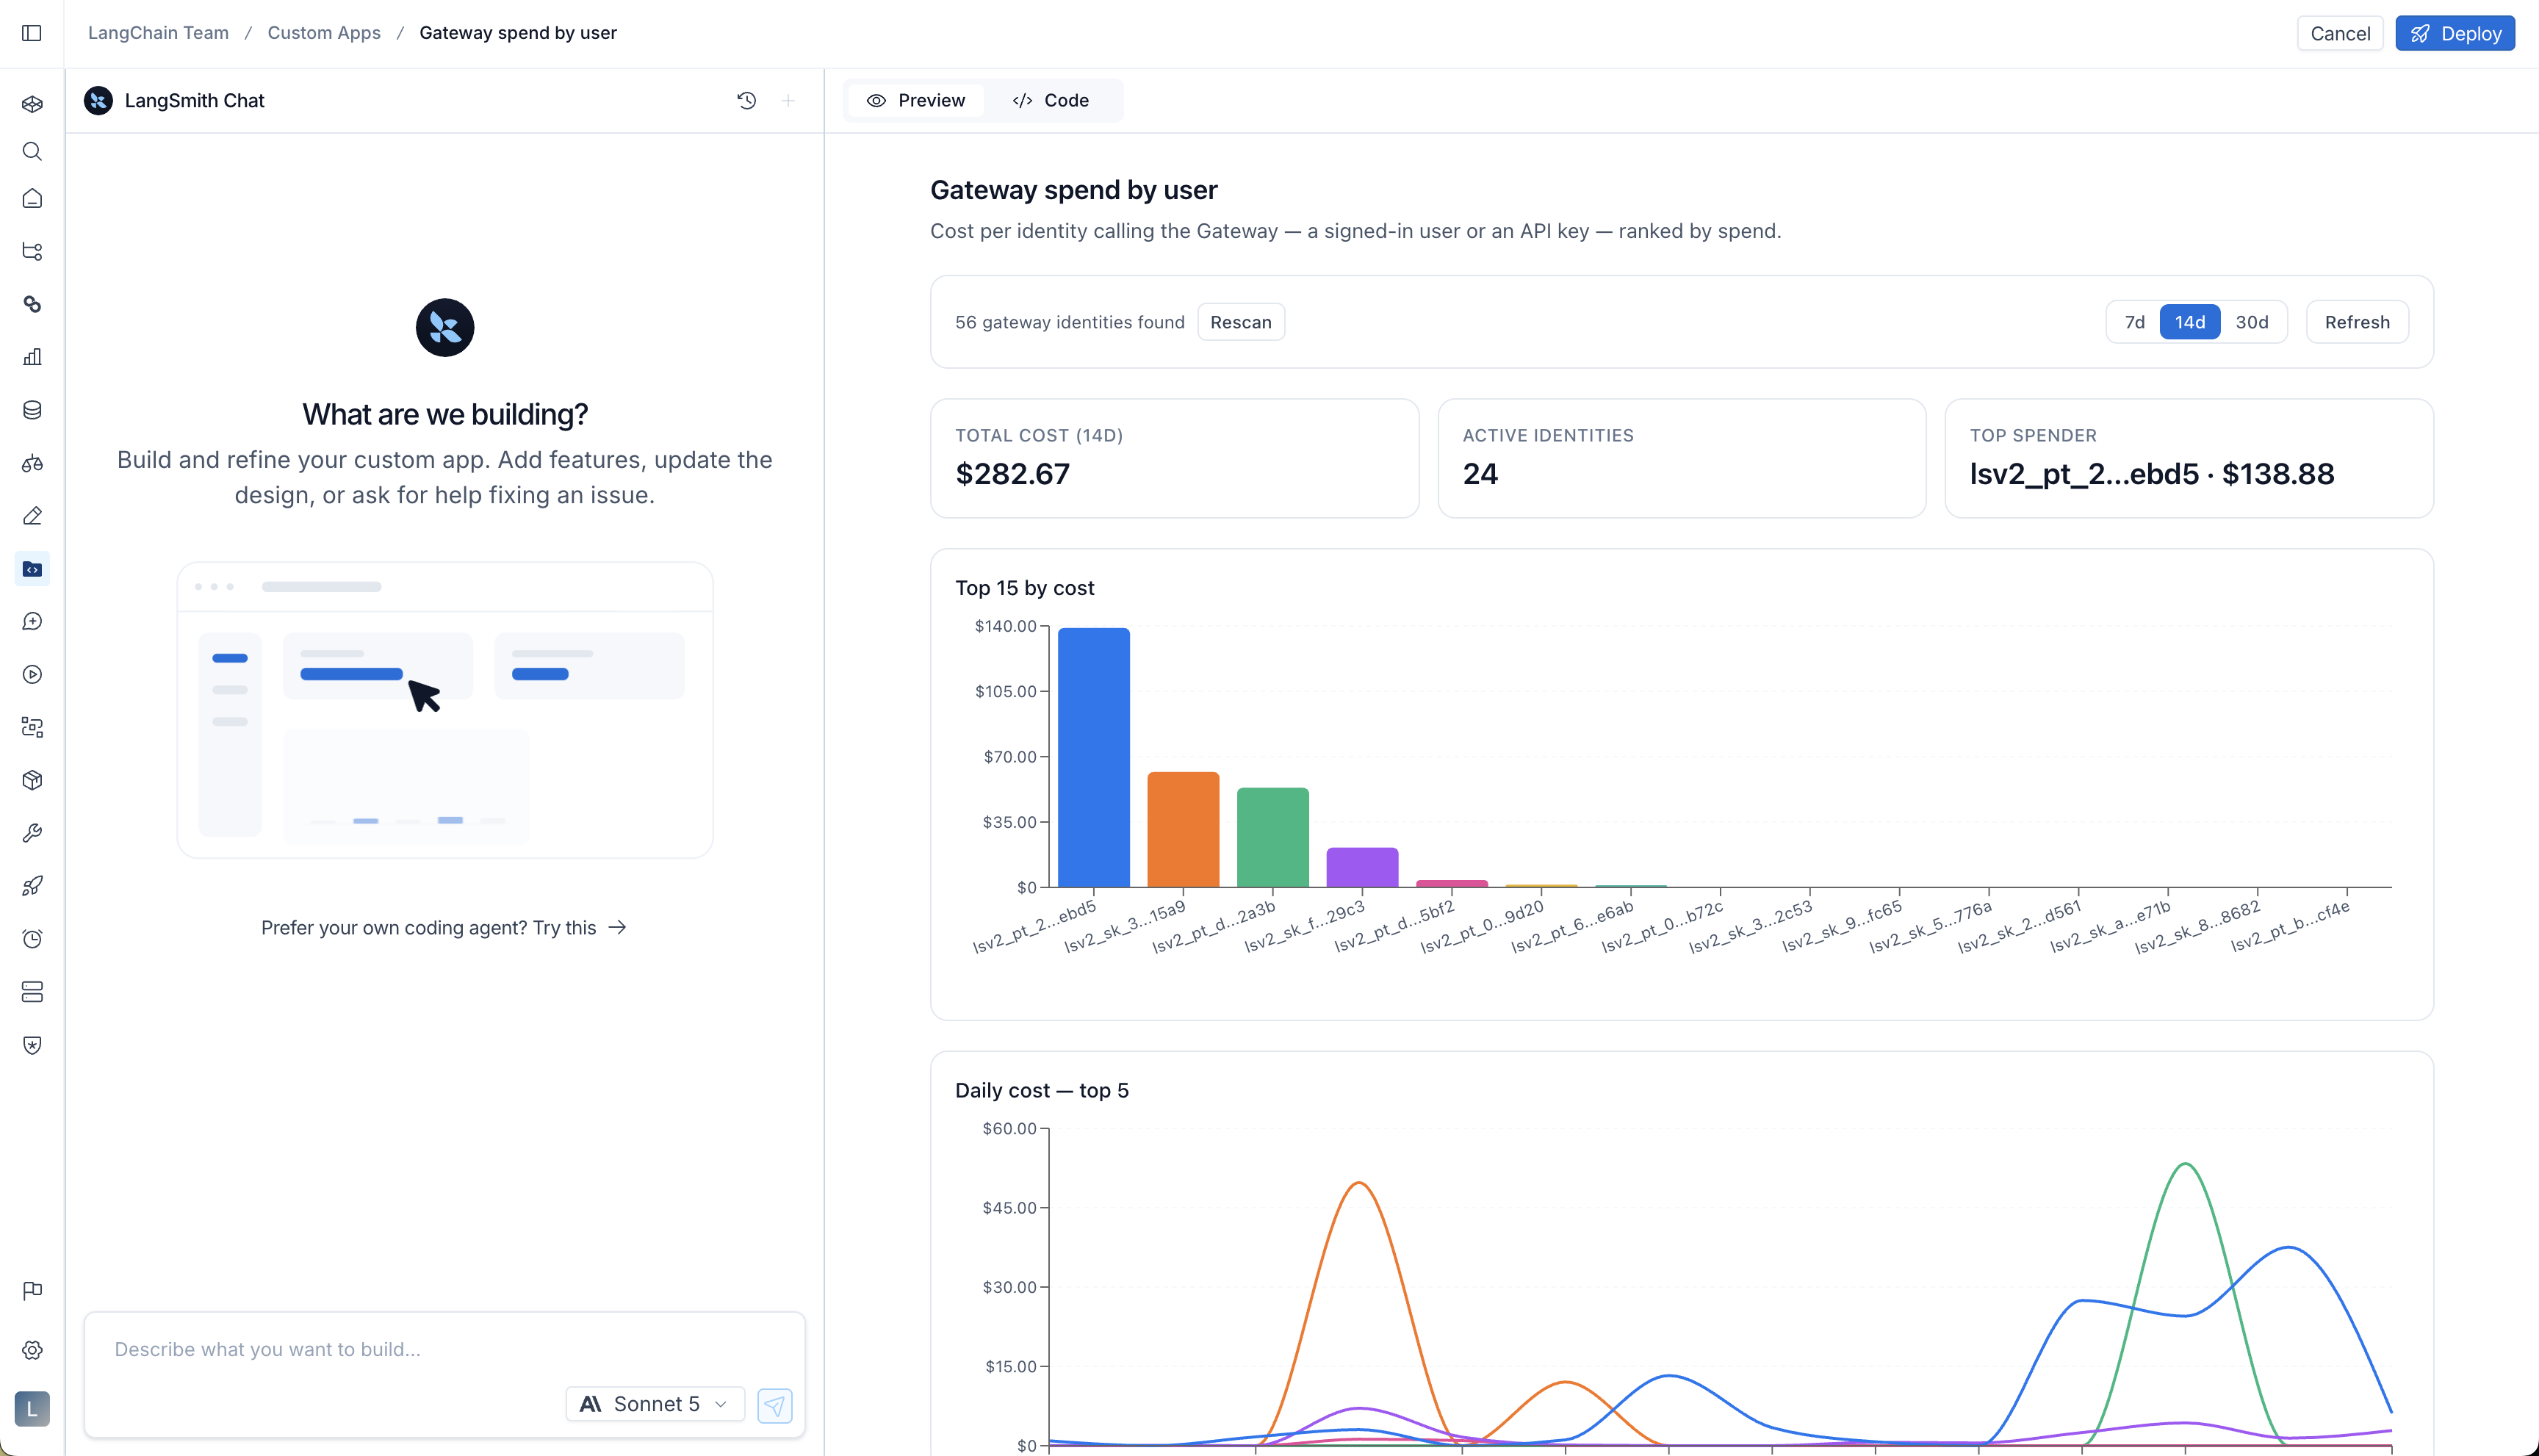
Custom Apps 기능을 사용하면 팀들이 LangSmith 데이터 위에 커스텀 인터페이스를 구축하고, 게시하며, 실행할 수 있습니다.
데이터를 내보내거나 별도의 내부 도구를 유지하는 대신, 팀들은 템플릿, 인앱 채팅 또는 코딩 에이전트 가이던스를 사용하여 LangSmith API를 기반으로 앱을 구축하고 이를 자신의 LangSmith 워크스페이스에 게시할 수 있습니다. 일단 게시되면, 이 앱은 반복적인 워크플로우를 위한 공유 인터페이스가 됩니다.
이는 검토자들이 집중된 UI가 필요한 주석 달기 워크플로우, 팀들이 여러 버전이나 슬라이스(slice) 전반에 걸쳐 출력을 비교하고 싶은 실험 검토, 그리고 최적의 뷰가 애플리케이션에 따라 달라지는 트레이스 검토 워크플로우에 유용합니다.
자체 지능 소유하기
궁극적으로, 우리의 최신 업데이트는 모든 회사가 자신들의 지능을 소유할 수 있도록 하는 사명을 지원합니다. 실제로 이는 팀들이 해결하고자 하는 특정 문제에 맞춰 맞춤화된, 도메인 특화 에이전트와 애플리케이션을 구축할 수 있음을 의미합니다.
CEO Harrison Chase가 발표한 Interrupt NYC 기조연설을 시청하여 이러한 발표 내용에 대해 더 깊이 알아보세요.
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기