
Kay x Cybersyn x LangChain: RAG를 위한 SEC 공시 자료 임베딩
요약
본 글은 Kay와 Cybersyn이 협력하여 LangChain의 SEC Retriever를 소개하며, 개발자들이 미국 상장 회사의 중요한 금융 정보가 담긴 SEC 공시 자료에서 컨텍스트를 쉽게 검색할 수 있도록 돕는 방법을 다룹니다. 이 도구는 LLM의 최신 지식 부족 문제를 해결하고, 복잡한 금융 데이터 처리에 필요한 RAG 파이프라인 구축 과정을 간소화합니다.
핵심 포인트
- LangChain SEC Retriever로 SEC 공시 자료에서 컨텍스트 검색 용이
- LLM의 한계(최신성) 극복을 위한 RAG 활용 필요
- 금융 문서는 복잡하여 신중한 데이터 처리와 청킹 요구됨
- Kay가 완전 호스팅 임베딩 및 시맨틱 검색 API 제공
*에디터 노트: 본 게시물은 Kay 팀이 Cybersyn과 협력하여 작성했습니다. * 금융 데이터 처리는 어렵습니다. Kay와 Cybersyn의 지원을 받는 LangChain의 SEC Retriever는 개발자들이 생성형 및 대화형 에이전트를 위해 SEC 공시 자료에서 컨텍스트를 쉽게 검색할 수 있도록 합니다.
금융 문서는 투자부터 기업 전략에 이르기까지 높은 중요도를 지닌 시나리오에서 자주 사용되는 풍부하고 미묘한 정보를 담고 있습니다. SEC 공시 자료는 미국 상장 회사의 이러한 금융 지식의 일반적인 출처입니다. 여러 팀이 LLM(Large Language Model) 사용 사례를 위해 이 비정형 데이터에 접근하기 시작했지만, 여러 가지 문제에 직면합니다.
LLM은 컨텍스트가 부족합니다: LLM의 지식은 마지막 학습 날짜만큼만 유효합니다. 금융 시장은 빠르게 움직이며, 개발자들은 LLM에 최신 지식을 제공하기 위해 검색 증강 생성(Retrieval Augmented Generation, RAG)을 활용할 필요가 있습니다. 게다가 SEC 공시 자료는 데이터 형식 때문에 검색 엔진으로 인덱싱하기 어렵습니다. 따라서 개발자들은 이러한 문서와 관련된 파생 기사를 학습하는 것을 선택하지만, 이는 출처 컨텍스트나 덜 알려진 회사들을 간과할 수 있게 합니다.임베딩 인프라는 빠르게 진화합니다: 계획 및 구현 측면 모두에서 RAG를 위한 인프라를 올바르게 구축하기는 어렵습니다. 자체 RAG 파이프라인을 구축하는 개발자들은 선택지에 압도됩니다. 선택할 수 있는 벡터 스토어(vector store)가 50개가 넘고, MTEB Leaderboard에는 끊임없이 변화하는 임베딩 모델 목록이 있습니다. 매주 새로운 임베딩 및 검색 방법이 등장합니다. 더 많은 GPU 용량을 확보하고 대규모 오프라인 배치 임베딩 파이프라인을 설정하려고 할 때 상황은 더욱 복잡해지며, 이 모든 과정에서 컴퓨팅 비용을 제어해야 합니다.금융 문서는 복잡합니다: 모호한 데이터 형식에서 데이터를 추출하는 것 외에도, 금융 문서는 신중한 데이터 처리와 청킹(chunking)이 필요합니다. 개발자들은 테이블 변환 방법 실험, 관련 엔티티 결정, 그리고 이를 상위 섹션에 연결하는 방법에 대해 고민해야 합니다.
이러한 문서를 검색할 때 오탐(false positives)에 대한 허용치가 매우 낮습니다. 왜냐하면 이 수치들이 중요한 결정에 직접적인 영향을 미치기 때문입니다.
여러 팀들이 자체적으로 정확히 동일한 파이프라인을 구축하고 있어 비용이 증가하고 있습니다. 바로 여기서 LangChain의 SEC Retriever가 등장합니다. Kay와 Cybersyn의 지원을 받아 개발자들은 생성형 및 대화형 에이전트를 위해 SEC 공시 자료에서 컨텍스트를 쉽게 검색할 수 있습니다.
Kay는 RAG에 특화되도록 설계된 데이터 API를 제공합니다. 저희는 개발자들이 데이터를 직접 수집하고, 임베딩을 생성하며, 검색 규모를 확장할 필요가 없도록 대규모 데이터셋의 완전 호스팅 임베딩을 제공합니다. Cybersyn은 Snowflake Marketplace에서 분석 준비가 된 경제 데이터를 제공하는 데이터-서비스(data-as-a-service) 회사입니다. 초기에는 비즈니스와 소비자가 돈과 시간을 어디에 지출하는지에 초점을 맞추었으나, 현재는 SEC 공시 자료를 포함한 LLM 학습 데이터셋을 포함하여 Snowflake를 통해 여러 데이터 제품을 제공합니다. Kay는 이 데이터를 추가로 풍부하게 만들고(enriches), 임베딩하며, 시맨틱 검색 API를 설정합니다. 본 블로그에서는 이 API를 시작하는 방법과 그 뒤에 있는 인프라 개요를 다룰 것입니다.
시작하기
LangChain에서 Kay를 사용하는 것은 믿을 수 없을 만큼 간단합니다.
먼저, Kay를 설치하고(pip install kay) Kay.ai에서 무료 API 키를 받습니다.
다음으로, 필요한 데이터셋으로 KayAiRetriever를 초기화합니다. 현재 저희는 회사와 관련된 여러 데이터셋을 인덱싱합니다. 이 데이터셋에는 재무 문서, 보도 자료, 엔지니어링 블로그 등이 포함됩니다(docs). 여기서는 10-K 및 10-Q에 접근하여 주어진 쿼리에 대한 상위 6개 청크를 검색할 것입니다.
from langchain.retrievers import KayAiRetriever
retriever = KayAiRetriever.create(dataset_id="company", data_types=["10-K", "10-Q"], num_contexts=6)
여기부터는 평소와 같습니다. 이 컨텍스트를 기존 프롬프트에 삽입하고 좋아하는 LLM으로 전달하기만 하면 됩니다. 여기 SEC 데이터의 임베딩된 힘을 정말 잘 보여주는 샘플 쿼리가 있습니다.
질문: 지난 세 분기 동안 Nvidia의 재무 성과에는 어떤 패턴이 있습니까?
답변: 제공된 재무제표를 바탕으로, 지난 세 분기 동안 NVIDIA의 재무 성과에서 나타나는 몇 가지 패턴은 다음과 같습니다:
-
영업 활동 현금 흐름 (Cash Flows from Operating Activities): 영업 활동을 통해 창출된 순현금(net cash)은 세 분기 동안 꾸준히 증가하는 추세를 보였습니다. 2023년 1분기에는 1,874백만 달러였고, 2023년 2분기에는 1,731백만 달러, 그리고 2023년 3분기에는 1,288백만 달러였습니다.
-
투자 활동 현금 흐름 (Cash Flows from Investing Activities): 투자 활동을 통해 창출된 순현금은 변동성이 크게 나타났습니다. 2023년 1분기에는 2,612백만 달러로 양(+)의 현금 흐름을 나타냈습니다. 그러나 2023년 2분기에는 8,244백만 달러라는 현금 유출(cash outflow)과 함께 마이너스(-)를 기록했습니다. 2023년 3분기에는 다시 7,378백만 달러의 현금 유입(cash inflow)을 기록하며 양(+)으로 전환되었습니다.
-
자금 조달 활동 현금 흐름 (Cash Flows from Financing Activities): 자금 조달 활동을 통해 창출된 순현금 역시 변화를 보였습니다. 2023년 1분기에는 4,146백만 달러로 양(+)의 현금 흐름을 나타냈습니다. 2023년 2분기에는 9,961백만 달러라는 현금 유출과 함께 마이너스(-)를 기록했습니다. 2023년 3분기에는 여전히 마이너스를 유지했지만, 2,610백만 달러로 감소했습니다.
-
인수 및 투자 (Acquisitions and Investments): NVIDIA는 세 분기 모두에서 인수와 투자를 진행했지만, 그 규모는 다양했습니다. 2023년 1분기에 투자 활동에 사용된 순현금은 1,272백만 달러였습니다. 2023년 2분기에는 8,244백만 달러라는 상당한 현금 유출이 있었습니다. 2023년 3분기에는 7,378백만 달러의 현금 유입을 기록하며 양(+)으로 전환되었습니다.
-
보통주 재매입 관련 지급액 (Payments related to Repurchases of Common Stock): NVIDIA는 2023년 2분기에 보통주 재매입과 관련된 상당한 지급액(cash outflow)이 발생했으며, 그 규모는 8,826백만 달러였습니다. 이는 주식 매입을 통해 주주들에게 가치를 환원하는 데 중점을 두었음을 시사합니다.
이러한 패턴들은 투자 및 재무 활동에서 현금 흐름의 변동을 나타내는 반면, 영업 현금 흐름은 비교적 안정적으로 유지되었습니다. 인수 및 투자 활동 또한 현금 흐름 변화에 기여했습니다. 추가적으로, NVIDIA가 주주에게 가치를 환원하려는 노력이 보통주 자사주 매입 관련 지급액에서 분명하게 드러납니다.
반면, ChatGPT, Bard 또는 Perplexity와 같은 검색 기능이 활성화된 LLM으로 동일한 쿼리를 시도해 보세요. Kay는 우리가 이 모든 데이터를 사전에 임베딩하고 각 데이터셋 및 사용 사례에 맞게 검색 기능을 조정하기 때문에 훨씬 더 많은 미묘한 차이를 포착합니다. 여기에는 데이터 강화(data enrichment), 최첨단 임베딩, 쿼리 이해 등 아래 인프라 섹션에서 다루는 여러 다른 주제가 포함됩니다.
사용 사례 (Use cases)
SEC 공시 자료는 크고 비정형적인 문서입니다. 이 자료들은 미국 상장 회사에 대한 중요한 정보를 담고 있습니다. 과거에는 이러한 모든 데이터가 몇 개의 경직된 표 안에 압축되어 있어, 대부분의 실무자들이 이 파일들에서 나오는 가치 있는 신호를 놓치게 만들었습니다. 이제 우리는 분석가, 감사원, 투자자, 임원, 영업 및 마케팅 팀이 이 정보를 단 몇 초 만에 파싱할 수 있도록 할 수 있습니다. 사용자들이 이미 이 데이터를 어떻게 활용하고 있는지 몇 가지 예시를 소개합니다.
재무 성과 분석 (Analyzing Financial Performance)
"지난 5년간 Company X의 매출 성장 추세를 보여주세요."
"Company A와 Company B의 부채 대 자본 비율을 비교해 주세요."
판매 기회 식별 (Identifying Sales Opportunities)
"Company X는 올해 어떤 새로운 하드웨어 제품을 출시했나요?" "Company A의 전략적 방향과 확장 계획을 요약해 주세요."
산업 동향 모니터링 (Monitoring Industry Trends)
"Company X가 활용하고 있는 주요 시장 트렌드는 무엇인가요?" "Company A와 Company B 간의 포지셔닝 차이점을 식별해 주세요."
규정 준수 연구 (Compliance Research)
"Company X는 최근 GDPR 가이드라인에 어떻게 적응하고 있나요?" "Company A 인수에 관련된 잠재적 위험은 무엇인가요?"
비하인드 스토리: 인프라 (Behind the Scenes: Infrastructure)
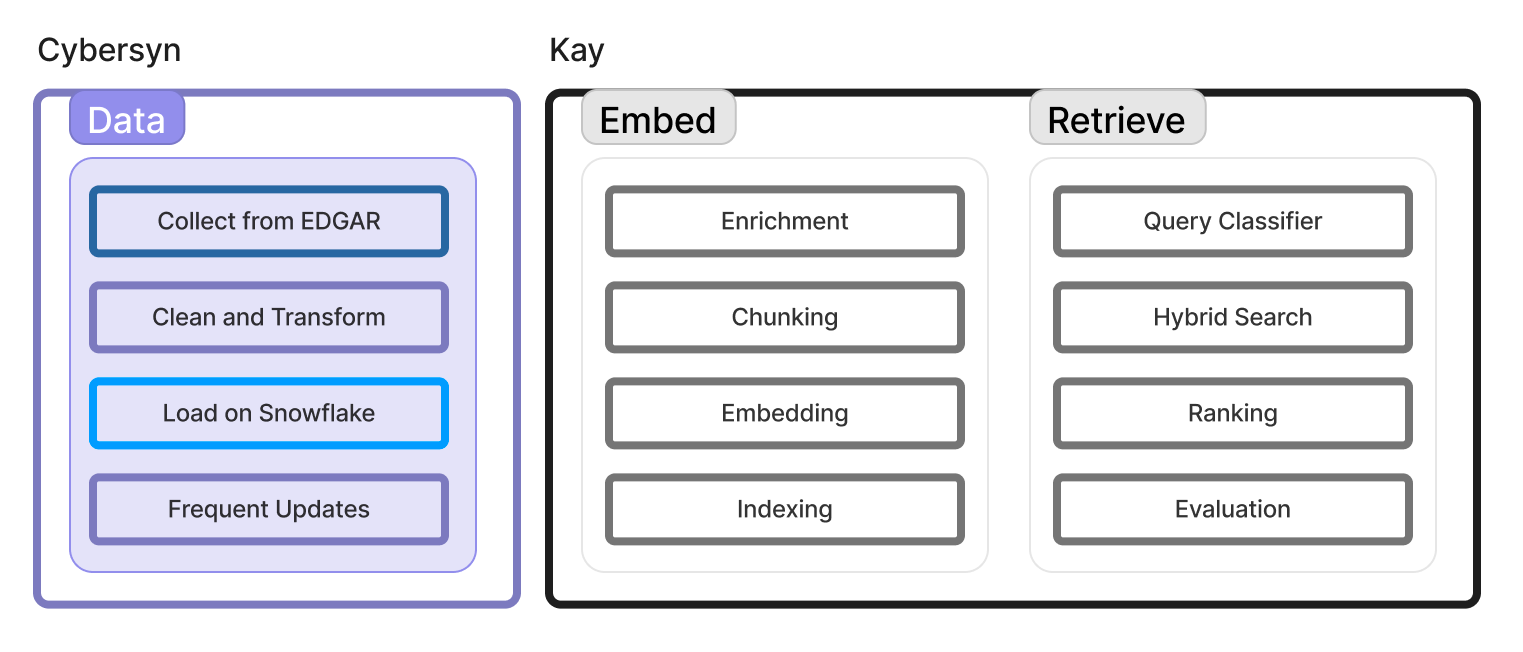
RAG 시스템은 데이터(data), 표현(representation), 검색(retrieval)의 세 가지 필수 구성 요소로 이루어져 있습니다. 이 시나리오에서 데이터는 일반적으로 임베딩(embeddings) 형태로 표현됩니다. 우리가 이러한 구성 요소들에 대해 내리는 결정들은 성능에 직접적인 영향을 미칩니다. Kay에서는 이러한 선택들을 매우 중요하게 생각하며 최신 기술 동향을 끊임없이 파악하고 있습니다. 아래 다이어그램은 각 구성 요소 내의 주요 프로세스 일부를 보여줍니다. 자세히 살펴보겠습니다.
데이터 수집 (Collecting data)
우리 시스템의 기반은 고품질 데이터입니다. 모든 미국 상장 기업들은 SEC(Securities and Exchange Commission)의 전자 데이터 수집, 분석 및 검색(EDGAR: Electronic Data Gathering, Analysis, and Retrieval) 시스템을 통해 의무적으로 서류를 제출합니다. 이 데이터는 API를 통해 이용 가능하지만, 그 다양한 데이터 형식 때문에 처리하고 임베딩하는 것이 어려울 수 있습니다. 바로 여기서 Cybersyn이 역할을 합니다.
Cybersyn은 확보하거나 정리하거나 결합하기 어려운 독점 및 공공 데이터셋으로부터 파생된 데이터 제품을 구축합니다. 그들의 데이터 제품 중 하나는 LLM Training Essentials로, SEC 서류와 여러 다른 정부 데이터셋들을 포함합니다. 이는 몇 가지 이점을 가져다줍니다:
- Cybersyn은 비정형 TXT 및 XBRL 데이터를 관계형 데이터베이스(relational database)로 변환하여, 제출된 PDF 파일에서 OCR(광학 문자 인식) 및 텍스트 추출 파이프라인을 직접 구축할 필요성을 없애줍니다.
- 또한 CIK, EIN, LEI, PermID, OpenFIGI를 포함한 공통 회사 식별자를 통해 기업들을 연결하는 데 도움이 되는 추가 메타데이터도 제공합니다. 이는 나중에 검색(retrieval)에 매우 유용합니다.
- 이 데이터는 Snowflake Marketplace에 로드됩니다. Snowflake는 이 데이터에 대한 안전하고 완전히 관리되는 접근을 보장하여, 사용자들이 SQL 쿼리를 사용하여 읽고 상호작용할 수 있게 합니다. 이는 접근 용이성을 크게 향상시킵니다.
- Cybersyn은 또한 SEC 데이터를 활용하는 사용 사례의 시간 민감한 특성을 인식하고, 이 데이터가 정기적으로 업데이트되도록 책임을 집니다.
Cybersyn 및 Snowflake를 활용한 경험은 Kay의 데이터 품질, 접근성, 신뢰도 향상에 크게 기여했습니다. 저희는 이들의 모든 데이터 제품을 탐색해 보시기를 강력히 추천합니다.
임베딩 생성하기 (Generating embeddings)
원시 텍스트 데이터를 확보한 후, 데이터 풍부화(data enrichment) 과정을 시작합니다. 저희는 두 가지 유형의 메타데이터를 만드는 데 중점을 둡니다.
- 회사 메타데이터 (Company Metadata): 티커 심볼, 산업, 위치, 요약, 웹사이트 등 회사 정보를 수집합니다. 이 데이터는 효율적인 검색을 위해 회사들을 정규화하고 그룹화하는 데 도움을 줍니다.
- 문서 메타데이터 (Document Metadata): 또한 각 문서에 특정한 정보(예: 다른 섹션, 시간 및 날짜 언급 전체, NER을 사용한 주요 개체)를 추출합니다. 이 메타데이터는 검색 능력을 더욱 향상시킵니다. 이 중 일부는 청크와 함께 임베딩되고 나머지는 필터링에 사용됩니다.
다음 단계는 임베딩 모델 선택입니다. 먼저, 저희는 OpenAI 임베딩 API에서 벗어나 자체 호스팅(self-hosting)하는 오픈 소스 모델로 전환하기로 빠르게 결정했습니다. OSS 임베딩 모델은 최첨단 기술이며, 확장성(scaling)에 대한 완전한 제어권을 제공하고, 훨씬 저렴하며, 나중에 파인튜닝(fine-tuning) 기능까지 열어줍니다. 이는 저희가 빠르게 반복 작업을 수행하고 나중에 확장할 수 있도록 하는 데 필수적이었습니다. OSS 모델 중에서는 이 데이터셋의 다양한 사용 사례에 대해 내부 평가를 거친 후, 현재 리더보드에서 상위권 모델 중 하나인 gte-base를 선택했습니다.
SEC 데이터를 처리하기 위해 섹션 기반의 동적 변수 청킹(dynamic variable chunking)을 구현하여, 청크 크기가 문장 단위로 평균 1500자로 제한되도록 했습니다. 테이블이 포함된 청크는 LLM을 사용하여 자연어로 요약하는 방식으로 다르게 처리합니다. 이 과정을 거치면, 저희는 청킹 및 임베딩을 시작할 수 있는 모든 데이터와 도구를 갖추게 됩니다. 오프라인 배치 임베딩 작업(offline batch embedding jobs)의 경우, Ray의 병렬화 프레임워크를 활용했습니다. Ray는 설정하기 쉽고, 작업을 수행하며, 신뢰할 수 있는 지원을 제공합니다. 이를 통해 15분도 채 걸리지 않아 2천만 개 이상의 임베딩을 청킹하고 임베딩할 수 있었습니다.
마지막으로, 생성된 임베딩을 벡터 데이터베이스에 넣습니다. 우리는 벡터 인덱싱에는 HNSW를, 텍스트 인덱싱에는 BM25를 사용하는데, 이는 이 데이터 유형들에 대해 비교적 표준적인 방식입니다. 한 가지 주목할 만한 점은 여러 벡터 스토어가 동시 쓰기 및 인덱싱 작업을 수행하여 쓰기 처리량(write throughput)이 크게 감소한다는 것이었습니다. 이 문제를 해결하기 위해 증분 인덱싱(incremental indexing)으로 전환하는 것을 강력히 권장합니다.
검색 최적화 (Optimizing Retrieval)
검색은 벡터 스토어에 기본 호출을 하는 것 이상입니다. 후보 집합(candidate set)을 줄이고 청크를 더 잘 순위 매길 수 있는 방법이 많습니다. 이 구성 요소에서는 검색 프로세스를 가능한 한 정확하고 효율적으로 만드는 것을 목표로 합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기