
Gemma 4 12B 소개: 통합적이고 인코더가 없는 멀티모달 모델
요약
Gemma 4 12B는 에이전트형 멀티모달 지능을 노트북에 구현하도록 설계된 최신 모델입니다. 별도의 인코더 없이 비전 및 오디오 입력을 LLM 백본으로 직접 통합하는 혁신적인 아키텍처를 채택했습니다. 이로 인해 메모리 사용량은 줄이고 26B MoE 모델에 근접한 강력한 추론 능력을 로컬 환경에서 구현할 수 있습니다.
핵심 포인트
- 별도 인코더가 없는 통합 아키텍처로 멀티모달 입력 처리 효율 극대화
- VRAM 16GB 노트북에서도 구동 가능한 경량화된 모델 크기 제공
- 네이티브 오디오 입력을 지원하는 최초의 중형 모델로서 기능 확장
- 26B MoE급 성능을 유지하면서 메모리 사용량을 절반 이하로 줄임
Gemma 4 12B 소개: 통합적이고 인코더가 없는 멀티모달 모델
오늘, 우리는 에이전트형(agentic) 멀티모달 지능을 노트북에 직접 구현하도록 설계된 최신 모델인 Gemma 4 12B를 소개합니다. 기기 친화적인 E4B와 더 진보된 26B Mixture of Experts (MoE) 사이의 격차를 메우는 Gemma 4 12B는 강력한 기능을 줄어든 메모리 사용량으로 패키징했습니다. 또한, 이는 네이티브 오디오 입력을 지원하는 최초의 중형 모델입니다.
개발자 커뮤니티 덕분에 Gemma 4 모델은 현재 1억 5천만 다운로드를 돌파했습니다. 여러분은 물리적 보조를 위한 웨어러블 로봇 팔부터 엔터프라이즈급 AI 보안 솔루션에 이르기까지 모든 것을 구축해 왔습니다. 저희는 이 최신 추가 기능을 통해 무엇을 만들어낼지 기대됩니다.
Gemma 4 12B가 독특한 이유에 대한 개요는 다음과 같습니다:
새로운 통합 아키텍처: 멀티모달 인코더가 없습니다. 비전 및 오디오 입력이 LLM 백본으로 직접 흐릅니다.고급 추론 능력: 벤치마크 성능은 26B 모델에 근접하며, 강력한 다단계 추론 및 에이전트형 워크플로우를 구현합니다.노트북 구동 가능: VRAM 또는 통합 메모리 16GB만으로 로컬에서 실행할 수 있을 만큼 작습니다.개방적이고 접근성 높음: Apache 2.0 라이선스 하에 출시되었으며 개발자 생태계 전반의 지원을 받습니다.Drafter 준비 완료: Gemma 4 12B는 지연 시간(latency)을 줄이기 위해 Multi-Token Prediction (MTP) drafters가 장착되어 있습니다.
이러한 기능들이 결합하여 속도나 추론 능력을 희생하지 않으면서 일상적인 하드웨어에 고급 멀티모달 기능을 가져옵니다. 이제 Gemma 4 12B가 어떻게 이를 달성하는지 자세히 살펴보겠습니다.
최첨단 에이전트를 로컬에서 구동하기
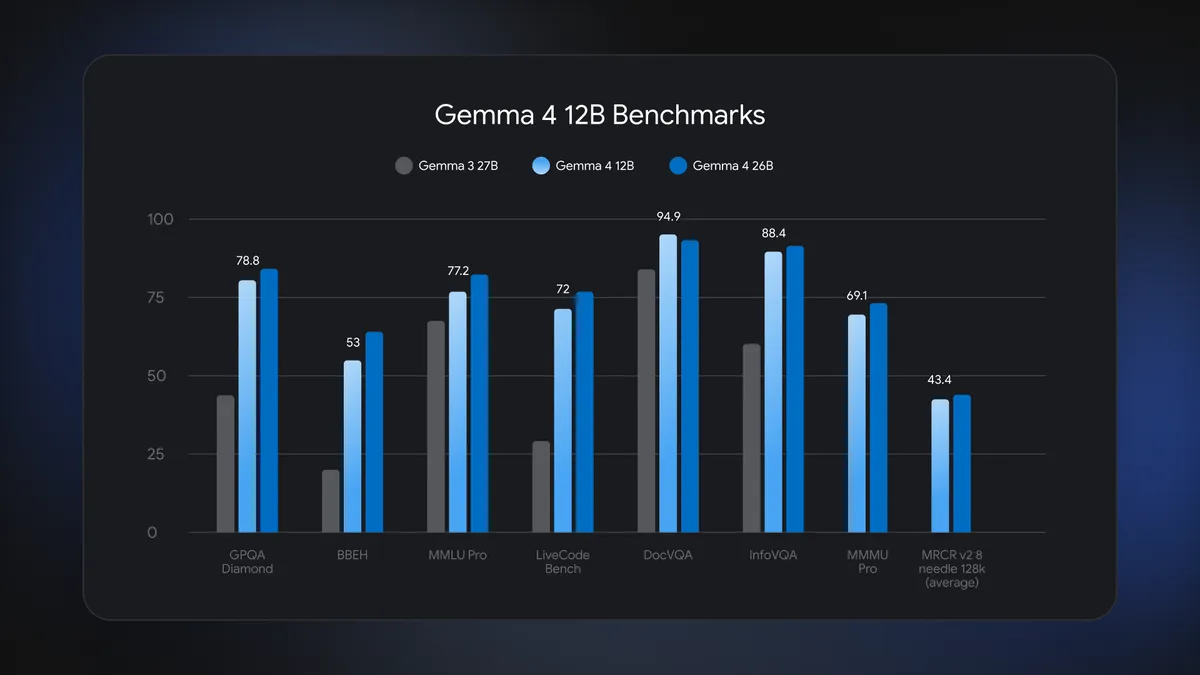
Gemma 4 12B는 표준 벤치마크에서 더 큰 26B MoE 모델에 근접한 성능을 제공하지만, 전체 메모리 사용량은 절반 이하입니다. RAM 16GB를 갖춘 소비자용 노트북에서도 로컬로 실행할 수 있을 만큼 작아, 여러분의 장치에서 강력한 멀티모달 및 에이전트형 경험을 구현합니다.
독특하게 효율적이고 통합된 아키텍처 경험하기
독특하게 효율적이고 통합된 아키텍처 경험하기
Gemma 4 12B가 돋보이는 점은 시각 및 오디오 입력을 처리하는 간소화된 접근 방식입니다. 기존의 멀티모달 모델들은 일반적으로 이미지와 오디오를 번역하기 위해 별도의 인코더에 의존하며, 이 표현(representation)들을 언어 모델로 전달합니다. 이러한 분리된 인코더들이 지연 시간(latency)을 추가하고 메모리 사용량을 증가시키기 때문에, 저희는 Gemma 4 12B를 오디오 및 비전 입력을 직접 통합하도록 인코더가 없는 아키텍처(encoder-free architecture)로 훈련했습니다.
Gemma 4 12B가 멀티모달 입력물을 네이티브하게 처리하는 방법은 다음과 같습니다:
비전 (Vision): Gemma 4의 비전 인코더를 단일 행렬 곱셈, 위치 임베딩(positional embedding), 정규화로 구성된 경량 임베딩 모듈로 대체했습니다. 이를 통해 LLM 백본이 시각적 처리를 담당할 수 있게 되었습니다.오디오 (Audio): 오디오 처리를 더욱 간소화했습니다. 오디오 인코더를 완전히 제거하고, 원시 오디오 신호(raw audio signal)를 텍스트 토큰과 동일한 차원의 공간으로 투영(projected)합니다.
자세한 내용을 알고 싶은 개발자분들은 저희의 보조 자료인 Gemma 4 12B 개발자 가이드(Developer Guide)를 참고해 주세요.
오늘 바로 시작하기
직접 사용해 보기: LM Studio, Ollama, Google AI Edge Gallery App, Google AI Edge Eloquent 앱, 그리고 LiteRT-LM CLI에서 몇 번의 클릭만으로 실험해 보세요.가중치 다운로드 (Download the weights): Hugging Face와 Kaggle에서 사전 훈련 및 명령어 미세 조정된 체크포인트(checkpoints)를 직접 다운로드하세요.통합 및 학습 (Integrate & learn): 개발자 문서를 검토하고 빠른 시작 노트북을 활용해 보세요.좋아하는 개발 도구 사용하기: Hugging Face Transformers, llama.cpp, MLX, SGLang, vLLM을 사용하여 로컬 추론 파이프라인(local inference pipelines)을 구현하거나 Unsloth를 사용하여 효율적으로 미세 조정하세요.**Gemma Skills로 에이전트 개발 잠금 해제 (Unlock Agentic Development with Gemma Skills):**에이전트가 최신 Gemma 발전을 활용하여 구축할 수 있도록 지원하기 위해, 공식 스킬스 리포지토리(Skills Repository)를 공개합니다. 이것은 에이전트가 Gemma 모델로 구축하는 것을 가능하게 하도록 특별히 설계된 스킬들의 라이브러리입니다.**원하는 방식으로 배포 (Deploy your way):**Google Cloud를 사용하여 프로덕션 환경에서 엔드포인트(endpoints)를 구동하세요. Gemini Enterprise Agent Platform Model Garden, Cloud Run 및 GKE를 통해 원하는 방식으로 배포할 수 있습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 Google DeepMind의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기