
Nvidia가 새로운 GenAI 모델과 라우터로 가성비를 높이다
요약
Nvidia는 Nemotron 3.5 Lightning 등 새로운 GenAI 모델과 오픈 소스 라이브러리를 출시하며 AI 분야의 영향력을 확대하고 있습니다. 이 제품군은 시스템 오브 모델(systems of models) 개념을 도입하여, 워크플로우 각 단계에 최적화된 다양한 모델을 활용할 수 있게 합니다. 또한, Nemotron 3 Super와 Ultra 등 특정 목적에 맞는 고성능 오픈 가중치 모델들을 지속적으로 선보이고 있습니다.
핵심 포인트
- Nemotron 3.5 Lightning은 시스템 오브 모델(model ensembles)의 일부로 작동합니다.
- Nemotron 3 Super는 기업 환경의 에이전트 워크플로우와 복잡한 추론에 최적화되었습니다.
- Nemotron 3 Ultra는 대규모 다단계 워크플로우 및 연구 자동화에 사용됩니다.
- Nvidia는 다양한 크기와 목적을 가진 오픈 가중치 모델 포트폴리오를 구축하고 있습니다.
AI
Nvidia가 새로운 GenAI 모델과 라우터로 가성비를 높이다
Nvidia는 끊임없이 확장되고 수익성이 높은 AI 분야에서 필수적인 플레이어 자리를 지키기 위해 노력하며, 그 영향력과 도달 범위를 계속해서 넓히고 있습니다. 오늘 초점은 기술 자체에 맞춰져 있으며, 이 공급업체는 오픈 AI 모델 포트폴리오를 추가하고 조직이 에이전트 기반 AI 워크플로우의 모든 단계에서 적절한 모델을 찾을 수 있도록 사용할 수 있는 오픈 소스 모델 라이브러리를 추가했습니다. 이는 기본 모델에 의존하거나 자체적으로 옵션을 분류할 필요가 없게 만듭니다.
하지만 세계에서 가장 부유한 기업이 AI 운영 및 도입을 촉진하기 위한 아키텍처 제공 범위를 계속 구축하는 와중에도, 최근 몇 주 동안 보안과 데이터센터 자금 조달이라는 AI 업계의 관심이 높아지는 영역으로도 진출하고 있습니다.
AI 산업의 어떤 계층을 보더라도, 아마 Nvidia를 발견할 가능성이 높습니다.
모델 공간에서 Nvidia는 Nemotron 3 모델 범위가 포함된 성장하는 오픈 모델 목록을 확장하고 있습니다. Nemotron 3.5 Lightning은 나머지 Nvidia의 Nemotron 모델들과 일치하며, 이는 시스템 오브 모델(systems of models), 즉 모델 앙상블(model ensembles)의 일부로 작동하도록 설계되었습니다. 이 경우 워크플로우의 각 단계에 서로 다른 모델이 사용됩니다. 시스템 오브 모델은 전문가 혼합(mixture of experts, MoE)과 정확히 같은 것은 아닙니다. MoE는 특정 모델 내에서 수십 개에서 수백 개의 고유한 전문가가 선택적으로 활성화되는 현대 GenAI 모델을 구축하는 접근 방식입니다. 이는 더 높은 수준의 추상화 계층입니다.
Nvidia의 생성형 AI 부문 부사장인 Kari Briski는 출시 전 브리핑에서
Lightning은 또한 오픈 모델들이 시장에 계속 출시되는 시점과 맞물려 있습니다. 특히 Moonshot AI의 Kimi K3, DeepSeek의 다양한 모델, Alibaba의 Qwen 계열 등 중국 벤더들로부터 나오는 모델들이 그렇습니다. 미국에서는 Meta가 이번 주 Muse Glimmer를 출시했는데, 이는 약속된 오픈 모델 세트 중 첫 번째입니다. (여기서 '오픈 가중치(open weights)'라는 의미이며, 반드시 모델의 학습 알고리즘에 대한 오픈 소스 코드를 의미하지는 않습니다.)
Briski는 지난 한 해 동안 Nvidia가 Nemotron Nano, Super, Ultra 모델을 출시해 왔으며, 각각 특정 작업을 위해 설계되었다고 언급했습니다. 2025년 12월에 출시된 Nano는 실시간 AI 에이전트, 다단계 도구 호출(multi-step tool calls), 고급 수학 및 코딩 기능을 갖춘 고처리량의 효율적인 소형 언어 모델입니다. Nemotron 3 Super는 기업 환경에서 효율적인 에이전트 기반 AI 워크플로우, 복잡한 추론 작업, 정확한 도구 호출을 위해 설계된 1,200억 개 매개변수(billion parameter)의 오픈 가중치 모델이며 MoE 설계를 채택했습니다.
Nemotron 3 제품군 추가
Nemotron 3 Ultra는 5,500억 개 매개변수(parameters)에 달하는 추론 모델로, 에이전트 오케스트레이션(agent orchestration), 심층 저장소 코딩(deep repository coding), 여러 출처를 기반으로 하는 연구, 기업 자동화와 같은 다단계 워크플로우를 실행하는 고처리량 및 장시간 구동 에이전트에 사용됩니다.
Briski는 “Lightning은 우리 제품군의 최고 장점들을 하나로 모았습니다. Ultra의 지식을 Nano 크기에 담았다고 할 수 있습니다. 그리고 Lightning은 지속적인 전문 작업 스트림을 처리하는 항상 켜져 있는(always-on) 에이전트를 위해 구축되었으며, 빠르고 정확하며 효율적이고, 동급 모델 대비 네 배 높은 처리량(throughput)을 제공하면서도 Super 모델과 동일한 지능 지수(intelligence index)를 가지며, 개발자가 추가 학습(post-train)할 수 있고 전문 작업에 최적화된 초강력 워크호스 모델입니다.”라고 말했습니다.
또한 Nvidia의 Jetson, GeForce RTX, DGX Spark 및 DGX Station 시스템에서도 실행될 수 있어, 개발자와 그 에이전트들이 모든 작업을 클라우드 API를 호출하는 대신 자체 하드웨어로 작업을 수행할 수 있게 합니다.
Nvidia에 따르면, 4배의 출력 속도는 에이전트 AI 작업을 완료하는 데 있어 다른 모델 대비 30%의 속도 향상을 가져옵니다. 조직은 NeMo 플랫폼을 통해 자체 데이터와 도구로 모델을 추가 학습(post-train)하여 전문화된 작업에 활용할 수 있습니다. Nvidia는 또한 학습 데이터와 기술을 공개하고, 코딩 에이전트 학습을 위한 오픈 데이터셋인 Nemotron-RL-Agentic-Terminal-Pivot을 출시합니다.
Briski는 코딩, 리서치, 파일 관리 등 에이전트 작업을 개방형 모델의 성능을 평가하는 PinchBench 테스트 결과가 Lightning이 비교 가능한 Qwen 모델보다 최대 30% 빠르며, Google DeepMind의 Gemma와 같은 다른 최첨단 AI 모델보다도 빠르다는 것을 보여준다고 말했습니다. 확인해 보세요:
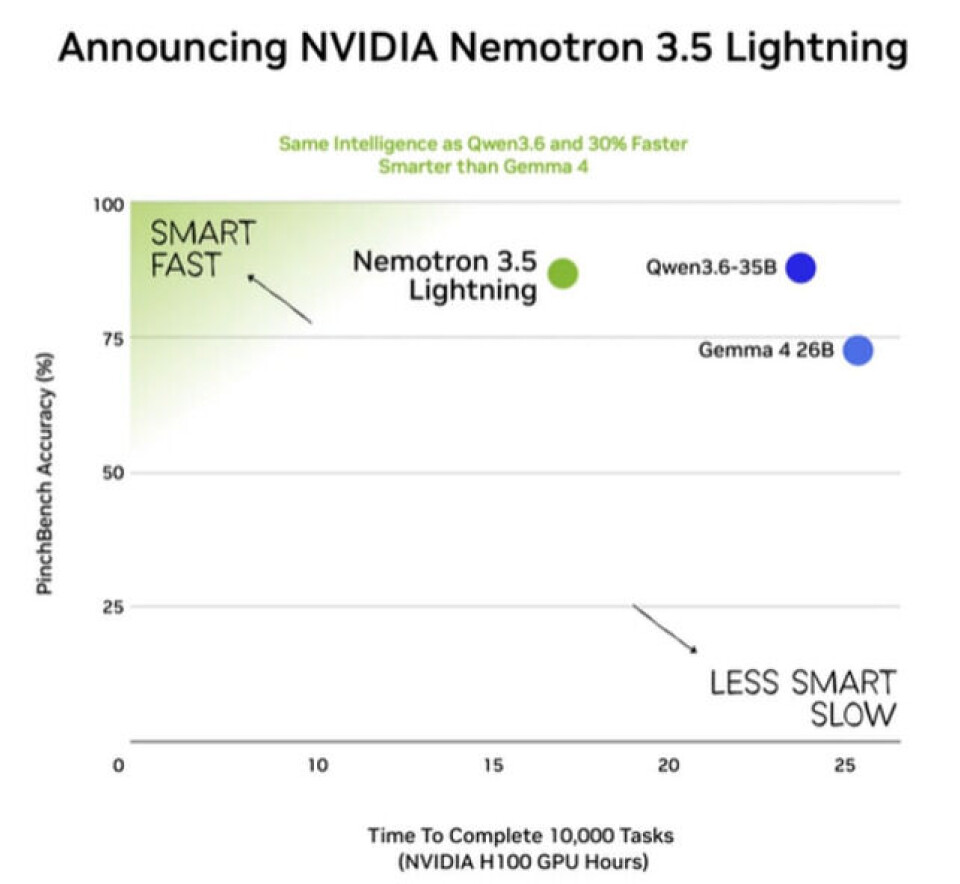
그녀는 속도가 중요하다고 언급했는데,
AI 모델 라우터는 새로운 것이 아닙니다. OpenRouter, Not Diamond부터 LiteLLM에 이르기까지 다양한 공급업체가 있으며, 이들은 동일한 문제를 해결하려고 노력하고 있습니다. 항상 작동하는 에이전트(Always-on agents)나 장시간의 자율 작업은 모델을 호출하여 높은 토큰 비용을 발생시키고, AI 워크로드 운영 비용을 증가시키며 정확도를 위험에 빠뜨립니다. Microsoft는 5월에 Switchcraft를 공개했는데, 이 공급업체에 따르면 이는 정확도를 거의 83% 높이고 추론(inference) 비용을 84% 절감합니다.
Nvidia는 개발자들에게 AI 워크플로우와 라우팅 기능을 모두 얻을 수 있는 단일 장소를 제공하는 방법으로 자체 오픈 모델 라인업에 Switchyard를 도입하려고 합니다.
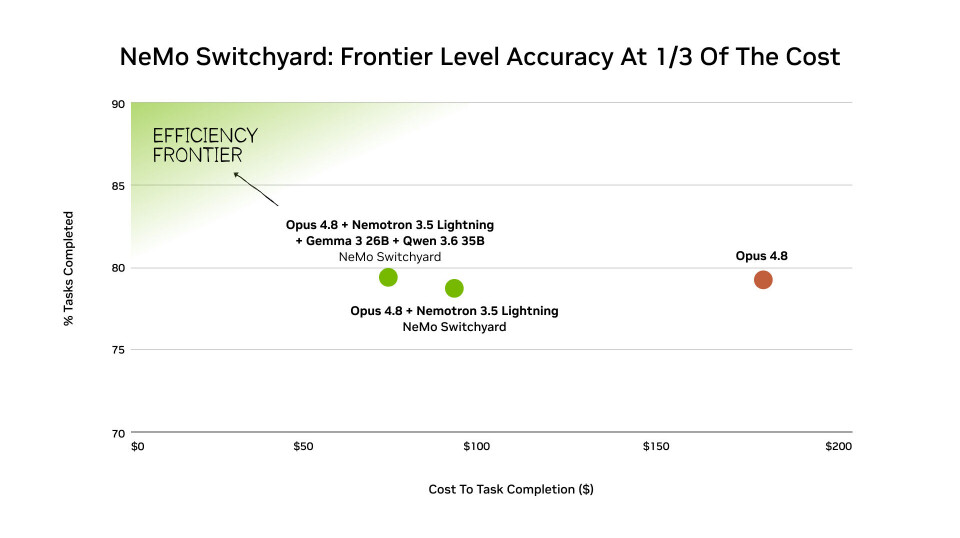
Briski는 “Switchyard는 개발자와 플랫폼이 자신만의 모델 풀, 라우팅 기준 및 정책을 정의할 수 있는 방법을 제공합니다”라고 말했습니다. “이는 최첨단(frontier) 모델을 추론 집약적인 단계와 Lightning으로 라우팅하고, 속도와 효율성이 중요한 실행 작업에 라우팅합니다. 이것이야말로 시스템 모델의 힘입니다. 워크플로우의 각 단계에 맞는 올바른 모델을 매칭하는 것이죠.”
그녀는 아래 차트가 Switchyard가 Anthropic의 Opus 4.8 모델 단독 사용 비용의 3분의 1 수준에서 더 나은 정확도를 제공하며, Opus 4.8을 Lightning 및 Gemma 3와 결합할 때 정확도와 비용 모두 향상됨을 보여준다고 말했습니다.
이 모든 것은 Nvidia가 보안을 포함하여 생성형 AI(generative AI) 및 에이전트 기반 AI(agentic AI)의 다른 영역으로 더 깊이 진출하고 있는 가운데 이루어지고 있습니다. OpenAI의 GPT-5.6-Sol과 또 다른 미공개 최첨단 모델에 대한 보고 이후, 이들이 Hugging Face를 자율적으로 침해하자, Nvidia는 30여 개가 넘는 회사의 컨소시엄을 주도하여 Open Secure AI Alliance를 출범시켰습니다. 이들은 인프라를 AI 위협으로부터 방어하는 데 사용되던 보호 장치가 모든 방어자가 적응하고 배포할 수 있는 오픈 모델과 도구를 기반으로 구축되어야 한다고 주장합니다. 현재 이 컨소시엄은 120개 이상의 회원사를 포함하며, 에이전트 기반 AI 사이버 보안을 강화하기 위한 새로운 가이드라인을 개발하면서 의견을 수렴하고 있습니다.
또한 해당 벤더는 오픈 모델을 보호하기 위한 또 다른 움직임으로 AI 안전 및 보안 팀의 인력을 확충하고, 보안 리서치 엔지니어를 모집하고 있는 것으로 알려졌습니다.
Nvidia는 조직들이 AI 인프라 비용을 지불할 수 있도록 돕기 위해 글로벌 투자 회사인 Apollo, BlackRock, Blackstone, Brookfield, Goldman Sachs, KKR과 협력하여 5,000억 달러 규모의 펀드를 조성합니다. 기업, 중소기업, 스타트업 및 정부 기관들은 AI 인프라를 구축할 방법을 모색하고 있습니다.
Nvidia 공동 창립자이자 최고 경영자인 Jensen Huang에 따르면, 이 펀드는 다음과 같은 도움을 줄 것입니다.
황은 성명을 통해 “AI 분야에서 컴퓨팅(compute)은 곧 매출입니다”라고 말하며, 해당 벤더의 DSX AI 팩토리와 다른 Nvidia 기술들의 광범위한 채택이 “개발자, 고객, 오프테이커로 구성된 깊은 글로벌 생태계에 의해 뒷받침되고 있다”고 지적했습니다. 그는 또한 “그렇기 때문에 우리는 전 세계 최고의 장기 자본 제공자들을 모아 AI 인프라를 독립적으로 인수(underwrite)하고 있습니다.”라고 덧붙였습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기