
Taalas를 통해 AMD가 AI 추론을 자체 칩에 직접 구현할 수 있게 되다
요약
AMD가 Taalas를 통해 AI 추론 엔진을 자체 칩에 직접 구현할 수 있게 되어, 낮은 지연 시간의 에이전트형 AI 구동에 유리해졌습니다. Nvidia CEO는 GPU 아키텍처만으로는 높은 상호작용 수준의 추론 성능을 달성하기 어렵다고 지적하며, 프리필과 디코드 부분을 분리하여 처리하는 것이 중요함을 강조했습니다.
핵심 포인트
- AMD Taalas를 통해 자체 칩에서 AI 추론 구현 가능
- GPU는 범용 병렬 처리에 강하나, 디코드 부분은 결정론적이지 않음
- 추론 성능 극대화를 위해 프리필과 디코드를 분리 처리해야 함
- 최신 하이브리드 플랫폼(Vera-Rubin)이 높은 상호작용 수준에서 우수한 성능을 보임
compute
Taalas를 통해 AMD가 AI 추론을 자체 칩에 직접 구현할 수 있게 되다
Nvidia의 최고경영자(CEO)이자 공동 창업자인 Jensen Huang은 지난 2026년 3월 GTC에서, 하이퍼스케일러, 클라우드 빌더, AI 모델 빌더 및 기타 기업뿐만 아니라 국가 주권 기관들까지도 에이전트형 AI를 사용하거나 채팅봇 추론에 프리미엄을 받고자 낮은 지연 시간(low latency)의 추론이 필요하다면 GPU 아키텍처로는 이를 할 수 없다고 폭로했습니다.
Huang이 보여준 것은, 더 넓은 범위의 지연 시간 프로필에서 최고의 낮은 지연 시간 성능을 얻기 위해 기업들이 해야 할 일은 AI 추론 엔진을 분할하여 컨텍스트 윈도우의 입력 토큰을 GPU 클러스터에서 처리하는 것(이는 이 작업에 매우 능하며 'prefill'이라고 불립니다)과, 모델이 응답을 제공하는 디코드 부분(decode part)을 Grok, SambaNova Systems, Cerebras Systems 등이 만든 것과 같은 대규모 병렬적이고 더 결정론적인 SRAM 기반의 행렬 연산 엔진에 오프로드하는 것이라는 점입니다.
그 이유는 간단합니다. GPU는 훌륭하고 고성능이며 높은 대역폭을 가진 범용 병렬 처리 엔진이지만, 추론의 디코드 부분에서의 성능은 이상적이기보다는 결정론적이지 않습니다. GTC에서 Huang이 보여준 차트에 따르면, 'Grace' CG100 CPU와 'Hopper' H100 GPU로 구성된 시스템(아마도 8개 GPU 노드)은 사용자들을 배치 처리하여 사용자가 초당 약 100개의 토큰을 처리할 수 있는 부하를 감당할 수 있지만, 그 이후에는 성능이 떨어지는 것으로 나타났습니다.
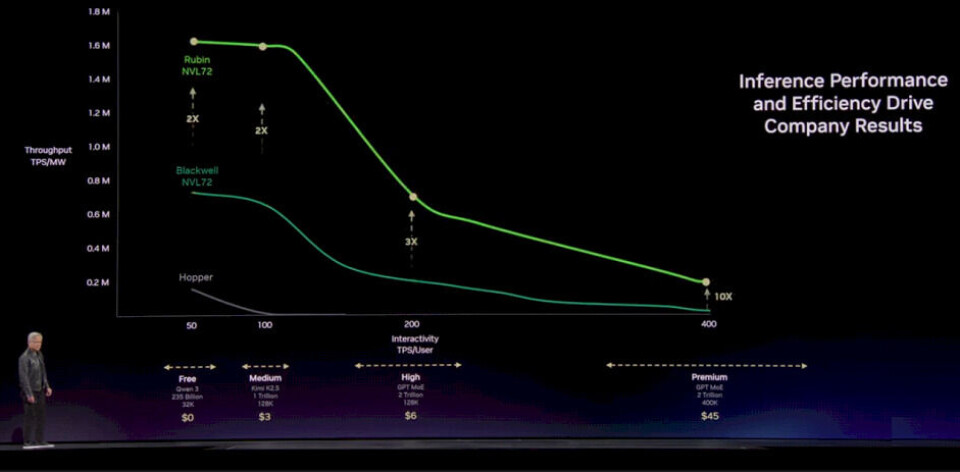
그는 이것을 중간 수준의 성능이라고 불렀습니다. 18개의 CPU와 동일한 Grace CPU 및 Nvidia의 “Blackwell” B300 GPU를 기반으로 하는 36개 GPU를 갖춘 NVL72 하이브리드 CPU-GPU 플랫폼은 100 TPS 상호작용 수준에서 약 3.5배의 성능(메가와트당 토큰/초로 표현)을 제공합니다. 임박한 “Vera” CV100 CPU 및 “Rubin” R200 GPU를 기반으로 하는 NVL72 랙 규모 시스템은 Grace-Blackwell 시스템보다 약 2배의 TPS/MW를 달성할 수 있으며, 이는 Grace-Hopper 시스템 대비 7배에 해당합니다.
Grace-Hopper 노드는 이보다 더 높은 상호작용을 구현하기는 어려웠지만, 적절한 전체 처리량을 유지하면서 Huang이 'High'로 부른 200 TPS/사용자를 지원하도록 Grace-Blackwell 시스템을 구동할 수는 있었습니다. 하지만 Vera-Rubin NVL72가 3배 더 나은 성능을 보여줍니다. 프리미엄(Premium) 수준, 즉 400 TPS 상호작용에서는 Grace-Blackwell 랙 규모 시스템의 TPS/MW가 거의 0에 가까워지지만, Vera-Rubin은 그보다 10배 더 나은 성능을 보이며 합리적인 전체 TPS/MW를 제공합니다.
다시 말해, 이 모든 것은 추론(inference)의 프리필(prefill)과 디코드(decode) 부분 모두에 GPU를 사용한다는 점입니다. 하지만 Nvidia가 추론 부하를 분할하여 프리필은 GPU에, 디코드는 현재 Grok LP30 가속기 랙으로 가정되는 곳에 배치했을 때 무슨 일이 일어나는지 보십시오:
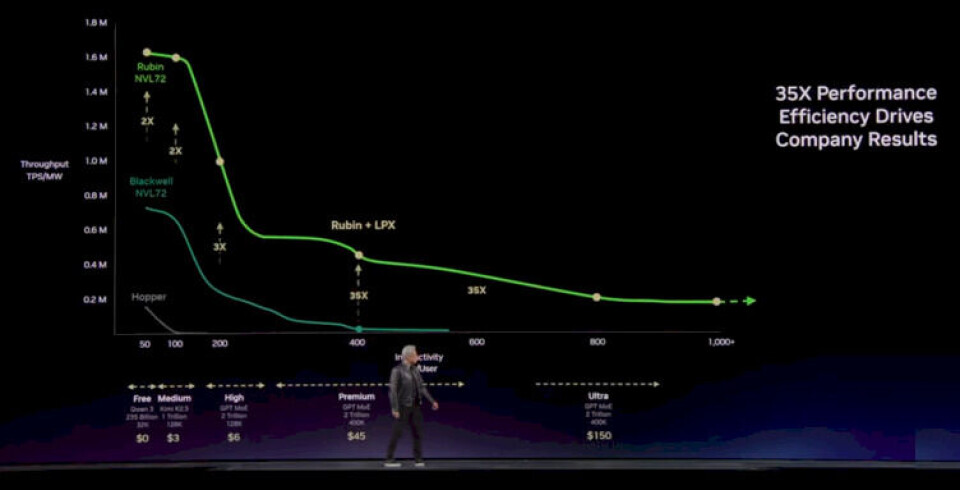
사용자당 1,000 TPS 이상의 상호작용을 가진 에이전트 워크로드(agentic workloads)의 성능 기준선이 될 수 있는 완전히 새로운 울트라(Ultra) 추론 계층이 열립니다. 게다가 Grok 없이 NVL72에 Vera-Rubin을 사용하고 Grok까지 추가하면, Grok 가속기가 없는 경우보다 35배 더 높은 성능을 갖춘 프리미엄 수준을 구현합니다 (Grok 가속기 없이는 10배). GPU 가속기만으로는 적절한 전체 시스템 처리량에서 사용자당 400 TPS 이상을 구동하기 어렵다는 것을 명확하게 알 수 있습니다.
물론 Grok 클러스터가 디코드 부분에서 확장할 수 있는 데에는 한계가 있습니다. 이 장치들을 백만 개 연결하여 상호작용을 더 높일 수는 없습니다. (물론 그 한계가 무엇인지는 저희도 모릅니다.)
이 두 개의 차트는 엔비디아(Nvidia)가 지난 12월에 Grok 팀과 기술을 200억 달러에 인수했던 이유뿐만 아니라, AMD가 분산형 추론(disaggregated inference)을 위해 Cerebras와 파트너십을 맺는 이유와 이번 주에 알려지지 않은 금액으로 AI 추론 스타트업 Taalas를 인수한 이유도 설명합니다. AMD의 GPU 역시 추론 디코드(inference decode) 측면에서 엔비디아의 GPU와 같은 한계를 가지고 있습니다.
Cerebras와의 파트너십은 AMD와 Cerebras 모두에게 좋은 일입니다. 이 협력은 올해 후반에 발표될 것으로 예상되는 4세대 웨이퍼 스케일 컴퓨팅 엔진(WSE-4)을, AMD의 'Helios' 클러스터가 'Verano' Epyc CPU 및 'Altair' MI455X GPU를 사용하여 엔비디아가 미래 Vera-Rubin-LPU 조합으로 보여주었던 것과 같은 분산형 추론 작업을 수행하게 할 것입니다.
유일한 문제는 AMD가 Cerebras 기술을 통제하지 못한다는 점입니다. 후자 회사는 많은 돈을 모금하여 올해 초 상장되기 전 AMD에게 매우 비싼 것이 되었습니다. AMD는 점점 자체 스택(stack)을 통제하는 것을 좋아하는데, 현재 Cerebras의 시가총액은 509억 달러이며, 이는 AMD가 분기당 2억 달러 미만의 매출을 올리는 회사에 600억 달러를 지불해야 할 수도 있음을 의미합니다. 연간 매출의 300배를 지불하는 것은 현재 그 프리미엄이 그보다 1/10 수준일 수 있는 세상에서는 매우 위험합니다.
따라서 AMD는 일단 파트너십을 선택한 것으로 보입니다. Graphcore가 Softbank(Arm의 소유자)에 흡수되고, 엔비디아가 사실상 Grok을 인수하며, SambaNova가 인텔과 파트너십을 맺은 상황에서 Cerebras가 유일한 선택지였고, 향후 추론 가속화를 위한 새로운 접근 방식을 모색할 것으로 보입니다.
저는 올해 2월에 회사가 스텔스 모드(stealth mode)를 해제했을 때 Taalas에 대해 깊이 파고든 적이 있습니다만, 여기에서 그 모든 것을 반복하지는 않겠습니다. 이 회사는 AI 가속기 및 RISC-V 분야의 선두주자인 Tenstorrent를 설립했거나 근무했던 엔지니어들이 모여서 창업했습니다. 그리고 이 회사의 혁신적인 핵심은 AI 추론 모델과 해당 가중치(weights)를 ROM 회로에 하드 코딩하고, 이를 온칩 KV 캐시 역할을 하는 거대한 SRAM 블록에 연결하는 것입니다. Taalas 칩의 현재 HC1 세대는 80억 개 매개변수(parameters)를 가진 모델을 저장할 수 있으며, 차세대 HC2는 200억 개 매개변수를 처리하도록 예정되어 있었습니다. 몇십 개의 칩을 상호 연결하면 이론적으로 1조 개 매개변수에 달하는 추론 모델의 모델과 가중치를 담아낼 수 있습니다. 초기 벤치마크 테스트에서 Taalas는 Nvidia Blackwell B200 GPU와 비교했을 때, 추론에 있어 극도로 낮은 지연 시간(latencies)과 훨씬 낮은 토큰당 비용을 보여주고 있습니다.
Taalas의 트릭은 각 모델마다 HC1 칩렛(chiplet)의 변형이 필요하다는 것입니다. SRAM과 그 주변 구성 요소는 동일하지만, 모델과 가중치를 인코딩하는 칩 내부의 금속층 두 개가 변경되어야 합니다. 하지만 다시 말해, Taalas에 따르면 새로운 GenAI 모델을 훈련시키는 데 드는 비용보다 Taalas의 HC 칩을 맞춤 제작하여 합리적인 수량(이 비교를 위해 몇십만 개 단위가 적절한 추정치입니다)으로 구매하는 것이 훨씬 저렴하다고 합니다.
AMD는 Taalas에 대한 계획을 많이 밝히지는 않았지만, “AMD는 이 기술을 자체 가속기 로드맵에 통합하고 AMD Instinct GPU와 시스템 레벨 솔루션을 개발할 계획”이라고 밝혔습니다.
모델별 아키텍처(Model Specific Architectures)의 세계에 오신 것을 환영합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기