
Gemini 3.8 text-to-speech가 인사합니다
요약
Google이 Gemini 제품군에 두 가지 새로운 텍스트-투-스피치(TTS) 모델인 Gemini 3.8 Flash TTS와 Gemini 3.8 Flash-Lite TTS를 공개했습니다. 이 모델들은 크리에이터와 개발자가 자연어 프롬프팅을 통해 캐릭터의 목소리를 처음부터 만들고, 세밀한 연기 지시 및 다양한 언어/방언으로 풍부하고 표현력 높은 오디오 콘텐츠를 제작할 수 있게 합니다.
핵심 포인트
- Gemini 3.8 Flash TTS는 창의적 방향 설정과 캐릭터 디자인에 중점을 두었습니다.
- Flash-Lite TTS는 대용량, 비용 효율적인 규모 확장에 최적화되어 있습니다.
- 자연어 프롬프팅으로 100개 이상의 언어와 방언에서 독특한 목소리 생성이 가능합니다.
- 30초 샘플만으로 음성 복제가 가능하며, 동의 확인 및 워터마킹 기술로 보호됩니다.
Gemini 3.8 text-to-speech가 인사합니다
오늘, 저희는 Gemini 제품군에 두 가지 새로운 text-to-speech 모델을 소개하며, 음성 생성을 정적인 프리셋에서 역동적인 크리에이티브 스튜디오로 변화시키고 있습니다. 이 모델들은 크리에이터, 개발자 및 기업들이 더 풍부하고 표현력이 뛰어난 오디오 경험을 만들 수 있도록 하며, Gemini Notebook이나 Google Vids와 같은 제품의 사용자 경험 개선에도 기여합니다.
Gemini 3.8 Flash TTS: 깊이 있는 창의적 방향 설정과 캐릭터 디자인에 중점을 두었습니다. 자연어 프롬프트를 사용하여 완전히 새로운 목소리를 처음부터 만들고, 게임, 몰입형 오디오북, 팟캐스트 및 인터랙티브 미디어 전반에 걸쳐 캐릭터를 생생하게 구현할 수 있습니다. 연기 지시(acting cues), 속도 조절(pacing), 방언 변화(dialect shifts), 백채널링(backchanneling)에 대한 세밀한 제어로 모든 연기 라인을 직접 지시할 수 있습니다.Gemini 3.8 Flash-Lite TTS: 대용량, 비용 효율적인 규모 확장에 중점을 두었습니다. 높은 볼륨의 더빙, 오디오 콘텐츠 제작 및 어조, 속도, 표현적 뉘앙스에 대한 세밀한 제어를 갖춘 표현력 있는 음성 에이전트에 최적화되어 있습니다.
이 모델들은 3.5 Live Translate, 3.5 Transcribe, 3.8 Live, 그리고 3.8 Live Extended Thinking을 거쳐 빠르게 성장하는 Gemini Audio 제품군을 보완합니다.
자신만의 목소리를 만들고 맞춤 설정하기
기존 30개의 오리지널 음성에서 무한한 라이브러리로 규모를 확장할 수 있습니다. 완전히 새로운 캐릭터 목소리가 필요하든, 일관된 브랜드 앰버서더가 필요하든, 저희의 3.8 Flash TTS 모델은 완벽한 보컬 스튜디오 역할을 합니다. 이를 통해 개발자와 기업들은 모든 순간에 표현력이 풍부하고 자연스러운 음성을 만들고 사용할 수 있게 되며, 맞춤형 오디오 경험을 쉽게 구축할 수 있습니다.
생성형 음성 디자인: Gemini 3.8 Flash TTS를 사용하면 자연어 프롬프팅을 통해 100개 이상의 언어와 방언에 걸쳐 역할(role), 악센트(accent), 목소리 특성을 맞춤 설정하여 처음부터 독특한 목소리를 만들 수 있습니다. 드라마틱하게 불을 내뿜는 용을 생명체로 만들든, 특정 지역의 억양을 가진 카리스마 있는 내레이터를 제작하든 가능합니다.
멜버른 출신의 활기찬 DJ 목소리를 Gemini 3.8 Flash TTS가 어떻게 생성하는지 들어보세요.
슈퍼로 작고 단조로운 로봇 목소리가 어떻게 생성되는지 들어보세요.
Gemini 3.8 Flash TTS가 일본 용을 생명체처럼 구현하는 것을 들어보세요.
광범위한 음성 라이브러리: 멕시코 스페인어, 퀘벡 프랑스어, 스코츠 영어와 같은 지역별 변이체를 포함하여 광범위한 언어 커버리지를 가진 2,000개 이상의 제작 준비가 된 목소리에 접근할 수 있습니다.
음성 복제: 사용자의 음성 또는 사용 권한이 있는 목소리의 오디오 샘플 단 30초만으로 일관된 보컬 프로필을 재현할 수 있으며, 개발자와 해당 성우의 목소리를 보호하기 위해 내장된 동의 확인(consent verification), SynthID 워터마킹, C2PA 자격 증명으로 뒷받침됩니다.
저장 및 확장: 설계한 사용자 지정 음성을 저장하고 관리하여 진행 중인 프로젝트 전반에 걸쳐 일관된 성능과 최소한의 드리프트(drift)를 보장합니다.
음성 리믹싱: 곧 출시될 예정이며, 음성 라이브러리에서 목소리를 선택하고 음색(timbre), 피치(pitch), 속도(pace), 억양(accent)을 미세 조정할 수 있습니다. 프롬프트를 사용하여 특성을 조절하세요 (예: “은근한 남부 미국 억양 추가” 또는 “전달 방식을 부드럽게”).
라인별 성능 지시
음성을 선택했다면, 두 TTS 모델 모두 각 문장이 어떻게 전달될지에 대한 정밀한 제어 기능을 제공합니다.
라인별 성능 지시: 직접 연출 지침을 작성하거나 Gemini가 자연스러운 스크립트 큐를 사용하여 전달을 안내하도록 할 수 있습니다. 차분한 고객 서비스 상담원 목소리부터 속삭이는 서스펜스 장면까지 가능합니다.
Gemini 3.8 Flash TTS가 인터랙티브 음성 에이전트를 위한 자연스럽고 매우 표현력이 풍부한 대화를 어떻게 구현하는지 들어보세요.
Gemini 3.8 Flash TTS가 세밀한 스크립트 제어를 사용하여 깊이 몰입감 있는 오디오 경험을 구축하는 것을 시청하고 들어보세요.
장문 생성(Long-form generation): 화자 이탈(speaker drift)을 최소화하면서 몇 시간 동안 지속되는 오디오 전반에 걸쳐 높은 음성 품질, 자연스러운 속도, 캐릭터의 음색을 유지합니다. 팟캐스트나 오디오북 제작에 이상적입니다.네이티브 투 스피커 장면 연출(Native two-speaker scene staging): 단일 스크립트에서 직접 여러 차례의 대화를 원활하게 진행할 수 있습니다. 팟캐스트든 극적인 스토리텔링이든 상관없이, 두 목소리를 자연스러운 대화 순서로 명확하게 분리하여 유지합니다.스크립트 기반 음성 폭발 및 백채널링(Scripted vocal bursts & backchanneling): 비언어적 신호(<laughs>, <sigh>, <gasp> 등)와 능동적인 경청 간투사(|mhm| 또는 |yeah| 등)를 사용하여 현실적인 대화의 질감을 더함으로써, 정확한 코믹 타이밍과 반응 순간을 연출할 수 있습니다.
Gemini 3.8 Flash TTS가 자연어 프롬프트를 처음부터 맞춤형 음성 페르소나로 변환하는 방식을 확인해 보세요.
Gemini 3.8 Flash TTS가 크리에이터가 애니메이션 대화를 생생하게 구현하도록 커스텀 장면을 디자인할 수 있게 하는 방법을 시청하세요.
Gemini 3.8 Flash TTS가 스크립트를 완전히 연기된 대화 장면으로 변환하여, 크리에이터가 음성 전달과 자연스러운 순서 진행을 지시하는 방식을 확인해 보세요.
글로벌 규모에 맞춰 구축된 표현력이 풍부한 고품질 음성 생성 기능
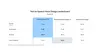
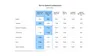
Gemini 3.8 Flash TTS는 선도적인 음성 커스터마이징 기능을 제공하며, Hume AI의 Voice Design Benchmark에서 전체 부문 #1을 차지(71.4)했을 뿐만 아니라 악센트 모델링에서도 선두를 달리고 있습니다(60.8).
Gemini 3.8 Flash TTS와 Gemini 3.8 Flash-Lite TTS는 신뢰성을 희생하지 않으면서도 진정으로 표현력이 풍부한 연기를 가능하게 하며, Hume AI의 Overall Quality Index에서 각각 #1과 #2를 차지했습니다. 이 모델은 Gemini 3.1 Flash TTS에 비해 장문 콘텐츠 및 듀얼 스피커 시나리오 제어와 같은 광범위한 사용 사례에서 큰 개선을 보여줍니다.
Voice Arena에서 진행된 블라인드 인간 선호도 평가(blind human preference evaluations) 결과, Gemini 3.8 Flash와 Flash-Lite TTS는 일본어, 브라질 포르투갈어, 베트남어, 현대 표준 아랍어(MSA), 멕시코 스페인어, 힌디어를 포함한 주요 글로벌 언어에서 경쟁 모델들 사이에서 최상위권을 차지했습니다. 100개 이상의 언어를 지원하는 이 모델들은 크리에이터, 개발자, 그리고 기업들이 전 세계적으로 고품질의 다국어 음성 경험을 구축할 수 있도록 힘을 실어줍니다.

신뢰, 동의, 투명성을 바탕으로 구축하세요
저희는 보이스 인재를 보호하고 정체성을 존중하며 콘텐츠의 투명성을 확보하기 위해 엄격한 안전장치를 갖추고 음성 생성 및 복제 기능을 개발했습니다. 음성 복제의 경우, 저희 시스템은 동의 확인(consent verification)을 활용합니다. 즉, 음성이 생성되기 전에 사용자는 참조 화자(reference speaker)와 일치하는 목소리 주인의 구두 동의 녹음 파일을 제공해야 합니다.
더 광범위하게는, Gemini Audio 모델로 생성되는 모든 오디오 클립에는 SynthID 워터마크가 적용됩니다. 이 감지할 수 없는 워터마크는 오디오 출력에 직접 직조되어 AI가 생성한 음성이 탐지될 수 있도록 보장하며, 이는 잘못된 정보(misinformation)를 방지하는 데 도움을 줍니다. 안전 및 책임에 대한 접근 방식에 대한 더 자세한 내용은 모델 카드를 검토해 주십시오.
새로운 Google AI Studio 오디오 플레이그라운드를 사용해 보세요
오늘부터 개발자들은 Google AI Studio에서 이러한 새로운 음성 생성 기능을 경험할 수 있습니다. 음성 디자인 작업 공간처럼 구축된 이곳에서, 처음부터 완전히 새로운 목소리 정체성을 프롬프트로 만들거나 자신만의 목소리를 복제한 다음, 이를 듀얼 스피커 시나리오 스크린플레이 에디터에 직접 가져와 대사별 전달을 지시할 수 있습니다.
Google AI Studio에서 음성 복제를 사용해 보세요.
쉽게 고성능 음성 인터페이스를 배포하세요
Gemini API를 사용함으로써, Agora, LiveKit, Pipecat, Vercel과 같은 개발자 플랫폼은 개발자들이 높은 성능의 음성 생성 경험을 쉽고 편리하게 구축하고 배포할 수 있도록 지원합니다.
저희는 Figma, HeyGen, Linguana, Wondercraft, 99.co, Ollang과 같은 회사들과 파트너십을 맺고 있으며, 이들은 저희의 최신 TTS 모델을 통합하여 글로벌 더빙 가속화, 미묘한 지역 억양을 사용한 미디어 현지화, 그리고 대규모 대화형 음성 에이전트 구동에 도움을 받고 있습니다.


최신 Gemini Audio 모델 사용 시작:
Gemini 3.8 Flash TTS가 오늘부터 출시됩니다:
개발자를 위해: Gemini API 및 Google AI Studio에서 이용 가능
기업을 위해: 곧 Gemini Enterprise의 API를 통해 제공 예정
모두를 위해: Gemini Notebook에서 이용 가능
Gemini 3.8 Flash-Lite TTS가 오늘부터 출시됩니다:
개발자를 위해: Gemini API 및 Google AI Studio에서 이용 가능
기업을 위해: 곧 Gemini Enterprise의 API를 통해 제공 예정
모두를 위해: Google Vids에서 이용 가능
AI 자동 생성 콘텐츠
본 콘텐츠는 Google DeepMind의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기