
유럽 및 중동 지역의 에이전트 규모 확장: Schneider Electric, Vodafone, monday.com 사례를 통해 얻은 교훈
요약
유럽 및 중동 지역의 기업들은 단일 챗봇 대신, 여러 사업 부서에 걸쳐 산재된 에이전트 PoC를 통합하기 위해 중앙 에이전트 플랫폼 구축에 집중하고 있습니다. Schneider Electric, monday.com, Vodafone 등의 사례는 성공적인 운영을 위해서는 관측 가능성, 평가, 배포가 포함된 강력한 인프라 계층(infrastructure layer)이 필수적임을 보여줍니다.
핵심 포인트
- 단일 에이전트보다 중앙 플랫폼 구축에 집중하는 추세입니다.
- 운영에는 PoC를 넘어선 견고한 인프라 계층이 필요합니다.
- monday.com은 하위 에이전트와 샌드박스를 통해 시스템을 재구축했습니다.
- 규제 문서 및 백오피스 업무 자동화에서 높은 ROI를 찾고 있습니다.
해당 지역의 에이전트 프로그램들은 많은 주목을 받는 소비자 대상 애플리케이션과는 다른 경로를 걷고 있습니다. 소수의 팀들이 단일하고 화려한 챗봇으로 시작하기보다는, 이미 여러 사업 부서에 걸쳐 수십 개의 에이전트 PoC(Proof of Concept)가 산재해 있어 이를 프로덕션 환경으로 일관되게 가져올 방법이 없어 플랫폼부터 시작하는 경우가 더 많습니다.
이는 규제 압력 수준이 매우 다른 산업 전반에서 나타나는 패턴입니다. 에너지, 통신, 보험, 은행, 소매업에 이르기까지 근본적인 과제는 동일합니다. 기업들은 에이전트를 프로토타입으로 만들기는 쉽지만, 운영하는 것은 훨씬 어렵다는 것을 발견하고 있습니다. 잘 운영되려면 많은 팀들이 첫 번째 에이전트를 구축할 때 예상하지 못했던 인프라 계층(infrastructure layer)이 필요합니다.
본 글에서는 세 개의 기업이 어떻게 이러한 인프라 계층을 구축했는지 살펴봅니다:
Schneider Electric은 관측 가능성(observability), 평가(evaluation), 배포(deployment)를 중심으로 LLMOps 규율을 갖춘 350명의 내부 AI 허브를 운영하며, 핵심 인프라 전반에 걸쳐 60개 이상의 에이전트를 지원합니다. monday.com은 단일 범용 에이전트였던 AI 어시스턴트 Sidekick을 계층화된 하위 에이전트(subagents), 경계가 설정된 도구(bounded tools), 그리고 샌드박스로 재구축했습니다. 이는 프로덕션 환경에서 더 많은 도구를 추가하는 것이 에이전트를 개선하기보다 오히려 악화시킨다는 것을 발견했기 때문입니다. Vodafone은 LangGraph를 기반으로 두 개의 프로덕션 어시스턴트인 Insight Engine과 Enigma를 구축했으며, LangSmith를 사용하여 이를 모니터링하고 개선합니다.
이 세 기업 외에도, 보험 및 보안 운영부터 소비자 소매업에 이르기까지 광범위한 산업을 아우르는 지역의 다양한 에이전트 프로그램에서 나타나는 패턴들을 다룰 것입니다.
에이전트 프로그램에서 나타나는 새로운 패턴들
중앙 에이전트 플랫폼(Central agent platforms)은 기업 전반에 걸쳐 파편화된 에이전트들을 통합하고 있습니다. 현재 이 지역에서 가장 흔한 패턴은 팀들이 단일 에이전트를 구축하기보다는 플랫폼에 투자하는 것입니다. 저희가 만난 조직 중 35%는 회사 전체의 에이전트 플랫폼 또는 제어 평면(control plane)을 주요 사용 사례로 설명하며, 비즈니스 단위 에이전트들은 결국 그 위에 구동됩니다.
12개 이상의 에이전트 개발 노력을 진행하는 기업들은 비슷한 결론에 도달하는 경향이 있습니다. 즉, 개별 팀들이 동일한 기반 시설을 재구축하고 있으며, 누군가 공유 계층(shared layer)을 소유해야 한다는 것입니다. 이는 팀들이 기본 원칙을 다시 발명하는 것을 막아주는 검증되고 재사용 가능한 템플릿이나 프레임워크를 의미할 수도 있고, 전체 라이프사이클을 지원하는 중앙 AI 허브로 분산된 개발을 통합하는 것을 의미할 수도 있습니다. 이 단계에서는 회사가 수백 개의 개념 증명(proofs of concept)을 가지고 있지만, 대부분의 POC에 대해 명확한 생산 경로가 없는 것이 드문 일이 아닙니다. 중앙 에이전트 플랫폼은 이 문제를 해결할 수 있습니다.
많은 조직들이 규제 문서 및 백오피스 업무를 위한 에이전트를 구축함으로써 투자 대비 효과(ROI)를 찾고 있습니다. 저희가 만난 조직 중 18%는 기존의 종이 기록과 알려진 건당 비용을 모두 가진 클레임, 인수 심사(underwriting), 송장, 입찰, 조달, 급여 또는 기타 워크플로우에 초점을 맞추고 있습니다. 정책 문구 검토, 클레임 문서 분류, 손실률 추출(loss-run extraction) 및 송장 검증을 위한 에이전트들이 모두 실제 운영 단계에 들어갔습니다. 많은 경우, 한때 몇 시간이 걸리던 작업이 이제는 몇 분 만에 완료될 수 있습니다.
지역적으로 위험(Risk), 규정 준수(compliance), 보안 운영 사용 사례가 증가하고 있습니다. 저희가 만난 조직 중 12%는 감사 의무를 지닌 기능에서 분석가 업무량을 줄이기 위해 에이전트를 구축하고 있습니다. 예시로는 낮은 심각도 및 중간 심각도의 보안 경고 분류(triaging), 2차 보증 및 반금융 범죄 테스트 실행, 그리고 첨부된 신뢰 점수와 함께 플래그 지정된 거래 검증 자동화 등이 있습니다.
연합 구축(Federated building)은 엔지니어링이 병목 현상이 되기 시작할 때 시작됩니다. 조직의 16%가 비엔지니어를 대상으로 중앙 가드레일(central guardrails)을 통해 에이전트를 구축하도록 돕는 방법을 시도하고 있습니다. 일반적인 패턴은 로우코드(low-code) 및 비기술 사용자에게 에이전트 구성을 가능하게 하는 동시에, 엔지니어들은 작동하는 에이전트를 산업화합니다. 이를 달성하기 위해 팀들은 글로벌 플랫폼을 구축하고 있으며 (예: 기업용 헤드리스로 제공되는 LangSmith Fleet과 같은 제품 활용), 이 플랫폼에서는 중앙팀이 프로덕션에 필요한 표준을 강제하는 동안 팀들이 코드를 작성하지 않고도 에이전트를 구성, 평가 및 게시할 수 있습니다.
관측 가능성(Observability), 평가(evals), 그리고 비용 통제가 규모 확장의 기반입니다. 이것은 저희의 대화 전반에 걸쳐 가장 흔한 주제입니다. 관측 가능성은 디버깅과 함께 거버넌스(governance) 및 지출(spend)과 점점 더 연결되고 있습니다. 팀들은 수십 개의 사용 사례에서 트레이싱(tracing), 평가, 프롬프트 관리, 그리고 주석 큐를 한 번에 원합니다. 게다가, 에이전트가 더 광범위한 자율성을 갖기 전에 사용자, 모델, 토큰, 지출 및 정책 전반에 걸쳐 통합된 가시성을 만들기 위해 팀들은 LLM 게이트웨이를 로드맵의 중심에 배치하고 있습니다.
아래 세 개의 팀은 회사가 첫 번째 파일럿 단계를 넘어 에이전트를 운영하는 데 필요한 것을 보여줍니다.
프로덕션에서 에이전트를 구축하는 선도적인 세 팀
Schneider Electric: 60개 이상의 에이전트에 걸친 공유된 LLMOps 분야**
Schneider Electric은 글로벌 에너지 기술 리더로서, 산업, 비즈니스 및 가정을 전기화하고 자동화하며 디지털화하여 지속 가능성을 주도하고 있습니다. 16만 명의 직원과 약 400억 유로의 연간 매출을 가진 이 회사는 야심 찬 AI 프로그램(350명의 전문가로 구성된 내부 AI 허브)을 운영하고 있으며, 이들은 에너지 소비 최적화, 자산 수명 주기 연장 및 개발자 생산성 가속화를 위해 60개 이상의 에이전트를 배포했습니다.
Schneider의 광범위한 AI 프로그램은 세 가지 범주에 걸쳐 있습니다:
제품에 임베딩 지능을 직접 적용하여 에너지 소비를 줄이고 (예: 실내 컨트롤러의 열 학습), AI를 활용하여 수요와 생산량을 예측함으로써 고객이 전력 사용 시간을 더 저렴하고 친환경적인 시간대로 조정할 수 있게 합니다. 또한, 복잡한 그리드 관리, 고객 성공(customer success) 지원 또는 탄소 배출량 소프트웨어 시스템 질의 등 운영상의 마찰을 줄이는 에이전트형 코파일럿을 배포합니다.**
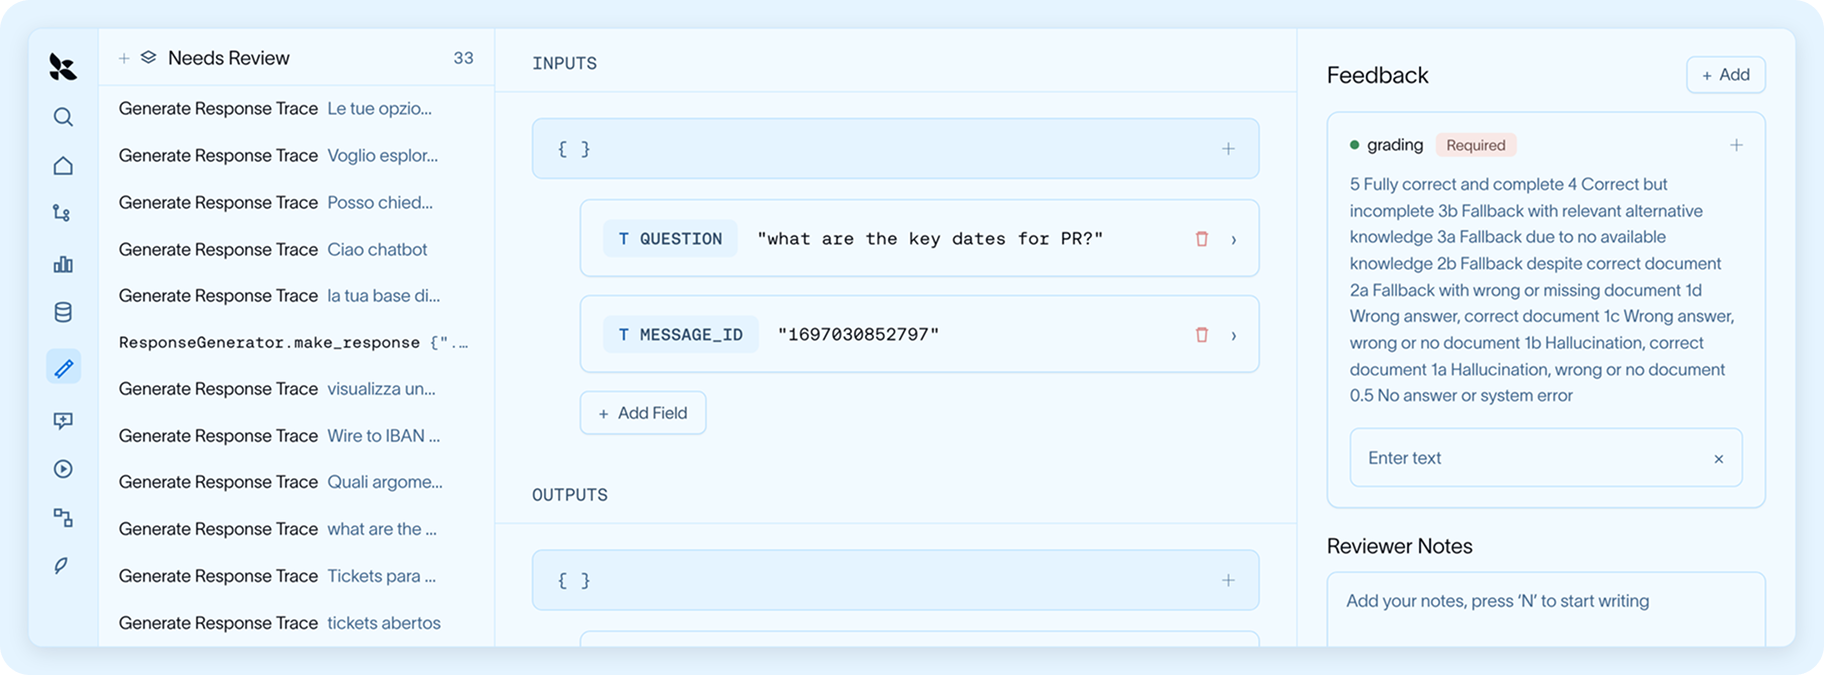
이렇게 구조화하면 개선 루프(improvement loop)를 촉진할 수 있습니다. 프로덕션 추적 기록은 오프라인 평가용 개발 데이터셋으로 다시 흐를 수 있으며, 주제 전문가(subject-matter experts, SMEs)는 프로덕션 추적 기록을 주석 처리하여 데이터셋에 직접 반영할 수 있습니다.
One Jo라는 Schneider의 내부 AI 비서가 107개국 16만 명의 직원을 지원합니다. 모든 대화는 추적되며, 프로덕션 추적 기록은 회귀(regression) 데이터셋을 구축하고 드리프트(drift)를 감지하기 위해 체계적으로 재사용됩니다.
평가 (Evaluation)
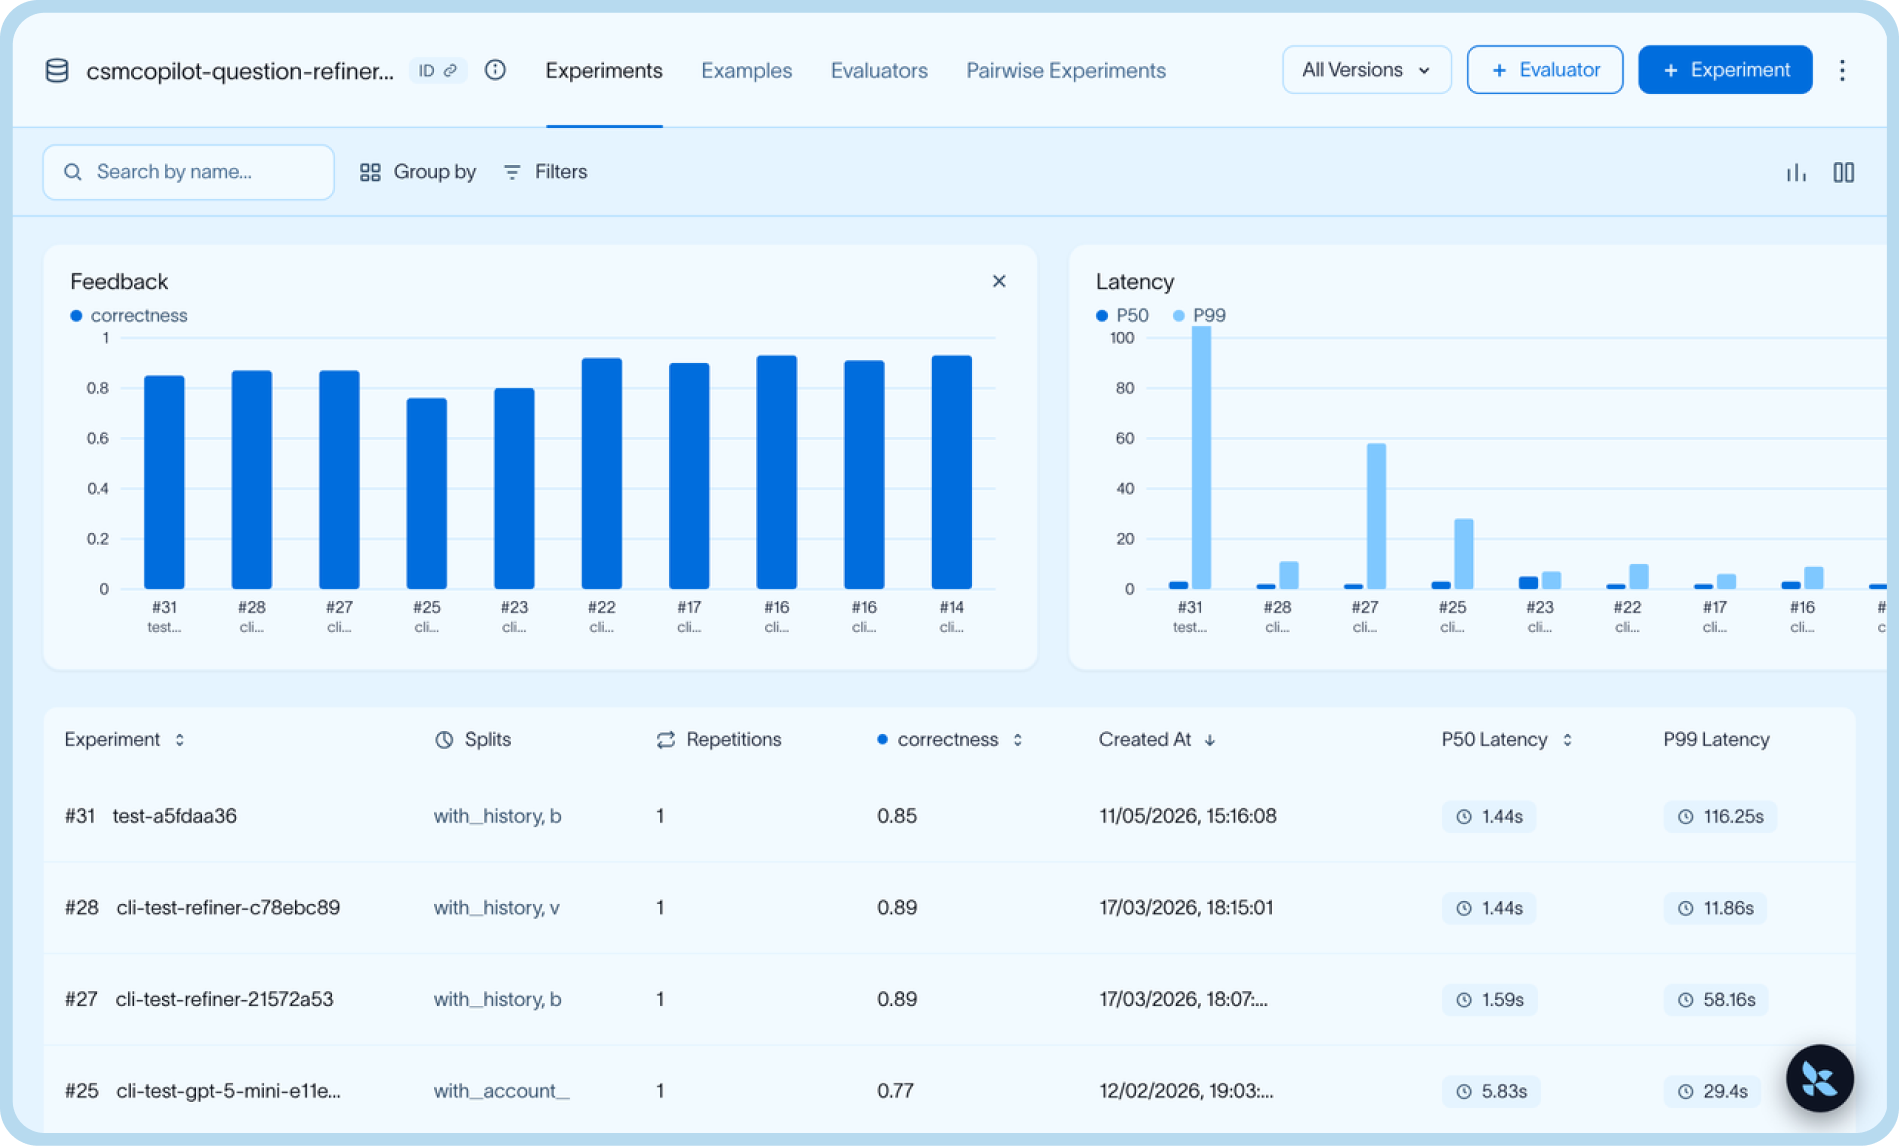
Schneider는 세 가지 영역에서 평가에 투자했습니다. 첫째, 스쿼드 전반에 걸쳐 데이터셋 컨벤션과 평가자 인터페이스를 표준화하는 오프라인 평가 템플릿을 구축했습니다.
둘째, 계측(instrumentation), 오프라인 평가(offline evals), 온라인 평가(online evals), 그리고 피드백 루프를 기준으로 자사의 60개 이상의 제품을 점수화하는 LLMOps 성숙도 프레임워크를 만들었습니다. 이 점수를 활용하여 탐색 단계에서 산업화 단계로의 진행을 통제합니다.
셋째, Schneider는 주제 전문가들을 평가 과정에 직접 참여시켰습니다. 자사의 AI 제품 중 약 20%가 이제 적어도 하나의 활성 주석 대기열(annotation queue)을 가지고 있으며, 이곳에서 SMEs들이 실제 프로덕션 사례를 검토합니다. 250명 이상의 CSM이 사용하는 고객 성공 관리자 코파일럿(Customer Success Manager Copilot)은 처음부터 SMEs의 참여로 구축되었으며, 팀은 이를 통해 높은 품질과 출시 시 채택률에 도달하는 데 도움이 되었다고 평가합니다.
배포 (Deployment)
모든 에이전트를 하나의 중앙 집중식 런타임(runtime)에서 실행하기보다는, Schneider는
디지털 에너지(Digital Energy) 부문에서, 견적 요청 및 사양을 분석하는 문서 처리 에이전트가 이전에는 몇 시간 또는 며칠이 걸리던 작업을 이제는 15분 남짓 만에 완료합니다. 이러한 장시간 백그라운드 워크로드(long-running background workload)는 작업 큐 기반 배포 모델(task-queue-based deployment model)의 이점을 누립니다.
다만, 관리해야 할 인프라가 늘어나고 조정해야 할 업그레이드가 많아진다는 트레이드오프(tradeoff)가 있으며, 슈나이더는 이를 지속적인 투자 영역으로 파악했습니다.
핵심 교훈 (Key Lessons)
슈나이더의 LLMOps 초기 투자는 결실을 맺었습니다. 추적 수준의 관찰 가능성(trace-level observability)과 견고한 오프라인 평가 프로세스(offline evaluation process)가 없었다면, 회사의 어떤 에이전트 제품도 프로덕션 준비 상태에 도달할 수 없었을 것입니다. 초기 계측(instrumentation) 단계를 건너뛴 팀들은 좋은 데이터 없이 비결정론적 회귀(non-deterministic regressions)를 디버깅하는 데 어려움을 겪었습니다.
슈나이더는 또한 맞춤형 기능을 구축하기 전에 기본 제공되는 기능에 의존하는 법을 배웠습니다. 특히 평가를 위한 정교한 내부 프레임워크를 구축하는 것은 매력적이었지만, 돌이켜보면 새로운 것을 만드는 것보다 기존 도구를 확장하는 것이 더 효과적이었습니다. 예를 들어, LangSmith SDK 위에 얹는 얇은 CLI(Command Line Interface), 기존 권한 모델에 매핑되는 사용자 지정 역할(custom role), 그리고 공개 API를 기반으로 구축된 예약 보고서 등이 그러합니다.
마지막으로, 슈나이더는 LangChain 생태계가 통합성과 유연성 사이에서 좋은 균형을 이루고 있음을 발견했습니다. 도구들이 잘 작동하지만 (오픈 소스 라이브러리, 관찰 가능성 및 평가를 위한 LangSmith, 그리고 LangSmith Studio와 함께하는 LangSmith Deployment), 서로에 묶여있지는 않습니다. OSS 라이브러리는 단독으로 사용될 수 있으며, LangSmith는 서드파티 프레임워크와도 깔끔하게 작동합니다. 이는 슈나이더가 스스로를 궁지에 몰아넣지 않으면서 도구들을 조합하고 매칭할 여지를 주었습니다.
자세히 알아보기: Schneider User Story (Blog)
Vodafone: 작동하는 파이프라인에서 모니터링되는 프로덕션 시스템으로
Vodafone: 작동하는 파이프라인에서 모니터링되는 프로덕션 시스템으로
Vodafone은 모바일, 유선, IoT 및 엔터프라이즈 서비스를 통해 3억 4천만 명 이상의 고객에게 서비스를 제공하며 유럽 전역에 데이터 센터 네트워크를 운영하고 있습니다. Vodafone의 데이터 및 AI 팀은 이 인프라 전반에서 근무하는 엔지니어를 지원하기 위해 LangChain과 LangGraph를 사용하여 두 개의 내부 어시스턴트를 구축했습니다. 이 어시스턴트들은 Vodafone의 엔지니어링 팀이 인프라를 더욱 효율적으로 운영하도록 돕습니다.
**성능 지표 모니터링 (Insight Engine): **이 어시스턴트는 자연어 질의(natural language queries)를 SQL로 변환하여 데이터 센터 모니터링 시스템에서 핵심 데이터를 검색함으로써 성능 지표를 분석합니다. 이를 통해 엔지니어와 운영 직원은 이전에 맞춤형 대시보드를 통해서만 접근 가능했던 동적이고 데이터 기반의 통찰력을 얻을 수 있습니다.
질의가 재고(inventory) 데이터와 관련된 경우, 에이전트는 요청을 NL2SQL 체인으로 안내합니다. 이 체인은 자연어 질의를 SQL 질의로 변환하여 응답을 에이전트에게 다시 보냅니다. 이후 에이전트는 그 요청을 또 다른 질의 처리 체인(query processing chain)으로 전달하고, 해당 체인이 재고 DB에 질의하여 결과를 받은 후, 이 정보를 LLM에 전달하여 질의 응답을 기반으로 그래프와 차트를 생성합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기