
LangChain의 Paid Media Agent 구축 과정
요약
본 글은 LangChain을 활용하여 유료 미디어(Paid Media) 캠페인 성과를 분석하고 최적화하는 'Paid Media Agent' 구축 과정을 다룹니다. 이 에이전트는 다양한 광고 채널의 복잡한 데이터를 통합 관리하며, 지속적인 학습 루프를 통해 마케팅 팀의 생산성을 높이고 캠페인 성과 개선을 목표로 합니다.
핵심 포인트
- 에이전트에게 명확한 작업 공간(샌드박스, 지침) 제공이 중요합니다.
- 계산 및 규칙은 코드로 처리하고, 모델은 해석/추천에 집중해야 신뢰성이 높아집니다.
- 에이전트는 전체 워크플로우를 중심으로 설계되어야 합니다 (분석-실행).
- Paid Media Agent는 성과 분석, 캠페인 초안 작성, 변형 테스트 등을 자동화합니다.
핵심 요약
에이전트를 지식 노동자처럼 다루세요. 가장 강력한 결과는 에이전트에게 샌드박스, 소프트웨어, 비즈니스 컨텍스트 및 명확한 운영 지침을 갖춘 잘 설계된 작업 공간을 제공했을 때 나왔습니다. 시스템 프롬프트는 에이전트가 모든 것을 컨텍스트에 담지 않고도 필요한 것을 찾도록 돕는 지도 역할을 했습니다.
판단에는 모델을, 일관성에는 코드를 사용하세요. 계산, 진실의 원천(source-of-truth) 규칙, 안전 장치는 코드에서 처리하는 것이 더 좋았습니다. 이는 에이전트를 더 빠르고 저렴하며 신뢰할 수 있게 만들었고, 모델은 결과 해석 및 다음 조치 추천에 집중할 수 있도록 했습니다.
전체 워크플로우를 중심으로 에이전트를 설계하세요. 에이전트는 올바한 도구를 찾고, 명확한 권한 내에서 작업하며, 분석부터 실행까지 이동해야 했습니다. 이는 캠페인 변경을 제안하고, 이를 인간의 승인을 거쳐 라우팅하며, 변경 사항이 올바르게 적용되었는지 확인하는 것을 의미했습니다.
추상화를 사용하여 에이전트의 업무에 집중하세요. Managed Deep Agents는 호스팅, 샌드박스, Slack 통합 및 일정을 관리하므로, 사용자는 에이전트를 유용하게 만드는 도구, 컨텍스트, 결정 규칙에만 집중할 수 있습니다.
LangChain의 처음 3년 동안 우리의 영업 파이프라인은 오픈 소스, 콘텐츠, YouTube, 커뮤니티, 미팅을 통해 성장하는 것이 주를 이루었습니다. 그래서 지난 1월에는 새로운 지역이나 기업 의사결정권자 등 유기적으로 도달하지 못했던 잠재 고객과 연결하기 위해 유료 광고 프로그램을 시작하고자 했습니다.
우리는 주로 유기적인 성장 엔진에서 단 6개월 만에 5개의 유료 채널로 확장하고 싶었습니다. 이는 우리 마케팅 팀에게 새로운 과제를 안겨주었습니다. 우리는 여러 채널에 걸쳐 출시되는 새로운 캠페인, 다양한 크리에이티브 및 타겟팅 실험, 그리고 이해하고 조치하기 위한 증가하는 양의 성과 데이터를 추적해야 했습니다.
확장하고 최적화하기 위해서는 극복해야 할 기술적인 장애물들이 있었습니다. 각 광고 플랫폼은 자체 데이터 스키마를 가지고 있어 채널 전반의 성과를 일치시키기가 어려웠습니다. 또한, 캠페인 매개변수들은 궁극적으로 우리가 중요하게 생각하는 판매 문의(sales inquiries), 가입(signups), 또는 콘텐츠 다운로드와 같은 결과물에 깔끔하게 대응되지 않았습니다. 회사로서 제품 출시 주기가 빨라지고 캠페인의 수가 늘어나면서, 무엇이 실행 중인지, 무엇이 효과적인지, 그리고 다음에 무엇을 시도해야 하는지를 수동으로 추적하는 것이 점점 더 관리하기 어려워졌습니다.
저희는 이러한 복잡성을 관리하는 데 도움을 줄 에이전트를 구축하기로 했습니다. 이 에이전트는 새로운 제품 발표를 추적하고, 캠페인을 초안 작성하며, 키워드를 추가하고, 변형(variations)을 테스트하며, 제안된 실험들을 팀에 승인을 위해 제시할 것입니다. 시간이 지남에 따라, 이는 지속적인 학습 루프(continuous learning loop)로 작동할 것입니다: 성과를 분석하고, 변경 사항을 만들고, 결과를 관찰하고, 배운 것을 포착하며, 그 통찰력을 미래 캠페인에 적용합니다. 우리의 목표는 마케팅 팀의 생산성을 높이는 동시에 캠페인 성과를 지속적으로 개선하는 것이었습니다.
본 게시물에서는 저희의 Paid Media Agent가 어떻게 작동하는지, 이것이 마케팅 팀을 어떻게 지원하는지, 그리고 이를 구축하면서 에이전트 엔지니어링(agent engineering)에 대해 무엇을 배웠는지 알아볼 것입니다.
저희는 Paid Media Agent를 오픈 소스화했으므로, 여러분도 시작점으로 사용할 수 있습니다. 또한 9월 23일 태평양 시간 오전 11시에 열리는 GTM Engineering Live: How We Built Our Paid Media Agent에 참여할 수도 있습니다. 이 웨비나에서는 에이전트를 시연하고, 코드와 설계 결정을 설명하며, 이러한 패턴을 여러분 자신의 에이전트에 적용하는 방법에 대한 질문에 답변해 드릴 것입니다.
주요 결과
주요 결과
- Paid media는 6개월 만에 마케팅 파이프라인의 0%에서 20%를 차지하는 수준으로 성장했습니다.
- 적격 리드당 비용(CPL)은 6월 대비 8월에 30% 감소했으며, 월별 지출액은 약 60% 증가했습니다. 가장 큰 소셜 채널인 LinkedIn의 경우, CPL이 1월보다 40% 낮았습니다.
- 분석 및 보고 기능을 외부 에이전시에 의존하는 대신 내부화함으로써 매달 약 $5K를 절약했습니다.
- 또한 계산을 코드에 통합하고 불필요한 모델 호출을 제거하여 에이전트 자체도 최적화했으며, 초기 보고 워크플로우의 비용은 40배 저렴해지고 속도는 13배 빨라져 실행 시간이 18분에서 85초로 단축되었습니다.
구축 내용 (What we built)
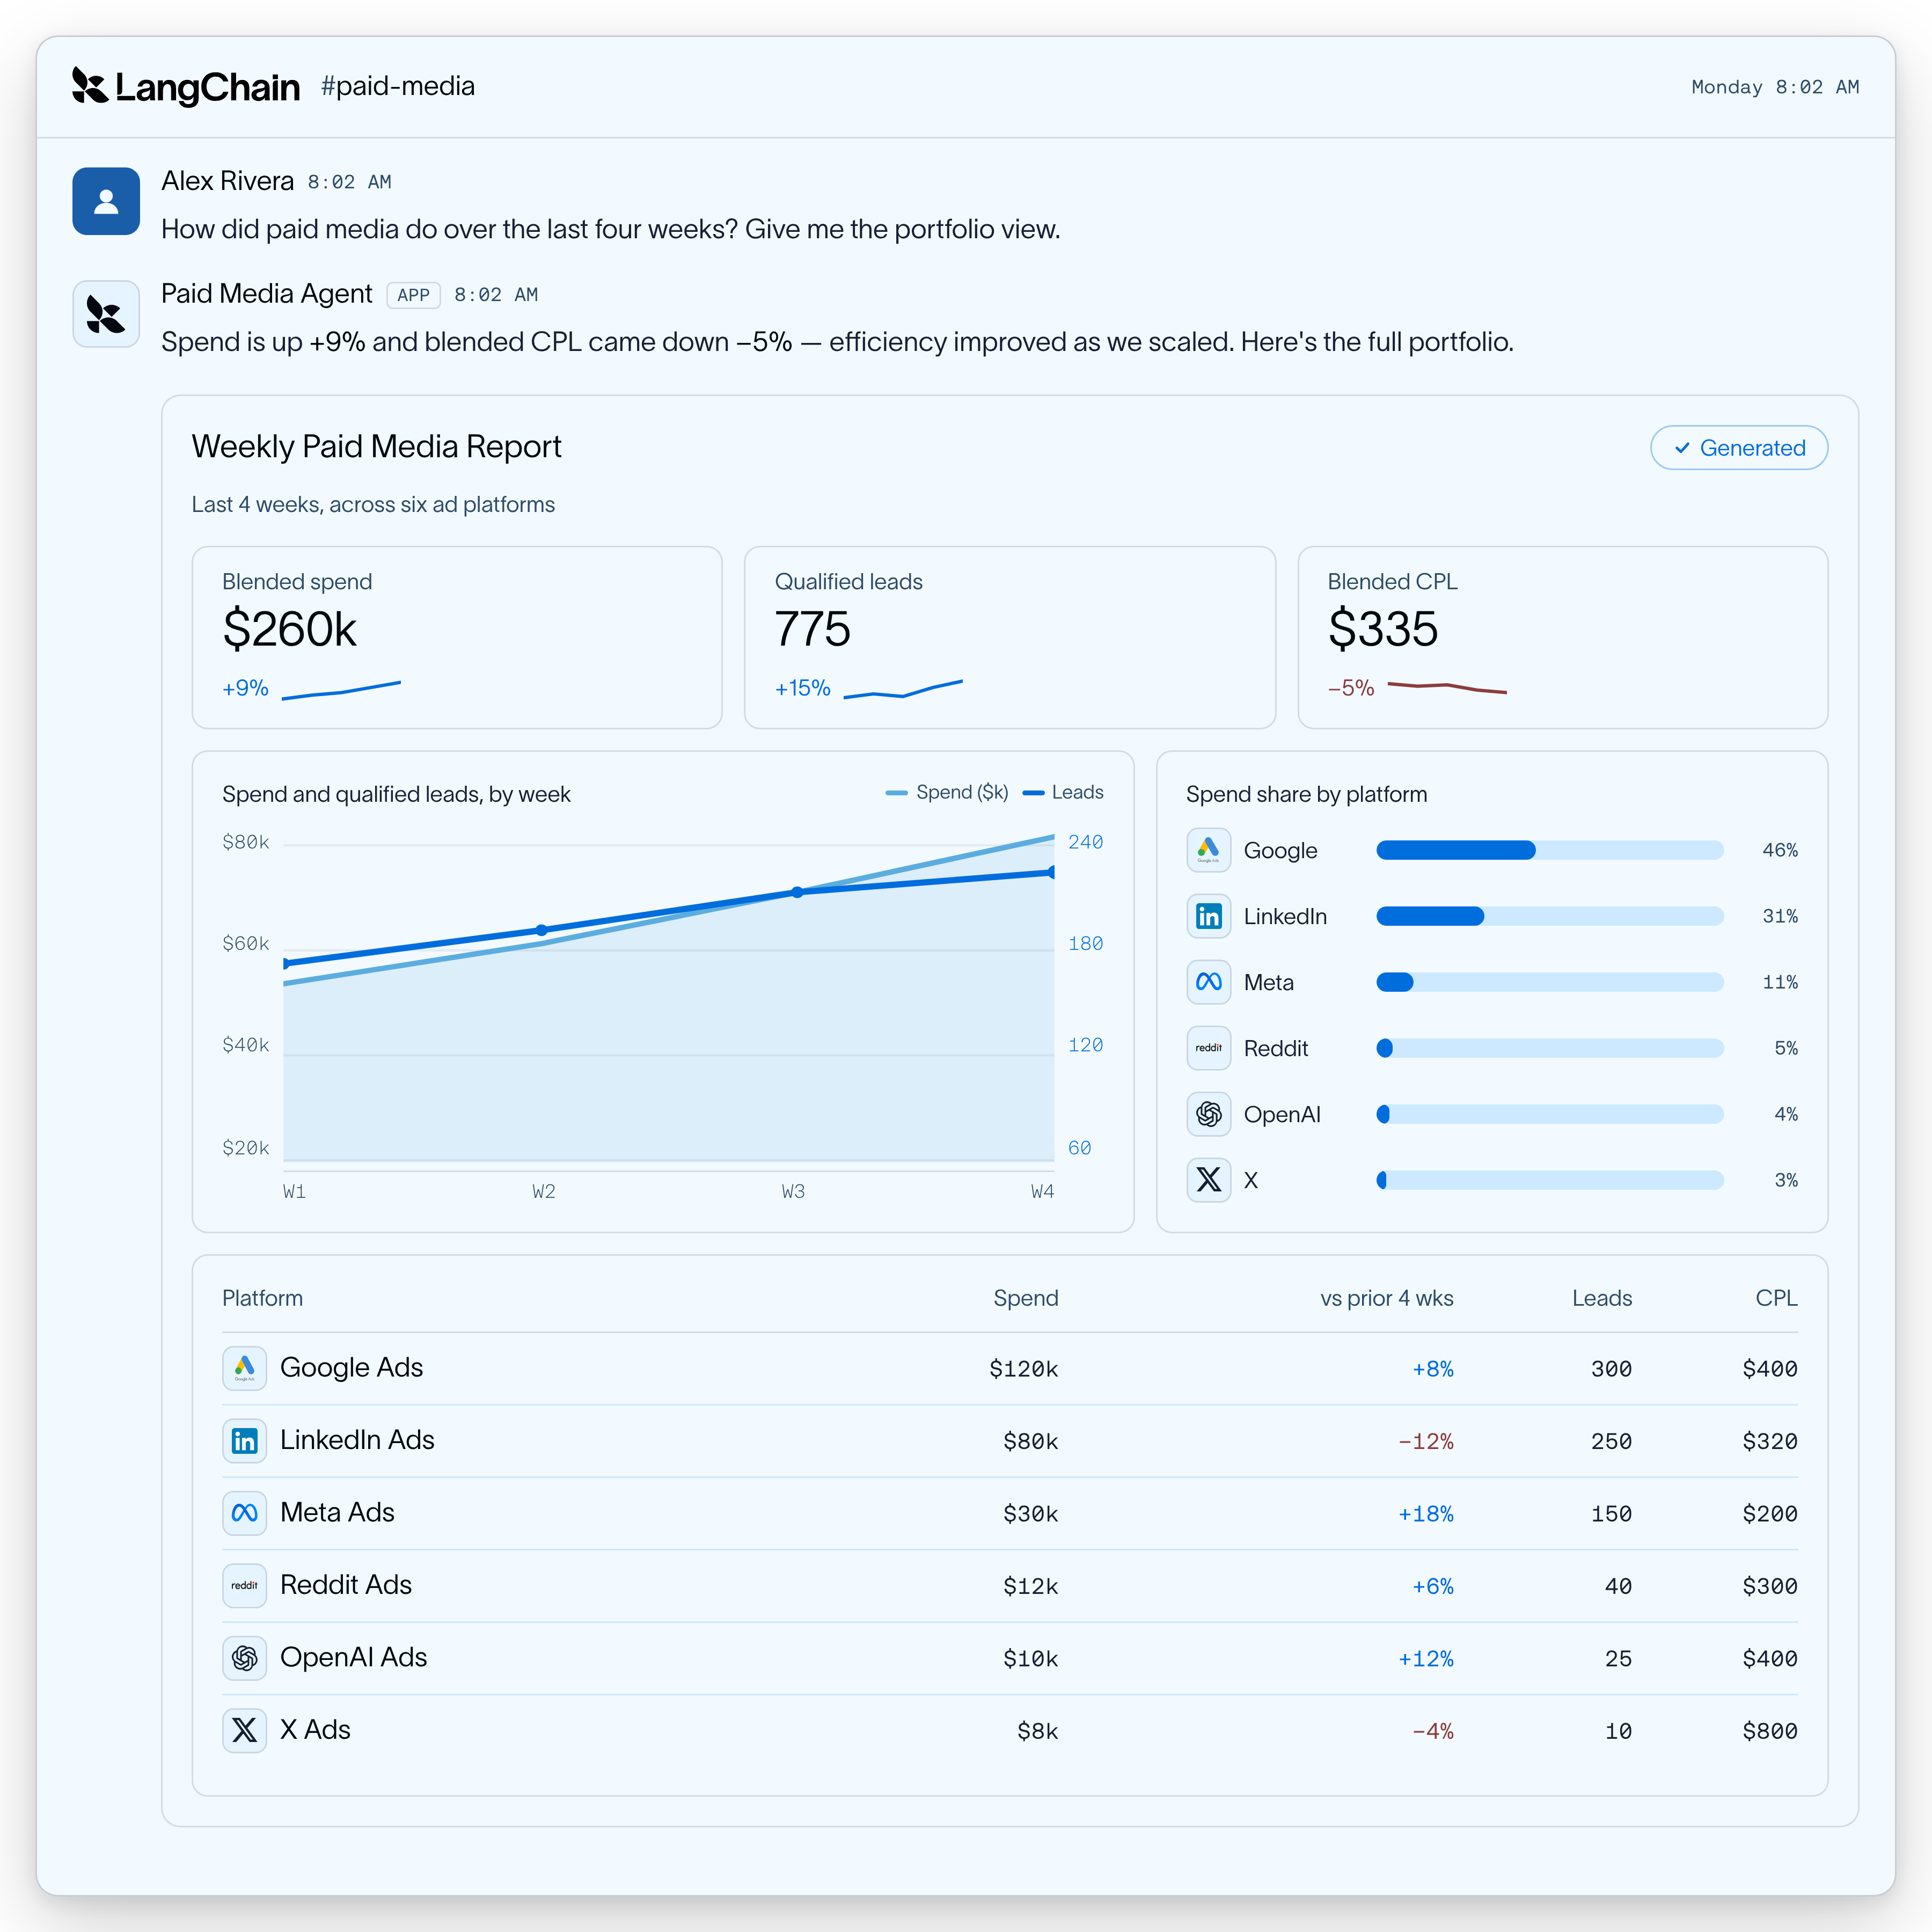
Paid Media Agent는 Slack에 상주하는 장기 실행 에이전트입니다. 매주 월요일마다 광고 플랫폼 데이터와 웨어하우스의 리드 및 파이프라인 데이터를 결합합니다. 그리고 각 플랫폼별로 무엇이 바뀌었는지, 왜 바뀌었는지, 팀이 다음에 무엇을 해야 하는지를 설명하는 요약본과 브랜드 PDF를 게시합니다.
팀은 이 에이전트를 스레드에서 태그하여 캠페인, 비용 또는 파이프라인에 대한 후속 질문을 할 수 있습니다. 또한 우리의 플레이북과 인코딩된 판단(encoded judgement)을 기반으로 새로운 키워드, 타겟팅 변경 사항, 광고 문구 또는 새로운 검색 캠페인을 제안할 수도 있습니다.
구축 방법 (How we built it)
우리는 간단한 원칙을 중심으로 이 에이전트를 구축했습니다. 코딩 에이전트는 지식 노동자(knowledge worker)입니다.
지식 노동은 종종 파일을 읽고, 정보를 변환하고, 분석을 실행하며, 기록하는 것을 포함합니다. 코딩 에이전트 역시 파일과 셸(shell)을 사용하여 이러한 작업을 수행합니다.
우리는 이 에이전트를 새로운 유료 미디어 분석가처럼 취급했습니다. 컴퓨터와 업무에 필요한 소프트웨어, 데이터 접근 권한, 그리고 우리 비즈니스가 어떻게 돌아가는지에 대한 문서를 제공했습니다.
운영 체제 (The Operating System)
운영 체제 (The Operating System)
저희는 에이전트 하네스(agent harness)를 위해 LangChain Deep Agents를 사용했습니다. 덕분에 핵심 에이전트 인프라를 처음부터 구축할 필요가 없었습니다. 마치 운영 체제처럼, Deep Agents는 파일 접근, 코드 실행, 작업 메모리 관리를 담당합니다. 이는 모델에게 작업을 계획하고, 하위 에이전트(subagents)에 작업을 위임하며, 작업이 복잡해짐에 따라 컨텍스트를 관리할 수 있는 도구를 제공합니다. 이 기반 구조가 바로 에이전트 하네스입니다. 저희는 여기에 페이드 미디어 툴, 스킬, 그리고 비즈니스 지식을 계층적으로 쌓았습니다.
컴퓨터 (The Computer)
모든 실행에는 기본적으로 LangSmith Sandbox가 제공됩니다. 이는 디스크 용량 32GB와 명령을 실행할 수 있는 셸이 포함된 격리된 마이크로 VM(microVM)입니다. 이 샌드박스는 에이전트에게 다른 실행이나 기반 시스템에 영향을 주지 않으면서 코드를 실행하고 파일 작업을 할 수 있는 안전하고 격리된 환경을 제공합니다.
저희는 여기에 분석용 pandas와 DuckDB, 스프레드시트를 위한 openpyxl, 그리고 보고서 생성을 위한 WeasyPrint 및 Jinja2를 갖추었습니다. 이러한 소프트웨어 외에도, 여섯 가지 스킬에 걸쳐 마크다운으로 저장된 작업 데이터와 비즈니스 지식이 존재합니다.
시작 속도를 빠르게 유지하기 위해, 저희는 이 소프트웨어와 비즈니스 위키를 *스냅샷(snapshot)*이라는 저장된 이미지로 만듭니다. 이를 통해 평균 시작 시간을 10초 단축할 수 있었습니다.
💡저희 콘텐츠 생성 에이전트의 샌드박스는 헤드리스 브라우저, ffmpeg, 미디어 툴, 브랜드 북 등이 있는 비디오 편집 워크스테이션과 더 유사합니다. 금융 에이전트는 스프레드시트를 위한 openpyxl과 더 무거운 데이터 처리를 위한 DuckDB가 필요할 수 있습니다. 어떤 작업을 하느냐에 따라 컴퓨터를 설계하는 방식이 달라집니다. 각기 다른 에이전트들은 서로 다른 컴퓨터를 필요로 합니다.
적절한 컨텍스트 제공하기 (Providing the right context)
에이전트에게 컴퓨터가 갖춰진 후, 다음 과제는 적절한 컨텍스트를 제공하는 것이었습니다. 인간 분석가는 자신의 역할, 사용하는 방법론, 근무하는 회사, 현재 무슨 일이 일어나고 있는지, 그리고 따라야 할 규칙들을 이해해야 합니다.
순진한 접근 방식은 이 모든 것을 시스템 프롬프트(system prompt)에 넣는 것입니다. 하지만 그렇게 하면 너무 길어지고, 매 실행마다 유지하기 비용이 많이 들며, 오래되어 쓸모없게 될 가능성이 높습니다.
이 문제를 다르게 생각하는 방법은 컨텍스트 윈도우 자체가 병목(bottleneck)인 경우가 많으며, 모델 자체의 문제가 아니라는 것입니다. 많은 명백한 추론 실패는 실제로는 컨텍스트 실패입니다. 즉, 모델이 올바른 정보를 놓치고 있거나, 너무 많은 관련 없는 정보가 주의력(attention)을 놓고 경쟁하고 있는 경우입니다.
프롬프트(prompt)를 지식이 존재하는 장소로 취급하는 대신, 우리는 그것을 지도(map)로 간주합니다. 지식은 예측 가능한 위치를 가진 구조화된 파일에 존재하며, 에이전트는 현재 작업에 필요한 컨텍스트만을 로드합니다.
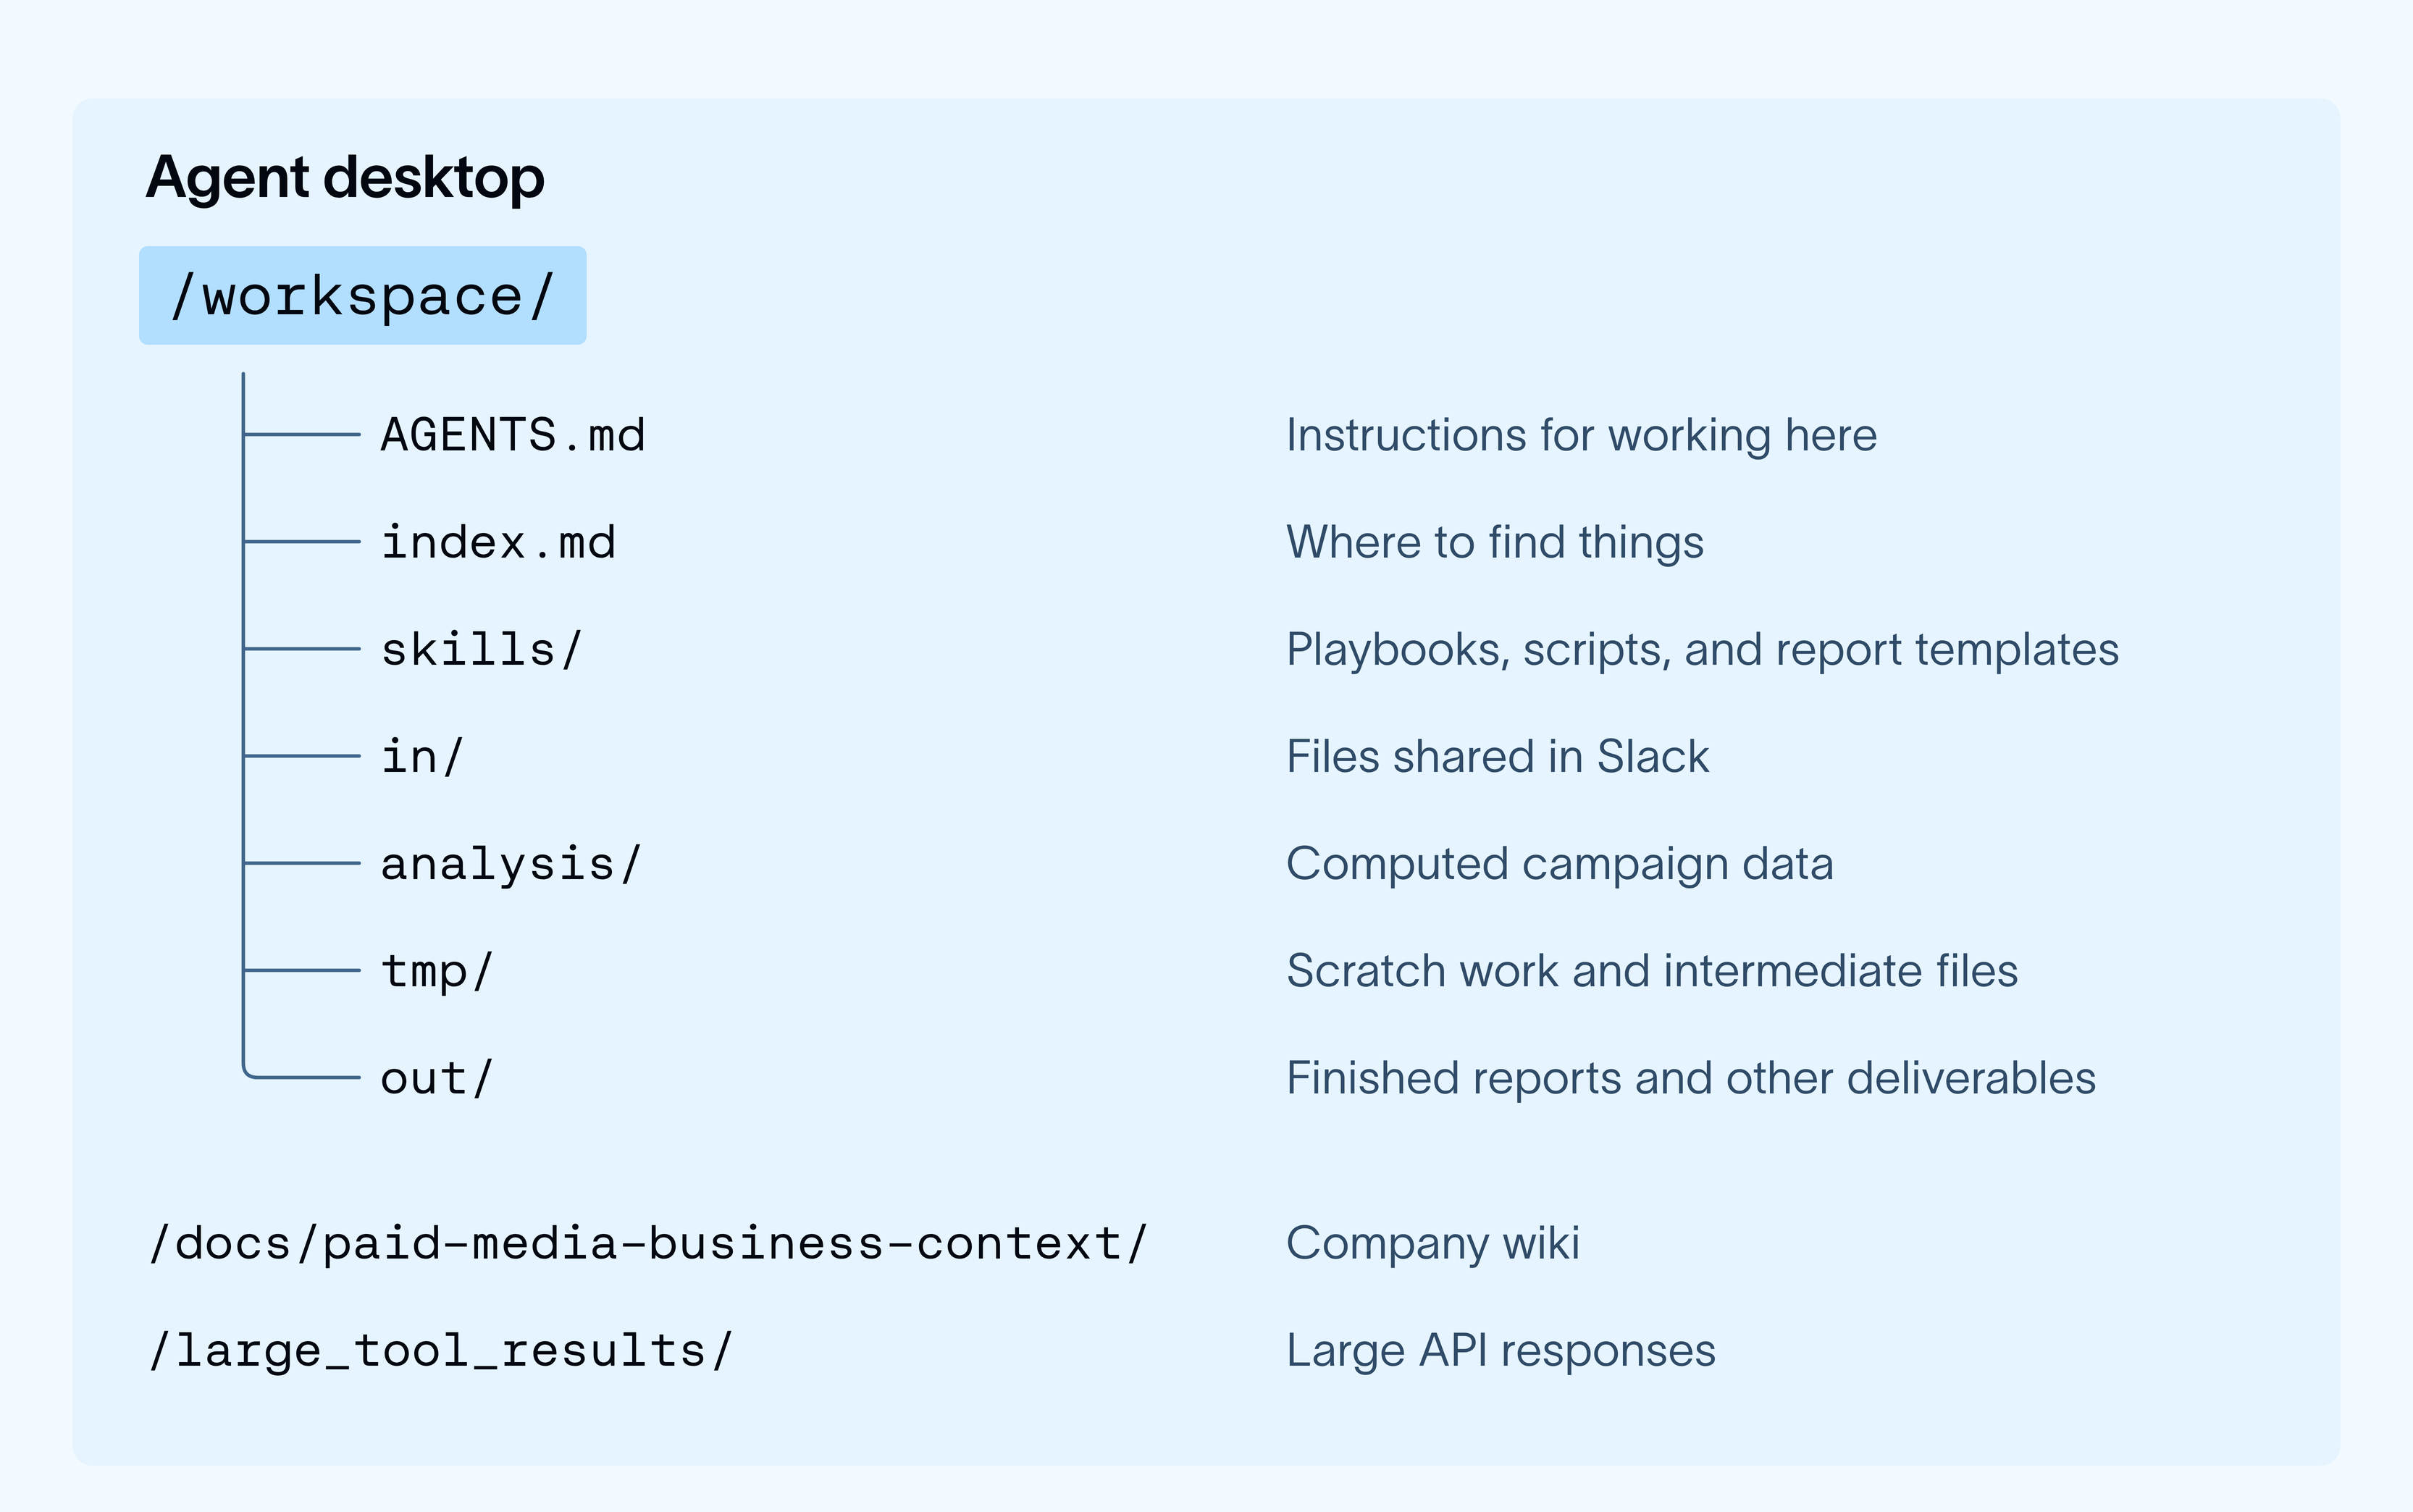
💡우리는 에이전트가 그 책상 위에 이미 있는 것들을 결합하여 우리가 명시적인 워크플로우(workflow)를 구축한 적 없는 질문에도 답변할 수 있다는 것을 발견했습니다. 이 에이전트는 조사를 안내하는 플레이북(playbook), 작업할 캠페인 데이터, 그리고 분석을 위한 라이브러리를 가지고 있었습니다. 이러한 작업 공간(workspace)을 설계하는 것이 곧 에이전트 자체를 설계하는 일부가 되었습니다. 에이전트의 작업 공간을 설계하는 방식은 그에게 제공하는 도구만큼 많은 고민을 할 가치가 있습니다.
우리는 컨텍스트를 다섯 가지 계층으로 나누었고, 아래에서 각각 설명합니다 (각 계층이 변화하는 속도 순서대로 배열했습니다):
시스템 프롬프트 (System prompt): 에이전트의 역할과 탐색 경로를 정의합니다. 저희는 에이전트의 역할을 한 문장으로 설명하는 것부터 시작하여, 작동 방법, 숫자의 출처, 결과 제시 방법이라는 세 개의 짧은 섹션으로 구성했습니다. 나머지 모든 것은 에이전트를 위한 포인터입니다. 예를 들어, 플레이북은 여기에 있고, 위키는 저기에 있으며, 먼저 인덱스를 읽으라는 식입니다. 이 프롬프트는 에이전트가 필요한 것을 어디서 찾을지 알려줍니다.스킬 (Skills): 런타임에 점진적으로 공개되는 여섯 개의 지침 폴더입니다. 에이전트는 처음에 각 스킬의 제목과 설명만 볼 수 있습니다.위키 (Wiki): 저희 퍼널이 어떻게 작동하는지, 각 캠페인이 무엇을 달성하도록 의도되었는지, 어떤 데이터 소스가 어떤 숫자를 소유하고 있는지, 그리고 팀이 어떤 결정을 내렸고 그 이유가 무엇인지 설명하는 19개의 페이지입니다.실시간 도구 (Live tools): 지출(Spend), 설정(settings), 파이프라인은 매일 변경되므로 에이전트가 요청 시점에 가져옵니다. 저희는 218개의 그러한 호출을 가지고 있습니다. 컨텍스트가 비대해지는 것을 어떻게 방지하는지에 대한 내용은 아래에서 더 설명하겠습니다.결정론적 코드 (Deterministic code): 계산, 날짜 범위(date windows), 계정 매칭, 그리고 강력한 안전장치(hard safeguards)를 포함하여 일관되고 재현 가능해야 하는 모든 것에 코드를 사용합니다. 예를 들어, 에이전트가 좋지 않은 주가 온 후 상위 파이프라인 드라이버를 잘라내는 것을 방지하는 규칙은 코드에 의해 강제되므로 모델이 이를 무시할 수 없습니다. 가장 어려운 경계는 스킬과 위키 사이입니다. 스킬은 작업을 수행하는 방법(데이터 읽기, 숫자 계산, 보고서 작성, 변경 사항 준비, 유료 미디어 성과 해석을 위한 플레이북 적용)을 설명합니다. 이는 저희 캠페인에 특정한 내용은 포함하지 않습니다. 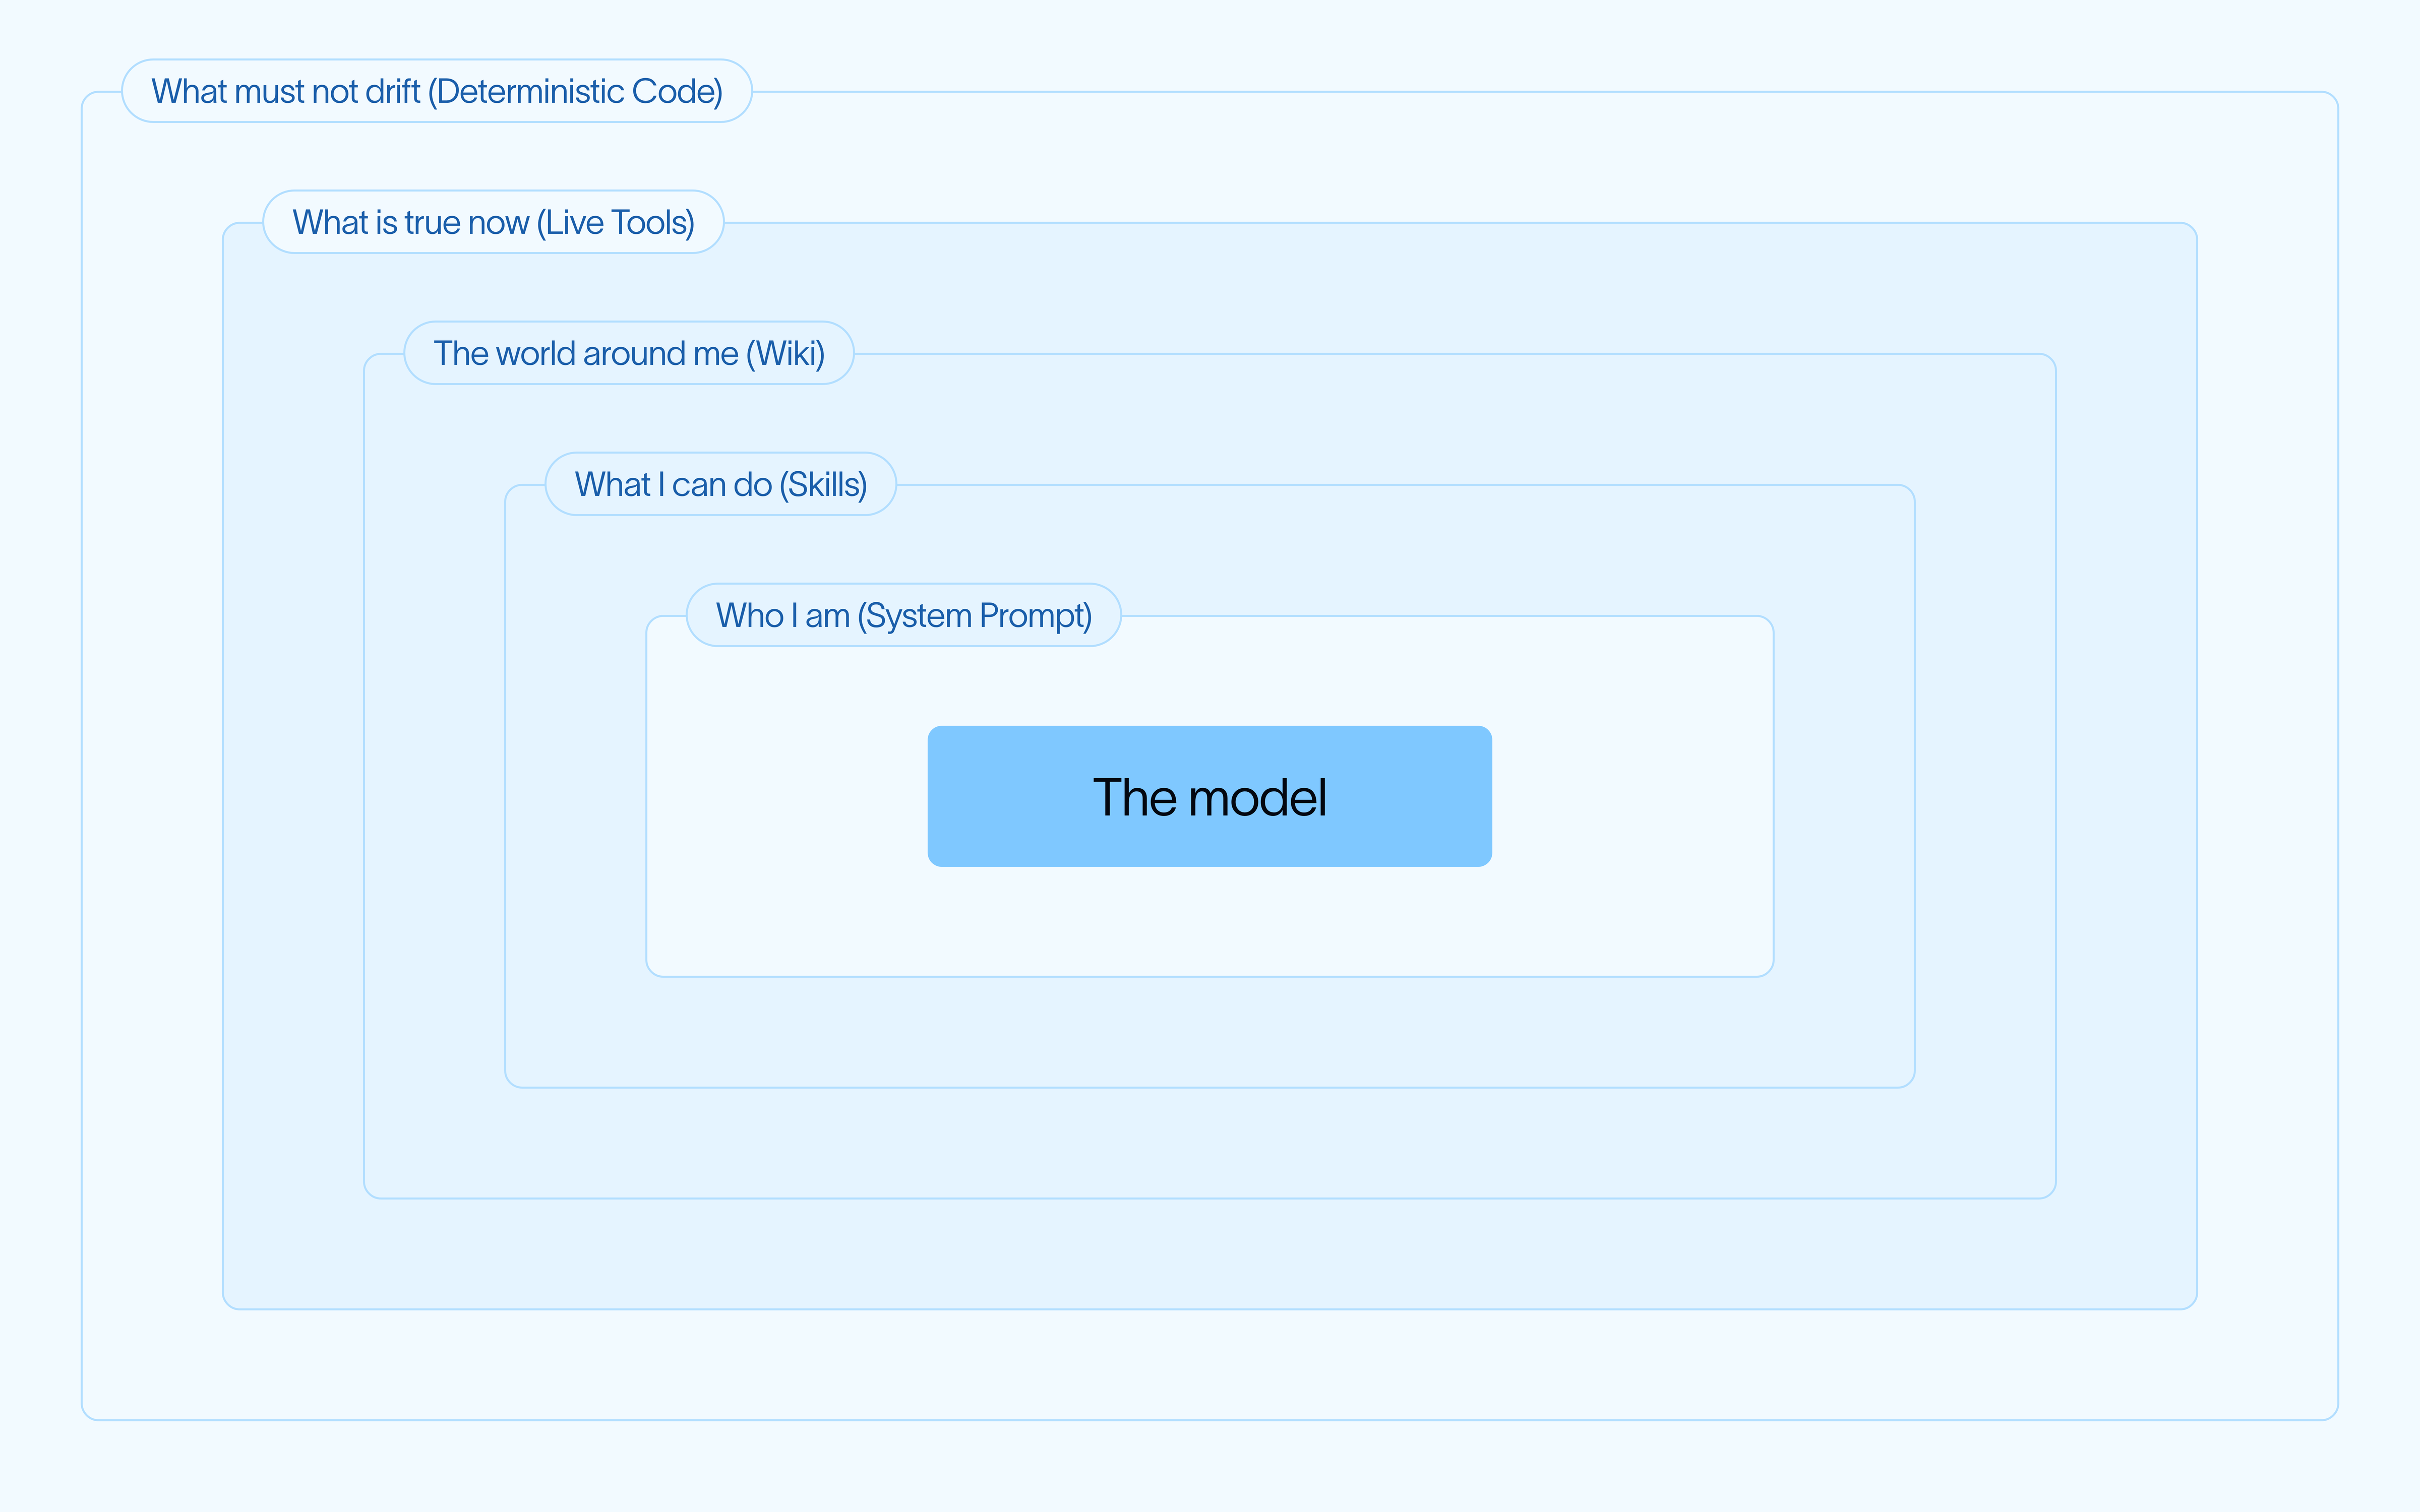
저희는 사용자 경험이 달랐기 때문에 원래 두 개의 에이전트 그래프를 구축했습니다:
- 주간 보고서 에이전트는 스케줄링 기반이었고 아티팩트를 많이 사용했습니다. Deep Agent, 샌드박스, 대규모 모델(large model), 그리고 PDF 생성을 사용했습니다.
- Slack은 답변을 몇 초 만에 받아야 했기 때문에, Google Ads 및 데이터 웨어하우스 도구를 사용하는 저사양 루프를 더 저렴한 모델로 구현했으며, 샌드박스는 없고 읽기 전용 접근만 가능했습니다.
이러한 분리는 단지 5주 동안 지속되었습니다. 새로운 기능이 추가될 때마다 두 번씩 구현해야 했습니다. Slack과 보고서에 도달하는 기능들이 서로 다른 시기에 이루어졌습니다. Slack은 샌드박스가 없어 첨부 파일을 처리할 수 없었고, 월요일 보고서에 대한 후속 질문에도 답변할 수 없었는데, 그 PDF는 또 다른 그래프에서 생성되었기 때문입니다.
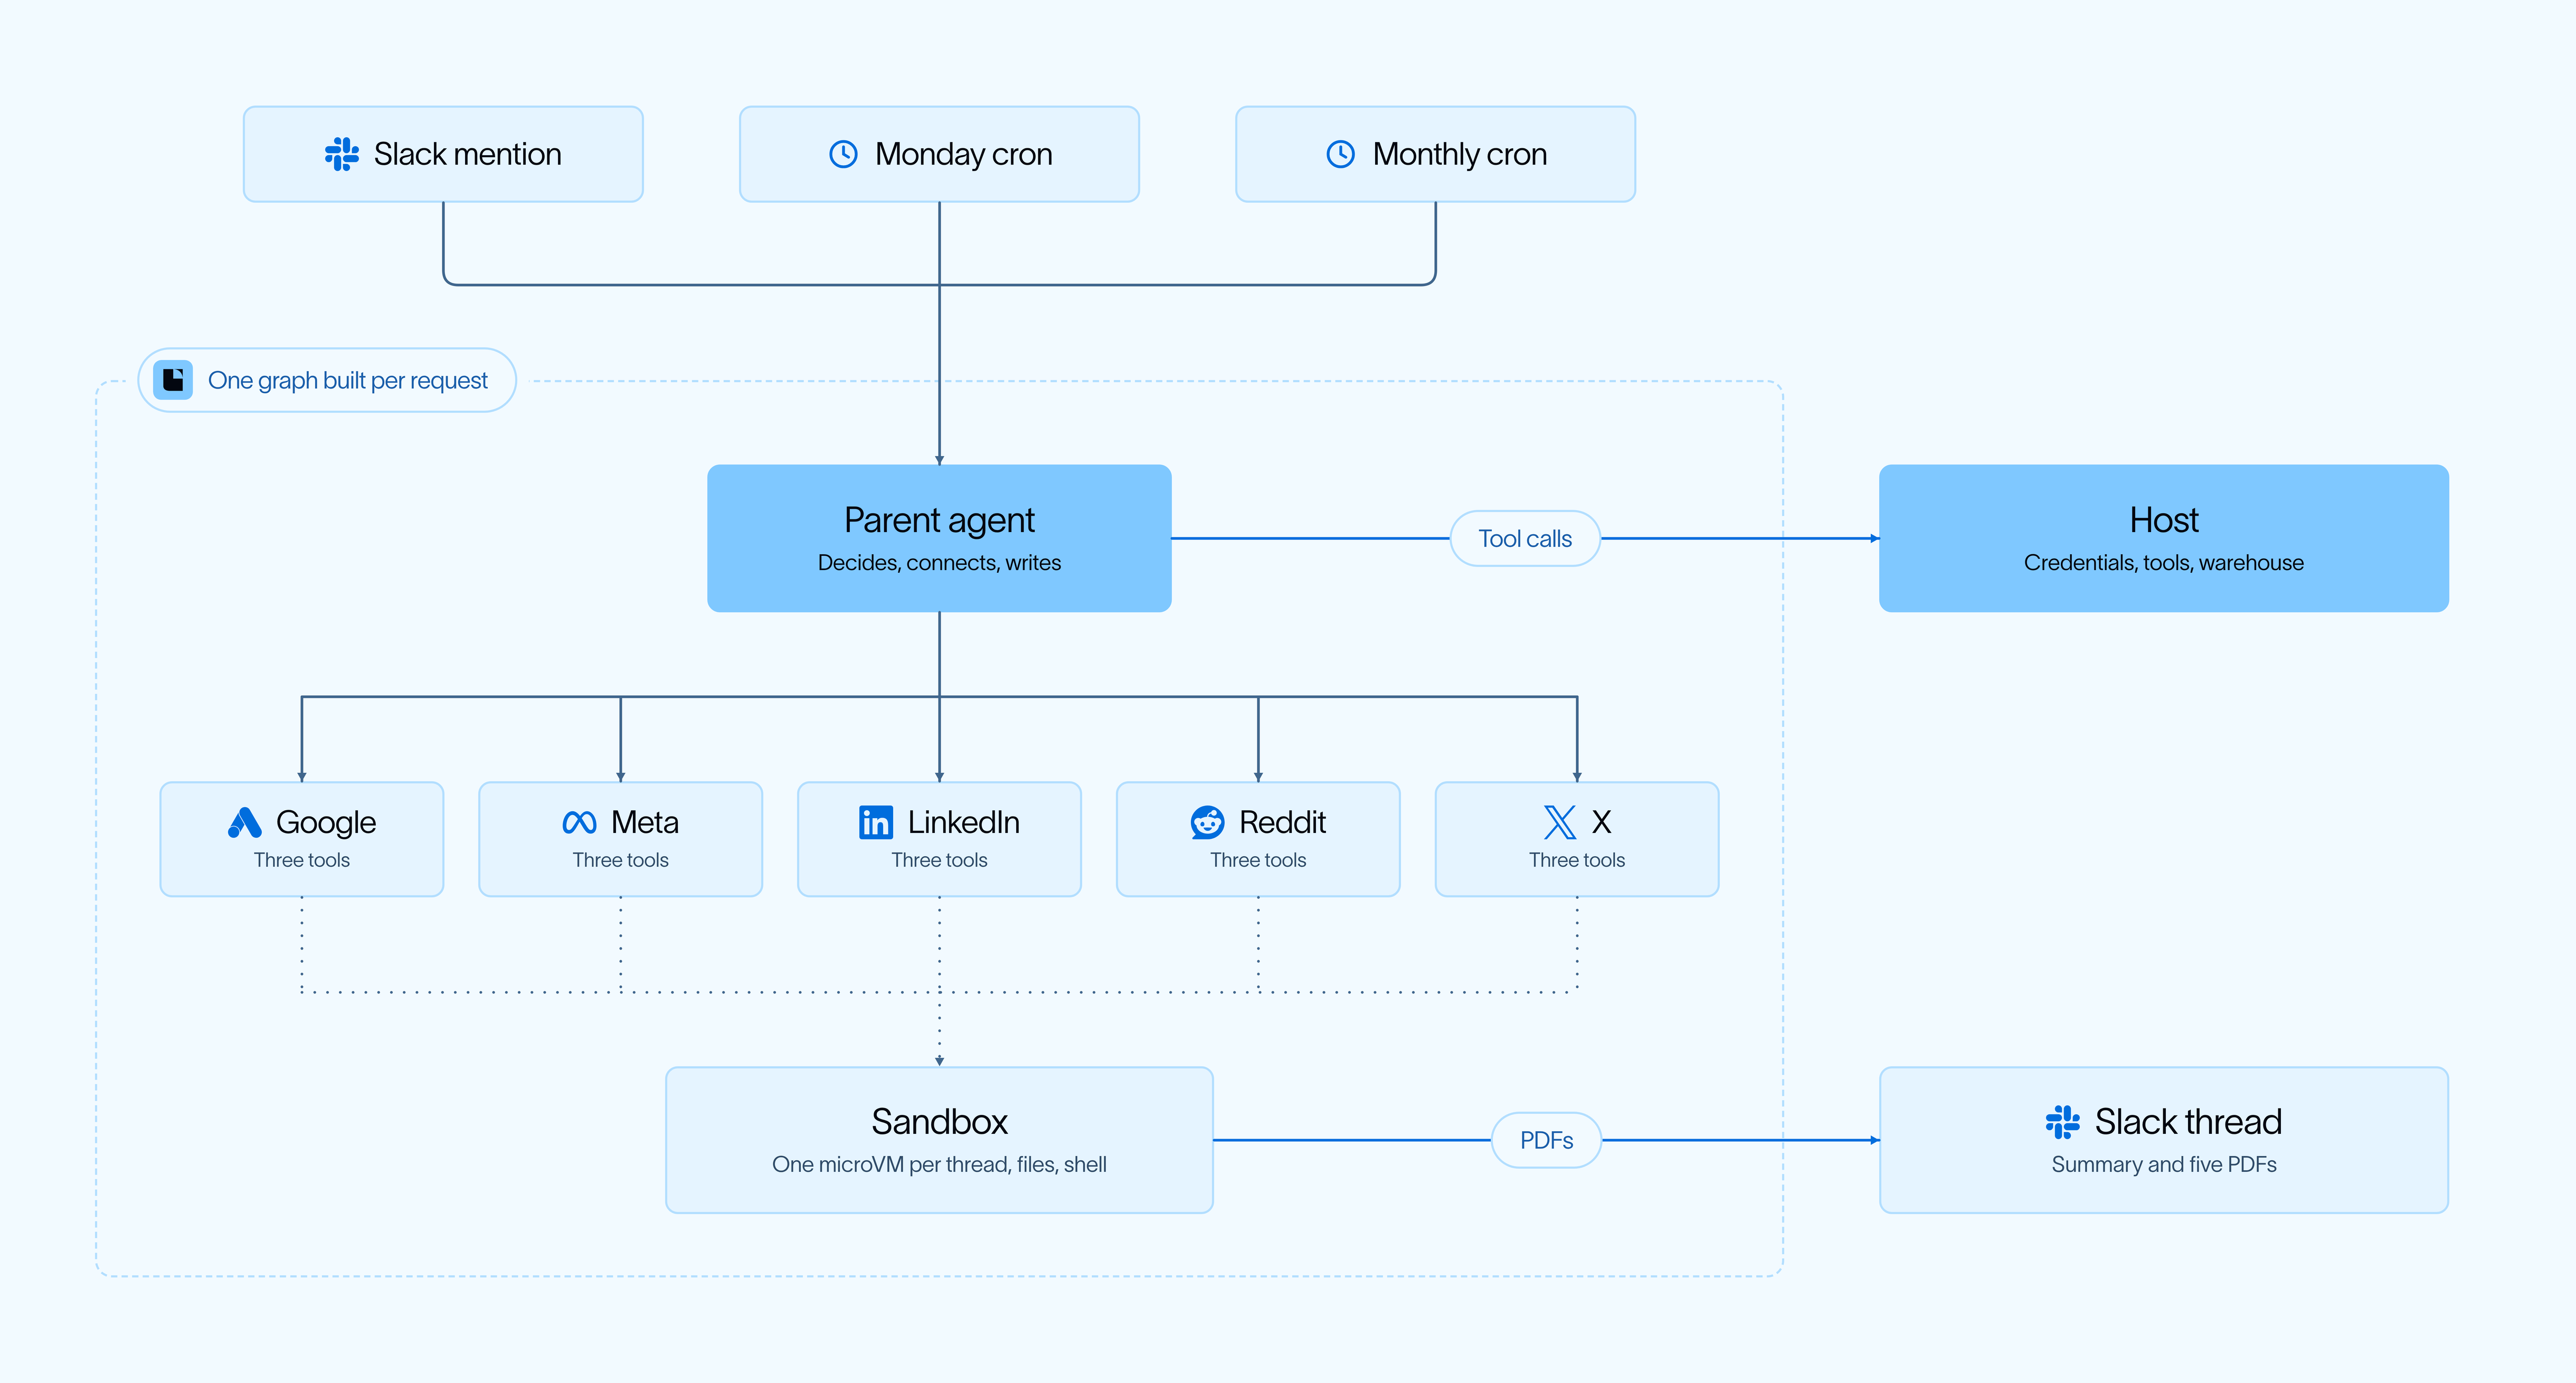
실수는 이들을 두 개의 제품으로 취급한 것이었습니다. 사실 이들은 동일한 위키, 스킬, 도구, 그리고 소스 규칙을 기반으로 하는 동일한 분석으로 들어가는 두 개의 진입점일 뿐이었습니다. 대신 저희는 각 요청에 대해 상태와 기능을 분리했습니다. 모든 스레드는 자체 샌드박스와 체크포인트를 가지며, 각 실행은 자신이 필요한 도구만 볼 수 있습니다.
이제 하나의 그래프가 존재하며, 모든 요청마다 새로 인스턴스화됩니다:
- Slack 언급과 월요일 크론(cron) 작업이 서로 다른 실행 모드로 진입합니다.
- 스케줄링된 실행은 단일 도구인
task()를 보고하고, 이 도구가 플랫폼별 서브에이전트에게 위임합니다. - Slack은 더 광범위한 읽기, 데이터 웨어하우스, 캠페인 운영 도구를 얻습니다.
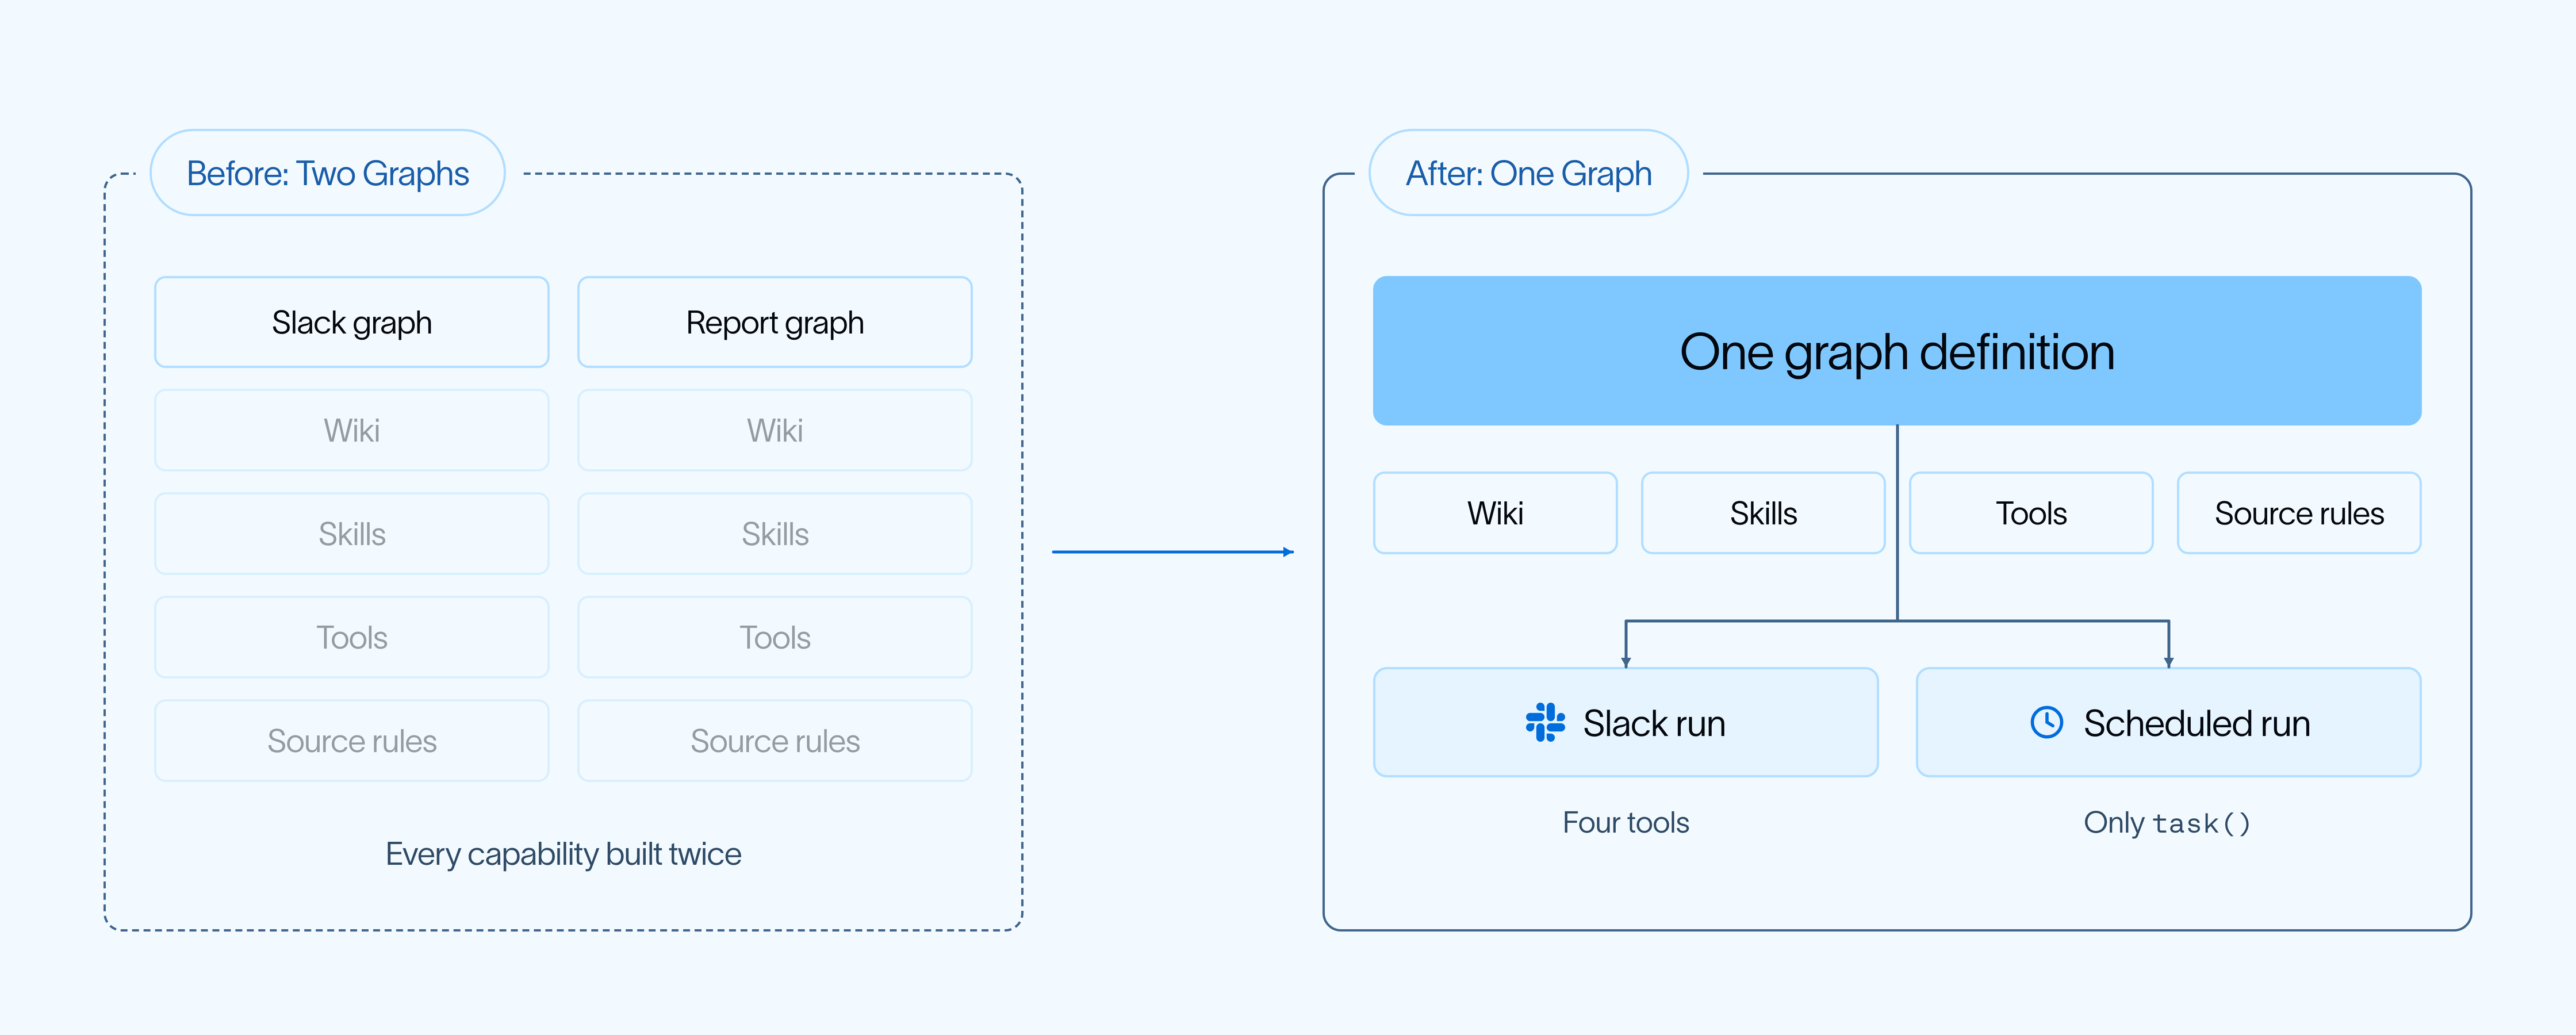
이는 LangSmith Deployment에서 호스팅, 확장성 및 스케줄링된 실행을 처리하는 동일한 런타임이며, 서로 다른 기능 프로필로 제공됩니다. 그리고 Slack이 이제 같은 샌드박스 아키텍처를 공유하게 되면서, 에이전트는 보고서 PDF를 열고 해당 스레드가 생성한 내용에 대해 후속 질문에 답변할 수도 있게 되었습니다.
💡핵심 교훈: 하나의 런타임을 사용하고 각 진입점마다 기능 프로필을 지정하세요. 동일한 공장(factory)이 서로 다른 사용자에게 서로 다른 기술과 권한을 부여할 수 있습니다.
주요 기술적 교훈
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기