
EmbeddingGemma 2: 개방적이고 가벼운 멀티모달 임베딩 모델
요약
EmbeddingGemma 2는 Gemma 4 아키텍처 기반의 개방적이고 가벼운 멀티모달 임베딩 모델입니다. 텍스트를 넘어 코드, 이미지, 비디오, 오디오까지 공유 임베딩 공간으로 확장되었으며, 온디바이스 추론에 최적화되었습니다. MTEB 등 주요 벤치마크에서 높은 성능을 보여주며, 로컬 환경에서의 검색 증강 생성(RAG) 및 코딩 에이전트 활용에 적합합니다.
핵심 포인트
- 코드, 이미지, 비디오, 오디오를 아우르는 네이티브 멀티모달 임베딩 지원
- 온디바이스 추론 최적화로 낮은 메모리 사용량과 높은 효율성 제공
- MTEB 등 벤치마크에서 작은 모델 중 최고 수준의 성능 입증
- 8K 토큰 컨텍스트 창으로 대용량 데이터 처리 가능
EmbeddingGemma 2: 개방적이고 가벼운 멀티모달 임베딩 모델
작년, 저희는 고품질 텍스트 임베딩을 위한 가벼운 옵션을 제공하기 위해 EmbeddingGemma를 소개했습니다. 이를 통해 개발자들이 앱에서 정보를 정리하고, 검색하며, 소비자 하드웨어에서 직접 연결할 수 있도록 도움을 줄 수 있습니다. 개발자 커뮤니티의 반응은 저희의 기대를 훨씬 뛰어넘었습니다. 2천만 건 이상의 다운로드를 기록하며, 빌더들은 이를 활용하여 더 스마트한 온디바이스(on-device) 검색 도구와 개인 정보 보호를 우선시하는 검색 증강 생성(RAG) 파이프라인을 구동했습니다.
오늘, 저희는 EmbeddingGemma 2를 출시하며 범위를 텍스트를 넘어 코드, 이미지, 비디오, 오디오까지 공유 임베딩 공간으로 확장합니다. Gemma 4 아키텍처를 기반으로 하며 상업적으로 허용적인 Apache 2.0 라이선스 하에 공개된 EmbeddingGemma 2는 7억 4천만 개의 파라미터를 가지고 있어 온디바이스 추론(inference)에 최적화되어 있습니다. 이 모델은 음성 메모에서 특정 비디오 클립을 찾거나, 텍스트 질의를 기반으로 수 시간 분량의 오디오 녹음 자료를 검색하는 등 모든 작업을 단일하고 네이티브 멀티모달 모델로 처리할 수 있도록 도와줍니다.
Gemini Embedding 모델과 동일한 기술로 구축된 EmbeddingGemma 2는 다음과 같습니다:
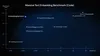
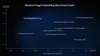
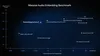
크기 대비 최고 수준의 성능: MTEB (Massive Text Embedding Benchmark) Code 및 MAEB (Massive Audio Embedding Benchmark)와 같은 벤치마크에서 크기가 작은 멀티모달 임베더 중 선두적인 점수를 달성했습니다. 동시에 텍스트, 비전, 오디오 작업 전반에 걸쳐 더 큰 모델들과 동등하거나 능가하는 성능을 보여줍니다.설계상 모듈화: 텍스트 전용 워크로드의 경우 단 270M 개의 파라미터만 필요하며, 옵션으로 비전(170M) 및 오디오(300M) 인코더를 추가하여 완전한 멀티모달 지원이 가능합니다.저장 효율성: Matryoshka Representation Learning (MRL)을 사용하여 개발자는 출력 벡터를 768차원에서 512, 256 또는 128차원으로 동적으로 축소할 수 있습니다. 이를 통해 로컬 벡터 데이터베이스 및 메모리 사용량을 최대 6배까지 줄일 수 있습니다.온디바이스 성능 최적화: 제한적인 리소스 제약 조건 내에서도 효율적으로 작동합니다. 양자화(quantization)를 적용했을 때, Google Pixel 11 Pro에서 EmbeddingGemma 2는 텍스트 전용 가중치에 대해 최소 약 191MB의 활성 RAM을, 완전한 멀티모달 모델에는 약 567MB를 필요로 합니다.확장된 컨텍스트 지원: 8K 토큰 컨텍스트 창(EmbeddingGemma 1보다 4배 더 큼)을 특징으로 하여, 최대 5.5분 분량의 오디오, 29개의 이미지, 58개의 비디오 프레임 또는 이들의 혼합 조합을 로컬 하드웨어에서 직접 처리할 수 있습니다.
코드, 비전 및 오디오 분야에서 최고 수준의 품질 달성
EmbeddingGemma 2는 EmbeddingGemma가 보여주는 강력한 다국어 텍스트 성능을 유지하면서도, 코드 성능(MTEB Code 기준, 68.76점에서 78.68점으로)에서 9.92점의 상당한 향상을 제공하여 로컬 코드베이스 인덱싱, 시맨틱 코드 검색 및 코딩 에이전트 검색에 매우 적합합니다. 이미지, 비디오, 문서 및 오디오 전반에 걸쳐, 이는 1B 미만 모델의 파라미터당 품질 기준을 새로 세우며 심지어 크기가 두 배 이상 큰 일부 전문 모델보다도 뛰어난 성능을 보여줍니다.
온디바이스에서 시맨틱 검색, 라우팅 및 검색 기능 구현 지원
EmbeddingGemma 2는 강력한 기능을 에지 하드웨어에 직접 제공합니다. 임베딩을 로컬에서 생성하면 데이터 프라이버시를 보장하고, 파이프라인 지연 시간을 줄이며, 개발자가 완전히 오프라인으로 작동하는 크로스모달 검색 및 검색 시스템을 구축할 수 있도록 지원합니다.
Gemma 4와 같은 생성 모델과 결합하여 EmbeddingGemma 2는 복잡한 멀티모달 데이터를 이해하는 온디바이스 RAG(검색 증강 생성) 파이프라인을 가능하게 합니다. EmbeddingGemma 2가 Gemma 4를 기반으로 구축되었고 텍스트 토크나이저와 오디오 인코더를 공유하기 때문에, 개발자는 두 모델을 낮은 결합 총 메모리 사용량으로 통합된 파이프라인에서 함께 실행할 수 있습니다.
EmbeddingGemma 2 시작하기
EmbeddingGemma 2가 구축하는 모든 환경에서 즉시 작동하도록 다음 파트너들과 긴밀하게 협력했습니다:
모델 다운로드: Hugging Face와 Kaggle에서 모델 가중치를 찾을 수 있으며, Gemini Enterprise Agent Platform Model Garden의 사용은 곧 제공될 예정입니다. 온디바이스에 최적화된 모델은 Hugging Face의 LiteRT Community를 방문하세요.온디바이스 배포: 턴키(turnkey) 임베딩, 검색 및 의사 결정 작업을 위해 Google AI Edge MediaPipe로 크로스 플랫폼 앱을 개발하거나 사용자 정의 모델 통합을 위해 LiteRT를 사용하세요. 브라우저용으로 transformers.js 또는 WebGPU를 사용하여 구축할 수 있습니다.선호하는 개발 도구 사용: transformers, sentence-transformers, MLX, vLLM, llama.cpp, SGLang, Ollama, LMStudio를 사용하여 모델을 효율적으로 서비스하고, Qdrant에 임베딩 벡터를 저장하세요.파인튜닝(Fine-tuning): Unsloth의 가이드를 따라 사용 사례에 맞게 EmbeddingGemma 2를 파인튜닝하는 방법을 확인하세요.
추론 및 파인튜닝을 위한 개발자 가이드, 문서 및 가이드를 살펴보세요.
AI 자동 생성 콘텐츠
본 콘텐츠는 HN Claude Code Search의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기