
Apple Silicon에서 GGUF 모델을 가장 빠르게 실행하는 방법: gmlx
요약
gmlx는 Apple Silicon 환경에서 GGUF 모델을 가장 빠르게 실행할 수 있는 로컬 추론 플랫폼입니다. MLX의 Metal 커널을 활용하여 llama.cpp보다 빠른 성능을 보여주며, 코딩 에이전트 연결, API 서비스, 음성 대화 등 다양한 기능을 지원합니다. 사용자는 Homebrew나 uv를 통해 쉽게 설치하고 모델을 관리할 수 있습니다.
핵심 포인트
- Apple Silicon에서 GGUF 모델의 최고 속도 추론 환경 제공
- MLX Metal 커널 기반으로 llama.cpp 대비 성능 우위 확보
- 코딩 에이전트 연결, API 서비스 등 다양한 활용 가능
- Homebrew 또는 uv를 통해 간편하게 설치 및 사용 가능
The fastest way to run GGUF models on Apple Silicon.
gmlx는 로컬 추론 플랫폼입니다. 터미널이나 브라우저에서 오픈 모델과 채팅하거나, OpenAI 및 Anthropic 호환 API를 통해 서비스하고, 코딩 에이전트를 연결하거나, 음성으로 대화하고, LoRA로 파인튜닝할 수 있습니다.
이는 mlx-kquant의 Metal 커널을 사용하여 Apple의 MLX에서 커뮤니티가 발표한 K-quant 및 IQ-quant GGUF 파일을 정확하게 실행합니다. 같은 파일에 대해서도 llama.cpp보다 빠르게 사전 채우기(prefills)를 수행하며, 두 엔진 모두에서 추측 디코딩(speculative decoding)을 사용하면 더 빠르게 디코드됩니다. 이 격차는 코딩 에이전트가 사용하는 긴 컨텍스트에서 가장 크게 나타납니다. RAM보다 큰 Mixture-of-experts 모델도 디스크에서 전문가들을 스트리밍하여 실행할 수 있습니다.
Quickstart
gmlx는 macOS 26.2 이상을 지원하는 Apple Silicon Mac이 필요합니다. Homebrew로 설치하세요:
brew install asher/gmlx/gmlx
아래 예시 모델인 Qwen3.8-27B UD-Q6_K는 20.5 GB의 다운로드 용량이며, 메모리 64 GB를 가진 Mac에 적합합니다. 모델은 대화 공간 외에도 파일 크기만큼의 메모리가 필요합니다. 더 작은 Mac에서는 먼저 모델 선택하기에서 모델을 선택하세요.
gmlx init --models-dir ~/models
gmlx pull hf:unsloth/Qwen3.8-27B-GGUF/Qwen3.8-27B-UD-Q6_K.gguf
gmlx run  qwen3.8-27b-ud-q6 --prompt "Explain entropy in one paragraph."
...
gmlx init은 설정 파일을 작성하고, pull은 모델을 다운로드하여 qwen3.8-27b-ud-q6 ID 아래에 추가합니다. serve는 포트 8080에서 백그라운드로 서버를 시작하며, launch는 pi 코딩 에이전트를 이 서버에 연결합니다. 먼저 npm install -g @earendil-works/pi-coding-agent로 pi를 설치하거나, --container를 추가하여 pi가 설치된 Apple 컨테이너에서 실행할 수 있습니다.
Homebrew 없이 설치하려면 uv를 사용하세요: uv tool install "gmlx[all]"를 사용하고, 음성 기능을 위해 brew install ffmpeg을 추가합니다. 자체 Python 환경에서 gmlx를 사용하려면, pip install "gmlx[all]"을 사용하십시오. 두 명령어 모두 모든 선택적 기능(optional feature)을 설치합니다.
설치에서는 각 경로에 대해 다루며, 업그레이드 및 gmlx 제거 방법을 안내합니다.
구성 파일 없이도 모든 GGUF 파일은 해당 경로를 통해 실행하고, 채팅하며, 서비스를 제공할 수 있습니다:
gmlx chat Qwen3-4B-Q4_K_M.gguf
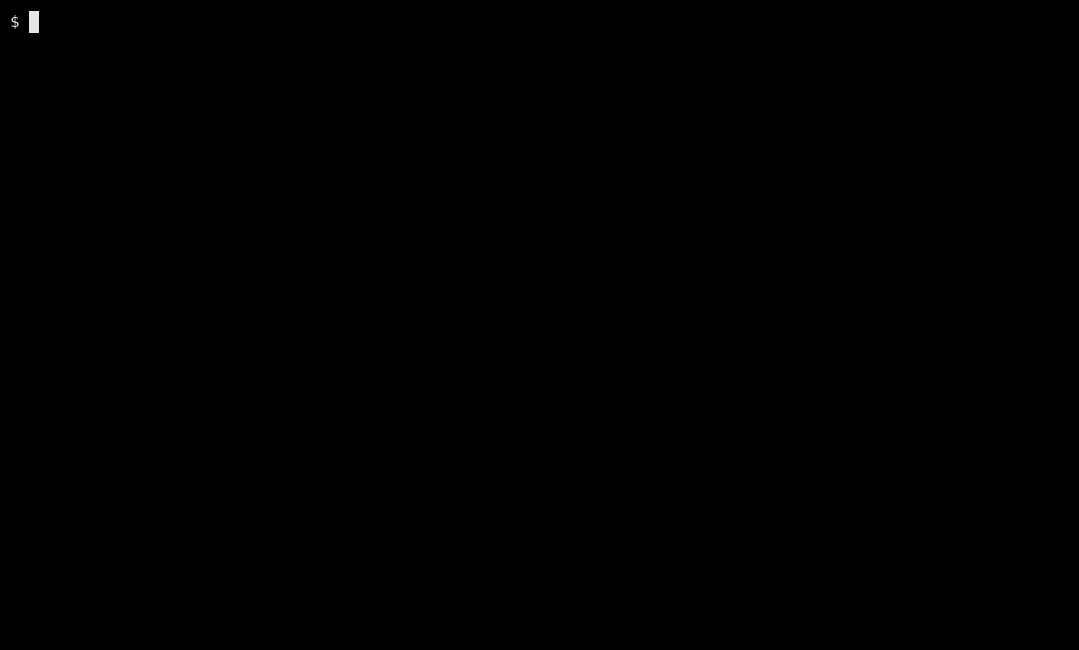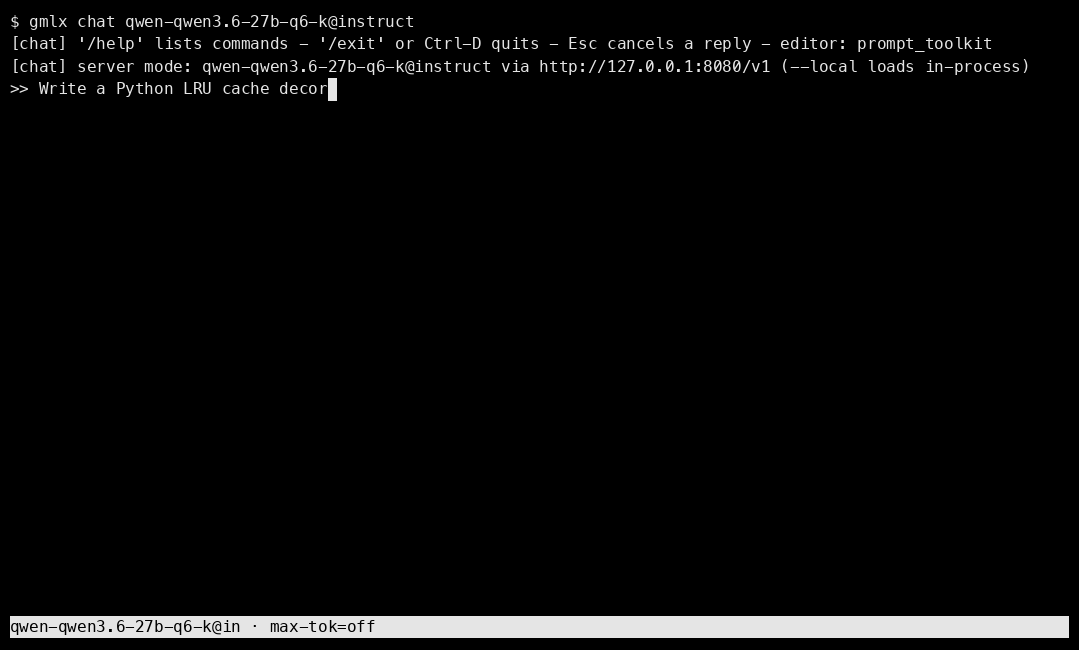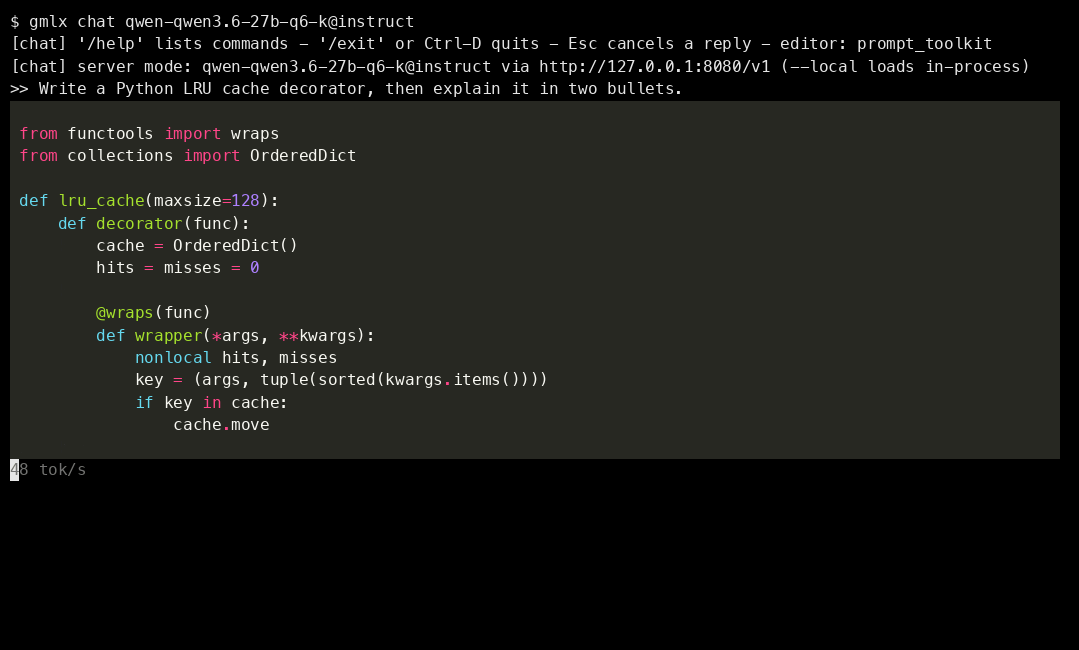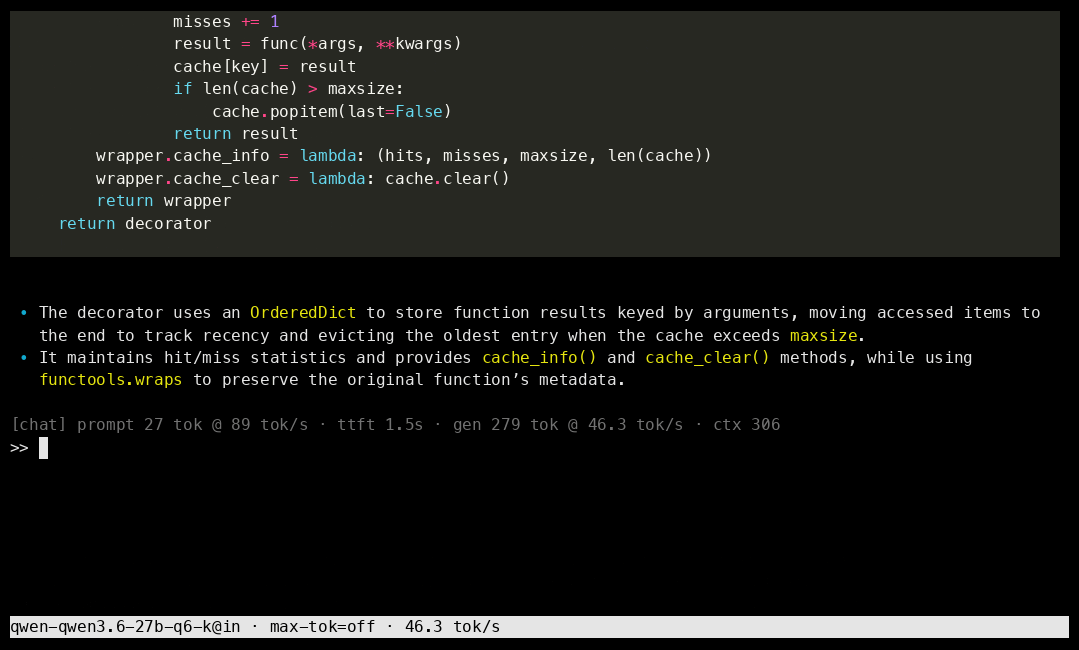
녹화는 로컬 서버에서 27B 모델을 사용하여 실제 속도로 실행됩니다.
주요 기능
- 마크다운, 세션, 이미지 및 각 계열별 권장 샘플링이 가능한 터미널 채팅 기능을 제공합니다. Chat를 참조하십시오.
- 다운로드 전에 원격으로 확인하는 기능:
gmlx validate는 파일이 로드되고 적합한지 알려줍니다. CLI 참고 자료를 참조하십시오. - OpenAI Chat Completions, OpenAI Responses 및 Anthropic Messages용 단일 서버를 제공하며, 도구(tools), 구조화된 출력(structured output), 비전 기능을 지원합니다. HTTP API를 참조하십시오.
- Mac 또는 Apple 컨테이너에 설정되며, 오직 사용자의 프로젝트만 볼 수 있는 코딩 에이전트와 채팅 앱을 한 번의 명령으로 설정할 수 있습니다. Agents and chat apps를 참조하십시오.
- 음성 깨우기 구문(wake phrase)과 함께하는 음성 채팅, 그리고 도구 및 메모리를 갖춘 비서 기능을 제공합니다. Voice chat와 Assistant를 참조하십시오.
- 로컬 RAG(Retrieval-Augmented Generation) 및 음성 스택을 위해 임베딩(Embeddings), 리랭크(rerank), 음성 인식(speech-to-text), 음성 합성(text-to-speech) 기능을 동일한 서버에서 제공합니다.
다음 기능을 확인하세요.
음성, 임베딩 및 재순위화 (Speech, embeddings and rerank).
- Z-Image, Qwen-Image 2.1, Krea 2 Turbo, FLUX.2 klein 및 FLUX.3 klein GGUF를 사용하여 명령줄에서, OpenAI 이미지 경로에서 그리고 ComfyUI에서 이미지 생성 기능 제공. M3 칩 이상이 필요합니다. 이미지 생성 (Image generation) 참조.
- 텍스트에 대한 예/아니오(yes-or-no), 선택(choice) 및 점수 질문에 대해 각 답변의 확률을 반환하는
/v1/systemoneAPI 결정 기능. 구조화된 결정 (Structured decisions) 참조. - 양자화된 모델에서의 LoRA 학습과 더 큰 모델로부터의 증류(distillation). LoRA 어댑터 (LoRA adapters)를 확인하세요.
- 로드된 모델을 표시하고 서버를 제어하는 메뉴 막대 앱. 메뉴 막대 앱 (Menu bar app) 참조.
성능 (Performance)
<picture> <source media="(prefers-color-scheme: dark)" srcset="https://raw.githubusercontent.com/asher/gmlx/main/docs/assets/perf/fleet-ratio-dark.svg"> <img src="https://raw.githubusercontent.com/asher/gmlx/main/docs/assets/perf/fleet-ratio.svg" alt="KV 깊이에 따른 gmlx 대 llama.cpp: 처리량 속도 향상"> </picture>수치가 높을수록 빠릅니다. 깊이(Depth)는 컨텍스트에 이미 존재하는 토큰의 수를 의미합니다. 각 모델별 벤치마크는 Benchmarks를 참조하세요.
M5 Max에서 gmlx는 모든 벤치마크된 모델과 모든 깊이에서 llama.cpp보다 더 빠르게 프리필(prefills)합니다. 양쪽 엔진 모두에서 추측 디코딩(speculative decoding)을 사용하면 디코드 속도 또한 더 빠릅니다. gmlx run model.gguf --bench 128,512,2048 명령어로 직접 Mac을 측정해 보세요.
추측 디코딩, 프롬프트 캐시(prompt cache), KV 캐시 양자화에 대한 설명은 성능 최적화 (Performance tuning)에서 확인할 수 있습니다. 1분짜리 비디오는 하나의 서버가 단일 채팅에서 네 개의 동시 스트림으로 갔다가 돌아오는 과정을 보여줍니다.
지원되는 아키텍처 (Supported architectures)
- Llama, Mistral, Phi-3, SmolLM3, Seed-OSS 및 ERNIE-4.5
- Qwen 2부터 3.8까지, dense 및 MoE 구조를 가진 하이브리드 어텐션 계열 모델들
- Gemma 1부터 4까지 (단, 3n 변형은 상위 레벨에서 GGUF가 손상됨)
- DeepSeek V3, R1, V4-Flash 및 V4.1-Flash
- GLM 4부터 5.3까지, Kimi-K3, MiniMax M2 및 M3, 그리고 gpt-oss
- Hunyuan, Hy3, HY4, Muse Glimmer 및 Muse Spark
- Granite, Nemotron-H 및 Falcon-H1
각 계열의 출력은 16k 컨텍스트에서 llama.cpp를 통해 검증되었습니다.
커버리지 테이블에 예외 사항들이 나열되어 있습니다. 모든 K-quant, IQ-quant 및 레거시 타입 외에도 MXFP4, NVFP4 및 테르너리(ternary) 타입이 로드되며, 비전 모델은 해당 프로젝터와 함께 로드됩니다.
Python API
from gmlx import load_model, generate

model, config, tokenizer = load_model(

풀 리퀘스트(Pull requests)를 환영합니다. 개발 환경 설정 및 규칙은 [contributing guide](https://github.com/asher/gmlx/blob/main/CONTRIBUTING.md)에, 테스트 계층은 [Testing](https://asher.github.io/gmlx/internals/testing.html)에, 런타임의 설계는 [Internals](https://asher.github.io/gmlx/internals/index.html)에서 확인할 수 있습니다.

## 감사의 글 (Acknowledgments)

gmlx는 GGUF 포맷 및 K-quant 참조 구현을 위해 [llama.cpp 및 ggml](https://github.com/ggml-org/llama.cpp)를 기반으로 하며, 런타임 및 모델 구현을 위해 [MLX 및 mlx-lm](https://github.com/ml-explore/mlx-lm)를 사용하고, 서버 앱, 생성 단계 루프(generation step loop), 비전 타워(vision towers)를 위해 [mlx-vlm](https://github.com/Blaizzy/mlx-vlm)을 활용합니다. gmlx는 mlx-lm과 mlx-vlm을 패키지에 포함하며, 해당 라이선스 하에 배포됩니다. 음성 기능은 음성 인식(speech-to-text)을 위해 [mlx-whisper](https://pypi.org/project/mlx-whisper/)를, 음성 합성(text-to-speech)을 위해 [mlx-audio](https://pypi.org/project/mlx-audio/)를 사용합니다.

## 라이선스 (License)

gmlx는 소스 코드는 이용 가능하지만 오픈 소스는 아닌 [Business Source License 1.1](https://github.com/asher/gmlx/blob/main/LICENSE) 하에 배포됩니다. 상업적 작업(commercial work)을 포함하여 개인적인 목적으로 gmlx를 사용, 수정 및 실행할 수 있으며, 수정되지 않은 복사본을 무료로 재배포할 수 있습니다. 다만, gmlx 또는 그 파생물을 판매하거나, 이를 상업용 제품 또는 서비스에 통합하거나, 호스팅된 서비스 형태로 타인에게 제공할 수는 없습니다. 각 배포 버전은 출시 후 4년이 지나면 Apache License 2.0으로 전환되며, 다운로드한 모델 가중치(model weights)는 자체 라이선스를 가집니다.

[LICENSE-MIT](https://github.com/asher/gmlx/blob/main/LICENSE-MIT)에 나열된 파일들은 MIT 라이선스이며 이를 명시하는 SPDX 헤더를 가지고 있습니다. `gmlx/comfyui_pack`의 ComfyUI 노드 팩은 자체 LICENSE 파일을 가진 Apache License 2.0 하에 라이선스가 부여됩니다. 임베디드(Vendored) 서드파티 코드는 [third-party notices](https://github.com/asher/gmlx/blob/main/THIRD_PARTY_NOTICES.md)에서 문서화되어 있습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub AI Tools의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기