Insights
AI가 자동으로 큐레이션·번역·정리하는 기술 동향 피드입니다.
© 2026 Molayo
AI가 자동으로 큐레이션·번역·정리하는 기술 동향 피드입니다.
본 페이지의 콘텐츠는 AI가 공개된 소스를 기반으로 자동 수집·요약·번역한 것입니다. 원 저작권은 각 원저작자에게 있으며, 각 게시물의 “원문 바로가기” 링크를 통해 원문을 확인할 수 있습니다. 저작권자의 삭제 요청이 있을 경우 신속히 조치합니다.
Meta-Harness 논문은 AI 에이전트가 BlackBoard 도구에 정보를 저장하고, 호출하며 모델에 제공하는 방식을 결정하는 'harness' 레이어를 자동으로 개발합니다. 이 시스템은 과거의 코드와 작동 기록을 분석하여 더 효율적인 에이전트 워크플로우를 설계할 수 있습니다.

사용자가 요청한 다양한 벤치마크 결과들을 ReWo-Bench 웹사이트에 모아 공개했습니다. 이 벤치마크에는 TYT, AYT, TUS, Context 등의 상세 테스트가 포함되어 있습니다.
본 글은 BlackBoard 도구를 활용하여 Thinking Machines의 'LoRA Without Regret' 기술을 분석합니다. LoRA는 모델 전체 가중치 업데이트 없이 작은 어댑터로 파인튜닝하는 기법으로, 랭크, 학습률 등 다양한 하이퍼파라미터가 결과에 미치는 영향을 다룹니다.
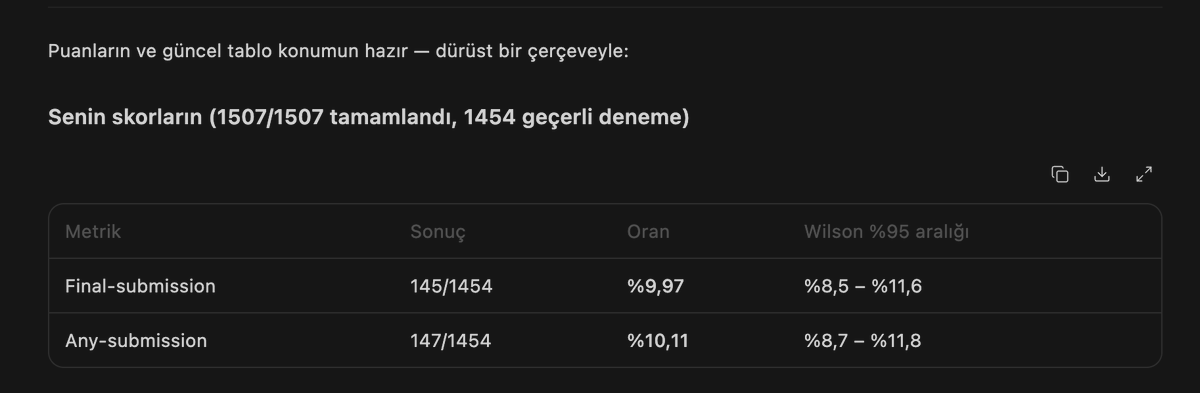
특정 27B 모델의 CyberGym 테스트 결과를 공유하는 내용입니다. 이 모델은 가드레일과 검열이 제거된 버전에서 32위를 기록했습니다.

본 글은 보안에 중점을 두고 파인튜닝한 Uncensored 27B 모델을 공격적인 시나리오에서 사용했을 때의 결과를 공유합니다. IP 주소만으로 목표를 지정하여 두 대의 머신에서 사용자 및 관리자 권한을 탈취하는 과정을 보여주었습니다.
사이버 보안에 초점을 맞춰 Uncensored 27B 모델을 미세 조정하여 공격적인 활용 사례를 공유합니다. Hackthebox의 격리된 환경에서 IP 주소 정보만으로 두 대의 기계 모두에서 사용자 및 관리자 권한을 성공적으로 탈취했습니다.

본 글은 GLM-5.3-Flash NVFP4와 DFlash2 통합을 위한 4x NVIDIA DGX Spark 기반 TP4 배포 패키지를 공개합니다. 이 패키지에는 모델, 런타임 버전, 필요한 패치, 시작/복구 작업, 정확성 검사 및 벤치마크 도구가 모두 포함되어 있습니다. 이 설정을 통해 단일 요청당 평균 디코드 속도는 33.37 token/s, 네 개의 동시 요청에 대한 총 디코드 속도는 70.43 token/s를 달성했습니다.
글쓴이는 Astra와 같은 비밀 모델의 ASI/AGI 수준 자체보다는, 이러한 강력한 AI를 소유한 주체들이 감시 및 정보 활동에 참여하거나 권리를 주장할 수 있다는 점을 더 큰 문제로 지적합니다. 이는 곧 디스토피아적인 사회 통제 시스템으로 이어질 위험성을 경고하고 있습니다.

Kahya-TTS는 OpenBMB의 VoxCPM2 모델을 기반으로 터키어 텍스트-음성 합성(TTS) 데이터셋을 구축하고 파인튜닝하여 개발된 모델입니다. 이를 통해 터키어에 특화되고 자연스러운 음성 데이터를 제공하며, 커뮤니티 사용자들에게 도움을 주고자 합니다.
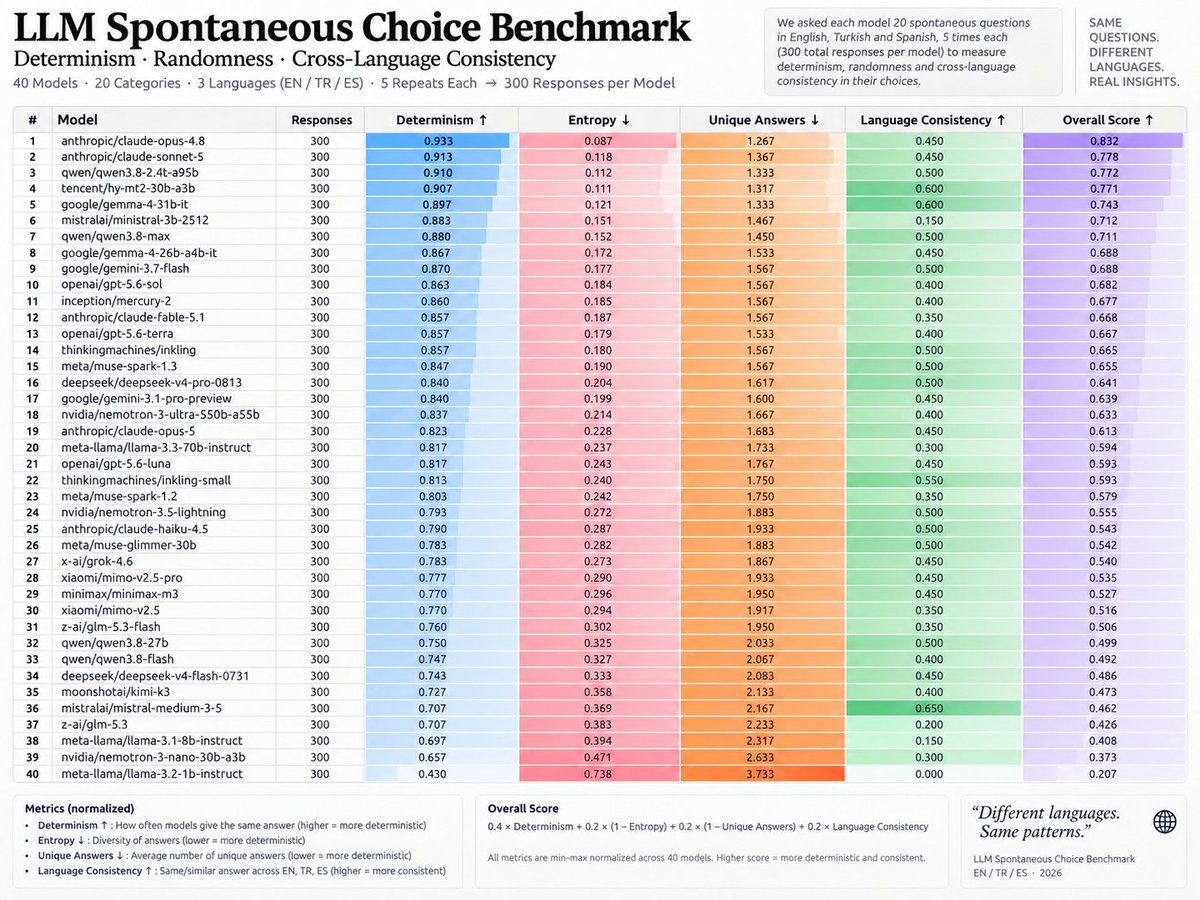
본 글은 LLM의 자발적 선택(spontaneous selection) 벤치마크 모델 분석 결과를 공유합니다. 연구자는 다양한 언어와 범주에 걸쳐 여러 모델에게 질문을 던져 결정론성, 엔트로피, 단일 답변 개수, 언어 일관성을 측정했습니다. 그 결과, 일부 최첨단 모델들이 예상보다 더 안정적이고 정형화된 행동 패턴을 보이는 것이 주요 발견입니다.

GLM 5.3 Flash NVFP4 모델을 활용하여 DFlash2와 NextN 기반의 추측 디코딩(speculative decoding) 성능을 비교 분석했습니다. 그 결과, NextN이 테스트된 모든 병렬성 수준에서 DFlash2를 크게 능가하는 우수한 성능을 보여주었습니다.
GPT Plus나 Claude Pro 같은 유료 멤버십을 사용하더라도, 고용량 토큰 모델(예: 1M 토큰에 $50)의 실제 비용 구조를 간과해서는 안 됩니다. 현재 할당량(quota) 시스템은 논란의 여지가 있으며, 저렴한 멤버십 요금으로는 예상보다 빠르게 토큰을 소진할 수 있습니다.
오픈 소스 파인튜닝 음성 모델 Kahya-TTS가 공개되었습니다. 이 모델은 @OpenBMB의 openbmb/VoxCPM2를 기반으로 광범위한 파인튜닝을 거쳤으며, 유창하고 감성적인 터키어 합성 추론이 가능합니다.
본문은 TTS 및 ASR 모델이 톤과 감정 합성 기능에서 강력하지만, 언어 자체의 역량 구현에 어려움이 있음을 언급합니다. 사용자가 로컬 환경에서 finetuning을 통해 cfg_value, inference_timesteps, seed 등의 매개변수를 조정하거나, 텍스트 내 스타일 지침을 활용하여 자신만의 방식으로 모델을 사용할 수 있도록 안내하고 있습니다.

GLM 5.3 Flash NVFP4 모델을 NVIDIA AI DGX Spark x4 클러스터에서 Speculative Decoding 기법으로 성공적으로 추론 테스트했습니다. 다양한 병렬 요청 수와 긴 Context 길이(1K~16K)를 활용하여 성능을 검증했으며, 매우 빠른 속도를 확인했습니다.
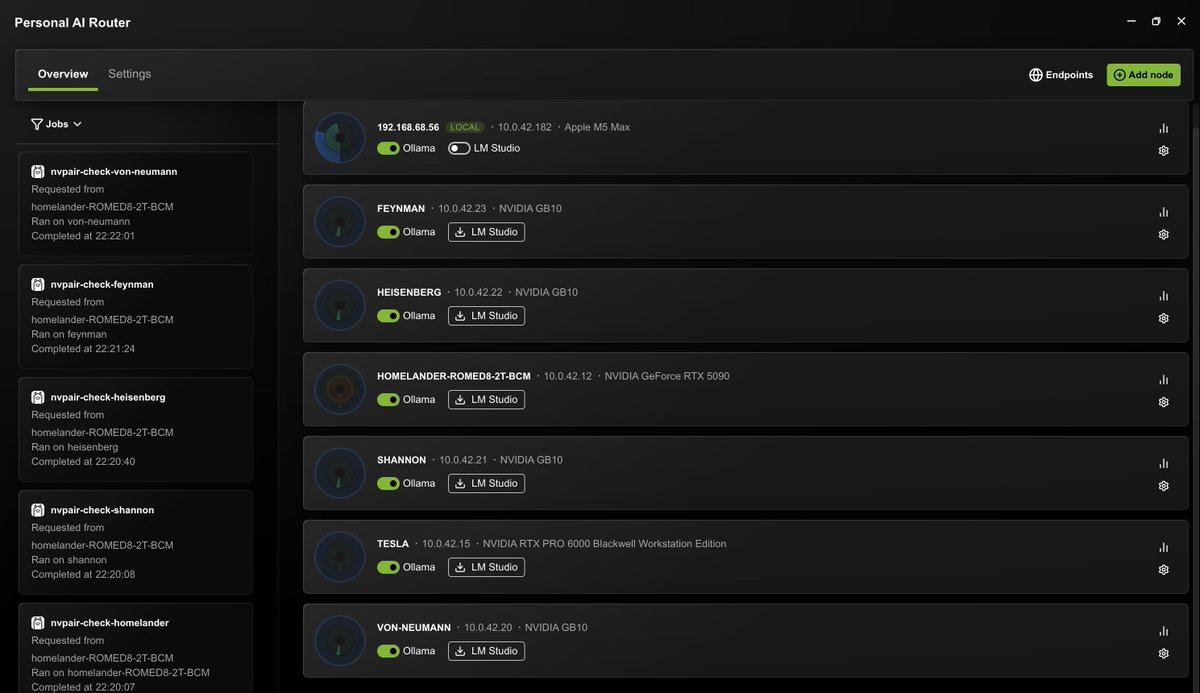
Ollama와 LMStudio를 통합하여 원활한 추론 환경을 구축하는 방법을 소개합니다. 이 구성을 통해 다양한 AI 모델을 효율적으로 배포하고 테스트할 수 있습니다.

다양한 컨텍스트 길이(16k~512k)에 따른 LLM의 응답 정확도와 품질을 평가하는 새로운 벤치마크를 소개합니다. 테스트 결과, 64k 이상의 컨텍스트에서는 품질 저하와 비용 급증이 동시에 발생함을 확인했습니다.
GLM 5.2와 DeepSeek-v4-0731 모델을 대상으로 이중 진자 물리 시뮬레이션 및 RK4 적분 태스크를 수행한 벤치마크 결과입니다. DeepSeek가 수치 정확도와 신뢰성 면에서 우세했으나, GLM은 UI 및 메모리 효율성 측면에서 강점을 보였습니다.
Trail 벤치마크를 통해 이중 진자 적분 태스크에서의 LLM 코딩 성능을 분석했습니다. 알고리즘, 수학, 프론트엔드 역량을 종합하여 모델별 품질 대비 성능과 가성비를 평가했습니다.

터키 법률 분야에 특화된 오픈 소스 의사결정 지원 LLM인 Mizan-27B가 공개되었습니다. RAG 방식의 데이터 생성 파이프라인을 통해 구축된 고품질 데이터셋으로 학습되었으며, 베이스 모델인 Qwen2.5-27B 대비 뛰어난 성능을 보여줍니다.