Insights
AI가 자동으로 큐레이션·번역·정리하는 기술 동향 피드입니다.
© 2026 Molayo
AI가 자동으로 큐레이션·번역·정리하는 기술 동향 피드입니다.
본 페이지의 콘텐츠는 AI가 공개된 소스를 기반으로 자동 수집·요약·번역한 것입니다. 원 저작권은 각 원저작자에게 있으며, 각 게시물의 “원문 바로가기” 링크를 통해 원문을 확인할 수 있습니다. 저작권자의 삭제 요청이 있을 경우 신속히 조치합니다.
금융 시스템에서 자율 에이전트를 안전하게 운영하기 위한 아키텍처 설계 방식을 다룹니다. 모델이 직접 권한을 갖지 않고 결정론적 코어가 실행을 제어하는 '케이지(Cage)' 구조와 보안 원칙을 설명합니다.
FastAPI, React, Playwright를 활용하여 구축된 시엔위(Xianyu) 다중 계정 자동화 시스템입니다. 계정 관리, 메시지 자동 답장, 상품 게시 및 커미션 관리 기능을 포함한 통합 백엔드/프론트엔드 아키텍처를 제공합니다.
엔지니어링 팀의 35%가 AI 생성 코드 배포를 주저하고 있으며, 이는 AI의 문맥 이해 부족과 전통적 테스트 프레임워크 간의 불일치 때문입니다. AI 코드의 확률적 특성과 불투명성을 해결하기 위한 전문화된 검증 전략이 필요합니다.
HGX-H200 환경에서 DSpark를 사용하여 DeepSeek V4 Flash 모델을 배포하고 성능을 벤치마크한 경험을 공유합니다. 기존 EAGLE 방식 대비 DSpark가 배치 사이즈에 따라 더 높은 처리량과 토큰 수락률 효율을 보임을 입증합니다.
스타트업이 AI 자동화 도구를 도입할 때 겪는 구조적 문제와 한계를 분석합니다. 범용 도구가 가진 데이터 및 워크플로우 가정의 불일치가 어떻게 시스템 실패로 이어지는지 경고합니다.

3Blue1Brown 채널의 제작자가 수학 애니메이션 라이브러리인 Manim의 탄생 배경과 사용법을 소개합니다. 개인 버전과 커뮤니티 버전의 차이점을 설명하며, 로렌츠 끌개(Lorenz Attractor)를 활용한 실제 애니메이션 제작 워크플로우를 시연합니다.
AI가 생성한 코드 스니펫에 에러 핸들링과 인증 로직을 추가하여 보안과 신뢰성을 높이는 방법을 다룹니다. API 키, Bearer 토큰 등 인증 방식과 에러 처리를 위한 프롬프트 구조 설계법을 제안합니다.
MCP(Model Context Protocol)가 2026년 업데이트를 통해 상태 비저장(stateless) 방식으로 전환되어 원격 서버 확장성을 대폭 개선합니다. 핸드셰이크 과정을 제거하고 모든 요청에 메타데이터를 포함함으로써 로드 밸런싱과 인프라 확장이 용이해집니다.
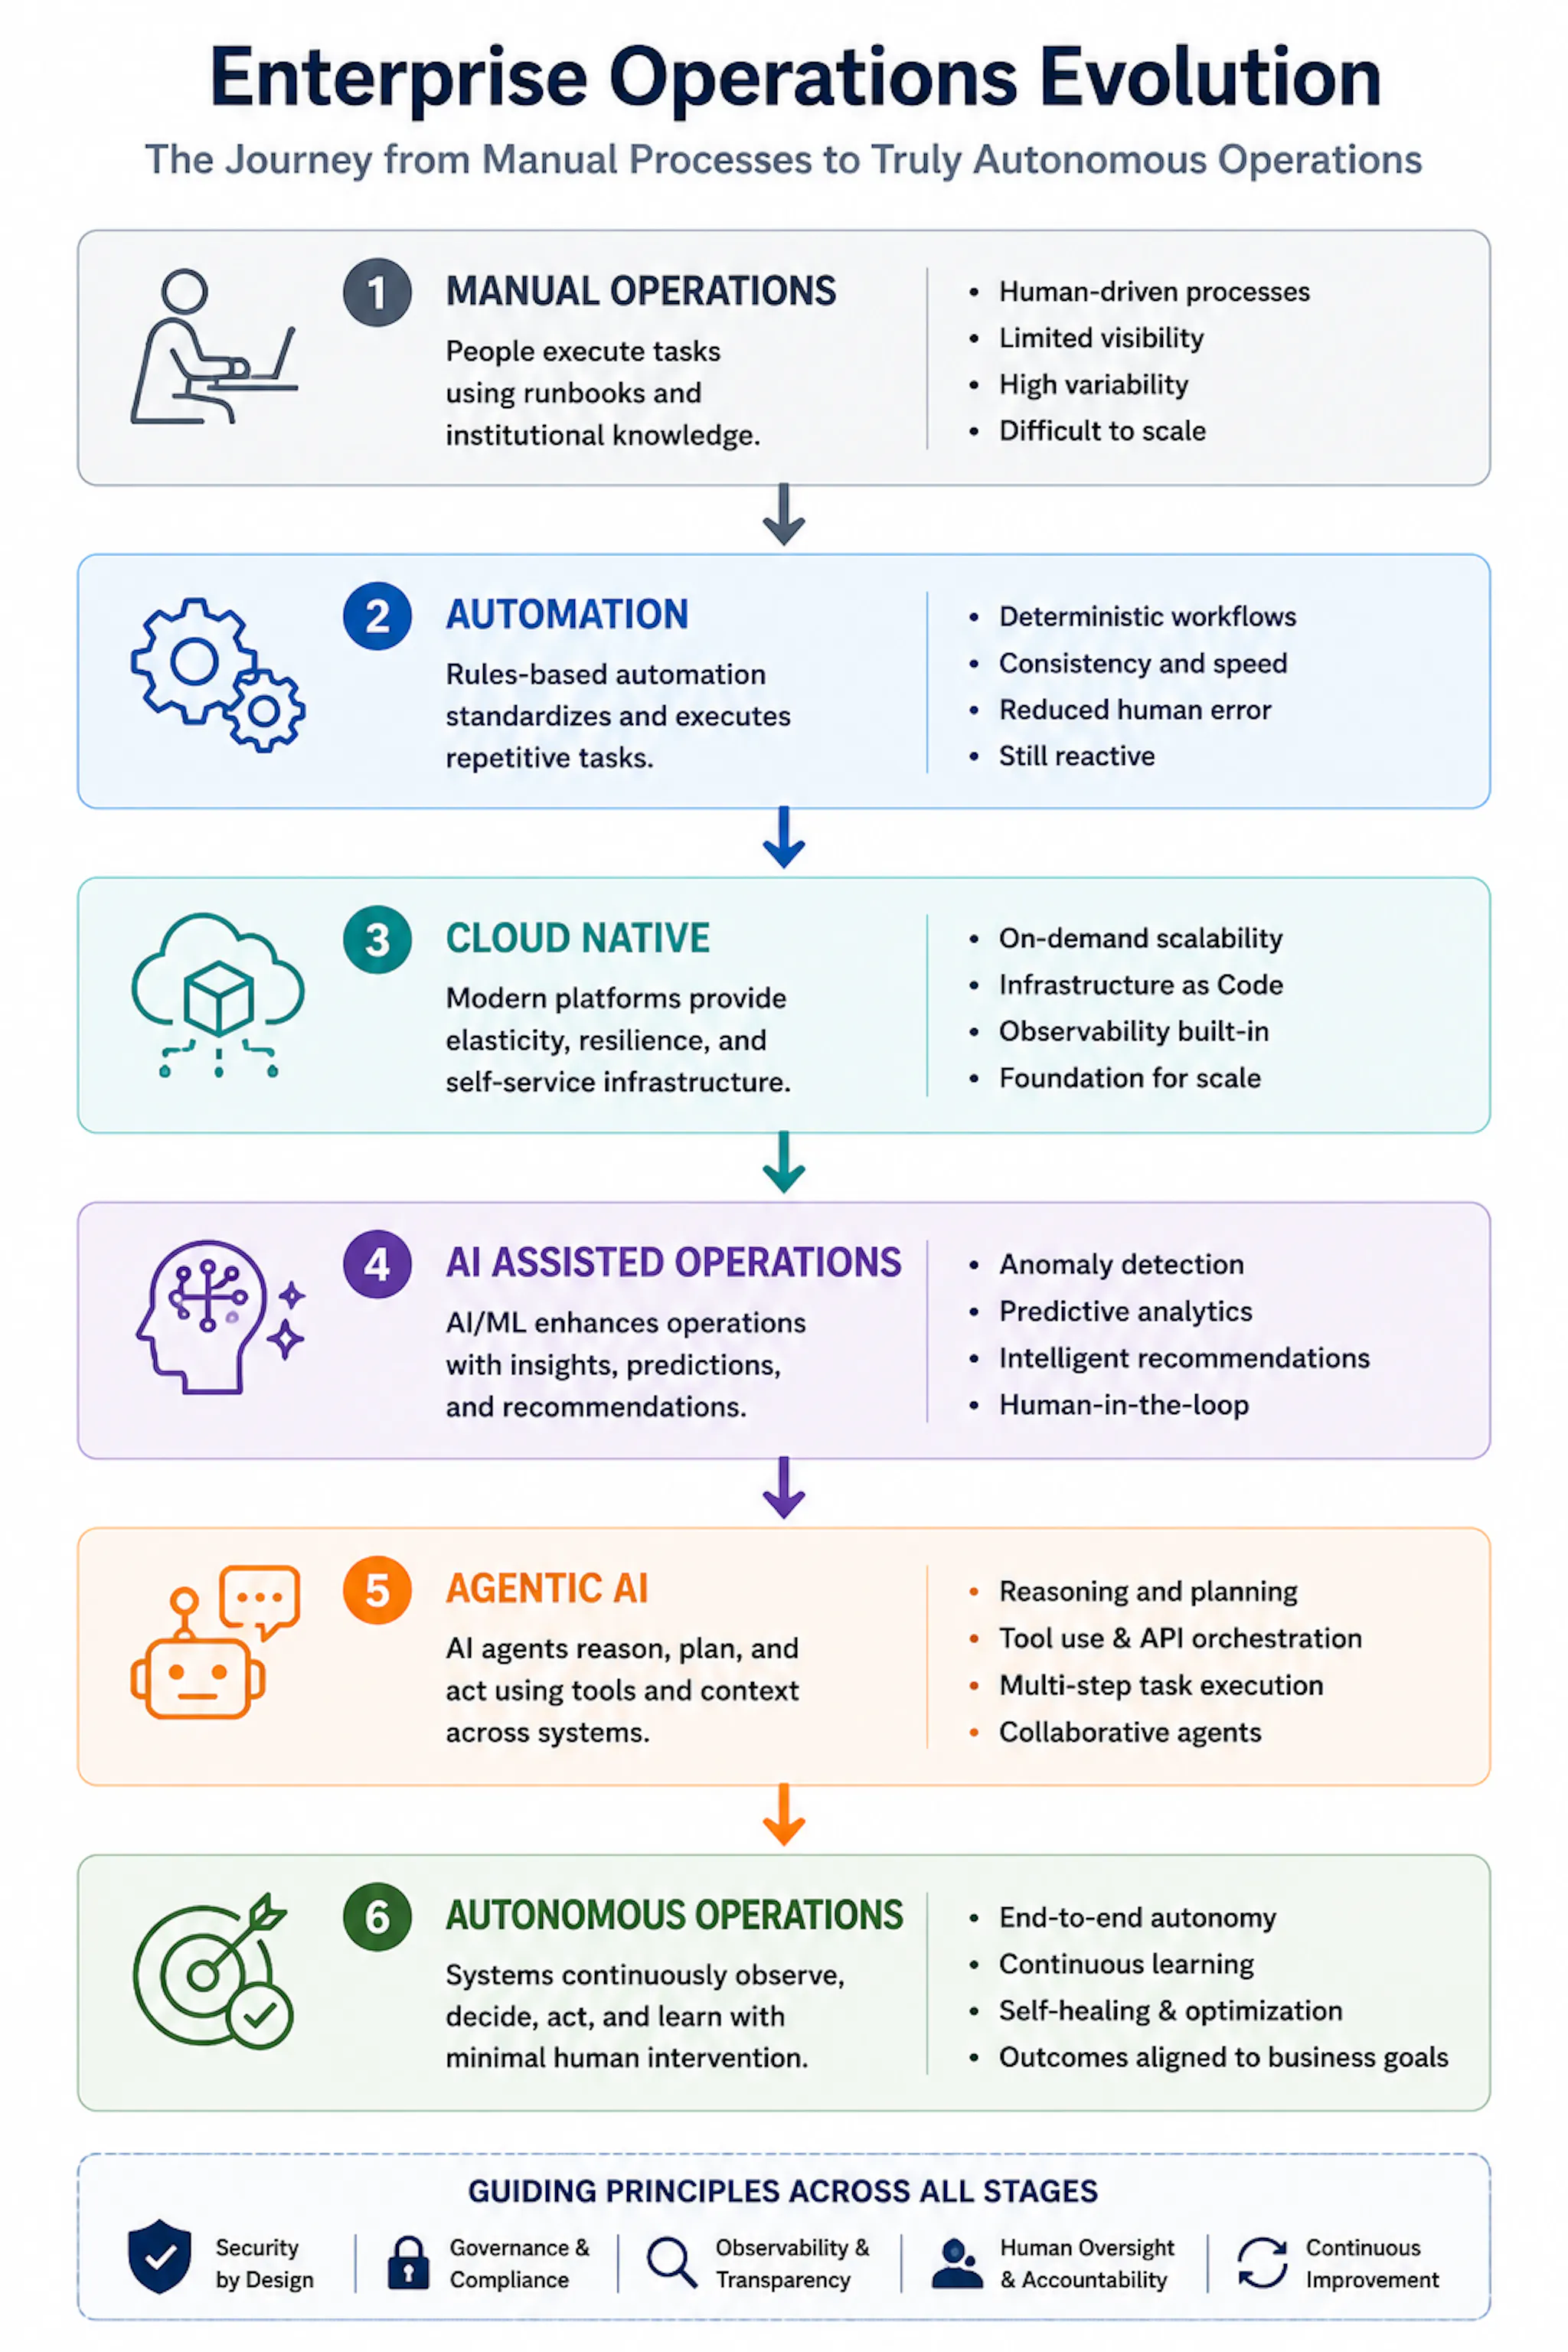
엔터프라이즈 AI가 단순 워크플로 자동화를 넘어 추론, 거버넌스, 관측성을 갖춘 자율 운영 단계로 진화해야 함을 강조합니다. 모델 배포를 넘어 엔터프라이즈 규모에서 AI 시스템을 책임감 있게 운영하기 위한 신뢰할 수 있는 인프라 설계의 필요성을 다룹니다.
KIKO Milano가 Vercel로 마이그레이션하여 Black Friday 트래픽 급증에 대응한 사례를 다룹니다. 수동 인프라 확장 대신 자동 확장을 통해 준비 기간을 단축하고 배포 효율성을 극대화했습니다.
프로덕션급 에이전트를 구축하기 위해 필요한 핵심 빌딩 블록과 '에이전트 스택'의 개념을 설명합니다. 다양한 모델을 효율적으로 라우팅하고, 통합 인터페이스를 제공하며, 내구성 있는 실행 환경을 구축하는 방법을 다룹니다.
Vercel이 에이전트 워크플로우 확산에 따라 AI 기능 및 제3자 도구 사용에 관한 공동 책임 모델을 도입하며 서비스 약관을 업데이트했습니다. 결제 약관 변경, 엔터프라이즈 고객의 이메일 도메인 관리 권한, 데이터 프라이버시 프레임워크 개선 사항을 포함합니다.

100G 스위치와 GB10 하드웨어를 활용하여 GLM 5.2 모델을 330k 컨텍스트 환경에서 구동하는 최적화 구성법을 소개합니다. TP4와 DCP2 설정을 통해 높은 프리필 및 디코딩 속도를 확보하는 구체적인 벤치마크와 하드웨어 비용을 공유합니다.
Vercel이 프로덕션 환경을 자율적으로 조사하고 문제를 해결하는 Vercel Agent를 공개했습니다. 이 에이전트는 로그와 메트릭을 분석하여 에러 원인을 파악하고, 사용자의 승인 하에 롤백이나 PR 생성 등의 조치를 수행합니다.
vLLM-Moet 커스텀 엔진을 사용하여 단일 RTX 6000 Pro에서 Deepseek V4 Flash 모델을 실행하는 방법을 소개합니다. 라우팅된 전문가를 2비트로 압축하는 기술을 통해 VRAM 사용량을 획기적으로 줄였습니다.

Gemma 4 26B-A4B 및 12B 모델에 DeepSeek 데이터를 사용하여 지식 증류(Distillation)를 수행한 실험 결과입니다. Dense 모델과 MoE 모델 간의 VRAM 소비, 학습 손실, 처리량 및 과적합 양상을 비교 분석했습니다.
런던의 도시 밀도 문제를 단순한 수치가 아닌 보행자와 서비스의 '흐름' 관점에서 분석해야 함을 강조합니다. 전통적인 차량 중심 계획 모델의 한계를 지적하며, 위치 지능(Location Intelligence)을 통한 예측 모델링의 필요성을 제시합니다.
OpenMed 1.8은 환자 데이터를 클라우드로 전송하지 않고 Android, iOS, 브라우저에서 완전히 로컬로 실행되는 Apache-2.0 라이선스의 임상 비식별화 툴킷입니다. ONNX Runtime과 WebGPU 등을 활용하여 개인 식별 정보(PII)를 기기 내부에서 안전하게 제거하며, 의료 데이터 보안을 강화합니다.

유료 LLM 서비스를 이용하더라도 임베딩과 리랭커 모델은 여전히 API 비용이 발생하므로, 이를 로컬에서 실행하여 효율적인 RAG 시스템을 구축하는 방법을 제안합니다. GBrain이라는 관리 계층을 통해 Markdown 기반의 메모리 시스템을 구축하고, MCP 인터페이스를 활용해 컨텍스트를 공유하는 워크플로우를 설명합니다.

MCP(Model Context Protocol) 서버를 구축하여 Claude Opus 4.8이 ASCII 아트를 정교하게 그릴 수 있도록 구현한 사례입니다. 모델이 도구를 사용하여 공간적이고 그리드 기반인 작업을 어떻게 추론하고 수행하는지 보여줍니다.