
코드 생성: 데이터베이스 성능의 핵심 영역
요약
본 글은 데이터베이스에서 네이티브 코드 생성을 핵심 기능으로 도입하는 것의 이점을 설명합니다. SQL 쿼리를 네이티브 코드로 컴파일하면 해석적 실행 방식보다 훨씬 빠르고 효율적인 성능을 달성할 수 있습니다. 이는 시스템 전반에 걸쳐 큰 속도 개선과 비용 절감을 가져옵니다.
핵심 포인트
- 네이티브 코드 생성은 데이터베이스의 핵심 성능 향상 요소입니다.
- 컴파일러 기반 접근 방식은 해석적 실행보다 월등히 빠르고 효율적입니다.
- 코드 생성을 일급 시민으로 구현하는 것이 고성능 시스템의 기반을 만듭니다.
이 글은 MemSQL의 아키텍트이자 엔지니어링 매니저인 Drew Paroski가 작성한 게스트 포스팅입니다. 이전에는 Facebook에서 근무했으며, 회사 웹 규모 애플리케이션 전반에 사용되는 인기 있는 실시간 PHP 컴파일러인 HHVM을 개발했습니다.
네이티브 코드 생성을 통해 최대의 소프트웨어 효율성을 달성하는 것은 모든 데이터베이스에 우수한 확장성과 성능을 가져다줄 수 있습니다. 그리고 처음부터 코드 생성을 데이터베이스의 핵심 기능으로 만드는 것은, 소프트웨어 아키텍처와 최종 사용자 경험 전반에 걸쳐 이점을 제공하는 풍부한 속도 개선 기능을 가능하게 합니다.
코드 생성 시스템을 구축하기로 결정했다면, 저희가 이 글에서 자세히 설명할 비용과 이점을 명확하게 이해해야 합니다. 만약 성능이라는 목표를 위해 모든 것을 감수할 의향이 있다면, LLVM 같은 기존 컴파일러 도구와 프레임워크를 검증되고 안정적인 방식으로 활용하여 시간을 절약하는 접근 방식도 상세히 설명합니다.
코드 생성 기본 지식 (Code Generation Basics)
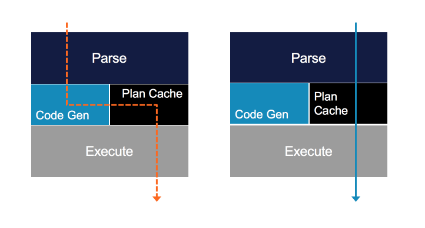
데이터베이스 세계에서 사람이 읽을 수 있는 SQL 쿼리는 네이티브 코드로 컴파일될 수 있으며, 이는 해석적 실행(interpreted execution)의 대안과 비교했을 때 더 빠르고 효율적으로 실행됩니다. 코드 생성은 다음 다이어그램에 나와 있듯이, 네이티브로 컴파일된 쿼리 계획으로 플랜 캐시를 채움으로써 작업을 간소화하는 데 도움을 줍니다. 비록 초기에 시간이 조금 더 걸릴 수 있지만, 데이터베이스에서 쿼리 계획을 네이티브 코드로 컴파일하는 것의 성능 이점은 상당할 수 있습니다.
효율성 및 성능 (Efficiency and Performance)
소프트웨어는 지난 50년간 세계에 영향을 미친 가장 큰 힘 중 하나였으며, 거의 모든 소프트웨어는 컴파일러를 동력으로 합니다. 컴파일러는 소프트웨어의 효율성과 성능에 막대한 영향을 미치며, 심지어 사람들이 소프트웨어를 사용하고 경험하는 방식뿐만 아니라 프로그래머들이 소프트웨어를 개발하는 방식에도 영향을 줍니다.
코드 컴파일에는 정성적(qualitative) 이점과 정량적(quantitative) 이점이 모두 존재합니다:
정성적 이점: 사용자 경험 자체의 가능성을 변화시키는 충분히 큰 실행 성능 차이 <br>
정량적 이점: 실행 효율성 개선은 CPU 및 리소스 사용량을 줄이는 데 도움을 주며, 이는 종종 비용 절감과 수익 증대로 이어집니다.
코드 생성을 일급 시민(First Class Citizen)으로 구현하기
코드 생성을 일급 시민으로 만드는 것은 고성능 소프트웨어 시스템의 기반을 마련합니다. MemSQL 같은 일부 데이터베이스는 코드 생성을 핵심 역량으로 간주하고 출시 초기부터 광범위한 네이티브 컴파일 기능을 보장합니다. 다른 데이터베이스들은 초기 출시 이후에, 보통 부분적인 커버리지로 시작하여 시간이 지남에 따라 확장하면서 코드 생성 지원을 구현합니다.
물론 쿼리 계획(query plans)을 네이티브 코드로 컴파일하지 않고도 다양한 수단을 통해 쿼리 성능을 향상시키는 것이 가능합니다. 하지만 이 대안은 “인터프리터(interpreter)”라는 소프트웨어 계층을 필요로 하며, 인터프리터는 CPU에서 직접 실행되어 SQL 쿼리를 대신하여 낮은 수준의 기계어 명령을 실행하는 역할을 합니다. 소프트웨어를 베어 메탈(bare metal), 컨테이너, 또는 VM에서 실행하든 관계없이, 네이티브 코드를 생성하여 CPU에 직접 전달하는 것은 더 큰 잠재적 성능을 가능하게 합니다.
데이터베이스를 구축할 때 컴파일 우선(compilation-first)의 사고방식을 취한다는 것은 모든 SQL 쿼리 계획을 네이티브 코드로 완전히 컴파일할 수 있다는 것을 의미합니다. 이는 데이터베이스에게 공격적인 입장인데, 코드 생성 지원을 지연시키는 다른 접근 방식들은 종종 기능의 부분 집합에 머무르는 경향이 있기 때문입니다.
디스크가 더 이상 병목 현상이 아닐 때의 데이터베이스 성능
인메모리(in-memory) 데이터베이스의 부상과 함께, 데이터베이스의 성능 환경은 상당히 변화했습니다. 또한 크고 끊임없이 변화하는 데이터셋에 대한 실시간 분석 수요도 증가하고 있습니다. 이러한 발전들은 다루어야 할 새롭고 흥미로운 성능 과제들을 제시합니다.
어떤 소프트웨어 시스템을 최적화할 때, 세 가지 광범위한 영역에 초점을 맞추는 것이 유용합니다:
- 지능형 I/O 스케줄링, 데이터 이동 및 부하 분산
- 개별 머신에서의 메모리 사용량
- CPU에서 실제로 계산이 수행되는 방식
I/O 스케줄링, 데이터 이동 및 부하 분산
많은 애플리케이션의 경우, 지능적인 I/O 스케줄링(I/O scheduling), 데이터 이동(data movement) 및 부하 분산(load balancing)이 성능에 직접적인 영향을 미칩니다. 잘못된 I/O 스케줄링은 애플리케이션을 멈추게 하여 I/O 완료를 기다리는 동안 CPU를 유휴 상태로 만들고, 생산적인 CPU 작업에 사용될 수 있었던 시간을 낭비하게 합니다. 데이터 이동 및 부하 분산에 대한 계획이 미흡하면, 애플리케이션이 귀중한 I/O 대역폭을 불필요하게 낭비하거나 클러스터 내 일부 노드에 과부하를 주는 동시에 다른 노드를 유휴 상태로 만들 수 있습니다. I/O 스케줄링, 데이터 이동 및 부하 분산을 최적화하는 것은 애플리케이션의 지연 시간(latency)을 줄이고 전체 처리량(throughput)을 극대화하는 데 매우 중요합니다.
메모리 사용
메모리 사용은 또 다른 중요한 초점 영역입니다. 현대 하드웨어는 CPU와 같은 다이(die)에 위치한 정교한 다단계 하드웨어 캐시(multi-level hardware caches)를 사용하여 대부분의 경우 번개처럼 빠른 메모리 접근 속도를 달성할 수 있습니다. 하지만 캐시는 제한된 자원이므로, CPU는 여전히 캐시 미스(cache miss)가 발생할 때마다 주기적으로 주 메모리(main memory)에서 읽어와야 합니다. 높은 캐시 미스율은 초당 수백만 번의 '마이크로 정지(micro-stalls)'를 유발하여 애플리케이션 속도를 늦출 수 있으며, 이때 CPU는 메모리에서 값을 검색하기 위해 짧은 시간 동안 유휴 상태가 됩니다. I/O와 마찬가지로, 메모리 사용 및 메모리 접근 패턴을 최적화하는 것은 처리량 증가와 지연 시간 감소 모두에 중요합니다.
CPU 연산
마지막 초점 영역인 CPU에서의 연산 수행 방식은 아마도 가장 명확할 것입니다. 가장 간단한 용어로, 연산을 최적화한다는 것은 필수적인 애플리케이션 기능을 모두 수행하면서도 실행되는 총 CPU 명령어(machine instructions)의 수를 줄이도록 애플리케이션을 변경하는 것을 의미합니다. CPU는 초당 처리할 수 있는 작업량이 제한적이므로, 당연히 CPU 부하를 줄이는 것이 애플리케이션 성능을 극대화합니다.
새로운 과제
전통적인 데이터베이스의 경우, 처리량(throughput)을 극대화하려는 노력은 I/O에 의해 병목 현상이 발생했습니다. 네이티브 코드 생성(native code generation)은 CPU 및 메모리 사용량에 상당한 영향을 미칠 수 있지만, I/O가 제한 요소인 경우에는 CPU와 메모리 사용량을 개선하는 것만으로는 애플리케이션의 최대 잠재 처리량에 큰 영향을 주지 못하는 경우가 많습니다.
메모리에 상주하는 데이터베이스(in-memory databases)에서 더 이상 I/O가 병목 현상이 아니게 되면서, 사용자들은 비즈니스 효율성을 개선하고 실시간 통찰력(real-time insights)을 얻기 위해 데이터베이스 시스템을 극한으로 밀어붙이고 있습니다. 이러한 요구 사항을 지원하기 위해 네이티브 코드 생성에 투자하는 것은 현대적인 고성능 데이터베이스를 구축하는 필수적인 부분이 되었습니다.
컴파일 파이프라인 구축
고품질의 네이티브 코드를 생성하는 컴파일러를 처음부터 구축하는 것은 성과를 보기 전에 엄청난 엔지니어링 노력을 필요로 합니다. 다행히도, 소프트웨어 엔지니어들은 장기적으로 일부 상충 관계(trade-offs)와 한계를 감수하면서도 필요한 초기 작업을 줄이는 여러 기술을 고안해 왔습니다.
‘트랜스파일레이션(transpilation)’ 접근 방식은 일반적인 기법으로, 원하는 소스 언어(예: SQL)를 먼저 두 번째의 고급 또는 중급 프로그래밍 언어(예: Java, C++)로 번역한 다음, 기존 컴파일러를 활용하여 이 두 번째 언어를 네이티브 코드로 변환하는 방식으로 작동합니다. 이 기술의 주목할 만한 예로는 Microsoft SQL Server의 네이티브 컴파일된 저장 프로시저(Hekaton)와 MemSQL의 초기 버전들(MemSQL 5 이전)이 있습니다.
비즈니스의 필요에 따라 트랜스파일레이션(transpilation) 접근 방식이 부과하는 상충 관계와 한계는 결국 새로운 사용 사례를 지원하고 새로운 시장으로 확장하는 데 장애물이 될 수 있습니다. 시간이 지남에 따라 MemSQL의 채택률이 점점 더 크고 다양해지면서, 증가하는 성능 요구 사항을 충족시키기 위해서는 원래의 네이티브 코드 생성 접근 방식을 전면 개편해야 한다는 것이 분명해졌습니다. MemSQL 5 개발 과정에서 기존 컴파일 파이프라인은 LLVM 기반의 새로운 고수준 언어 가상 머신 아키텍처로 대체되었으며, 이로써 자체적인 코드 생성 속도를 20배 향상시키는 동시에 여전히 높은 품질의 네이티브 코드를 생성할 수 있게 되었습니다. 코드 생성 속도의 증가는 방대한 데이터셋을 다루는 몰입적이고 상호작용적인 경험을 만드는 데 중요한 단계였습니다.
새로운 MemSQL 코드 생성 아키텍처
새로운 MemSQL 코드 생성 아키텍처의 내부 세부 사항 중 일부를 간략하게 살펴보겠습니다.
컴파일 파이프라인은 매개변수화된 SQL 쿼리에서 시작합니다. 이 쿼리는 MPL(MemSQL Plan Language)이라는 고수준 명령형 언어로 표현되는 명령형 쿼리 플랜으로 변환되고, 이는 다시 중간 및 저수준 인터미디에이트 언어(각각 MemSQL Bit Code와 LLVM bitcode)로 낮춰지며, 마지막 단계에서는 LLVM을 사용하여 LLVM bitcode를 고품질 네이티브 코드로 변환합니다.
“explain mpl”과 “explain mbc” 명령어는 사용자에게 MemSQL 네이티브 컴파일러가 어떻게 작동하는지 볼 수 있는 몇 가지 내부 검사(introspection) 기능을 제공합니다. 이 컴파일러는 최적의 실행 계획을 지능적으로 선택하기 위해 최선을 다하므로, 일반적으로 사용자가 이러한 내부 세부 사항에 주의를 기울일 필요는 없습니다.
기본 예시
create database db1;
use db1;
create table t (a bigint primary key not null, b bigint not null);
...
explain mpl select a*a + b from t;
위에서 보여준 것처럼, 샘플 SQL 쿼리는 MPL로 작성된 명령형 플랜으로 변환됩니다. “ScanTable” 함수 내부의 “foreach” 블록은 테이블의 모든 행을 순회하며 각 행에 대해 “NetworkProcessFn” 함수를 호출합니다. “NetworkProcessFn”은 각 행에 대해 “a*a+b”를 계산하고, 클라이언트로 전송될 결과를 큐에 넣습니다.
explain mbc select a*a + b from t;
Function 2 <NetworkOutputFn>:
0x0000 Lea local=&local2 local=context i32=8
0x0010 Lea local=&local1 local=local2 i32=0
...
샘플 SQL 쿼리에 대해 생성된 MBC는 MPL과 동일한 명령형 플랜을 보여주지만, 더 크고 복잡한 연산들이 더 작은 단계로 분해되어 있어 더 높은 수준의 디테일을 가집니다. 예를 들어, MPL의 “foreach” 루프는 일련의 낮은 수준의 MBC 명령어(구체적으로 “VSIterHasMore”, “JumpIfTrue”, 및 “JumpIfFalse”) 시퀀스로 변환되었습니다.
쿼리 플랜이 MBC로 변환된 후에는 다음 단계에서 MBC를 LLVM 비트코드(bitcode)로 번역하고, LLVM을 활용하여 이 비트코드를 고품질의 네이티브 코드(native code)로 변환합니다. LLVM이 네이티브 코드를 생성하면, 이를 CPU에 직접 전달하여 실행시킵니다. MemSQL에서 모든 SELECT 쿼리와 모든 데이터 수정 쿼리는 이러한 방식으로 실행됩니다.
첫 등급 코드 생성을 통한 지형 변화
첫 등급 코드 생성을 통한 지형 변화
고성능 데이터베이스를 첫 등급 코드 생성(first class code generation)을 통해 구축하는 것은 이전에 불가능했던 새롭고 질적으로 다른 사용자 경험을 가능하게 합니다. 산업 전반에 걸쳐 개인화, 위험 관리, 이상 감지, 청구(billing), 공급망 최적화와 같은 영역은 향상된 데이터베이스 성능으로부터 이점을 얻을 수 있습니다. 실시간 비즈니스 분석은 기업이 빠르게 변화하는 데이터 세트에 대한 임시(ad hoc) 및 지속적인 쿼리를 통해 운영 현황을 즉각적으로 파악할 수 있게 합니다. 이는 명령줄에서 수동으로 수행하거나 Tableau 또는 Zoomdata와 같은 시각화 도구를 통해 수행될 수 있습니다.
가장 중요한 점은, 네이티브 코드 생성(native code generation)을 통해 얻는 빠른 성능이 개발자가 이전에 애플리케이션에 통합하기 어려웠던 정교한 기능들을 작성할 수 있도록 한다는 것입니다. 예를 들어, 쿼리 계산에 몇 분이 걸린다면 그 라이브 쿼리 결과를 애플리케이션에 포함시키는 것은 불가능합니다. 하지만 1초 이내에 반환되는 결과는 인터랙티브 애플리케이션에 실시간으로 제시될 수 있습니다. 이는 최종 사용자에게 적절한 콘텐츠, 전자상거래 품목 또는 광고를 제공하는 것부터 실시간 모니터링을 통한 사기 경고(fraud alerts)까지 다양할 수 있습니다.
네이티브로 컴파일된 함수를 통한 나아갈 길
네이티브 코드 생성에 적극적인 입장을 취하는 것은 데이터 처리의 한계를 밀어붙이는 성능 기반을 마련합니다. 광범위한 네이티브 컴파일 기능(native compilation capabilities)은 현대 인메모리 데이터베이스 시스템(in-memory database systems)의 효율성을 극대화하는 데 필수적입니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 HN OpenAI Codex의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기