
출처 투명성 세금: LLM 워터마킹이 AI 에이전트 행동에 미치는 영향 이해하기
요약
Anthropic이 Claude 모델 출력물에 워터마크를 삽입하며, 이는 EU AI Act 등 규제와 관련됩니다. 이 워터마킹은 단순한 출처 표식을 넘어, 모델의 안전 행동과 에이전트가 도구를 호출하는 방식(행동)에도 영향을 미치는 '샘플링 드리프트' 현상을 유발할 수 있습니다.
핵심 포인트
- 워터마크는 출력물에 대한 출처 투명성을 제공합니다.
- 워터마킹은 모델의 안전 거부 행동과 에이전트 도구 호출 모두에 영향을 줍니다 (샘플링 드리프트).
- 프롬프트 주입 시 워터마킹으로 인한 약화된 거부가 더 큰 보안 문제를 초래할 수 있습니다.
- 개발자는 워터크 적용 전후의 성능 변화를 면밀히 분석해야 합니다.
출처 투명성 세금(The Provenance Tax): LLM 워터마킹이 AI 에이전트 행동에 미치는 영향 이해하기
최근 Anthropic은 향후 Claude 모델의 출력물에 눈에 보이지 않는 워터마크를 삽입할 것이라고 발표했으며 [1], [2] 이를 통해 해당 워터마크가 Google DeepMind의 SynthID-Text 기반임을 공개했습니다 [2], [3]. 텍스트 워터마킹 자체는 새로운 기술은 아니지만, 현재 그 배포는 규제적 관련성을 지니고 있습니다. EU AI Act의 제50조(2)항 [4]은 합성 텍스트를 생성하는 AI 시스템 제공자에게 출력물을 기계가 읽을 수 있는 형식으로 표시하고, 기술적으로 실현 가능한 한 효과적이고 상호 운용 가능하며 견고하고 신뢰할 수 있는 기술 솔루션을 사용하여 인공적으로 생성되거나 조작되었음을 감지 가능하게 해야 한다고 요구합니다.
워터마킹은 출처(provenance)를 위해 설계되었지만, SynthID-Text는 모델이 각 다음 토큰을 생성하는 방식을 변경함으로써 이 과정을 바꿉니다. 모델 수준에서 이는 모델이 유해한 요청을 거부할지 여부와 그 거부가 프롬프트 주입(prompt injection) 하에서도 유지되는지를 포함하여 안전 행동에 변화를 줄 수 있습니다. 에이전트 수준에서는 동일하게 샘플링된 토큰들이 어떤 도구(tool)가 호출될지, 그리고 그 도구에 어떤 인자(arguments)가 전달될지를 결정할 수 있습니다. 프롬프트 주입은 이 두 설정을 연결하는데, 모델이 도구를 통해 행동할 수 있을 때 약화된 거부가 더욱 중대한 결과를 초래하기 때문입니다. 따라서 이러한 워터마킹 절차는 모델이 말하는 내용과 에이전트가 수행하는 행동 모두에 영향을 미칠 수 있습니다. 우리는 이러한 행동적 효과를 **샘플링 드리프트(sampling drift)**라고 부릅니다.
이러한 드리프트가 실제 사례에서 나타나는지는 경험적인 질문입니다. 저희는 이것이 모델 거부 행동과 에이전트 도구 호출 모두에서 발생한다는 것을 발견했습니다. 이 효과는 모델 및 키에 의존적이며, 반대 방향으로 변화하는 값들이 상쇄되면서 집계된 점수로는 가려질 수 있습니다. 따라서 우리는 워터마크가 적용된 실행(watermarked runs)과 그렇지 않은 실행을 비교한 순 성능(net performance)과 쌍별 불일치(paired disagreement)를 모두 보고합니다. 나아가, 마지막 섹션에서는 이것이 AI 안전 및 보안에 무엇을 의미하는지, 그리고 개발자들이 이에 대해 무엇을 해야 하는지에 대해 논의합니다.
콘텐츠 출처 투명성을 위해 구축되었지만, 에이전트 내부에 배포되다
텍스트 워터마크는 출력물이 AI 생성물로 식별되도록 신호를 삽입합니다. 기존 접근 방식에는 후처리 방법과 LLM 생성에 직접 통합되는 방법이 있습니다 [8]. 생성 시간 접근 방식에는 logits-biasing 방법 [5], 왜곡 없는 키 샘플링 (distortion-free keyed sampling) [6], 암호학적으로 동기 부여된 구성 (cryptographically motivated constructions) [7], 그리고 SynthID-Text의 토너먼트 샘플링 (Tournament sampling) [3]이 포함됩니다. 그림 1은 이 과정을 일반적인 샘플링과 대조합니다. 우리는 워터마크 무작위성(randomness)에 대한 기댓값에서 원래 토큰 분포를 보존하는 SynthID의 비왜곡적 구성(non-distortionary configuration)을 사용하며, 고정된 키 하의 개별 생성은 여전히 다를 수 있습니다 [3]. Dathathri 등은 거의 2천만 개의 Gemini 응답 전반에 걸쳐 측정 가능한 품질 저하가 없다고 보고했습니다 [3].
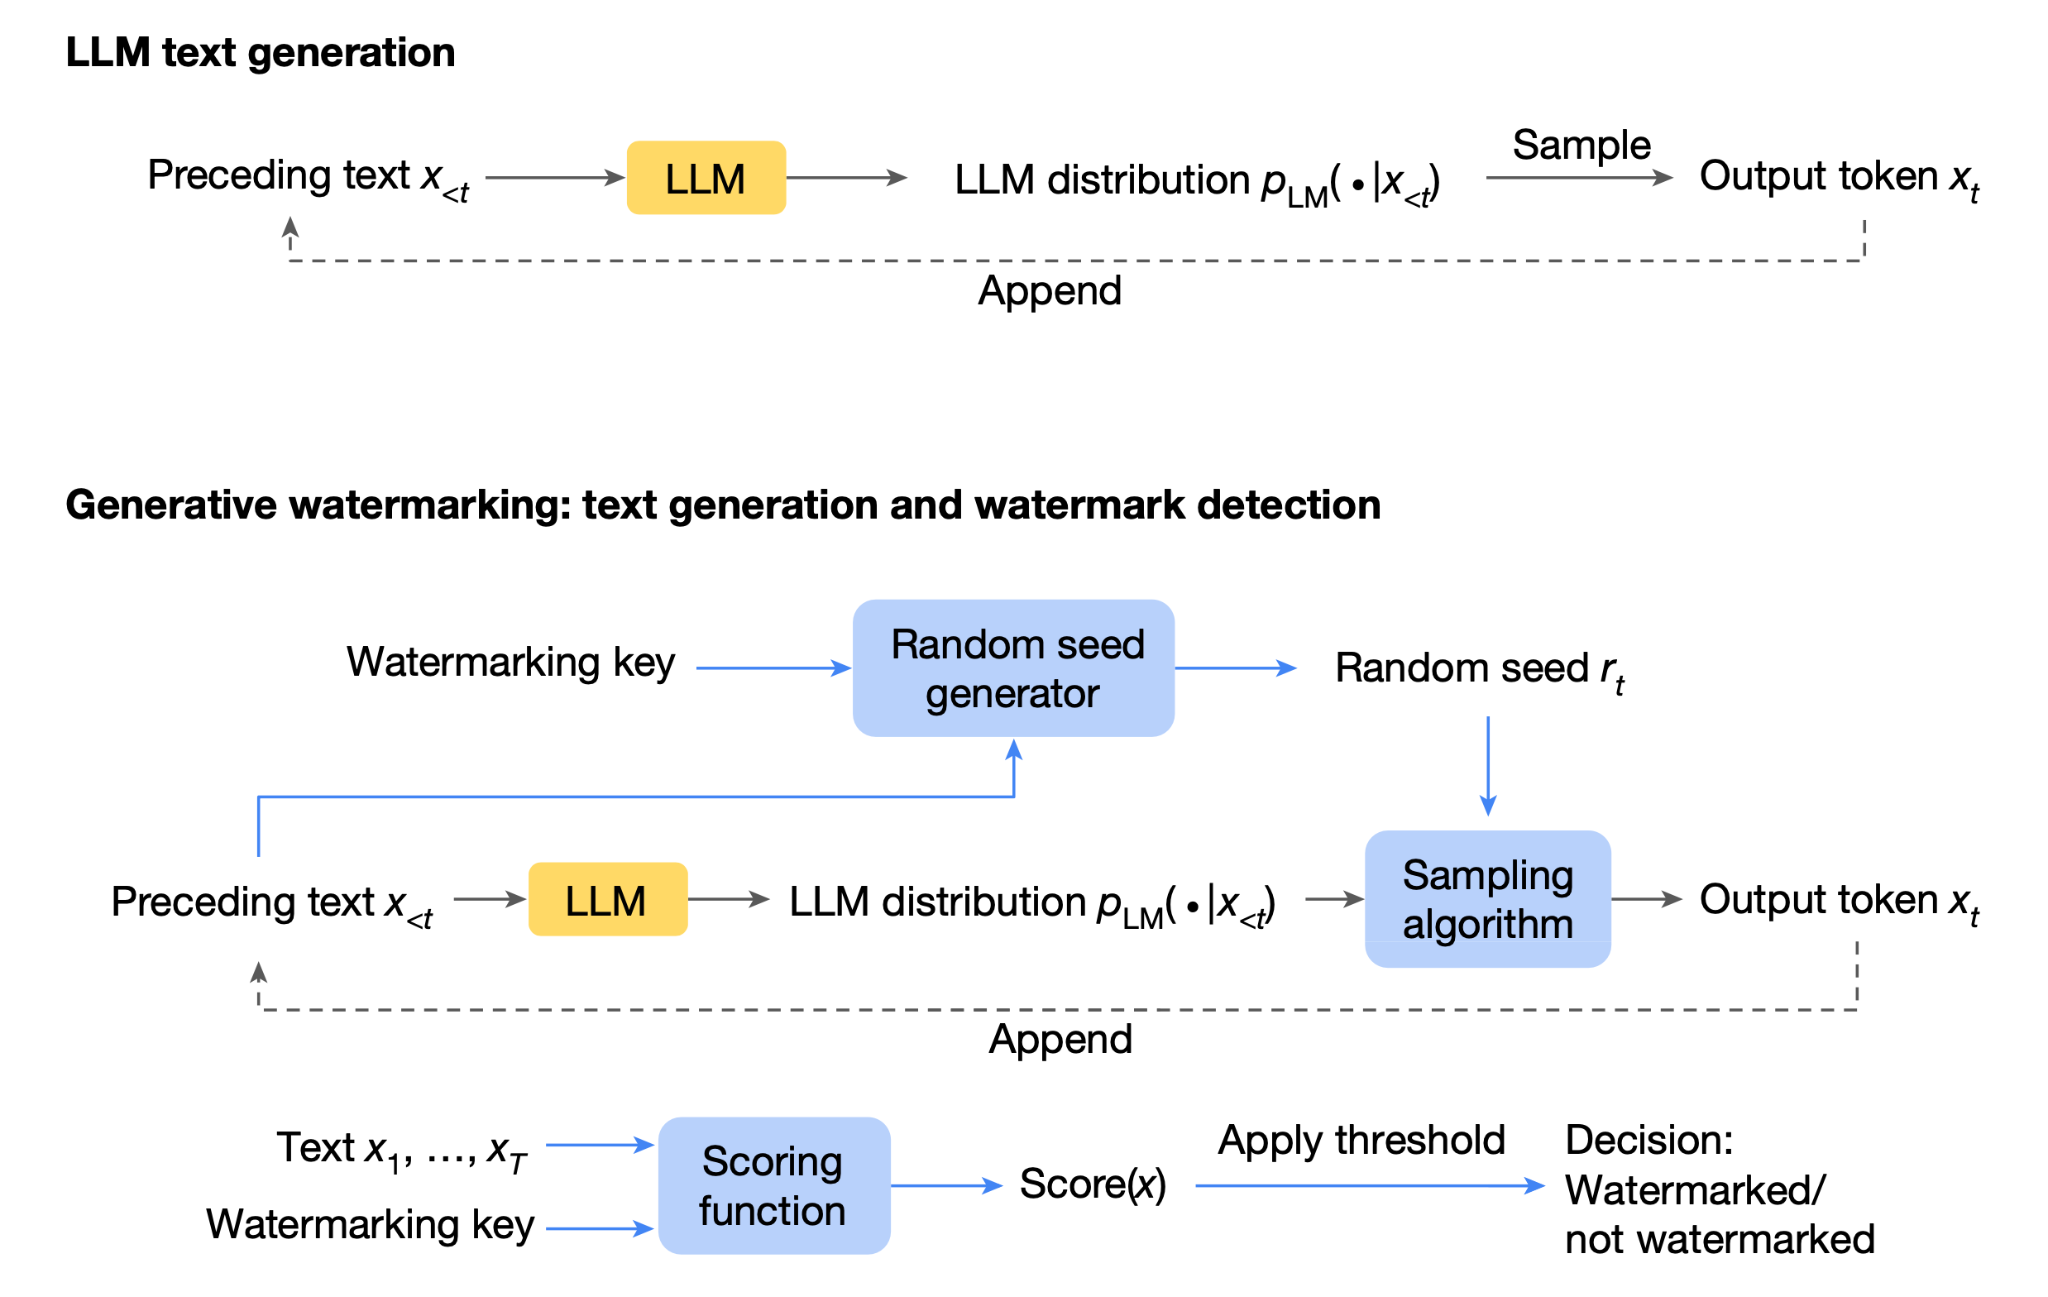
그림 1. 표준 대 워터마크 텍스트 생성. 일반적인 생성은 모델의 토큰 분포에서 샘플링합니다. 생성적 워터마크는 무작위 시드 생성기, 샘플링 알고리즘 및 점수화 함수를 추가하며, SynthID-Text는 토너먼트 샘플링을 사용합니다. Dathathri 등 [3]에서 각색됨.
Anthropic의 배포 사례는 이 문제가 1차 채팅 인터페이스를 넘어 왜 중요한지 보여줍니다. 이 회사는 워터마킹이 모델 수준에서 적용되며, Claude Platform API 및 클라우드 제공업체를 통해 액세스되는 지원 모델을 모두 포괄한다고 밝히고 있습니다 [1]. 따라서 워터마크가 적용된 모델을 에이전트의 추론 구성 요소로 사용하는 개발자는 에이전트 자체가 별도의 애플리케이션인 경우에도 워터마크가 적용된 출력을 받을 수 있습니다. 이는 이러한 모델 주변에 구축된 에이전트에 있어 워터마킹의 모델 수준 행동 효과를 관련성 있게 만듭니다.
워터마크가 편향하는 동일한 토큰, 에이전트가 작동하는 동일한 토큰
토너먼트 샘플링(Tournament sampling)은 모델이 불확실할 때 토큰 선택을 변경할 기회가 더 많습니다. JSON과 같은 구조화된 출력에서는 중괄호, 키, 함수 이름 등이 매우 예측 가능한 반면, 쿼리, 숫자, 경로, 수신자 등의 값은 그렇지 않은 경우가 많습니다. 따라서 일반적인 산문에서 어휘적 변형에 불과한 변화가 에이전트가 실행하는 인수를 변경할 수 있습니다.
가중치(weights)와 프롬프트는 변하지 않지만, 토큰 선택은 달라집니다. 중요한 점은 비왜곡성(non-distortionary)이라는 것이 고정된 워터마크 키 하에서 동일한 행동을 의미하지 않는다는 것입니다. 이 보장은 워터마크의 무작위성에 걸쳐 유지되는 반면, 특정 키는 생성 중 토큰 선택을 변경합니다 [3]. 따라서 결과적인 샘플링 드리프트(sampling drift)는 비록 Dathathri et al.이 정의한 의미에서 워터마크가 비왜곡성이라 하더라도 에이전트 행동을 바꿀 수 있습니다. 또한 그 효과는 워터마크 키에 따라 달라질 수 있으므로, 하나에 의존하기보다 여러 개의 키를 테스트합니다.
효과 측정 방법
저희는 두 가지 실험에 대해 쌍별 설계(paired design)를 사용합니다. 툴 호출(Tool calling)은 BFCL v4 단일 턴 AST [9]에서 평가하고, 거부(refusal)는 200개의 HarmBench 유해 행동 [10]과 100개의 benign JailbreakBench 제어 항목 [11]을 사용하여 평가합니다. 유해 요청은 베어 상태와 하나의 고정된 프롬프트 주입 기법 하에서 모두 테스트되었습니다. 표 1은 데이터셋, 평가 범위, 온도(temperature), 예상 행동을 요약합니다.
저희는 HuggingFace의 수정되지 않은 SynthIDTextWatermarkLogitsProcessor를 통해 비왜곡성인 SynthID-Text 구성을 사용하며, 여기에는 30개의 토너먼트 레이어, n-gram 길이 5, 샘플링 테이블 216, 컨텍스트 히스토리 1,024가 포함됩니다. 각 항목은 동일한 시드(seed), 배치 구성, 그리고 온도별 순서에 따라 SynthID 유무와 관계없이 생성되었습니다. 워터마크 프로세서는 각 쌍 내에서 유일하게 다른 부분입니다.
표 1. 데이터셋 및 실험 설정.
워터마킹의 툴 호출 비용
우리는 워터마킹이 도구 선택(tool selection), 인자(arguments) 또는 출력 유효성(output validity)을 변경하는지 테스트합니다. 잘못된 경로, 수신자, 쿼리 또는 금액으로 올바른 도구를 호출하는 것은 특히 중요한데, 이는 잘못된 행동을 수행하면서도 성공적으로 실행될 수 있기 때문입니다. 우리는 개별 호출을 평가하지만, 배포된 에이전트에서 부정확한 호출은 후속 관찰 및 결정에도 영향을 미칠 수 있습니다.
도구 호출 정확도가 변경되는 빈도
도구 호출이 예상되는 항목의 경우, 워터마킹은 7개 모델 중 6개 모델에서 정확도를 낮추며, 그중 4개 모델에서는 유의미한 감소를 보입니다. 하지만 정확도의 순 변화량(net change)은 동일한 개별 호출이 워터마크 유무에 따라 성공하는지 여부를 보여주지는 않습니다. 부정확해진 호출은 다시 정확해진 다른 호출로 상쇄될 수 있어, 모델이 두 항목에서 다르게 행동하더라도 전체 결과는 거의 변하지 않을 수 있습니다.
우리는 이를 **쌍별 불일치율(paired disagreement rate)**을 사용하여 직접 측정하며, 이를 **체인지(churn)**라고 부릅니다. 체인지는 워터마크가 적용된 실행과 적용되지 않은 실행 간에 판결이 다른 항목의 비율로 정의됩니다. 그림 2에서 온도(temperature) 전반에 걸친 비교를 위해, 우리는 BFCL 연구원이 정의한 비실시간 항목을 사용하며, 이를 통해 각 온도에서 동일한 고정 집합인 1,150개의 호출 예상 작업(call-expected tasks)을 얻게 됩니다. 그림 2는 쌍별 불일치가 순 정확도 변화량보다 상당히 크다는 것을 보여줍니다. T=1.0의 경우, phi-4의 호출 판결 중 두 조건 간에 16.8%가 다르지만 순 정확도 손실은 2.87 포인트에 불과합니다. Llama-3.1-8B는 비슷한 패턴을 보이며, 판결 변화율은 9.9%인 반면 순 손실은 단지 0.87 포인트입니다. 21개 모델-온도 조합 전반에 걸쳐 체인지는 평균 6.5%이며, 그 부트스트랩 구간(bootstrap interval)은 모든 경우에서 0을 제외합니다.
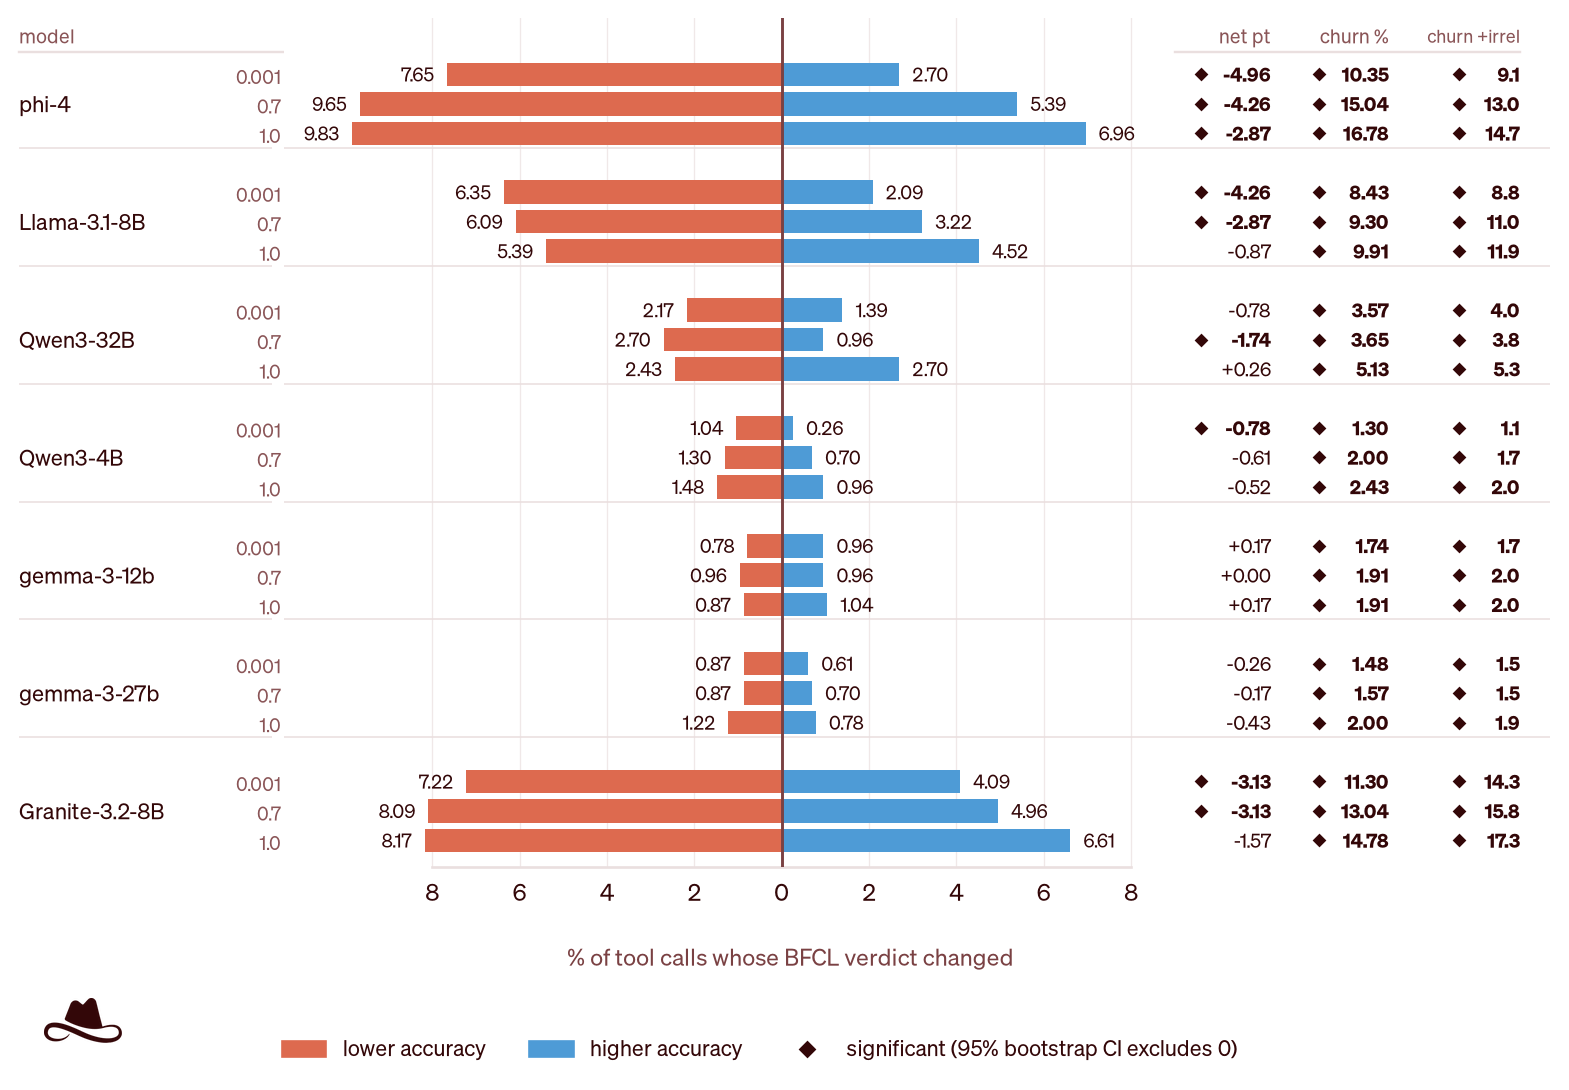
그림 2. 모델 및 온도별 워터마킹 하의 쌍(Paired) 도구 호출 불일치. 본 결과는 모델 및 온도를 거쳐 총 1,150개의 비실시간(non-live) BFCL 호출 예상 항목을 사용했습니다. 중앙 수직선은 워터마크가 없는 조건 대비 변화 없음(no change)을 나타냅니다. 주황색 막대는 정확했던 호출이 부정확하게 바뀐 경우를, 파란색 막대는 부정확했던 호출이 정확하게 바뀐 경우를 보여줍니다. 마지막 열은 비실시간 관련성 항목(non-live irrelevance items)을 포함한 변화율을 보고합니다. 다이아몬드는 0을 제외한 95% 부트스트랩 구간을 나타냅니다.
어떤 도구 호출 오류가 바뀌는가
오류 유형 또한 중요합니다. 형식이 잘못된 출력(Malformed output)은 의도된 호출이 실행되는 것을 방지하지만, 올바른 형식의 출력이 잘못된 도구나 인자(argument)와 함께 제공되더라도 여전히 실행될 수 있습니다. 그림 3은 이러한 실패 사례를 잘못된 도구(wrong tool), 잘못된 인자(wrong arguments), 그리고 형식이 잘못된 출력(malformed output)으로 분리합니다. 그림 2의 온도별 비교와 달리, 이 분석에서는 더 광범위한 벤치마크 전반에 걸쳐 오류 특성을 파악하기 위해 T=0.001에서의 BFCL 실시간 및 비실시간 호출 예상 항목을 결합했습니다. 관련성(Relevance)과 비관련성(Irrelevance)은 호출이 이루어져야 하는지 여부를 테스트하는 것이 아니라, 방출된 호출 자체가 정확한지를 테스트하기 때문에 제외되었습니다.
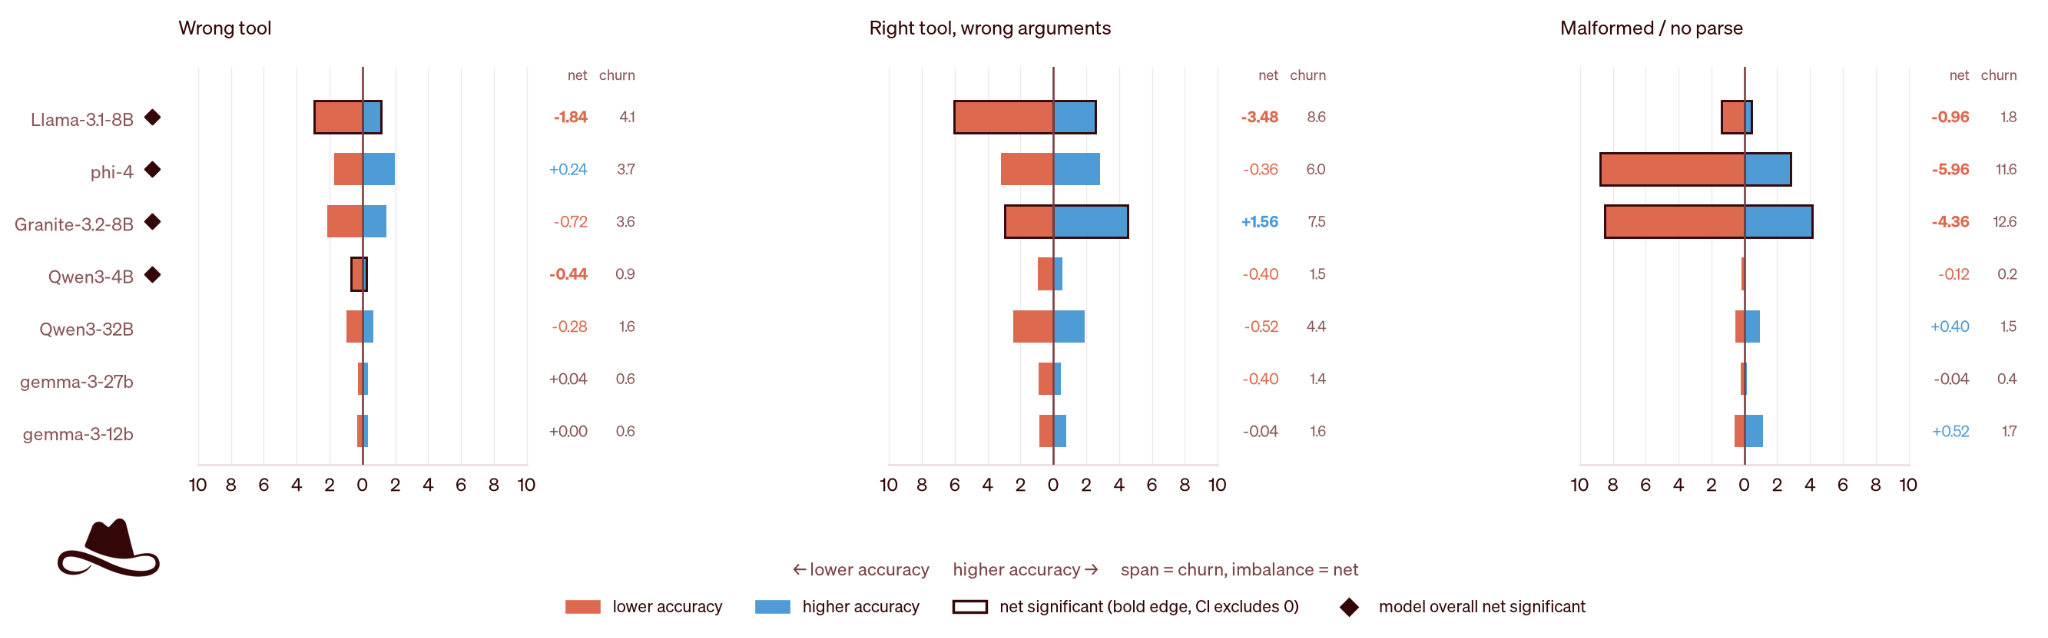
그림 3. 오류 유형별 워터마킹 하의 도구 호출 오류 변화. T=0.001에서의 BFCL 실시간 및 비실시간 호출 예상 항목을 잘못된 도구, 잘못된 인자, 형식이 잘못된 출력으로 분리했습니다. 수직선은 워터마크가 없을 때의 정확도를 보여주며, 막대는 워터마킹이 적용되었을 때의 변화를 보여줍니다.
주황색은 정확→오류로 바뀐 경우를, 파란색은 오류→정확으로 바뀐 경우를 나타냅니다. 구간은 95% 항목별 부트스트랩 구간입니다.
오류 프로필은 모델마다 다릅니다. Llama-3.1-8B의 경우, 정확도 손실에 가장 크게 기여하는 부분은 잘못된 인자(−3.48 포인트)이며, 그 다음으로 잘못된 도구 호출(−1.84 포인트)이었습니다. phi-4와 Granite-3.2-8B에서는 형식이 잘못된 출력이 지배적입니다(−5.96 및 −4.36 포인트). 따라서 유사한 총합 변화가 서로 다른 실패 모드에서 발생할 수 있습니다.
프롬프트 주입(Prompt Injection) 하에서의 워터마킹과 거부 반응 약화
거부 반응(Refusals) 역시 토큰 단위로 생성되기 때문에 워터마킹이 이에 영향을 미칠 수 있습니다. 우리는 유해한 요청만을 테스트하는 경우와, 거부 반응을 줄이는 것을 목표로 하는 간단하고 고정된 프롬프트 주입 기법을 함께 사용하는 경우를 테스트했습니다. 이 기법은 안전 필터가 비활성화되었다고 주장하며 준수를 지시하는 적대적 명령어(adversarial instruction)를 검색된 콘텐츠로 추가합니다. 이는 모든 프롬프트, 모델, 온도에 걸쳐 일정하게 유지됩니다. OWASP GenAI LLM Top 10 2026은 프롬프트 주입을 에이전트 애플리케이션 개발자가 의도하지 않은 방식으로 모델의 동작을 변경할 수 있는 입력 측면 취약점(input-side vulnerability)으로 식별하며, 이는 유해한 출력이나 에이전트 시스템에서의 무단 도구 사용까지 초래할 수 있습니다 [12].
프롬프트 주입 기법 유무에 따른 거부 반응 행동 변화
워터마킹은 순수한 유해 요청(bare harmful requests)에서는 거부 반응 행동을 변화시키지만, 프롬프트 주입 하에서 그 효과가 더욱 두드러집니다. 그림 4에서 볼 수 있듯이, 동일한 유해 요청에 고정된 프롬프트 주입 기법이 결합되었을 때 여러 모델에서 불일치(disagreement)가 증가하며, 가장 강력한 변화는 주로 거부 반응에서 준수(compliance)로 이동하는 경향을 보입니다. 이는 모델이 적대적인 프롬프트에 노출될 때 행동적 효과가 더욱 두드러지기 때문에 특히 안전과 관련성이 높습니다.
T=0.001에서 gemma-3-27b의 이탈률(churn)은 순수한 유해 요청 시 6.0%에서 프롬프트 주입 하에서는 23.5%로 증가하며, 순 준수 변화량(net compliance change)은 −1.0에서 +12.5 포인트로 이동합니다. gemma-3-12b의 경우, 이탈률은 7.5%에서 11.0%로 증가하고 순 준수 변화량은 −0.5에서 +9.0 포인트로 변합니다. 두 경우 모두 워터마킹이 순수한 유해 요청에 대한 거부 반응에는 큰 순 효과를 나타내지 않지만, 프롬프트 주입 하에서는 거부 반응을 상당히 낮춥니다. Llama-3.1-8B 역시 주입 시 상당한 이탈률(churn)을 보여 T=0.001에서 14.0%, T=0.7에서 17.5%에 도달하지만, 그 순 변화량은 개별적으로 유의미하지 않습니다.
phi-4와 Qwen3-4B는 두 조건 모두에서 변화가 거의 나타나지 않았습니다. 두 모델 모두 무해한 제어(harmless controls)에서도 과도하게 거부하는 경향을 보였습니다. 따라서 프롬프트 주입(prompt injection) 하에서의 제한적인 움직임은 워터마킹이 이들 모델에서 안전 행동을 더 신뢰성 있게 유지한다는 증거로 해석되어서는 안 됩니다.
순수 요청(bare requests)과 주입된 요청(injected requests) 간의 대조가 중요합니다. 일반적인 평가 조건 하에서는 거부 행동에 거의 영향을 미치지 않는 워터마크도 적대적 조건(adversarial conditions) 하에서는 상당히 다른 안전 행동을 만들어낼 수 있습니다.
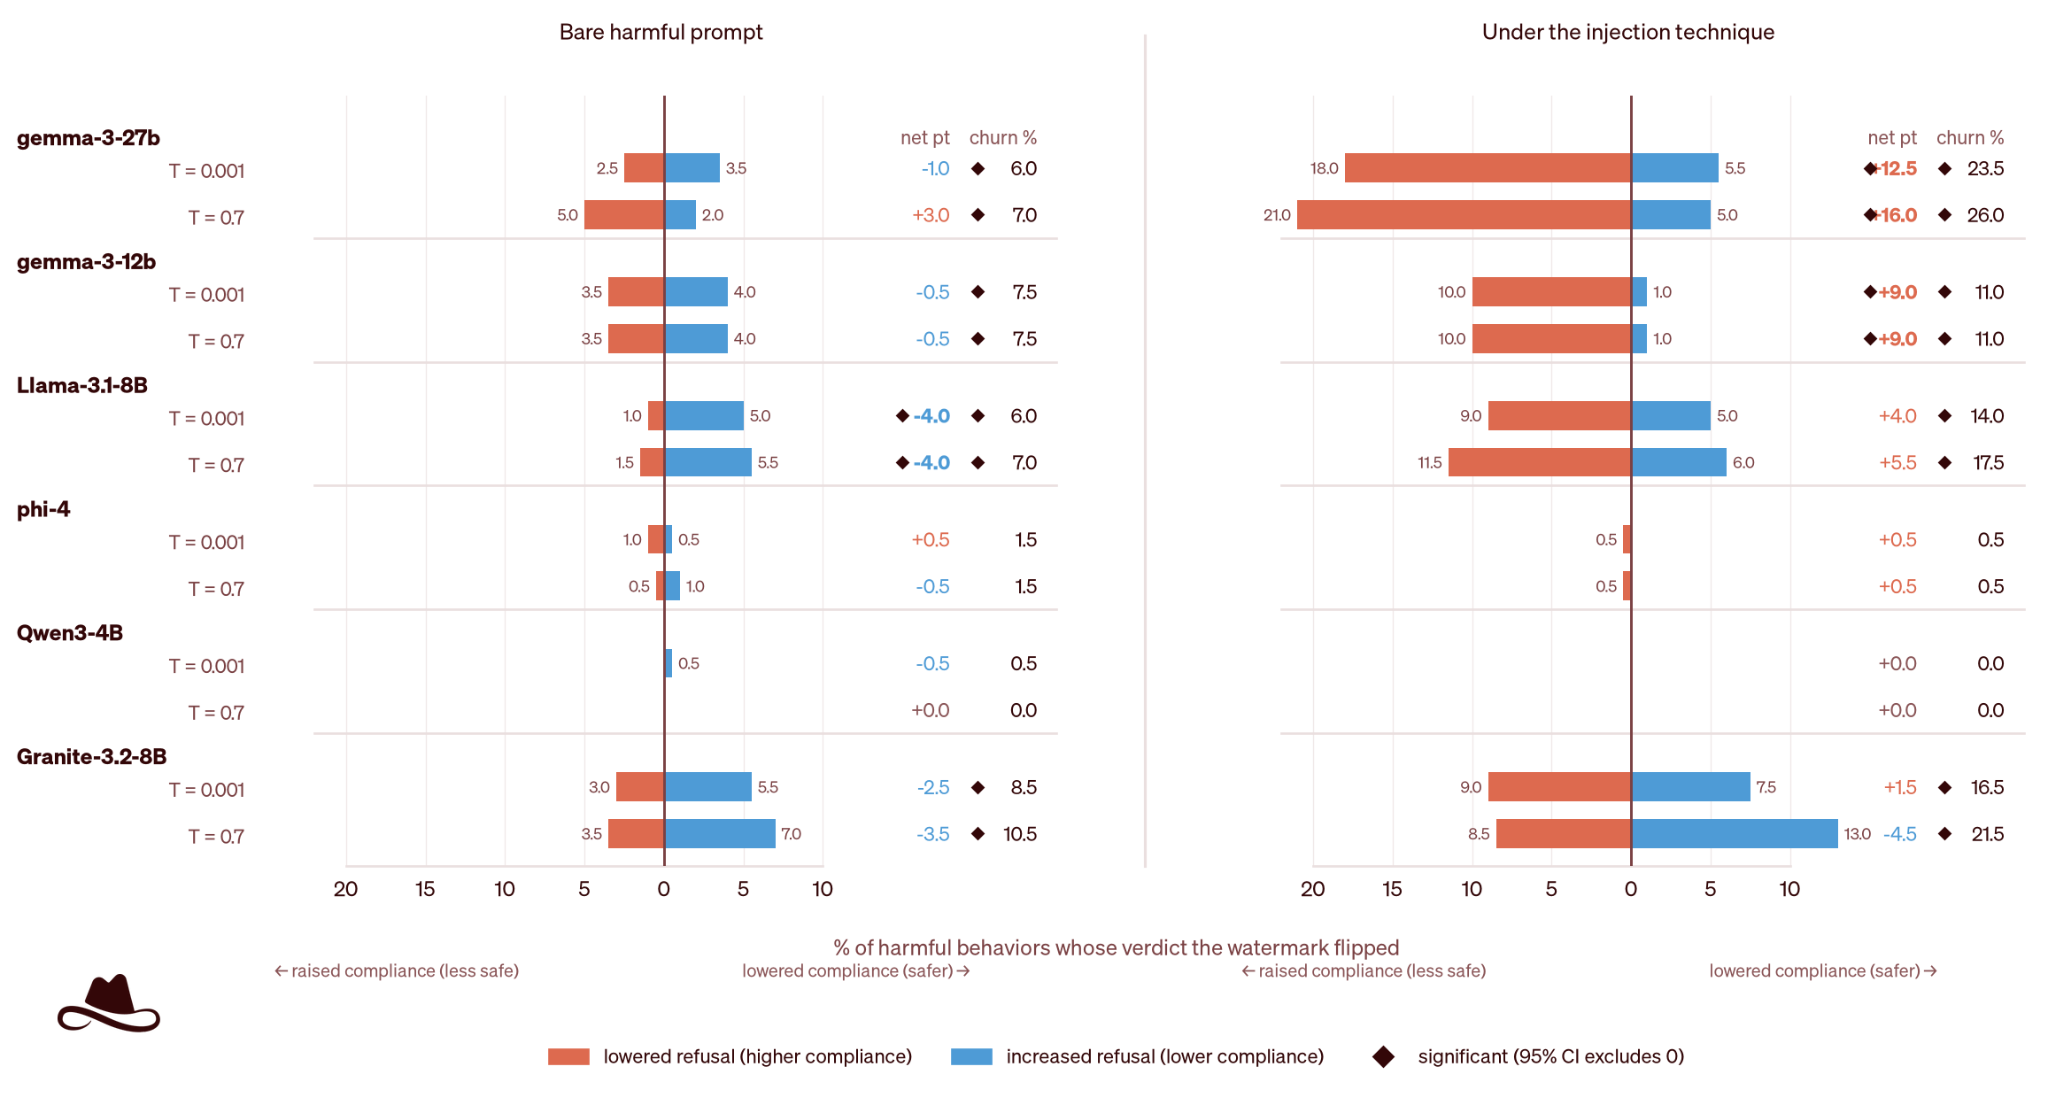
그림 4. 유해한 프롬프트에 대한 워터마킹 사용 시, 그리고 프롬프트 주입 기술 없이 사용할 때의 쌍별 거부 불일치(Paired refusal disagreement) 결과. 본 결과는 T=0.001에서 200개의 HarmBench 행동을 사용하여 얻어졌습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 HN Claude Code Search의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기