
장기적으로 Nvidia NVSwitch는 대규모 확장 AI 네트워크의 InfiniBand이다
요약
본 기사는 과거 컴퓨팅 I/O 버스 경쟁사였던 InfiniBand와 현재 AI 클러스터 네트워킹의 핵심인 Nvidia NVSwitch를 비교 분석합니다. 특히, 이더넷 컨소시엄이 낮은 지연 시간과 높은 대역폭을 가진 InfiniBand의 장점을 이더넷의 확장성 및 멀티테넌시 기능과 결합하여 AI 클러스터를 위한 차세대 네트워크를 구축하는 방향성을 제시하고 있습니다.
핵심 포인트
- Nvidia NVSwitch는 대규모 AI 네트워크에서 핵심적인 역할을 수행합니다.
- InfiniBand와 이더넷은 오랜 경쟁을 거쳐 새로운 형태로 통합되고 있습니다.
- Ultra Ethernet Consortium은 InfiniBand의 성능과 이더넷의 확장성을 결합하는 것을 목표로 합니다.
- 이러한 발전은 1백만 엔드포인트 규모의 AI 클러스터를 지원할 수 있게 합니다.
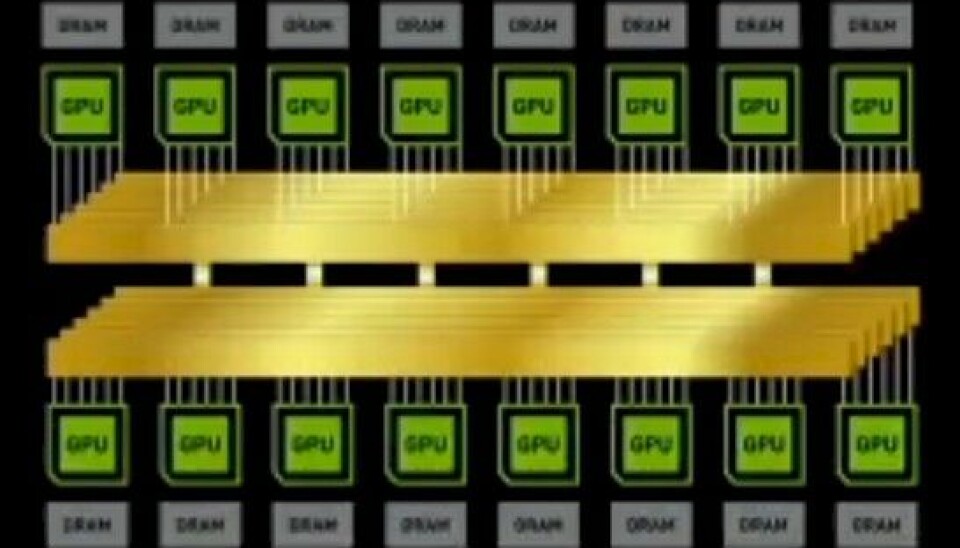
장기적으로 Nvidia NVSwitch는 대규모 확장 AI 네트워크의 InfiniBand이다
아주 먼 옛날, PC와 서버를 위한 두 개의 경쟁적인 미래 I/O 방식이 있었고, 닷컴 버블(Dot Com boom)이 거세게 몰아치면서 이들은 화해하고 타협하여 모든 컴퓨팅의 I/O 버스로 InfiniBand 포트와 스위치 패브릭을 만들었습니다.
하지만 아아, 닷컴 버스트(Dot Com bust)가 찾아왔고, 이 표준에 동의했던 모두는 그것을 쓰레기통에 던져버리고 포인트 투 포인트 인터커넥트(예: PC나 서버가 인터넷 또는 사내 네트워크와 연결되는 방식)와 여러 머신에 걸쳐 컴퓨팅을 집계하는 현재 우리가 '스케일 아웃 네트워킹(scale out networking)'이라고 부르는 것에 초점을 맞추었습니다. 매우 어려운 경제 상황으로 인해, 업계는 주변 장치를 위해 업데이트된 PCI-X를 거쳐 PCI-Express 버스를 선택했습니다.
고성능, 저지연 인터커넥트였던 InfiniBand는 Voltaire와 Mellanox Technologies에 의해 재조명되었으며, Mellanox는 스위치 ASIC과 NIC를 공급하고 Voltaire는 HPC ModSim 워크로드를 목표로 하는 스위치를 만들었습니다. Mellanox는 2010년 11월 $2억 1800만 달러에 Voltaire를 인수하여 InfiniBand 스위칭 입지를 통합했습니다. Unisys 출신 기술자들로 설립된 InfiniCon 시스템은 이 시장에 진출했고, 여러 변형 끝에 QLogic이 되었으며, 이는 InfiniBand 영역에서 Mellanox의 유일한 실질적인 경쟁 상대였고 2012년 1월 Intel에 $1억 2500만 달러에 인수되었습니다. (그 QLogic 팀은 2020년 9월 Intel에서 분사하여 Cornelis Networks가 되었습니다.) TopSpin은 InfiniBand 스위치 공급업체였으며, 2005년에 Cisco Systems에 인수되었습니다. Sun Microsystems는 공동 창립자 Andy Bechtosheim의 지도 아래 InfiniBand를 'Constellation' HPC 클러스터에서 클러스터링 기술로 채택하고 자체 InfiniBand ASIC과 NIC를 만들었습니다.
Oracle은 2009년 4월 Sun Microsystems를 56억 달러에 인수한 이후에도 이러한 노력을 계속했으며, Big Larry는 입지를 강화하기 위해 InfiniBand 스위치 제조사 Xsigo Systems까지 인수했고, 이후 이더넷(Ethernet)이 자체적인 규모 확장(scale up), 분산 확장(scale out), 그리고 전반적 확장(scale across) 네트워킹 플랫폼이라고 결정했습니다.
2023년 7월에 설립된 Ultra Ethernet Consortium을 통해, 목표는 InfiniBand의 낮은 지연 시간과 높은 대역폭, 그리고 일부 서비스 품질 및 적응형 라우팅 기능들을 이더넷의 더 높은 확장성(scalability), 멀티테넌시(multitenancy), 그리고 서비스 품질 기능들과 결합하여, InfiniBand를 확실하게 능가할 수 있는 규모 확장 네트워크를 만드는 것입니다. 이는 1백만 개의 엔드포인트(endpoints)를 지원하는 것을 목표로 하는 AI 클러스터를 위한 것입니다. 이더넷은 또한 Nvidia의 NVSwitch 인터커넥트의 규모 확장 영역으로 진출하고 있으며, 여기서는 GPU 메모리를 하나의 일관되고 공유된 메모리 공간에 72개의 가속기(accelerators)에 연결할 수 있게 하고, 지연 시간 호프(latency hops)를 감수한다면 네트워크를 576개 장치까지 확장하는 수단을 제공합니다.
분명히 말하자면, 저는 InfiniBand를 좋아하고 NVSwitch도 좋아합니다. InfiniBand는 25년 반 동안 논쟁의 여지가 없는 낮은 지연 시간 리더였으며, 오늘날에도 여전히 우위를 가지고 있습니다. 이것이 제가 Nvidia가 7월로 마감되는 지난 12개월간 257억 4천만 달러를 벌어들였다고 생각하는 이유입니다. 이는 제가 Nvidia가 이더넷 및 NVSwitch 인터커넥트 결합으로 판매했다고 생각하는 256억 7천만 달러와 거의 같습니다. 하지만 이것은 대규모 클러스터에 대한 InfiniBand의 정점일 가능성이 높으며, 수많은 하이퍼스케일러(hyperscalers), 클라우드 빌더(cloud builders), 그리고 AI 모델 빌더들이 임박한 Ultra Ethernet 기술과 Broadcom, Cisco Systems, 심지어 Nvidia 자체와 같은 이더넷 ASIC 벤더들이 포트 호프 지연 시간 및 이더넷 패브릭 내의 종단 간(end to end) 지연 시간을 낮추는 쪽으로 표준화하는 추세에 있습니다.
10년도 더 전, 저는 InfiniBand가 Ethernet에 의해 너무 빨리 사라질 것이라고 썼습니다. 그리고 Nvidia에게는 InfiniBand가 오랫동안 존재할 것으로 예상합니다. 현재 이 분야에서 유일한 공급업체는 중국의 일부 커스텀 HPC 인터커넥트(InfiniBand 기반)를 제외하고, 이는 과거 독립적이었던 Mellanox에 의해 라이선스를 받고 승인되었지만, 이제는 InfiniBand라고 부르기 어려울 정도로 향상되었을 수 있습니다. 하지만 Ethernet은 그 규모상의 이점과 캠퍼스, 엣지, 데이터센터 네트워크와의 광범위한 호환성 덕분에 InfiniBand를 상대적인 틈새시장에 가둘 수는 있습니다. 그리고 앞으로 볼 때, 확장(scale up)용 NVswitch와 확장(scale out)용 Spectrum-X Ethernet이 Nvidia 자체 판매 시장을 지배할 것입니다. 이것은 공급업체 주도(vendor push)가 아니라 고객 수요(customer pull)입니다. 기업들은 확실히 Ethernet을 원할 것이고, AI 모델 빌더들도 마찬가지입니다. 심지어 이전에 AI 클러스터에서 InfiniBand에 주목받게 했던 Meta Platforms조차도 말입니다.
네트워킹 분야의 오래된 격언은 Ethernet이 항상 승리한다는 것입니다. 그리고 실제로 그렇습니다. 그 이유는 Ethernet이 엔터프라이즈 네트워크 전반에 걸쳐 광범위하게 적용될 수 있는 좋은 아이디어들을 HPC 및 이제 AI와 같은 틈새 영역의 모든 패브릭으로부터 빼앗아 오기 때문입니다. 클러스터로 시스템을 연결하는 확장(scale out) 네트워크에서 사람들이 이 시스템들에 접근하는 것이 사실이라면, GPU와 XPU를 AI 클러스터에 연결하는 데 사용되는 확장(scale up) 네트워크에서도 똑같이 사실일 것입니다. 우리는 이미 다른 메모리 공유 방식의 전송 수단으로 매우 빠른 Ethernet이 사용되는 것을 목격하고 있습니다.
여기에는 2024년 5월에 AMD, Broadcom, Cisco Systems, Google, Hewlett Packard Enterprise, Intel, Meta Platforms, Microsoft가 설립한 UALink가 포함되는데, 이 프로토콜은 NVLink와 NVSwitch를 겨냥하며 첫 공격을 가했습니다. 주목할 점은 AMD가 자체 'Helios' 랙 내부의 스케일업 네트워크에 UALink 프로토콜을 실행하기 위해 Broadcom Tomahawk 6 Ultra Ethernet 스위치를 사용하고 있다는 것입니다. UALink는 XPU와 GPU를 연결하기 위한 메모리 원자적(atomic) 프로토콜일 뿐이며, CPU와 DPU가 메모리를 공유하는 것을 막을 것은 아무것도 없습니다. 마찬가지로 Meta Platforms와 Microsoft가 주도하며 AMD, Arista Networks, Arm, Cisco, Hewlett Packard Enterprise, Marvell, Nvidia, OpenAI, Oracle 등이 참여한 ESUN 프로토콜도 있습니다. Broadcom은 ESUN/SUE-T 노력(Ethernet 스케일업 스택의 두 가지 다른 계층으로, SUE-T는 부하 분산 및 기타 상위 레벨 기능을 처리함)에 속해 있었으나 UALink에서 손을 떼었으며, 우리가 아는 한 NVLink/NVSwitch 조합에는 관심이 없습니다. 하지만 Broadcom의 CPU 및 XPU 고객들이 칩 관리 사업(chip shepherding business)에서 NVSwitch를 자신들의 랙 스케일 패브릭으로 지지하고 데이터센터에 Nvidia 스타일의 랙을 GPU와 XPU 모두에 사용하기로 결정한다면 상황이 바뀔 수도 있습니다.
이 모든 것이 어떻게 전개될지는 말하기 어렵습니다. 오늘 Nvidia는 대만 SoC 제조사 MediaTek이 발행한 전환사채 35억 달러를 인수했으며, Nvidia의 공동 창업자이자 최고경영자인 Jensen Huang은 이를 세계에서 가장 크고 최고의 SoC 제조업체라고 Bloomberg에서 평가했습니다. (AMD와 Intel은 이에 대해 반발할 것이며, 그럴 만도 합니다.) 이 거래의 일환으로 MediaTek은 NVLink Fusion 스택에 접근하게 되는데, 이는 자체 칩을 설계하는 기업들이 해당 칩에 NVLink 포트를 장착하여 NVSwitch 메모리 패브릭의 일부가 될 수 있도록 허용합니다. 그리고 다시 한번 상기시켜 드리자면: Nvidia는 NVSwitch ASIC과 복합체를 별도로 판매하지 않습니다. 혼합 구성 요소에는 “Grace” 또는 “Vera” CPU나 Nvidia의 “Blackwell” 또는 “Rubin” GPU가 필요하며, 이는 규모 확장 네트워크로 Nvidia의 NVSwitch를 갖춘 랙을 구매한다는 것을 전제로 합니다.
저는 Nvidia가 CPU와 GPU 및 XPU 가속기 모두에 NVLink 포트를 가진 고객에게 NVSwitch 네트워킹을 판매하는 것에 만족할 수 있는 시기가 올 것이라고 생각합니다. 물론 이에 필요한 소프트웨어 지원이 있을 것입니다. 하지만 지금까지 Nvidia의 공개적인 입장은 이것은 허용되지 않는다는 것입니다.
장기적으로 AI 시스템의 규모 확장 네트워크(scale up network)에는 몇 가지 다른 변화가 일어날 것입니다.
현재 Nvidia가 GPU 매출의 약 95%, 그리고 GPU/XPU 통합 매출의 약 75%를 차지하고 있기 때문에, NVLink/NVSwitch로 규모 확장 네트워킹 시장을 지배하고 있습니다. 이는 아마도 2027년 달력 연도를 거치며 몇 퍼센트 포인트 하락하는 정도에 그칠 것입니다.
하지만 하이퍼스케일러(hyperscalers), 클라우드 빌더, AI 모델 빌더 및 대기업들은 다양한 하드웨어 공급업체 간의 상호 교환성(interchangeability)을 허용하는 널리 채택된 표준을 선호한다는 점을 상기할 필요가 있습니다. NVLink Fusion은 UALink와 ESUN/SUE-T 작업에 방해물을 놓아, 불가피한 변화를 또 다른 한두 세대 지연시키려는 시도입니다.
하지만 이 기술 거인들은 원하는 대로 할 수 있습니다. 그들은 자체 장치에 대한 새로운 표준을 만들 충분한 자금을 가지고 있으며, 2014년에 Google, Microsoft, Arista Networks가 느린 IEEE의 방식(10 Gb/sec 신호와 10개 레인을 고수하려 했던 것)에 염증을 느끼면서 100 Gb/sec 및 그 이상의 이더넷 백본으로 새로운 표준을 만들어냈던 것처럼, 결국 다시 협력할 이유가 충분하다고 믿을 만합니다.
UALink는 포트 대 포트로 NVLink/NVSwitch와 맞설 수 있으며, 이론적으로는 NVLink/NVSwitch보다 거의 두 배까지 확장할 수 있습니다. 2025년 4월에 출시된 UALink 1.0 사양은 단일 레벨의 UALink 스위칭에서 최대 1,024개의 XPU 또는 GPU로 확장될 수 있습니다. 저희는 메모리를 공유하는 576개 GPU를 확보하려면 NVSwitch가 두 단계 필요하다고 확신합니다.
UALink와 ESUN/SUE-T 진영이 화해하여 모든 당사자가 만족할 만한 표준을 만들 가능성—어떤 이들은 확률이라고까지 말할지 모릅니다—이 있으며, 아마도 UALink 2.0으로 불릴 것입니다. (저희가 CXL 메모리 일관성 표준을 얻게 된 방식입니다.) 그리고 이 가상의 UALink 2.0 표준이야말로 NVSwitch에 정면으로 도전하는 표준이 될 것입니다. InfiniBand는 포트 호핑에서 지연 시간(latency)이 100나노초에서 120나노초로, 이더넷 스위치보다 3분의 1에서 절반 수준입니다. 그런데 UALink 사양은 포트 대 포트 호핑이 약 100나노초가 될 것으로 예상하고 있습니다. (사양 자체는 특정 지연 시간을 요구하지 않으며, 공급업체들이 할 수 있는 최선을 다할 것입니다.) NVSwitch의 포트 호핑은 InfiniBand보다는 이더넷에 가까울 것이라는 소문이 돌지만, 아무도 이를 확인한 적이 없습니다. 따라서 만약 그 소문이 사실이고 UALink 공급업체가 InfiniBand와 같은 지연 시간을 달성할 수 있다면 UALink 진영에게는 큰 이점이 될 것입니다. 게다가 이것을 이더넷 스위치 위에서 수행할 수 있다면 더욱 좋을 것입니다.
만약 UALink가 성공하여 사실상의(de facto) 스케일 업 네트워크 표준이 된다면 무슨 일이 벌어질까요? Nvidia는 그저 자신이 만들 수 있는 최고의 UALink 스위치와 포트를 만들 것이고, NVLink/NVSwitch를 통해 어마어마한 수익을 올렸던 것처럼 또다시 큰돈을 벌게 될 것입니다. 마치 세상이 오직 이더넷만을 원한다고 해도 InfiniBand 스케일 아웃 네트워크를 판매하면서 그렇게 많은 돈을 벌었던 것과 같습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 The Next Platform의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기