
이해 부채를 측정하는 CLI를 3일 만에 만들어보고, 직접 사용해 본 후기
요약
이 글은 '이해 부채(Understanding Debt)'라는 개념을 측정하는 CLI 도구를 개발하고 사용한 후기를 담고 있습니다. 이 도구는 git 히스토리를 분석하여 파일별 이해도 점수를 산출하며, AI 변경과 인간의 변경에 따라 점수가 변화합니다. 개발자는 직접 테스트를 거치며 툴이 설계대로 작동함을 확인했지만, 실제 사용 경험을 통해 '파일 단위'가 아닌 '형태(Structure)'나 '맥락(Context)'을 이해하는 것이 더 중요하며, 단순히 감점만으로는 학습 동기가 부족하다는 한계를 발견했습니다.
핵심 포인트
- 이해 부채 측정 CLI를 개발하여 git 히스토리 기반의 이해도 점수화 시도.
- AI 변경은 이해도를 낮추고, 인간의 수정은 채우는 방식으로 모델링함.
- 파일 단위가 아닌 '형태'나 '의존성' 등 구조적 맥락 파악이 더 중요함을 깨달음.
- 단순히 취약점을 진단하는 점수 제시만으로는 학습 동기를 부여하기 어려움.
AI가 코드를 작성할수록 '내가 파악하고 있다고 생각하는 범위'와 실제 코드 사이에 오차가 쌓입니다. 이 오차는 최근 '이해 부채(Understanding Debt)'라고 불리게 되었습니다.
이를 측정할 수 있다면 흥미로울 것 같아, git 히스토리에서 이해 부채를 수치화하는 CLI를 만들었습니다. 3일 만에 기본적인 작동 수준까지 만들고, 제 리포지토리에 직접 한 바퀴 사용해 본 결과, **'작동은 하지만, 쓸만한 지표는 아니었다'**는 결론이 나왔습니다. 그 기록을 공유합니다.
제작한 것
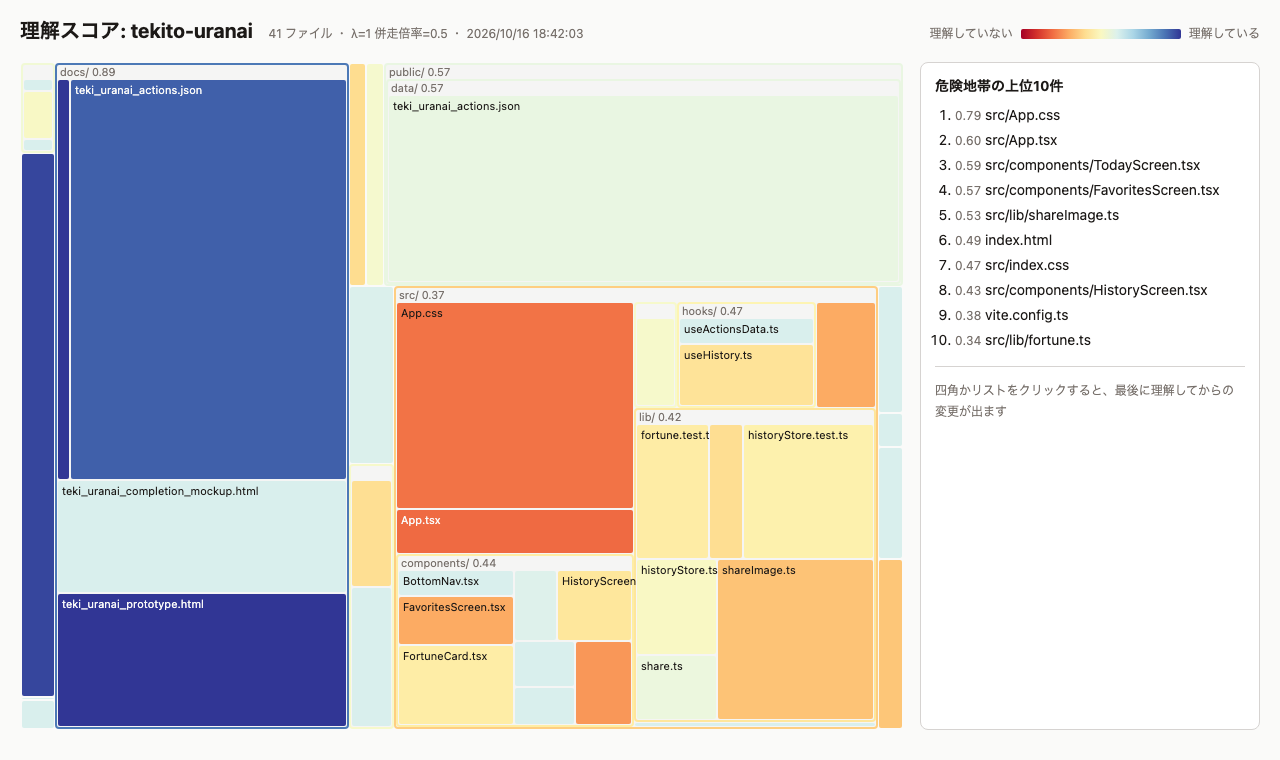
파일별로 0부터 1 사이의 '이해도 점수(理解スコア)'를 내주는 CLI입니다. 빨간색일수록 이해하지 못한 부분, 파란색일수록 이해하고 있는 부분으로 트리맵에서 확인할 수 있습니다.
커밋 출처를 세 가지로 분리하기
먼저 git 히스토리에서 각 커밋을 누가 작성했는지에 따라 분류합니다.
| 출처 | 판정 |
|---|---|
| 자율(自律) | 저자가 AI(Claude, [bot] 등)인 경우 |
| ... |
히스토리를 재생하여 점수를 올리고 내리기
파일의 히스토리를 오래된 순서로 재생하며 이해도 $u$를 업데이트합니다.
- 인간의 변경: 변경한 비율만큼, 이해하지 못한 부분을 채웁니다.
- AI의 변경: 변경한 비율에 따라 지수적으로 낮춥니다 (함께 작업한 경우 자율의 절반 강도).
처음에는 '마지막으로 인간이 건드린 이후 AI가 몇 줄을 바꿨는지'로 계산하자는 안이었지만, 그렇게 하면 인간이 한 줄만 고쳐도 만점으로 돌아와 버리기 때문에, 비율로 올리고 내리는 형태로 변경했습니다.
위험 지대(危険地帯)와 ack
점수만으로는 '낮지만 아무도 건드리지 않은 파일'까지 올라오기 때문에, 다음 수식으로 위험도를 계산하여 상위 10건을 표시합니다.
위험도 = 중요도 × (1 − 이해 점수) × 최근 90일 변경 빈도
또 하나 어려웠던 것이, 혼자 개발할 때는 PR 리뷰가 일어나지 않는다는 것입니다. 제 로컬 리포지토리 5개에서 나온 PR 57건을 확인해 보니, 인간의 리뷰는 단 한 건도 없었습니다 (댓글은 Vercel의 bot뿐). 그래서 '읽고 이해했다'고 자체 신고하는 ack 명령어를 만들었고, ack를 하면 점수가 만점으로 돌아가도록 했습니다.
이해한다는 수단 자체는 툴에 담지 않고, 설명이 필요할 때는 mizchi/explainer에게 맡겼습니다. 흐름은 'danger로 발견 → 설명을 읽음 → ack'입니다.
한 바퀴 사용해 보기
이 리포지토리 자신을 대상으로 한 바퀴를 돌려보았습니다.
danger로 위험 지대를 표시 - 2위였던 src/score.ts
(점수 0.29, 인간 커밋 0건)의 설명을 읽고 이해함 -
ack
그러자 위험도가 0.39 → 0이 되어 상위 10개에서 사라짐 - GitHub Pages에 배포하는 것까지 확인
설계대로 작동했습니다. 하지만 사용해 본 느낌은 **'툴 자체가 미묘했다'**는 것이었습니다.
어려웠던 점
1. 파일은 구현의 단위이지, 이해의 단위가 아니었다
가장 크게 깨달은 것은 이것입니다. 설명을 읽고 '알겠다'고 느꼈을 때 효과적이었던 것은 파일 내용 자체가 아니라, 형태였습니다. 어디서 무엇이 만나는지, 의존성이 어느 쪽을 향하고 있는지 말이죠.
파일 하나하나를 이해 완료 상태로 만들어 나가는 것에 애초에 의미가 있는 건지 의문입니다. 게다가 이 툴은 그 형태를 알지 못합니다.
2. 감점만 보여줘도, 이해하러 갈 마음이 생기지 않는다
점수가 낮다고 해도, '그럼 읽어볼까'라는 생각이 들지 않았습니다. 취약성 진단 점수를 보는 것과 비슷한 느낌입니다. 감점 제시만으로는 동기가 되지 않습니다.
3. 전부 AI로 작성되어 있으면, 전부 낮다
전부 AI와 함께 작성한 혼자 개발하는 경우, 거의 모든 파일의 점수가 낮아집니다. 결과적으로 위험도의 순위는 거의 변경 빈도에 의해 결정되었고, 상위에 온 것은 '말해 듣지 않아도 아는 파일'(엔트리 포인트 등)이었습니다.
다른 리포지토리에서는, 많은 변경이 통과되는 허브(App.tsx 등)가 파일 단위로 ack를 해도 영원히 상위에 남아있었습니다.
4. 점수는 이해도를 측정하고 있지 않았다
이해가 일어난 것은 설명을 읽는 순간이었고, 점수는 그 후에 ack 버튼을 누른 것에 따라 움직였을 뿐입니다. 측정하고 있던 것은 이해가 아니라, '이해했다고 신고한 것'이었습니다.
멈추기로 했다
그래서 여기서 일단락했습니다. 코드와 공개 페이지는 그대로 남겨두겠습니다. 잘 안된 결과도 작동하는 것과 함께 남겨둘 가치가 있다고 생각하기 때문입니다.
다시 시작한다면, 다음 두 가지 질문에 답할 수 있는 방안부터 삼을 생각입니다.
어떤 단위를 추적할 것인가. 파일보다는 모델이나 의존성의 형태에 가까운 단위로 만들 수 있을까 -
사람이 스스로 이해하러 가고 싶은 동기를 어떻게 만들 것인가. 감점 제시 외의 방식은 없을까
추가: 제작 과정
이 툴 자체도 거의 Claude Code에게 구현을 맡겨서 만들었습니다. 사람이 담당한 부분은 각 단계별 설계 승인, 데이터 형태 변경, 의사결정 채택, main 브랜치에 병합하는 것뿐입니다. 결정된 사항은 모두 ADR(Architecture Decision Record)에 남겼고, 중단된 판단도 ADR 0015로 남겨두었습니다.
각 단계가 끝날 때마다 AI에게 퀴즈를 내게 하고, 답하지 못한 부분을 기록하는 것도 했습니다. 이해 부채를 측정하는 툴을 만들면서, 자신의 이해 부채를 쌓지 않기 위한 노력입니다. 결과적으로 이 퀴즈와 설명을 읽는 시간이 점수보다 훨씬 더 이해에 도움이 되었습니다.
논의(Discussion)

AI 자동 생성 콘텐츠
본 콘텐츠는 Zenn AI의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기