<picture>
<source media="(prefers-color-scheme: dark)" srcset="assets/linkedrecords-logo-dark.png">
<img src="https://raw.githubusercontent.com/wolfoo2931/linkedrecords/HEAD/assets/linkedrecords-logo-light.png" alt="LinkedRecords">
</picture>
LinkedRecords는 백엔드 코드가 필요 없이 단일 페이지 애플리케이션(single-page application)에서 직접 연결할 수 있는 Backend-as-a-Service입니다. 권한 부여(Authorization)가 데이터 모델에 내장되어 있으며, 실시간 협업(CRDT/OT)이 기본적으로 작동합니다.
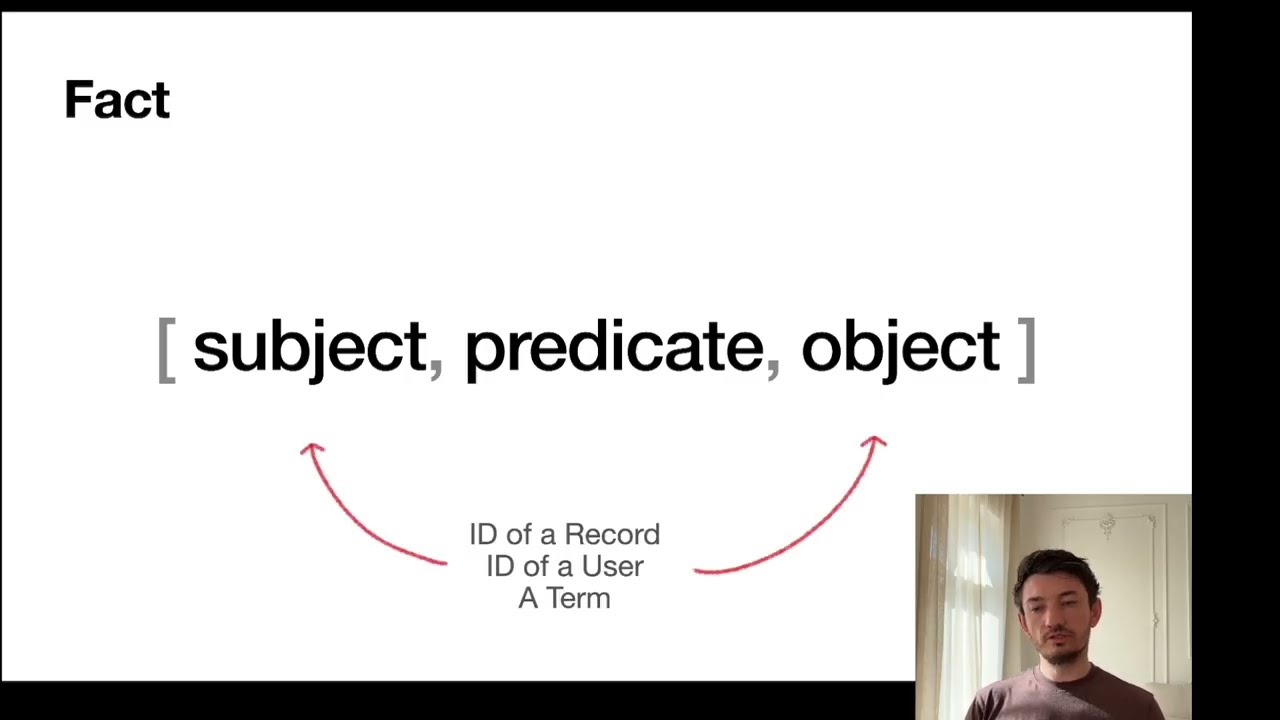
LinkedRecords Introduction
빠른 시작 (Quickstart)
Docker를 사용하여 백엔드를 로컬에서 실행합니다 (PostgreSQL 및 원클릭 테스트 계정을 포함한 모의 OIDC 제공자(mock OIDC provider) 포함):
curl -fsSLO https://raw.githubusercontent.com/wolfoo2931/linkedrecords/main/docker-compose.yml
docker compose up
서버는 http://localhost:6543에서 사용 가능합니다. 앱에서 연결하세요:
npm install @linkedrecords/browser
import LinkedRecords from '@linkedrecords/browser';

const lr = new LinkedRecords(new URL('http://localhost:6543'), {
...
React를 사용하나요? 시작 가이드에서 @linkedrecords/react hooks를 사용하여 완전한 협업 할 일 목록 앱(collaborative todo app)을 구축할 수 있습니다.
개념 (Concept)
LinkedRecords는 누구나 가입하고 데이터를 삽입할 수 있는 버킷으로 생각할 수 있습니다.
이론적으로, 모든 사용자는 LinkedRecords API를 직접 사용하여 데이터를 쓰거나 검색할 수 있습니다.
하지만 이는 불편합니다. 마치 사용자들에게 SQL 쿼리 작성을 기대하지 않듯이, 그들이 LinkedRecords API와 상호작용하는 것을 기대하지 않을 것입니다.
LinkedRecords 앱은 API를 숨기고 작업을 수행하기 위한 편리한 사용자 인터페이스를 제공하는 전문적인 프론트엔드입니다.
전통적인 SQL 세계에서 불편함만이 사용자가 데이터베이스에 직접 접근하지 못하게 하는 유일한 이유는 아닙니다. 권한 부여(authorization) 관련 우려가 훨씬 더 강력한 이유입니다.
LinkedRecords를 사용하면 이는 더 이상 문제가 되지 않습니다. 권한 부여는 API에 직접 내장되어 있습니다. 이는 작은 사고방식의 전환을 요구합니다:
모든 레코드에 대해 백엔드에서 보편적인 권한 규칙을 정의하는 대신, 데이터 레코드를 삽입하는 사용자가 누가 읽을 수 있는지 지정합니다.
LinkedRecords API의 경우, 우리가 달성하고자 하는 주요 특성은 단순성(Simplicity), 유연성(Flexibility), 그리고 분리된 아키텍처(decoupled architecture)입니다.
- 단순성: API는 많은 엔드포인트나 메서드를 가져서는 안 됩니다. 대신, 몇 가지 기본적인 빌딩 블록으로 구성되어야 합니다.
- 유연성: 사용 가능한 소수의 엔드포인트가 다양한 사용 사례를 지원하도록 조합될 수 있습니다. 내장된 권한 부여 모델은 서로 다른 권한 부여 사용 사례(RBAC 등)를 구현할 수 있도록 해야 합니다.
- 분리됨: LinkedRecords는 이를 데이터 저장소로 사용하는 단일 페이지 애플리케이션(single-page applications)으로부터 분리되어야 합니다.
권한에 대해 걱정하지 않고 React 앱에서 직접 호출할 수 있는 SQL이라고 생각하십시오. SQL보다 읽기 쉬우며 실시간 업데이트를 제공합니다.
설정 (Configuration)
LinkedRecords는 환경 변수를 통해 구성됩니다. 아래 표나 전체 설정 참조를 참고하여 모든 배포 모드에 대한 예시를 확인하십시오.
| 환경 변수 이름 | 예시 | 설명 |
|---|
| PGHOST | localhost | PostgreSQL 서버의 호스트 이름. |
| ... | | |
기밀 클라이언트 모드 (Confidential Client Mode)
이 섹션의 환경 변수들은 'Public Client Mode'에서 설명된 구성을 제공하는 경우 모두 선택 사항입니다.
LinkedRecords가 confidential client 모드(기밀 클라이언트 모드)로 실행되는 경우, 세션 토큰은 HttpOnly 쿠키에 저장됩니다. 보안 관점에서 이는 권장되는 방법으로 간주됩니다. 하지만 LinkedRecord 서버와 프런트엔드가 동일한 도메인을 공유하지 않는 경우에는 불가능합니다. 서로 다른 도메인 간에는 쿠키가 타사 쿠키(third-party cookie)가 되므로, 이 모드를 사용할 수 없습니다.
| 환경 변수 이름 | 예시 | 설명 |
|---|
| FRONTEND_BASE_URL | http://localhost:3001 | 프런트엔드의 기본 URL입니다. Access-Control-Allow-Origin HTTP 헤더에 사용되며, OpenID connect 리디렉션에도 필요합니다. |
| ... | | |
Public Client Mode
싱글 페이지 애플리케이션(single-page application)이 LinkedRecords 서버와 다른 도메인에 호스팅되는 경우, 싱글 페이지 애플리케이션은 액세스 토큰을 브라우저에 저장해야 합니다. 이 시나리오에서는 다음 환경 변수들을 구성해야 합니다.
| 환경 변수 이름 | 예시 | 설명 |
|---|
| ALLOW_HTTP_AUTHENTICATION_HEADER | true | 공개 클라이언트가 http 인증 헤더를 통해 액세스 토큰을 제공하여 요청을 보낼 수 있도록 허용합니다. |
| ... | | |
Optional Configuration
S3
S3가 구성되면 블롭 레코드 값(blob record values)을 저장하는 데 사용됩니다. S3가 구성되지 않은 경우, 이들은 PostgreSQL 데이터베이스에 저장됩니다.
S3 구성을 권장합니다.
| 환경 변수 이름 | 예시 | 설명 |
|---|
| S3_COPY_FROM_BL_ATTRIBUTE_TABLE | false | 이는 블롭 스토리지(blob storage)를 postgresql에서 S3로 마이그레이션하는 데 사용됩니다. |
| ... | | |
Redis
Redis는 여러 LinkedRecords 인스턴스가 로드 밸런서 뒤에서 실행되어 실시간 업데이트가 다른 인스턴스에 연결된 클라이언트에게 도달해야 할 때만 필요합니다.
| Environment Variable Name | 예시 | 설명 |
|---|
| REDIS_HOST | redis.example.com | Redis 호스트입니다. 이를 설정하면 Redis 어댑터가 활성화됩니다. |
| ... | | |
Paddle
| Environment Variable Name | 예시 | 설명 |
|---|
| PADDLE_NOTIFICATION_SECRET | xxxx | 쿼터 업그레이드에 paddle을 사용하는 경우, 웹훅 콘텐츠의 서명을 검증하기 위한 알림 비밀번호가 필요합니다. |
| ... | | |
개발
기여를 환영합니다 - 자세한 내용은 CONTRIBUTING.md를 참조하세요.
사전 요구 사항: Node.js v24 및 PostgreSQL 데이터베이스 ( PG* 환경 변수를 통해 구성됨, CONTRIBUTING.md 참조; 또는 임베디드 데이터베이스 사용을 위해 USE_PGLITE=true를 설정하세요).
npm install
npm start
npm test
...
문서화 웹사이트는 docs/에 있습니다:
cd docs && npm install && npm run dev
성능
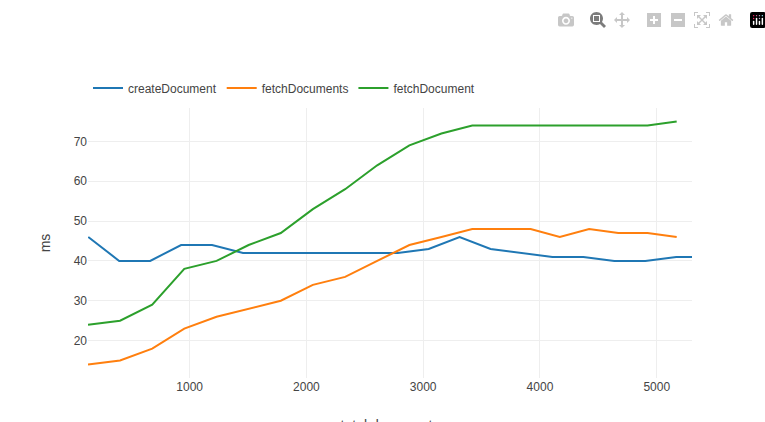
아래 차트는 데이터베이스가 성장함에 따라 핵심 작업의 성능을 보여줍니다. 이 내용은 main 브랜치로 병합될 때마다 자동으로 업데이트됩니다.
부하 테스트는 현실적인 문서 관리 시나리오를 시뮬레이션합니다. 각 createDocument 작업은 문서 콘텐츠, 협업자/읽기 그룹, 댓글, 참조 및 구성을 포함하는 8개 레코드(7 KeyValueRecords + 1 LongTextRecord)의 청사진을 생성합니다. fetchDocuments 작업은 사용자에게 연결된 모든 문서를 나열하며, fetchDocument는 관련된 모든 레코드를 가진 단일 문서를 검색합니다.
Load Test Performance Chart
부하 테스트 작동 방식
이 테스트는 세 명의 사용자를 가진 멀티테넌트 환경을 시뮬레이션합니다:
- User 1은 지속적으로 문서를 생성합니다(현재 테스트 구성에서는 5,000회 반복).
- User 2는 '테스트 대상 사용자'로, User 1이 생성하는 문서 10개당 1개의 문서를 생성하며, 최대 300개 문서까지 진행됩니다. 300개 문서에 도달하면 이 사용자의 문서 생성이 중단됩니다.
- User 3는 간헐적으로 문서를 생성합니다(1,000회 반복마다).
x축은 데이터베이스의 총 문서 수(모든 사용자가 소유한 문서 포함)를 나타냅니다. y축은 밀리초 단위의 응답 시간을 보여줍니다.
측정 항목:
| 작업 | 설명 |
|---|
createDocument | 모든 관련 기록(콘텐츠, 설정, 댓글, 참조, 협업자/읽기 그룹)을 포함하여 새 문서를 생성하는 데 걸리는 시간. createDocument는 데이터베이스의 총 문서 수와 사용자에게 보이는 문서 양 모두에 독립적이라는 것을 알 수 있습니다. |
fetchDocuments | User 2의 문서 목록(최대 300개 문서까지)을 가져오는 데 걸리는 시간. 이 시간은 사용자에게 보이는 문서 양에는 의존하지만, 총 문서 수에는 의존하지 않습니다(그래프가 약 3,000개 문서 부근에서 평평해집니다). |
fetchDocument | 모든 관련 데이터(콘텐츠, 댓글, 그룹, 활동 상태, 참조)를 포함하여 단일 문서를 가져오는 데 걸리는 시간. 이 시간은 사용자에게 보이는 문서 양에는 의존하지만, 총 문서 수에는 의존하지 않습니다(그래프가 약 3,000개 문서 부근에서 평평해집니다). |