
Z80-μLM: 레트로 컴퓨팅 마이크로 언어 모델
요약
Z80-μLM은 64kb RAM의 Z80 프로세서 환경에서 구동되는 초소형 대화형 AI 모델입니다. 양자화 인식 훈련(QAT)과 2비트 가중치 양자화를 활용하여, 고성능 하드웨어 없이도 개성을 유지하며 작동하는 것이 핵심입니다. 이 프로젝트는 레트로 컴퓨팅 환경에 LLM 기술을 접목한 연구 사례를 제시합니다.
핵심 포인트
- Z80 프로세서(1976년)에서 구동 가능한 초소형 AI 모델 구현.
- QAT와 2비트 가중치 양자화를 통해 메모리 제약 극복.
- CP/M, ZX Spectrum 등 레트로 컴퓨팅 환경에 배포 가능.
- LLM 데이터를 활용하여 자체 호스팅 및 미세 조정 용이.
Z80-μLM: 레트로 컴퓨팅 마이크로 언어 모델
Z80-μLM은 양자화 인식 훈련(quantization-aware training, QAT)을 통해 64kb의 RAM을 가진 Z80 프로세서에서 구동되는 '대화형 AI'입니다. 이 모델은 짧고 문자 단위로 시퀀스를 생성합니다.
이 프로젝트의 근본적인 질문은 다음과 같았습니다: 개성을 유지하면서 얼마나 작아질 수 있을까? 그리고 쉽게 훈련하거나 미세 조정(fine-tuning)할 수 있을까? 게다가 자체 호스팅 배포가 쉬울까?
답은 '예'입니다! 1976년의 4MHz 프로세서에서 구동되는 40kb의 .com 바이너리(추론, 가중치 및 채팅 스타일 UI 포함)로 가능합니다.
튜링 테스트를 통과하지는 못하겠지만, 녹색 화면을 보며 미소 짓게 만들 수는 있을 것입니다.
자신만의 모델을 가장 잘 훈련하는 방법에 대한 통찰은 TRAINING.md를 참고하세요.
예시 (Examples)
두 가지 사전 구축된 예제가 포함되어 있습니다:
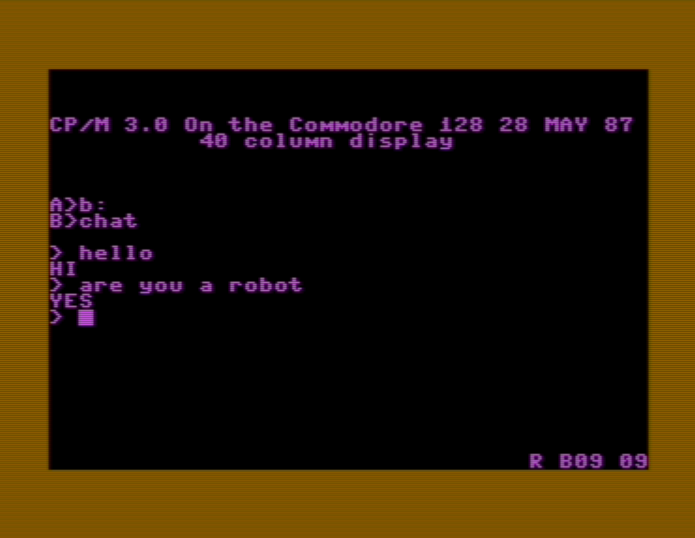
tinychat
일상적인 질의응답 쌍으로 훈련된 대화형 챗봇입니다. 인사, 자신에 대한 질문, 일반 잡담 등에 간결하고 개성이 담긴 답변을 합니다.
> hello
H I
> are you a robot
...
guess
모델이 비밀 주제를 알고 있고 사용자의 질문에 YES/NO/MAYBE로 답하는 '20가지 질문' 게임입니다. 정확하게 추측하면 WIN합니다.
LLM(Ollama 또는 Claude API)을 사용하여 훈련 데이터를 생성하고 클래스 분포를 균형 있게 맞추는 도구가 포함되어 있습니다.
빠른 시작 (Quickstart)
5분 이내에 실행해 보세요:
1. 다운로드: GitHub Releases에서 사전 구축된 바이너리를 다운로드합니다.
2. 에뮬레이터 설치:
| 플랫폼 | CP/M (.COM 파일) | ZX Spectrum (.TAP 파일) |
|---|---|---|
| Linux | iz-cpm | apt install fuse-emulator-gtk |
| ... |
3. 실행:
- CP/M:
iz-cpm CHAT.COM - ZX Spectrum:
fuse --tape CHAT.TAP, 그리고LOAD "" CODE및RANDOMIZE USR 32768
소스 코드로 빌드하거나 자신만의 모델을 훈련하려면 TRAINING.md를 참고하세요.
기능 (Features)
- Trigram 해시 인코딩: 입력 텍스트를 128개의 버킷으로 해싱합니다. 오타에 강하고 단어 순서에 독립적입니다.
- 2비트 가중치 양자화: 각 가중치는 {-2, -1, 0, +1}이며, 바이트당 4개를 패킹합니다.
- 16비트 정수 추론: 모든 연산은 Z80 네이티브 16비트 부호 있는 산술을 사용합니다.
- ~40KB .COM 파일: CP/M의 임시 프로그램 영역(TPA)에 들어갑니다.
- 자기회귀 생성 (Autoregressive generation): 텍스트를 문자 단위로 출력합니다.
- 부동 소수점 없음: 모든 것은 고정 소수점 스케일링을 사용한 정수 연산입니다.
- 대화형 채팅 모드: 인자 없이
CHAT만 실행하면 됩니다.
플랫폼 지원 (Platform Support)
Z80-μLM은 여러 Z80 기반 플랫폼에서 실행됩니다:
- CP/M: 원래의 목표 플랫폼입니다.
buildz80com.py를 사용하여.COM파일을 생성합니다. - ZX Spectrum 48K:
buildz80tap.py를 통해 완벽하게 지원됩니다. 자세한 내용은 ZX-SPECTRUM.md를 참조하세요.- 에뮬레이터 또는 실제 하드웨어를 위한
.TAP파일을 생성합니다. - I/O에 ZX Spectrum ROM 루틴을 사용합니다.
- 48K 시스템에 최적화된 메모리를 사용합니다.
- 대부분의 ZX Spectrum 에뮬레이터와 호환됩니다.
- 에뮬레이터 또는 실제 하드웨어를 위한
ZX Spectrum 빌드의 경우, 예시 디렉토리에서 run-zx.sh를 사용하거나 ZX Spectrum 가이드를 참조하세요.
상호작용 방식 (Interaction Style)
이 모델은 당신을 이해하지 못합니다. 하지만 묘하게, 당신을 파악합니다.
당신의 입력은 트라이그램 인코딩(trigram encoding)을 통해 128개의 버킷으로 해싱됩니다. 이는 추상적인
OK- 인지함, 중립적WHY?- 전제에 의문을 제기함R U?- 존재론적 의심을 던짐MAYBE- 진정한 불확실성AM I?- 질문을 되돌려 반영함
이것은 반드시 한계는 아닙니다. 이것은 다른 상호작용 방식입니다. 간결한 응답들은 당신으로 하여금 문맥에서 의미를 추론하게 하거나, 그것이 이해하는지 확인하기 위해 직접적인 예/아니오 질문을 던지도록 강요합니다 (예: '당신은 봇인가', '당신은 인간인가', '내가 인간인가'는 논리적으로 일관된 암기된 답변을 표시함)
장점
- 짧고 다양한 입력에 대해 일관되게 분류된 출력을 생성함
- 퍼지 매칭 (오타, 재구성, 단어 순서)
- 어휘 선택을 통한 개성 표현
- 제약된 8비트 하드웨어에서 실행 가능
한계점
- 새로운 문장을 생성하는 채팅봇이 아님
- 다중 턴(multi-turn)의 맥락을 깊이 추적하는 것이 아님
- 문법을 이해하는 파서가 아님
- 일반 지능에 근접한 어떤 것도 아님
작지만, 기능적입니다. 그리고 때로는 그것이 바로 당신에게 필요한 것입니다.
아키텍처
- 입력: 128개 쿼리 트라이그램 버킷 + 128개 컨텍스트 버킷
- 은닉층(Hidden layers): 구성 가능한 깊이/너비, 예: 256 → 192 → 128
- 출력: 문자 집합(charset)의 각 문자에 대한 뉴런 하나
- 활성화(Activation): 은닉층 사이의 ReLU
양자화 제약 (Quantization Constraints)
The Z80은 8비트 CPU이지만, 활성화 및 누산기(accumulators)에는 16비트 레지스터 쌍(HL, DE, BC)을 사용합니다. 가중치(Weights)는 바이트당 4개씩(각 2비트)으로 패킹되며, 곱셈-누적(multiply-accumulate)을 위해 8비트 부호 값으로 언패킹됩니다.
16비트 누산기는 수치적 안정성(오버플로우 없이 256개 입력 합산)을 제공하지만, 모델의 표현력은 여전히 2비트 가중치에 의해 병목 현상이 발생하며, 무작정 학습(naive training)할 경우 QAT(Quantization-Aware Training) 없이는 오버플로우하거나 '이상하게' 작동할 수 있습니다.
Z80 내부 루프 (Z80 Inner Loops)
추론의 핵심은 빡빡한 곱셈-누적 루프입니다. 가중치는 바이트당 4개씩 패킹됩니다:
; 패킹된 바이트에서 2비트 가중치를 언패킹
ld a, (PACKED)      ; 패킹된 가중치 가져오기
and 03h             ; 하위 2비트를 마스킹
...
곱셈-누적은 가능한 4가지 가중치 값을 처리합니다:
각 레이어 후에는 오버플로우를 방지하기 위해 2비트 산술 우측 시프트(arithmetic right-shift)를 수행합니다:
sra h        ; Shift right arithmetic (preserves sign)
rr l
sra h
...
이것이 전체 신경망입니다: 가중치 언팩, 곱셈-누적(multiply-accumulate), 시프트. 문자를 하나 생성할 때마다 약 10만 번 반복됩니다.
라이선스: 적절하다고 판단되는 MIT 또는 Apache-2.0.
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub AI Research의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기