
TurboQuant: 데이터 비식별(data-oblivious) KV 캐시 압축기
요약
TurboQuant는 데이터 비식별(data-oblivious) KV 캐시 압축기입니다. 랜덤 회전과 스칼라 Lloyd-Max 양자화기를 사용하여 KV 캐시 크기를 FP16 대비 3~4배 줄이며, 보정 데이터가 필요 없어 GPU 메모리 제약 환경에 유용합니다. 다만, 최신 하드웨어(Hopper/Blackwell)에서는 기본적으로 `--kv-cache-dtype fp8` 사용이 권장됩니다.
핵심 포인트
- KV 캐시를 FP16 대비 3~4배 압축하는 데이터 비식별 기술입니다.
- 보정 데이터가 필요 없어 다양한 환경에서 적용 가능합니다.
- 최신 GPU에서는 기본적으로 `--kv-cache-dtype fp8` 사용이 권장됩니다.
- TurboQuant는 매우 큰 컨텍스트(128K+)의 대형 모델 서비스에 여전히 강점을 가집니다.
⚡ TurboQuant





데이터 비식별(data-oblivious) KV 캐시 압축기. 랜덤 회전(Random rotation) + 스칼라 Lloyd-Max 양자화기(scalar Lloyd-Max quantizer)를 사용하여 KV 캐시 크기를 FP16보다 3~4배 줄이며, 보정 데이터(calibration data)가 필요 없습니다. GPU 메모리가 서비스 환경에서 병목 제약 조건일 때 유용합니다.
Google의 TurboQuant (ICLR 2026)의 오픈 소스 구현체입니다. 정보 이론적 왜곡 경계(information-theoretic distortion bound) 대비 증명된 성능으로 2.7배 이내에 있습니다.
현실 점검 (Reality check) (2026년 5월)
ICLR 포스터 발표 이후 많은 것이 바뀌었습니다. TurboQuant가 항상 정답은 아니며, 커뮤니티는 초기 과대광고(hype)가 암시했던 것보다 훨씬 더 미묘한 그림으로 수렴했습니다. 시작하기 전에 이 표를 읽어보세요:
| 발견 내용 (Finding) | 출처 (Source) | 사용자에게 의미하는 바 (What it means for you) |
|---|---|---|
| Hopper/Blackwell에서 FP8 KV 캐시가 최적의 기본값 — 2배 용량, 측정 가능한 정확도 손실 없음, 처리량 저하 없음 | Red Hat AI / vLLM 블로그, 2026년 5월 11일 | 먼저 --kv-cache-dtype fp8을 사용하세요. >2배 압축이 필요하고 어느 정도의 처리량 감소를 감수할 때만 TurboQuant를 사용하세요 |
| ... |
TurboQuant가 여전히 우위를 점하는 경우 (Where TurboQuant still wins)
| 시나리오 (Scenario) | TurboQuant가 FP8보다 나은 이유 (Why TurboQuant beats FP8) |
|---|---|
| 128K 이상의 컨텍스트를 가진 70B+ 모델의 단일 카드 서비스 | 3~4배 KV 감소로 모델과 캐시 적재 가능; FP8은 2배만 확보함 |
| ... |
목차 (Table of contents)
- 🎛️ HuggingFace Space에서 라이브 데모 확인하기 — 모델의 KV 캐시가 실시간으로 줄어드는 것을 확인하세요
- 새로운 기능 (What's new) — 2026년 5월 • TurboQuant를 사용해야 하는 이유? • 작동 원리 • 빠른 시작하기
- 팁과 트릭 (새로운 내용 — Red Hat 평가 및 독립 포트)
- 2026년 KV 압축 환경
- 통합 기능 (vLLM, SGLang, llama.cpp, KVPress, LMCache, MLX)
- 하드웨어 지원 • 어떤 압축기를 사용해야 할지 결정하기 • FAQ
- 프로젝트 구조 • 인용 (Citation) • 크레딧 (Credits)
2026년 5월의 새로운 기능
TurboQuant가 상위 버전 vLLM에 포함되었고, 여러 심각한 독립 포트를 확보했으며,
첫 번째 종합적인 서드파티 평가를 받았습니다. 주요 내용은 '새로운 SOTA이니 어디든 사용하라'에서
'특정 조건 하에서 유용하며, 주의사항이 있다'로 바뀌었습니다.
2026년 5월 필독 자료
- 5월 11일 — Red Hat AI / vLLM 블로그: "TurboQuant에 대한 최초의 종합 연구: 정확도 및 성능"
Eldar Kurtić, Michael Goin, Alexandre Marques 작성. 현재 생태계에서 가장 중요한 데이터 포인트:
Llama-3.3-70B, Qwen3-30B-A3B, MiniMax-M2.7 모델에 대한 장문 컨텍스트 검색(MRCR) 및 추론(AIME25, GPQA, MATH500, LiveCodeBench-v6) 전반의 엄격한 평가를 수행했습니다. 결론: FP8 KV가 최고의 기본값이며, TurboQuant4bit_nc가 실용적인 TQ 변형이고, 공격적인 3비트 모드는 정확도를 의미 있게 떨어뜨립니다. - 5월 11일~18일 — 여러 독립적인 평가(TeqVolt, AI Intensify)가 동일한 결론에 도달했습니다: PolarQuant는 작동하며, QJL은 3비트에서 성능 저하를 일으킵니다. QJL을 비활성화하면 동일한 압축률에서 더 나은 실질적인 정확도를 얻을 수 있습니다. PyTorch, MLX, Triton 구현체로 테스트되었습니다.
- 5월 13일 — varjoranta/turboquant-vllm v0.13.5
vLLM 0.20.2 + FlashInfer CUTLASS MoE를 통해 엔드투엔드Qwen3.6-35B-A3B-TQ3-native지원을 추가했습니다. 최초로 프론티어(frontier) MoE 모델에 대한 네이티브 패킹 TQ 체크포인트가 구현되었으며, 디스크에서 약 16 GB (BF16 대비 4.4배 압축)입니다. - 4월 23일 — varjoranta v0.13.0
블록 대각 WHT CUDA 커널을 배포했습니다: Qwen3.6-35B-A3B-TQ3에서 10.1배 디코드 속도 향상을 달성했습니다. - 4월 말 — vLLM 병합
--kv-cache-dtype turboquant_{k8v4, 4bit_nc, k3v4_nc, 3bit_nc}를 추가했습니다. 이 dtype 이름들은 이전의tq3/tq4/pq4제안을 대체합니다.
활성 커뮤니티 포트
| Repo | Stars | Engine | Notable |
|---|---|---|---|
| 0xSero/turboquant | 1.1K | vLLM + Triton | 최초의 오픈 소스 vLLM 통합; RTX 5090 + 8×RTX 3090 벤치마크; 비대칭 3비트 K / 2비트 V |
| ... |
네이티브 패킹된 체크포인트 (Native-packed checkpoints)
varjosoft/Qwen3.6-35B-A3B-TQ3-native
— 사전 융합된 전문가 레이아웃(pre-fused expert layout); A100 80 GB 또는 RTX PRO 6000에서turboquant-plus-vllm을 통해 로드.
이전 자료 (여전히 관련 있음) — 2026년 4월
- LMCache 블로그 (4/15) — 알고리즘에 대한 가장 쉬운 설명.
- Towards AI (4/15) — 일반 소비자용 GPU 사용 가이드; TurboQuant는 AWQ / GGUF / NVFP4 위에 쌓임.
- TriAttention (arXiv 2604.04921) — 토큰 선택을 통해 AIME25에서 10.7배의 KV 감소; TurboQuant와 결합 가능.
- LRKV (4/9) — 사전 학습 시 아키텍처적 45~53%의 KV 감소.
- Adaptive KV-Quant (arXiv 2604.04722) — 엣지(edge)에 대한 학습된 토큰별 비트 폭.
- SGLang PR #21419 — 최초의
--kv-cache-dtype turboquant시도; 아직 작업 중(WIP), 현재 SGLang 상태는 INTEGRATIONS.md 참조. - SGLang PR #21954 — Blackwell SM100/SM120용 NVFP4 KV 전략 추상화; TurboQuant가 조합하는 컨테이너.
ICLR 2026 포스터 (아카이브): Zandieh et al., 2026년 4월 25일.
📚 2026년 전체 환경 — TriAttention, LRKV, MLA, KIVI, KVQuant, ParoQuant, NVFP4-KV, KVPress, KV Packet, SnapKV, H2O, StreamingLLM과의 비교를 포함하여 보려면 **LANDSCAPE_2026.md**를 확인하세요.
TurboQuant의 장점?
📄 논문 결과 (Llama-3.1-8B-Instruct, LongBench — [논문]에서)
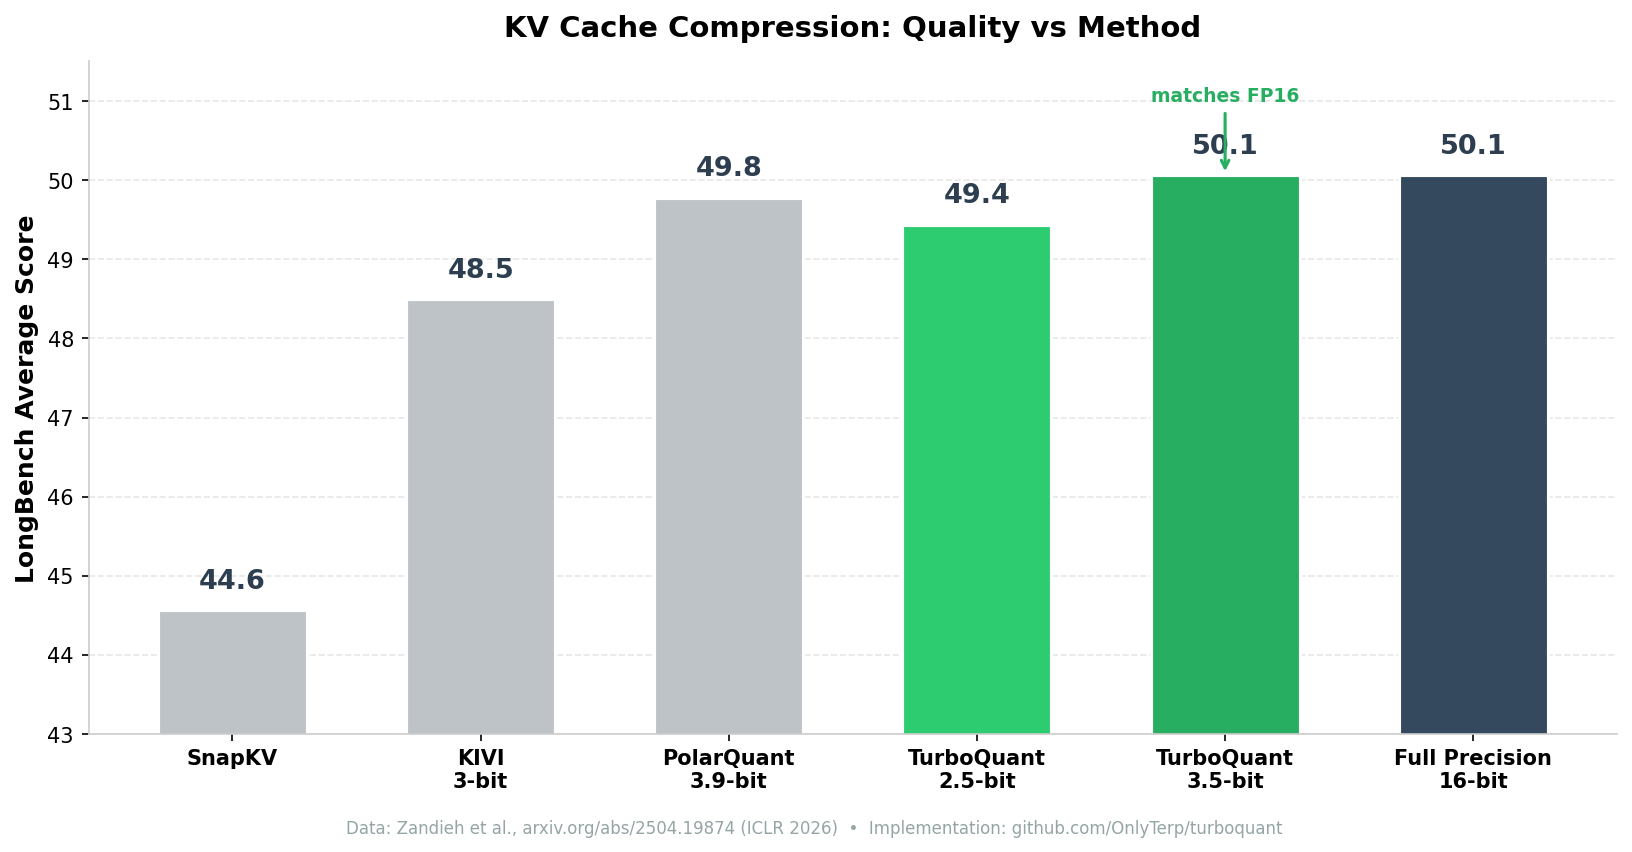
| Method | KV Bits | LongBench Avg | Needle-in-Haystack |
|---|---|---|---|
| Full Precision | 16 | 50.06 | 0.997 |
| ... |
⚠️ 독립적인 재현 결과는 논문보다 더 신중한 그림을 보여줍니다.
Red Hat AI / vLLM의 2026년 5월 평가는 추론 및 매우 긴 컨텍스트에서, 특히 QJL 비활성화 없이 사용할 경우 3-bit 모드가 의미 있는 정확도 저하를 보인다는 것을 발견했습니다. 프로덕션 환경에서는 4-bit*_nc변형을 사용하세요. BENCHMARKS.md §독립적인 재현를 참조하세요.
🔧 당사 구현 결과 (Mistral-7B-Instruct-v0.3)
| Mode | Logit Cosine | Top-1 Match | KV Key Cosine | KV Value Cosine | Compression |
|---|---|---|---|---|---|
| 3.5-bit (default) | 0.963 | 80% (4/5) | 0.992 | 0.988 | 4.9× |
| 2.5-bit | 0.956 | 80% (4/5) | 0.973 | 0.961 | 7.1× |
두 모드 모두 이상치/정규 채널 서브셋에 대해 **두 개의 독립적인 회전(two independent rotations)**을 사용하며(Section 2.3), 실제 데이터에서 추출한 **온라인 코드북(online codebooks)**을 사용합니다(Section 4.1).
회전 모드: `rotation_mode=
QJL은 선택 사항입니다. PyTorch, MLX, Triton에 대한 독립적인 평가 결과, 1비트 QJL 보정(correction)이 소프트맥스(softmax)가 증폭시키는 분산을 추가하여 $b ext{ 값이 } 3$ 이하일 때 어텐션 품질을 저하시키는 것으로 일관하게 나타났습니다. 순수한 MSE만을 사용하는 PolarQuant로 되돌리려면 qjl_score_weight=0.0으로 설정하거나 (enable_qjl=False) 하십시오. IMPLEMENTATION_NOTES.md의 QJL Score Weight 논의를 참조하십시오.
작동 방식 (How It Works)
TurboQuant는 근사 최적 압축을 달성하는 2단계 벡터 양자화기(vector quantizer)입니다:
Input KV 벡터 (FP16, d=128)
         │
         ▼
...
핵심 통찰: 무작위 회전(random rotation) 후, 각 좌표는 다른 좌표와 거의 독립적인 베타 분포(Beta distribution)를 따릅니다. 이는 좌표별 스칼라 양자화(scalar quantization per coordinate)가 근사 최적이라는 것을 의미합니다 — 깊은 모델을 거치면서 결합되거나 오류가 누적되는 현상이 없습니다.
빠른 시작 (Quick Start)
# PyPI에서 설치
pip install turboquant
# 사용하기
from turboquant import TurboQuantCache

...
또는 소스에서 설치하여 수정해 볼 수 있습니다:
git clone https://github.com/OnlyTerp/turboquant.git
cd turboquant
pip install -e ".[dev]"
...
서빙 엔진 (Serving engines) — 각 엔진의 전체 설정은 INTEGRATIONS.md를 참조하십시오:
# vLLM (업스트림 병합됨 — 권장)
pip install "vllm>=0.20.2"
vllm serve meta-llama/Llama-3.3-70B-Instruct --kv-cache-dtype turboquant_4bit_nc
...
팁과 트릭 (Tips and tricks)
Red Hat AI / vLLM 평가(2026년 5월 11일), tonbistudio V3 회고, scos-lab 8개 모델 벤치마크 및 0xSero, varjoranta, AmesianX의 런타임 데이터에서 추출되었습니다. 튜닝하기 전에 이것을 읽으십시오.
1. 먼저 FP8을 시도해 보세요
vllm serve <모델> --kv-cache-dtype fp8
FP8이 메모리 예산에 맞는다면, 더 이상 고민할 필요가 없습니다. Red Hat 팀이 테스트한 모든 모델에서 최고의 품질/최고 처리량 KV 포맷입니다. TurboQuant는 2배 이상의 압축이 필요할 때만 그 가치를 발휘합니다.
2. TurboQuant 사용 시: 3bit_nc 대신 4bit_nc를 선택하세요
vllm serve <model> --kv-cache-dtype turboquant_4bit_nc
4bit_nc는 '정규화 보정(norm correction)' 변형으로, QJL 잔차(residual)를 건너뛰고 토큰별 정규화 재조정(per-token norm rescale)을 사용합니다. Llama-3.3-70B, Qwen3-30B-A3B, MiniMax-M2.7 전반에 걸쳐 AIME25 / GPQA / MATH500 / LiveCodeBench에서 FP8 대비 약 1점 차이 내외를 유지하면서도 KV를 2.6–3.1배 줄여줍니다. 반면 3bit_nc와 k3v4_nc는 동일한 벤치마크에서 컨텍스트 길이가 ≥128K일 때 15–25점이 하락합니다.
3. 참조 경로(reference path)로 작업할 때는 QJL 비활성화
qjl_score_weight=1.0의 논문 기본값은 편향되지 않지만 분산이 높습니다. Softmax는 특히 주의가 집중된 헤드에서 이러한 분산을 증폭시키므로, 독립적인 포트(PyTorch, MLX, Triton)에서는 MSE만 사용했을 때가 MSE+QJL보다 b ≤ 3에서 일관되게 우수합니다. 코드로 구현하면 다음과 같습니다:
cache = TurboQuantCache(n_layers=..., n_heads=..., d=128, b_mse=3,
                        qjl_score_weight=0.0)  # QJL 비활성화
# 또는 최신 버전에서는 enable_qjl=False 설정
4. 첫 번째 및 마지막 2개 레이어 건너뛰기
첫 번째와 마지막 2개 레이어는 불균형적인 신호(disproportionate signal)를 담고 있습니다. Red Hat의 평가에 따르면, 이 레이어들을 양자화하는 것이 절약되는 비트 수보다 더 많은 정확도 손실을 초래합니다. vLLM은 *_nc 변형에 대해 이를 자동으로 처리하며, 자체 어텐션 백엔드를 구축할 경우 다음 코드를 복제하여 사용하세요:
SKIP_LAYERS = set(list(range(2)) + list(range(model.config.num_hidden_layers - 2,
                                              model.config.num_hidden_layers)))
for layer_idx in range(model.config.num_hidden_layers):
...
5. 비트를 선택하기 전에 K 대 V 노름 프로파일링 수행
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub AI Research의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기