요약
Mistral의 첫 번째 시계열(time-series) 기반 모델군인 Timestral은 2억 9백만 개의 매개변수(parameters)만을 사용하여 최첨단 확률적, 다변량 예측을 제공합니다. 이 모델은 주요 벤치마크에서 더 큰 모델들을 능가하는 성능을 보이면서도 과거 및 미래의 공변량(covariates)을 지원합니다. 네 가지 크기(5M부터 209M 매개변수까지)로 제공되어 정확성과 효율성의 균형을 맞추었으며, CPU에서도 효율적으로 실행되고 다양한 도메인에서 제로샷 예측(zero-shot forecasting)에 탁월합니다. 이 모델은 합성 사전 학습(synthetic pre-training), 공변량 인식 어텐션(covariate-aware attention), 그리고 장문맥 학습(long-context learning)을 결합했으며, Mistral Forge를 통해 도메인 적응을 위한 미세 조정 옵션을 제공합니다.
오늘 저희는 첫 번째 시계열 기반 모델군인 Timestral을 출시합니다. 2억 9백만 개의 매개변수만을 가진 가장 큰 모델은 해당 분야의 주요 공공 벤치마크 세 가지(GIFT-Eval, TIME, fev-bench)에서 모두 1위를 차지하며, 이전 최첨단 성능보다 단지 3분의 2에 불과한 모델 매개변수로 능가합니다.
Timestral은 확률적, 다변량 예측을 제공하고 과거 전용 및 알려진 미래 공변량을 지원합니다. 저희의 모델군은 예측 정확도 대 모델 크기의 파레토 프론트(Pareto front)에 위치하여, 각 크기에서 선도적인 성능을 제공합니다. 그 결과는 GIFT-Eval 및 TIME 리더보드에 제출되었습니다.
시계열 기반 모델 (Time Series Foundation Models, TSFM)
시계열은 센서 원격 측정(sensor telemetry)부터 관측 가능성 지표(observability metrics)에 이르기까지 기업에서 가장 흔한 데이터 유형 중 하나입니다. 이를 기반으로 구축된 예측은 용량 계획, 에너지, 공급망, 위험 및 유지보수 분야의 의사결정을 주도합니다.
산업 플랜트는 생산 일정에 맞춰 공정 센서를 예측하고, 장비 고장 전에 드리프트(drift)를 감지하며, 수천 개의 자산 전반에 걸쳐 용량과 예비 부품을 계획합니다. 금융팀은 포지션, 헤징(hedging), 재무 관리 전반의 흐름, 물량 및 변동성을 예측하여 수천 개의 계좌에 정보를 제공합니다.
ARIMA나 선형 회귀(linear regression) 같은 전통적인 모델은 시계열 예측을 위한 잘 확립된 도구로 남아 있습니다. 이러한 모델들은 보통 단일 시계열에 맞춰 학습되며, 해당 시계열의 기록으로부터만 패턴을 학습합니다.
PatchTST와 같은 딥러닝(deep learning) 모델은 여러 관련 시계열에 걸쳐 비선형적 패턴을 학습할 수 있는 능력을 추가하지만, 여전히 일반적으로 각 데이터셋마다 처음부터(from scratch) 훈련되기 때문에, 학습한 지식이 새로운 도메인으로 전이되지 않습니다.
시계열 파운데이션 모델(time series foundation models)은 시계열에 사전 훈련(pre-training) 접근 방식을 가져옵니다. 대규모의 다양하고 광범위한 코퍼스(corpus)로 훈련된 저희 모델은 여러 시계열에 걸쳐 전이되는 패턴을 학습하며, 데이터가 부족한 도메인에서도 이전에 본 적 없는 데이터에 대해 제로샷(zero-shot) 예측을 수행합니다.
벤치마크 결과
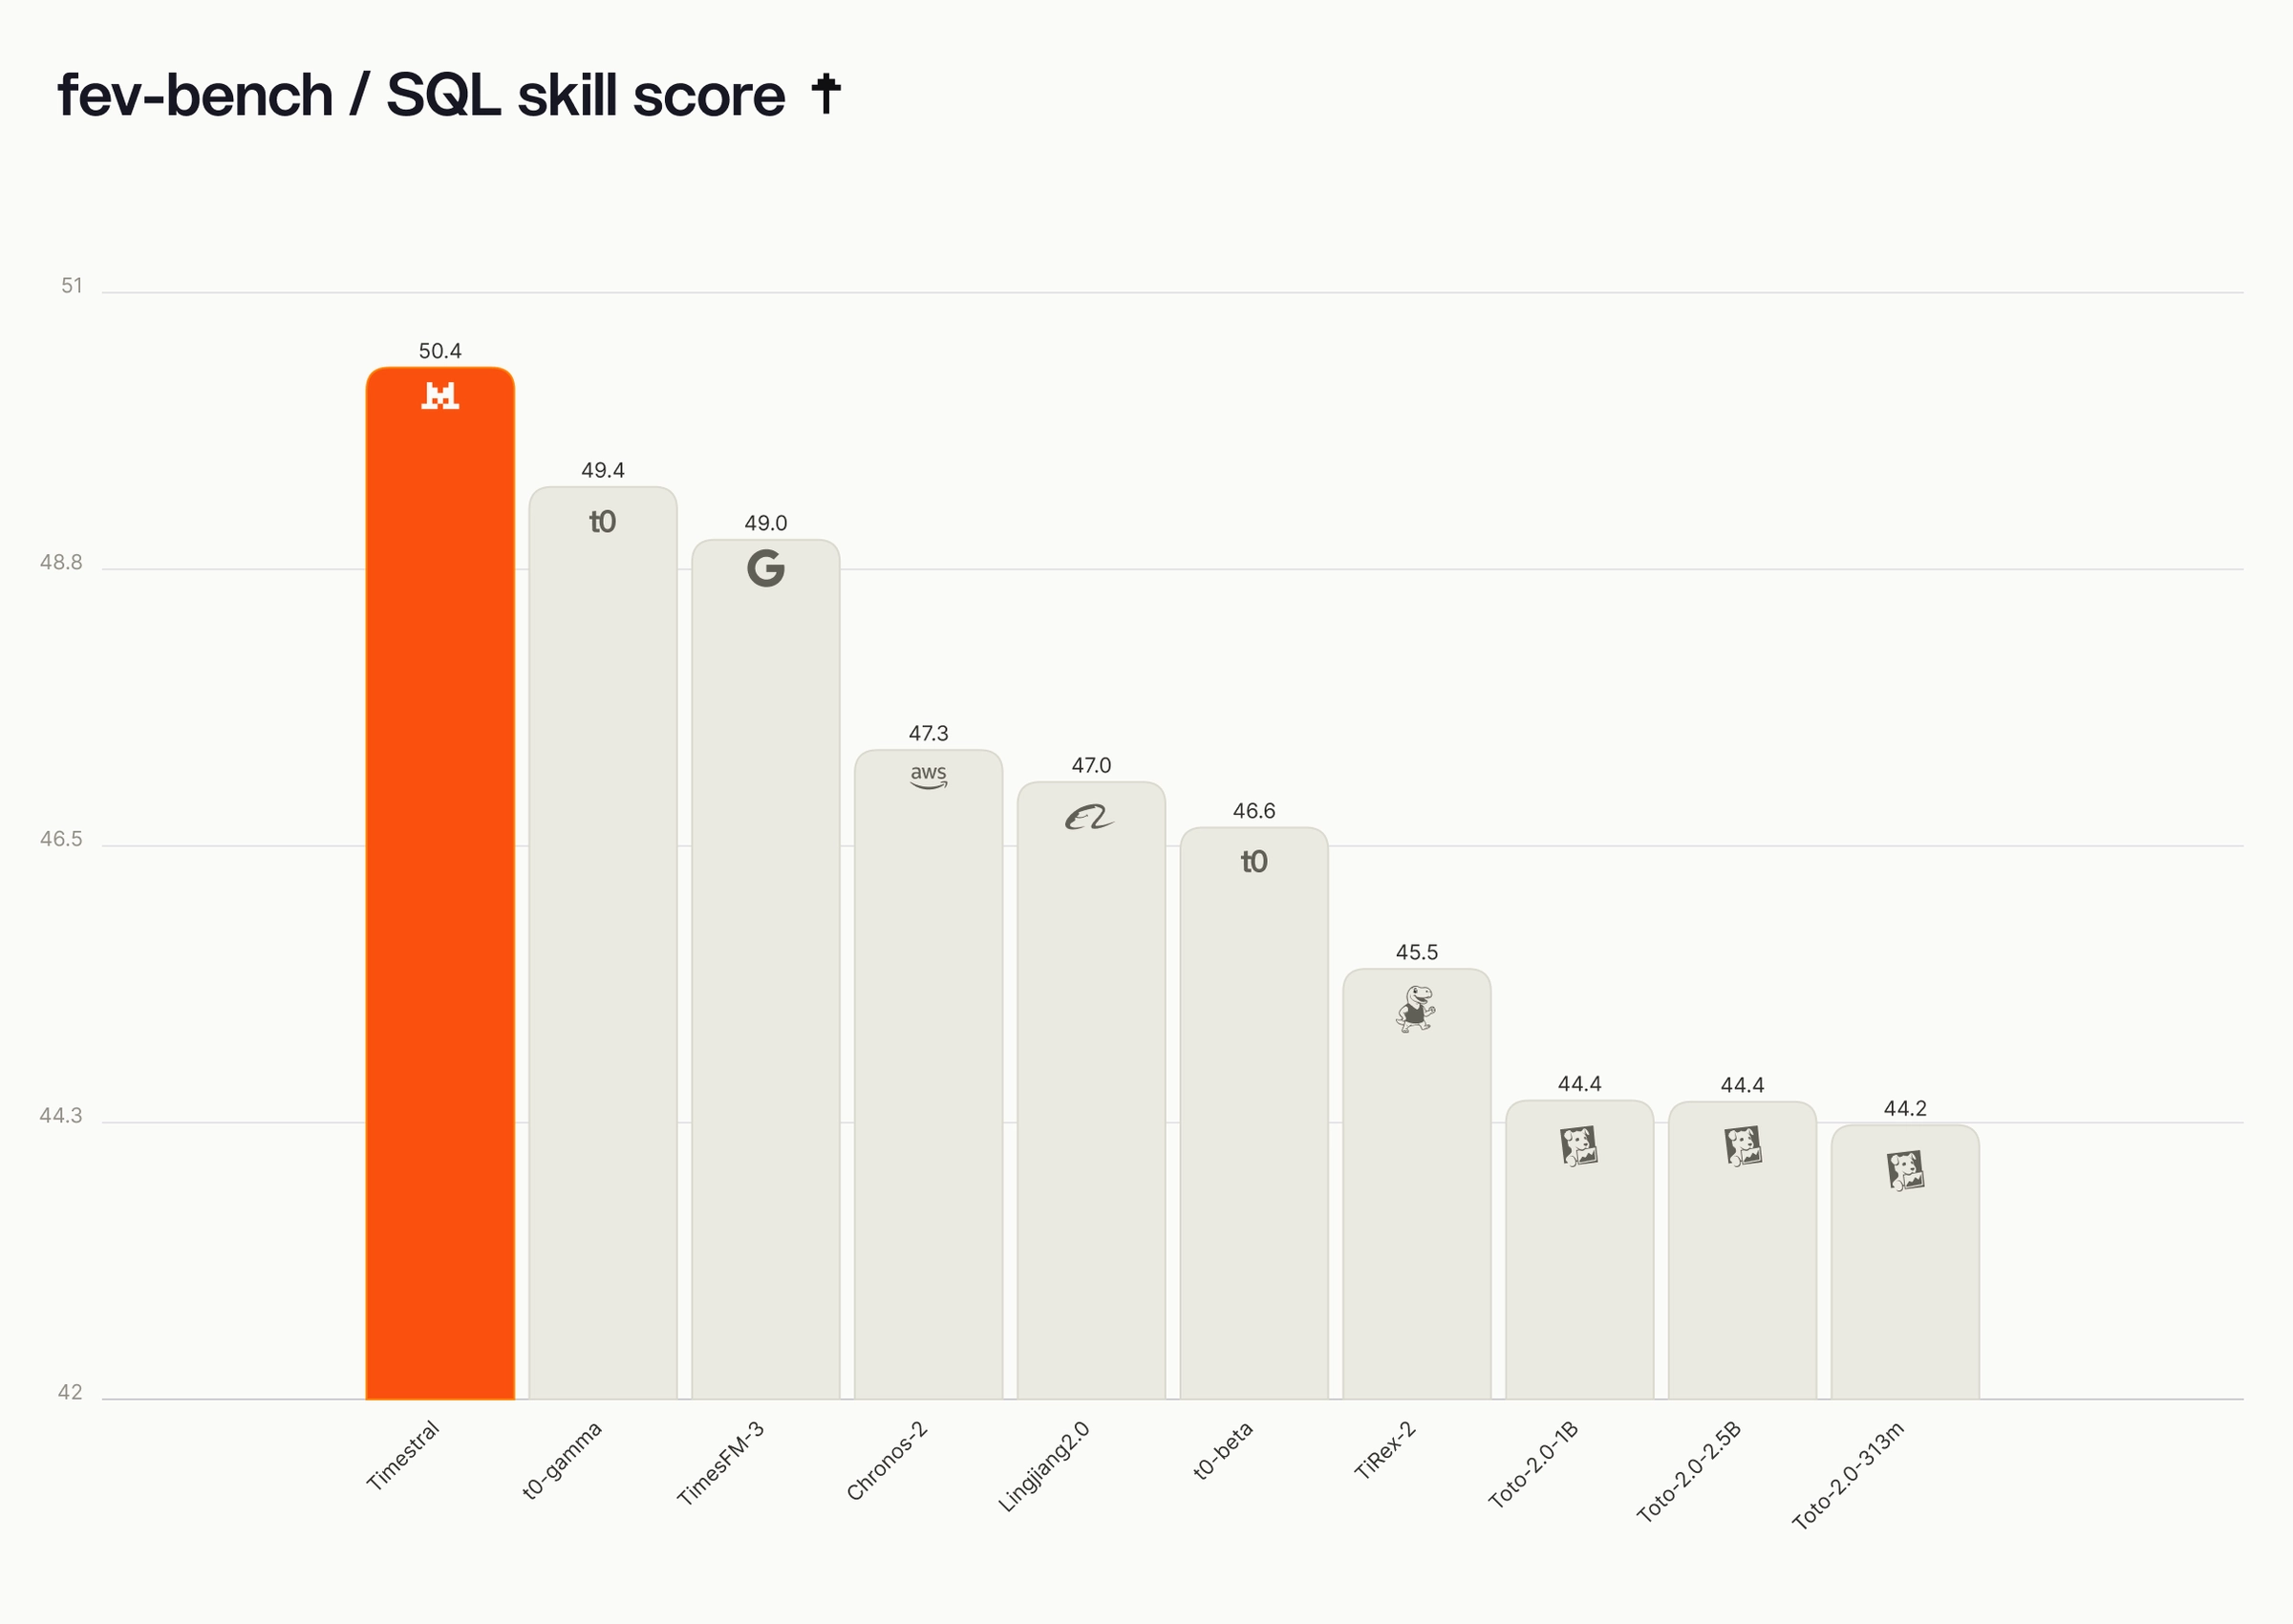
저희는 Timestral을 세 가지 주요 공개 예측 벤치마크인 GIFT-Eval, TIME, 그리고 fev-bench에서 평가했습니다. 사전 훈련되고 제로샷 모델들 중에서, 저희 모델은 다섯 가지 모든 지표에서 최고 순위를 차지합니다. 이 결과는 엔셈블링(ensembling) 없이 단일 체크포인트(checkpoint)만으로 얻어진 것입니다.
GIFT-Eval: 비교 가능한 사전 훈련 및 제로샷 항목 중 상위 10개. 숫자가 낮을수록 좋습니다.
TIME: 리더보드 항목 35개 중 상위 10개. 두 지표 모두 숫자가 낮을수록 좋습니다.
fev-bench: SQL 스킬 점수 기준으로 리더보드 항목 37개 중 상위 10개. 숫자가 높을수록 좋습니다.
모든 사양에 최적화된 모델군
Timestral은 네 가지 모델(5M, 28M, 123M, 209M 파라미터)의 패밀리로 최적화되었습니다. 더 큰 모델일수록 예측 성능이 향상되며, 작은 모델들은 더 빠르고 저렴합니다. 네 모델 모두 동일한 아키텍처와 훈련 방식을 공유합니다. 모든 크기는 정확도 대 모델 크기의 파레토 프론트(Pareto front)에 위치합니다: 즉, 각 모델 크기에서 더 잘 예측하는 공개 모델은 없습니다.
*GIFT-Eval, TIME 및 fev-bench에서의 점수 대 모델 크기 (1 - 스킬 점수로 표시). 숫자가 낮을수록 좋습니다. 저희의 28M 모델은 GIFT-Eval과 TIME에서 약 네 배 더 큰 Chronos-2를 능가합니다. 저희의 209M 모델은 파라미터 수가 적으면서 TimesFM-3 및 Falcon-2.0을 능가합니다.
Timestral은 추론(inference) 시 GPU가 필요하지 않습니다. 8개의 스레드를 가진 표준 서버 CPU에서, 3주간의 15분 간격 기록을 바탕으로 하루를 예측하는 데 5M 모델은 10ms가 소요되고 209M 모델은 140ms가 소요됩니다. 더 작은 모델들은 속도를 위해 일부 정확도를 희생합니다: 28M 모델은 209M 모델보다 5배 빠르며, 123M 모델은 지연 시간의 4분의 3 수준에서 209M 점수의 0.2% 이내에 도달합니다.
산업적 예시
수천 개의 센서가 장비 전반에 걸쳐 있는 산업 플랜트를 가정해 봅시다. Timestral은 해당 데이터의 예측을 여러 방식으로 개선할 수 있습니다.
다변량 예측(Multivariate forecasting). 펌프의 진동, 온도, 압력은 독립적으로 움직이지 않습니다. 한 가지가 상승하면 종종 다른 것의 변화를 설명하거나 유발합니다. Timestral은 관련 시계열들을 공동으로 모델링하므로, 각 센서를 개별적으로 예측하는 대신 이러한 의존성을 활용할 수 있습니다.
확률적 예측(Probabilistic forecasting). 단일 예측 값만으로는 전체 그림을 보여주지 못할 수 있습니다. Timestral은 전체 분위수(quantiles) 세트를 예측하므로, 팀들은 불확실성이 얼마나 넓은지 확인하고, 이를 반영하는 경고 임계값을 설정하며, 단일 숫자가 아닌 위험에 기반하여 유지보수를 계획할 수 있습니다.
범주형 공변량(Categorical covariates). 일부 공변량은 연속적인 숫자 대신 범주의 집합에서 값을 취합니다. 예를 들어, 요일이나 기계의 상태(가동 중, 유휴, 유지보수 중) 등이 있습니다. 이러한 것들을 숫자로 인코딩하면 본래 가지고 있지 않은 순서나 척도를 부과하게 됩니다. Timestral은 이를 범주형 입력으로 직접 받아 예측을 개선합니다.
미리 알려진 미래 공변량(Known-future covariates). 센서 동작의 일부 구동 요인은 사전에 알려져 있습니다. 예를 들어, 생산 일정, 계획된 가동 중단, 일기 예보 등이 있습니다. Timestral은 이러한 요소들을 조건화하여 예측 품질을 개선할 수 있으므로, 예정된 부하 증가는 놀라움으로 간주되기보다 예상되는 것으로 처리됩니다.
모델에서 시스템으로(From Model to System)
Timestral은 기존 모니터링 파이프라인 내에서 실행되거나, 다중 모드 에이전트 워크플로우에서 당사의 언어 모델과 결합될 수 있는 수치적 모델입니다.
플랜트에서는 다음과 같이 나타날 수 있습니다:
Timestral은 공장의 센서 스트림에서 지속적으로 실행되며, 이상 징후가 발생하는 즉시 이를 감지합니다.
펌프에서 이상 징후를 감지하면, 에이전트(agent)는 해당 신호를 임베딩하고 과거 센서 데이터의 임베딩과 비교하여 유사한 과거 고장을 찾아냅니다.
그런 다음 에이전트는 하위 에이전트를 시작하여 근본 원인 분석(root cause analysis)을 수행하며, 이를 위해 유지보수 기록, 근무 교대 일지 및 운영자 메모와 같은 해당 공장의 맥락 정보, 장비 매뉴얼, 과거 작업 지시서, 그리고 관련 장비의 측정값 등의 정보를 활용합니다.
에이전트는 발견된 내용을 바탕으로 근거 자료와 가능한 다음 단계를 포함한 제안 진단을 작성합니다.
공장 관리자는 단순히 경고(alert)를 받는 것이 아니라 센서 데이터로 뒷받침되는 진단과 계획을 받게 됩니다.
주요 기술적 기여
이러한 결과를 도출하기 위해 여러 아이디어가 결합되었습니다. 각 내용은 기술 보고서에서 자세히 설명될 것입니다.
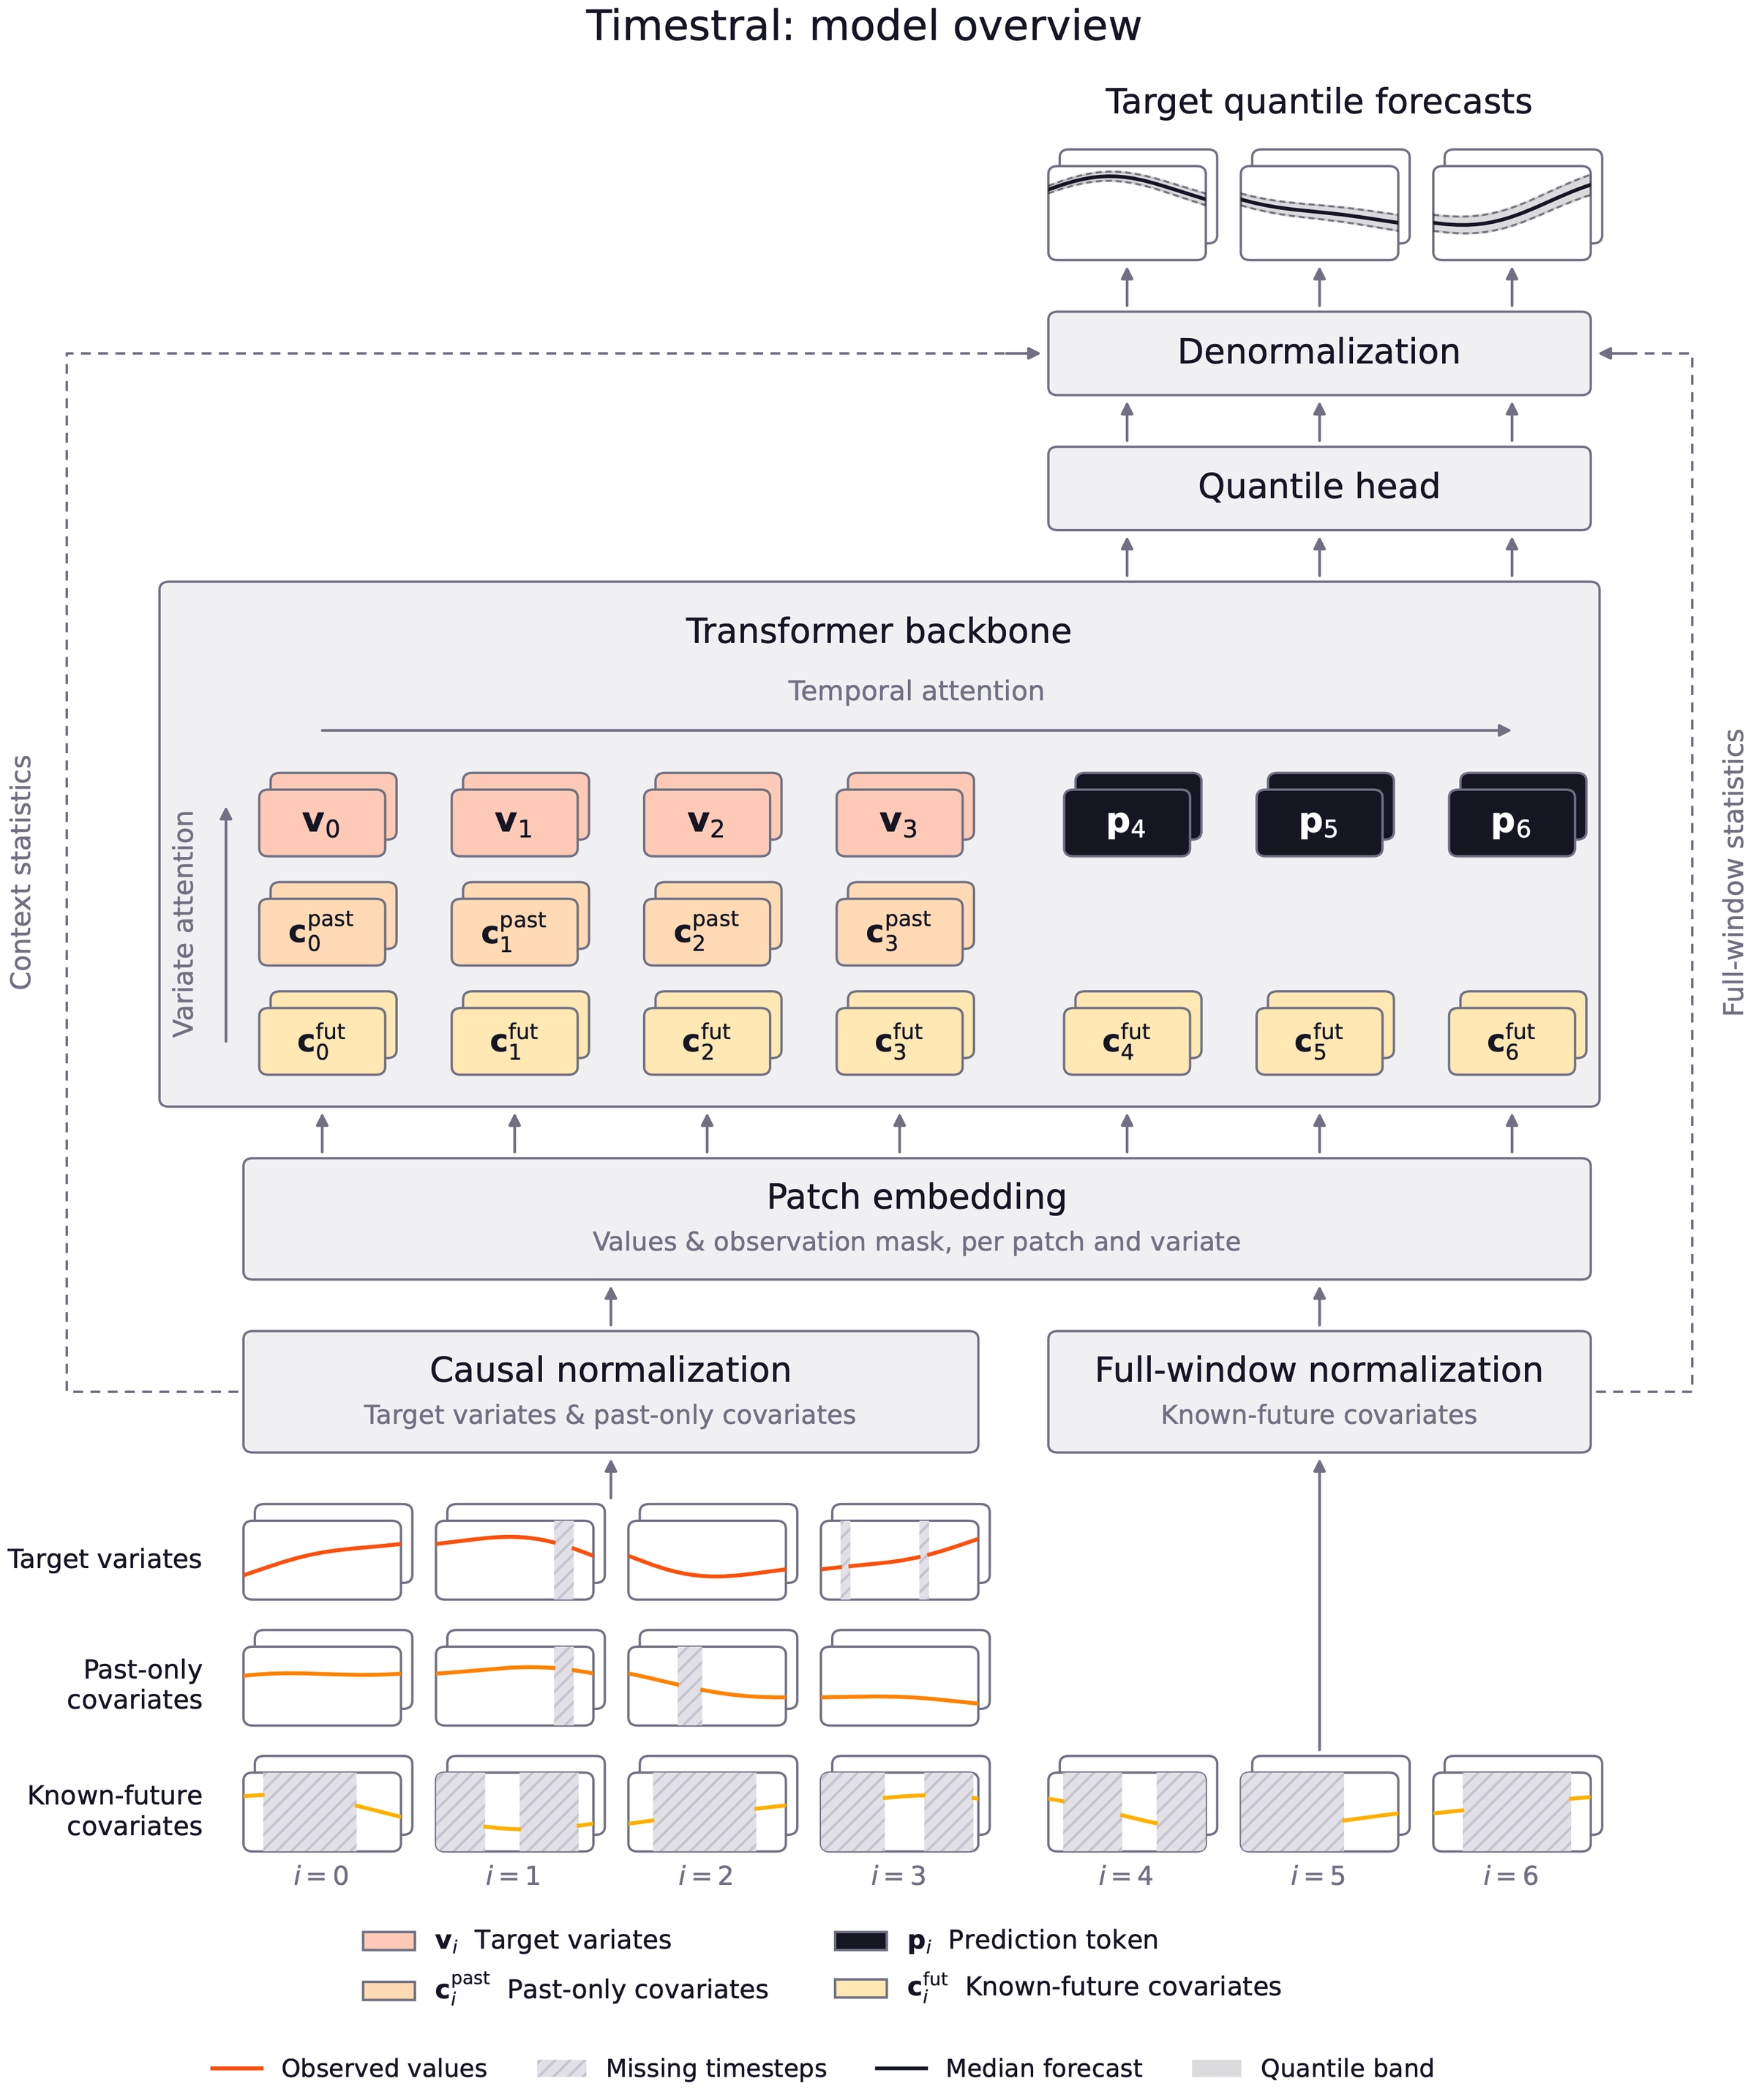
분리된 범위 예측(Decoupled Horizon Forecasting). Toto 2.0 및 TimesFM-3과 같이 연속 패치 마스킹(contiguous patch masking)으로 학습된 인과 디코더(causal decoders)는 예측해야 할 값을 마스크 처리하여 마치 누락된 값처럼 보이게 하고, 나중 예측의 컨텍스트로도 손실되게 합니다. 우리의 접근 방식인 DHF는 이 두 가지를 분리합니다: 전체 기록은 시퀀스에 유지되고, 학습된 예측 토큰(forecast tokens)이 그 이전의 기록을 읽습니다. 따라서 관측된 모든 값은 목표(target)이자 컨텍스트 역할을 하며, 실제 누락된 값은 여전히 누락으로 표시되고, 훈련 범위 길이와 누락 데이터 증강(missing-data augmentation)은 서로 독립적으로 조정될 수 있습니다.공변량 인식 어텐션(Covariate-aware attention). 각 입력 시계열(input series)에는 역할이 할당됩니다: 목표 변수(target variate), 과거 전용 공변량(past-only covariate), 또는 알려진 미래 공변량(known-future covariate)입니다. 알려진 미래 공변량은 전체 윈도우에 걸쳐 가시적이며 목표는 인과적으로 유지되고, 정보 흐름은 오직 공변량에서 목표로만 이루어집니다. 따라서 Timestral은 휴일 달력이나 일기 예보를 사용하여 목표의 미래가 예측에 새어 나가는(leaking) 것을 방지할 수 있습니다.합성 데이터 우선 방식(Synthetic-first data). 훈련 데이터의 대부분은 합성 데이터였습니다.
우리는 먼저 추세(trend), 계절성(seasonality) 및 다양한 노이즈 패턴을 포함하는 일관된 시간적 역학(temporal dynamics)을 가진 단변량 프로세스(univariate processes)를 생성했습니다. 그런 다음 다변량 합성기(multivariate synthesizer)를 사용하여 이러한 프로세스 간의 비선형 의존성(nonlinear dependencies)을 도입함으로써 다변량 시계열(multivariate series)을 구성했습니다.2단계 훈련. Timestral은 먼저 컨텍스트 크기 8192로 순수 합성 데이터에 대해 대규모 사전 훈련된 후, 4배 더 긴 컨텍스트를 가진 실제 및 합성 데이터 혼합물로 사후 훈련됩니다. 목표는 CRPS의 이산 근사치인 21 분위수(quantiles)에 대한 핀볼 손실(pinball loss)입니다.
적응 가능한 모델
공개 벤치마크는 일반적인 성능을 측정하지만, 실제 운영 데이터(production data)는 행동과 구조 면에서 크게 다를 수 있습니다. 또한 시장이 체제 변화(regime change)를 겪거나, 장비가 열화되거나, 수요 패턴이 이동함에 따라 시간이 지남에 따라 변동할 수도 있습니다. 지속적인 가치는 모델을 도메인 내 데이터(in-domain data)에 적응시키고 분포가 움직일 때 계속 재훈련할 수 있다는 점에 있습니다.
더 나아가고자 하는 조직의 경우, Timestral은 저희 언어 모델에 사용하는 것과 동일한 훈련 파이프라인인 Mistral Forge를 통해 이용 가능합니다. 이는 다음을 지원합니다:
제로샷 추론(Zero-shot inference): 별도의 작업 없이 바로 사용 가능합니다.
아키텍처 확장(Architectural extensions): 도메인별 공변량(domain-specific covariates)과 같은 확장이 가능합니다.
독점 데이터에 대한 미세 조정(Fine-tuning on proprietary data): 일반적인 성능을 유지하면서 특정 도메인에 특화할 수 있습니다.
훈련 데이터에 대한 제어(Control over the training data): 훈련 혼합물 조정, 사전 훈련 데이터 재활용(replaying pre-training data), 목표 도메인을 반영하는 합성 데이터 샘플 생성 등을 포함합니다. 데이터에 대한 완전한 통제는 우리가 백테스트한 것이 사전 훈련 중에 보지 못한 것임을 보장합니다.
전체 파이프라인은 에어갭 환경(air-gapped environments)을 포함하여 고객사의 하드웨어에서 배포될 수 있습니다.
다음 단계
사용자 여러분이 자체 데이터로 Timestral을 실행할 수 있도록 GitHub 저장소를 공개했습니다. 전체 결과가 담긴 기술 보고서가 곧 뒤따를 예정입니다. 더 전문화된 예측 문제(forecasting problems)나 연구 협업에 대해서는 저희에게 문의해 주십시오.
Timestral
| |
|---|---|
Type | 시계열 기반 모델 (TSFM) |
Parameters | 5M, 28M, 123M 및 209M |
Context length | 32,768 타임 스텝 |
Output | 확률적 예측, 21분위수
Inputs | 다변량 목표 변수(Multivariate targets), 과거 전용 및 알려진 미래 공변량(known-future covariates) |
Deployment | 온프레미스(On-prem), VPC 또는 에어갭(air-gapped) |
Licence | 수정된 MIT