지난 몇 주 동안 이 프로젝트에 매달렸습니다. 이 프로젝트의 동기, 과정, 배운 점 등에 대해 기술 보고서를 작성하는 것이 흥미로울 것 같다고 생각했습니다.
면책 조항 (DISCLAIMER): 이 저장소(github.com/hellas-ai/thunderbolt-ibverbs)의 모든 코드는 AI가 생성했습니다 (주로 Codex 5.5 및 Opus 4.7 사용). 프로젝트가 올바른 방향으로 진행되도록 충분히 이해하려고 노력했지만, 많은 경우에 실패했을 가능성이 매우 높으며, 코드에 많은 잘못된 가정, 환각(hallucinations), 그리고 단순한 어리석음이 포함되어 있을 것이라 확신합니다. 어떠한 보증이나 담보도 제공되지 않으며, 연구 용도로만 사용해야 하며, 인간이 직접 소비하기 위한 용도가 아닙니다.
요약 (TL;DR). 우리는 일반적인 USB4 연결이 저지연(low-latency), 고성능 InfiniBand 장치인 것처럼 속이는 리눅스 커널 모듈(linux kernel module)과 유저스페이스 심(userspace shim)을 작성했습니다. 이를 사용하여 두 대의 128GB Strix Halo 미니 PC 간에 분산 추론(distributed inference)을 수행합니다. Apple의 네이티브 프로토콜과의 기본적인 상호 운용성(interop)은 작동합니다.
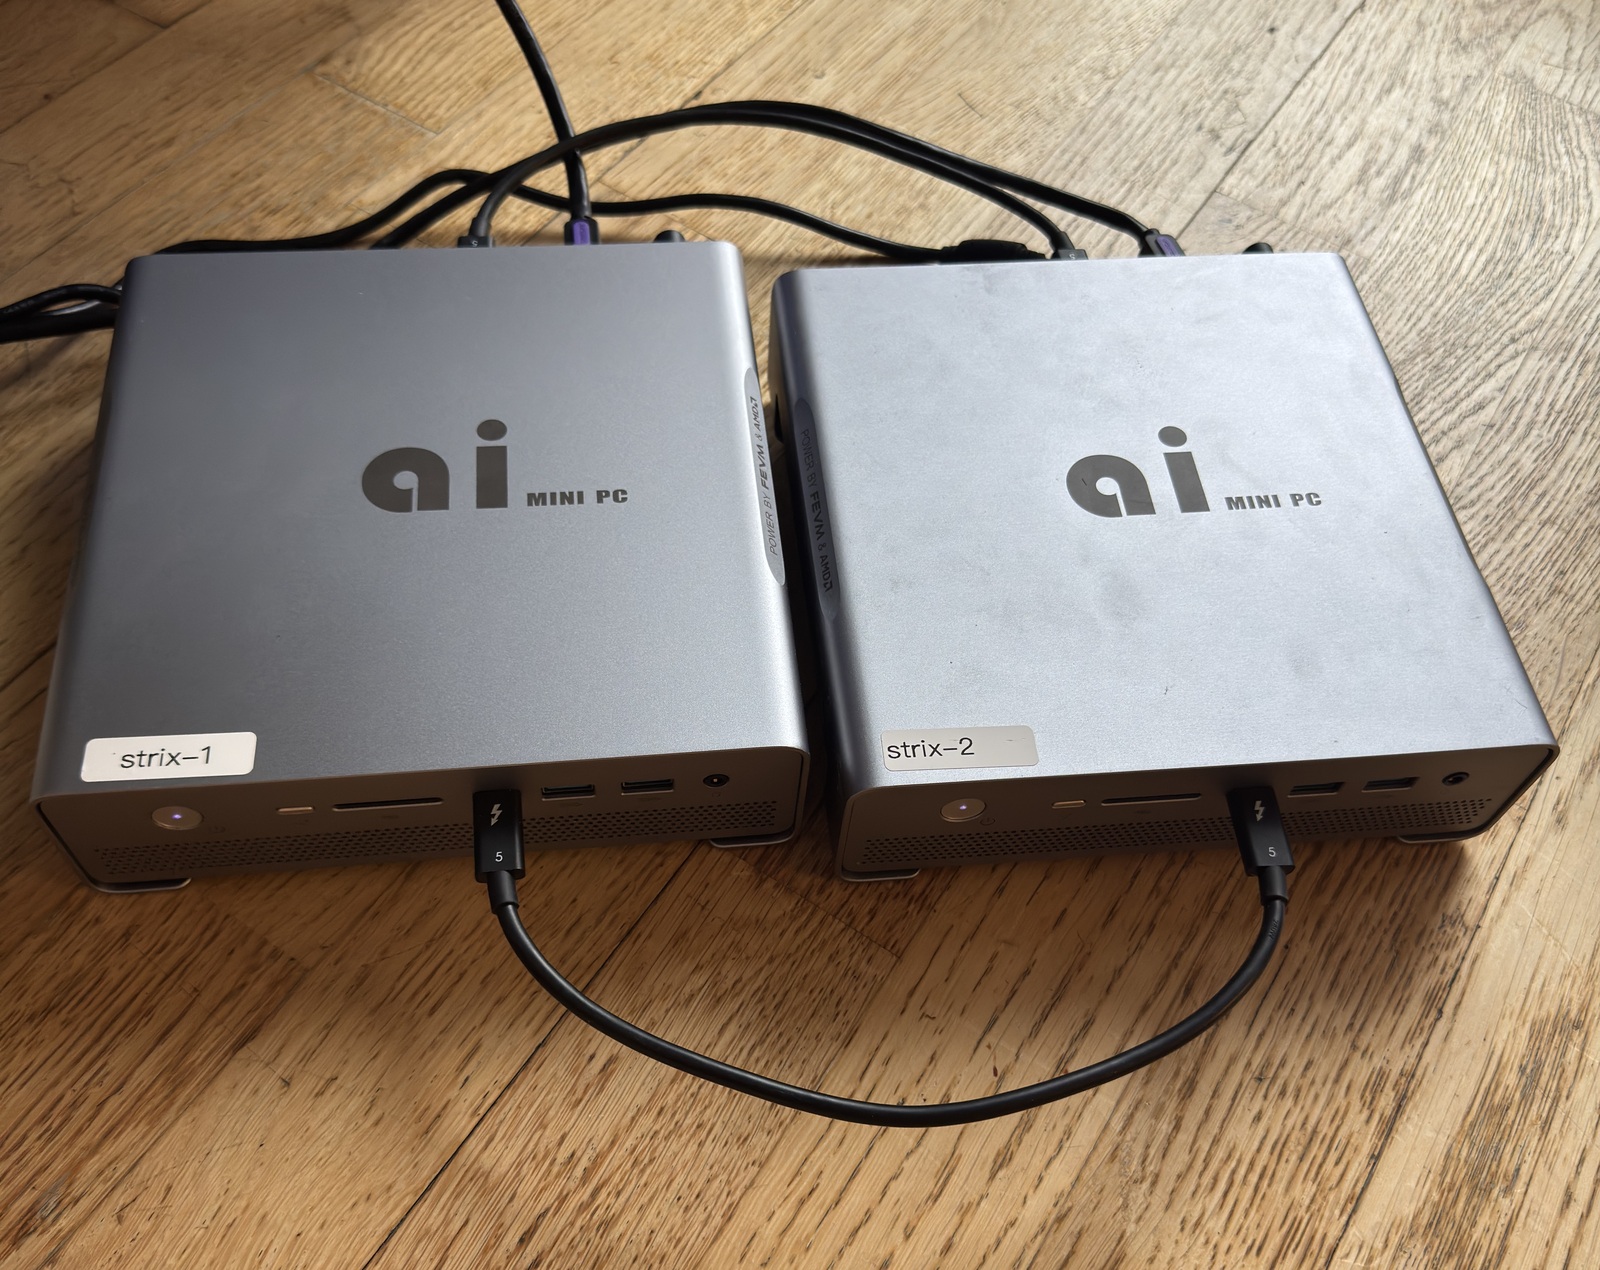
Two Strix Halo mini-PCs (strix-1, strix-2) connected by USB4
방향당 ~48 Gb/s (양방향 총 ~95 Gb/s) 지속적인 ib_write_bw,
IOMMU를 끈 상태에서 1 MiB / 8 QPs 기준 4-HCA 합계 — 온보드 2.5 GbE의 ~2.3 Gb/s 및 thunderbolt-net 기반의 soft-RoCE의 ~9 Gb/s (레일당 수준)와 비교.
64 B, 단일 QP 기준 편도 ~7 µs ib_write_lat,
RXE/2.5 GbE의 ~28 µs 및 RXE/TBnet의 ~65 µs와 비교.