Terminal-Bench-Science 0.1
Terminal-Bench-Science는 연구원들의 실제 작업 흐름(workflow)을 기반으로 AI 에이전트를 평가합니다. 모델 개발자나 데이터 공급업체가 아닌 과학자들이 AI의 과학적 역량에 대한 기준을 설정합니다.
Steven Dillmann 작성
Terminal-Bench-Science는 Stanford University의 연구원들이 주도하고, 전 세계 다양한 과학 분야 및 연구 기관의 도메인 전문가들과 협력하여 Terminal-Bench 팀이 구축한 벤치마크입니다. 이는 과학적 연구에서 가져온 다양하고 도전적인, 전문가가 선별한 워크플로우 세트를 통해 AI 에이전트의 역량을 측정합니다.
Terminal-Bench-Science는 최첨단 AI와 함께 진화하는 지속적인 벤치마크로, 과학적 요구사항과 AI 개발 사이에 피드백 루프를 만듭니다. 첫 번째 버전에는 생명과학, 물리과학, 지구과학, 수학, 공학 분야에서 가져온 70개의 과제가 포함되어 있습니다. 평가된 모델 중 가장 강력한 Claude Opus 5는 Terminal-Bench-Science 0.1에서 30%의 해결률(resolution rate)을 달성했습니다.
Terminal-Bench-Science 0.1 리더보드
Terminal-Bench-Science
Terminal-Bench가 소프트웨어 엔지니어링 분야 AI 에이전트 발전에 기여해 왔다면, Terminal-Bench-Science는 같은 목표를 과학 분야에 적용합니다. 우리의 목표는 에이전트를 개발하여 그들이 유용한 연구 조교(research assistant) 역할을 수행하도록 하는 것입니다. 이러한 에이전트는 기술적으로 까다롭고 시간이 많이 소요되는 워크플로우를 실행함으로써, 과학자들이 인간의 판단이 가장 중요한 부분—연구 질문 정의, 가설 형성, 결과 해석 및 검증, 발견 공유 등—에 더 많은 시간을 집중할 수 있도록 해방시킵니다. 이러한 역할에서 AI 에이전트는 연구원들이 달성하는 것을 확장하고 과학적 발견을 가속화하는 데 도움을 줄 수 있습니다.
이를 위해서는 실제 과학적 관행을 반영하고, 역량에 대한 검증 가능한 증거를 제공하며, AI의 최전선과 함께 진화하는 벤치마크가 필요합니다.
우리는 실제 과학 워크플로우에서 도출된 벤치마크가 필요합니다. 과학적 역량은 교과서 질문이나 표준화된 연습 문제가 아닌, 실제로 활동하는 과학자들 자신에 의해 기여된 실제 연구 관행을 통해 평가되어야 합니다. Terminal-Bench-Science는 다양한 분야의 과학자들이 자신이 중요하게 생각하는 문제들에 대한 AI 발전을 위한 기준을 설정할 수 있는 직접적인 목소리와 공유 플랫폼을 제공합니다. 과학에서의 이해관계는 너무나 높기 때문에, 그 벤치마크는 외부적 관심사보다는 과학 공동체의 우선순위를 반영해야 합니다.
우리는 과학적 역량에 대한 검증 가능한 증거가 필요합니다. 신뢰할 수 있는 평가 없이는 에이전트의 능력이 향상되고 있는지, 아니면 그 한계가 어디에 남아있는지 알 수 없습니다. Terminal-Bench-Science는 현실적인 환경에서 에이전트를 평가하며, 재현 가능하고 작업별 테스트를 통해 분석(analyses), 시뮬레이션(simulations), 증명(proofs), 코드(code), 데이터 제품과 같은 구체적인 아티팩트들을 등급화합니다.
우리는 최첨단에 발맞추는 벤치마크가 필요합니다. 과학적 벤치마크는 너무 자주 출판할 논문으로 취급될 뿐, 진전을 이끄는 메커니즘으로 다루어지지 않습니다. 그것들은 한 번 출시된 후 모델이 발전하고 알려진 한계가 지속됨에 따라 방치됩니다. Terminal-Bench-Science는 AI 최전선과 함께 진화하는 연속적인 벤치마크입니다. 정기적인 출시를 통해 과학자들은 새로운 워크플로우에 기여하고, 기존 작업을 개선하며, 과학적 필요와 AI 개발 간의 피드백 루프를 만들 수 있습니다.
Terminal-Bench-Science 피드백 루프
Terminal-Bench-Science 0.1은 생명과학(life), 물리과학(physical), 지구과학(earth), 수학(mathematical), 공학(engineering) 과학 전반에 걸쳐 70개의 작업을 포함합니다. 작업들은 과학적 데이터 분석, 통계 추론(statistical inference), 시뮬레이션, 최적화(optimization), 정리 증명(theorem proving), 이미지 재구성(image reconstruction), 신호 처리(signal processing), 역문제(inverse problems), 센서 보정(sensor calibration), 모델 피팅(model fitting), 분류(classification), 그리고 과학적 머신러닝(scientific machine learning)에 걸쳐 있습니다.
Terminal-Bench-Science 0.1 작업 범위
작업들은 GitHub의 공개적인 프로세스를 통해 연구자들에 의해 기여되며, #tb-science에서 논의와 피드백이 이루어집니다.
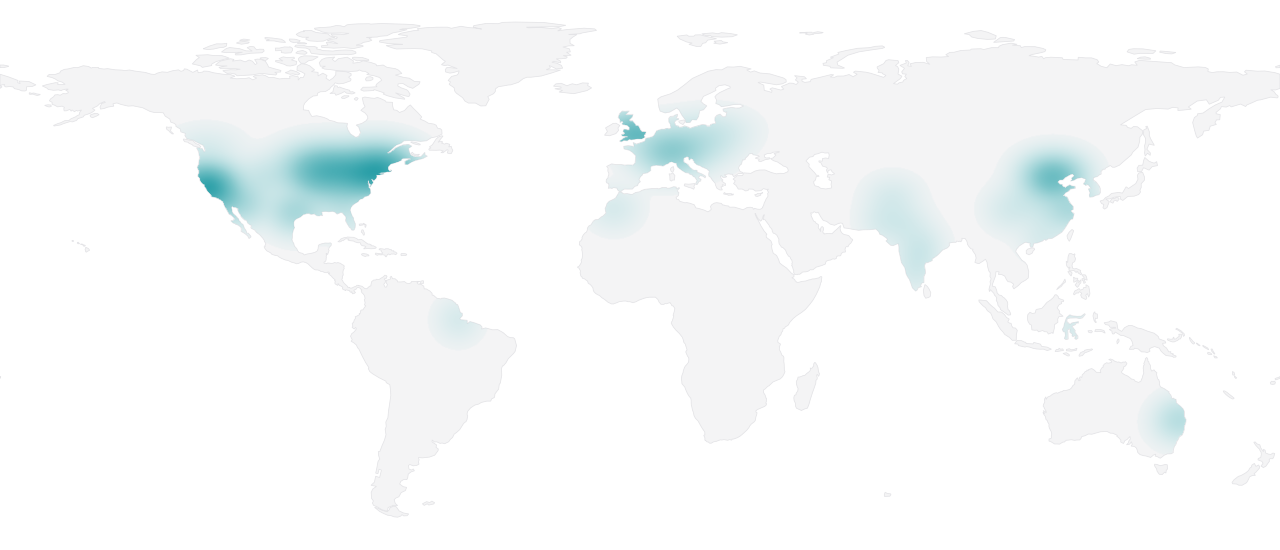
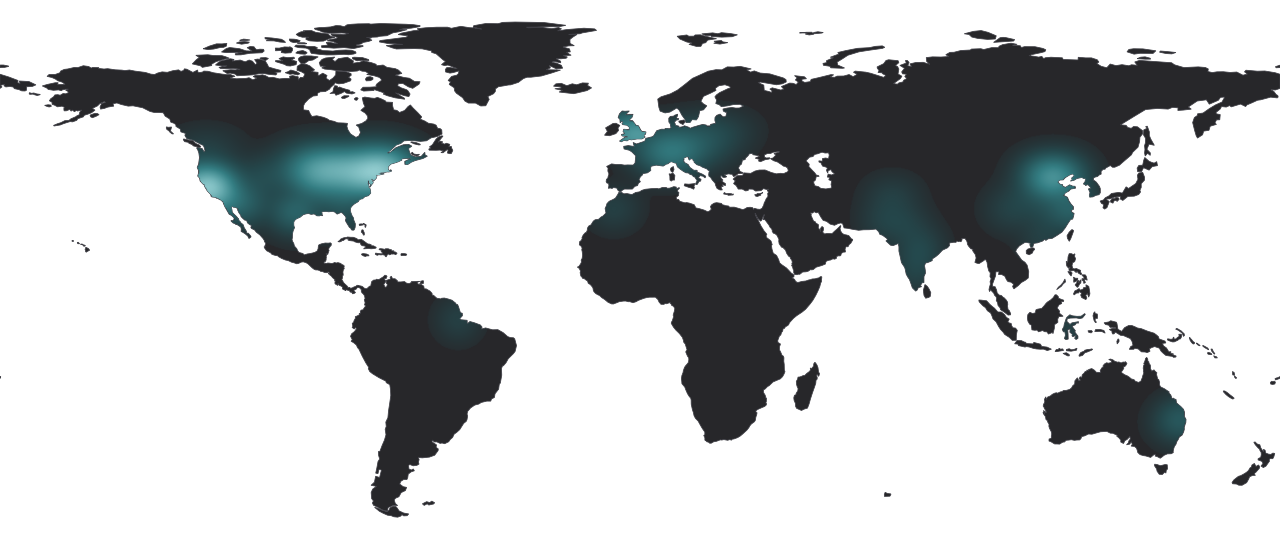
Discord 채널에서 기여가 이루어집니다. 기여는 제안(proposals)으로 시작되며, 검토자들이 각 아이디어를 논의하고 피드백을 남기며, 벤치마크에서 측정할 가치가 있는 과학적으로 근거 있는 워크플로우처럼 보이는 것을 승인합니다. 승인된 제안은 풀 리퀘스트(pull requests)로 구현되는데, 여기서 검토자들은 각 작업이 객관적으로 검증 가능하고, AI 에이전트에게 진정으로 도전적이며, 오늘날의 최첨단 시스템들이 이미 쉽게 해결하는 문제가 아닌지 확인합니다. 병합(merge)을 위해서는 도메인 검토자들이 과학적 타당성과 현실성을 평가하고, 기술 검토자들이 작업 구성과 검증을 점검하며, 품질 향상자(bar raiser)가 최종 품질 검사를 수행합니다. 920개의 제안 중 464개가 구현 승인을 받았고 386개의 풀 리퀘스트가 열렸지만, 단지 70개의 작업만이 Terminal-Bench-Science 0.1에 포함되었습니다. 이러한 높은 선택률은 과학적으로 흥미롭고, 최첨단 에이전트에게 도전적이며, 엄격한 평가를 위해 충분히 잘 명시된 작업을 만드는 것이 얼마나 어려운지를 반영합니다. 제안, 풀 리퀘스트, 검토 전반의 진행 상황은 공개 작업 대시보드에서 추적됩니다.
Terminal-Bench-Science 0.1 기여
World map showing the geographic density of Terminal-Bench-Science proposal and implementation authors using public profile locations and affiliations
World map showing the geographic density of Terminal-Bench-Science proposal and implementation authors using public profile locations and affiliations
Terminal-Bench-Science 0.1은 과학 연구 분야 AI 에이전트에 대한 상당한 발전 가능성을 보여줍니다. 평가된 각 모델은 모든 70개 작업을 대상으로 독립적인 세 번의 시도를 수행했습니다. Claude Opus 5는 Claude Code와 결합하여 30.0%로 가장 높은 해결률을 기록했으며, GPT-5.6 Sol은 Codex를 사용해 22.4%, Claude Fable 5는 Claude Code를 사용하여 21.4%를 달성했습니다. Claude Opus 4.8은 중간 수준인 10.5%에 머물렀습니다. GPT-5.6 Terra, Kimi K3, Grok 4.6 모두 10% 미만의 작업을 해결했습니다. GLM 5.3이 가장 강력한 오픈 모델로 8.1%를 기록했으며, GPT-5.6 Luna가 3.3%로 가장 낮았습니다.
Terminal-Bench-Science는 Terminal-Bench 3.0과 비슷한 수준의 시스템을 구별하는 동시에, 두 가지 모두에서 평가된 모든 모델에 대해 해결률을 10 퍼센트 포인트 이상 하락시키는 것을 목표로 합니다. 이러한 격차는 의도적인 것입니다. 검토 과정 동안 작업들은 최신 최첨단 모델들에게 도전하도록 조정되었기 때문입니다.
Terminal-Bench-Science와 Terminal-Bench 비교
성능은 발전의 단지 한 차원에 불과합니다. 비용-해상도 플롯(cost-resolution plot)은 모든 70개 태스크에 걸친 총 평가 비용을 해상도율(resolution rate) 대비 보여줍니다. GPT-5.6 Luna, Kimi K3, 그리고 GPT-5.6 Terra는 낮은 비용의 영역에서 우위를 점합니다. GPT-5.6 Sol과 Claude Opus 5는 더 높은 비용으로 가장 높은 해상도율에 도달하며, 이 중 Opus 5가 $7.0k로 가장 높습니다. GPT-5.6 Sol은 Claude Fable 5와 비슷한 성능을 보여주면서도 비용은 3분의 1 이하($4.2k 대 $14.2k)입니다. 토큰 사용량(Token usage)은 다른 영역의 경계를 보여줍니다. Claude Fable 5는 GPT-5.6 Sol과 비슷한 성능을 보이면서도 약 4분의 1 적은 토큰을 사용합니다(6.4B 대 8.4B). Kimi K3가 낮은 토큰 사용량 끝점을, 그리고 Claude Opus 5가 높은 해상도 끝점을 담당합니다. 두 파레토 경계선(Pareto frontiers)에 동시에 나타나는 모델은 Kimi K3와 Claude Opus 5뿐입니다.
Terminal-Bench-Science 0.1 비용 대 해상도율
Terminal-Bench-Science 0.1 토큰 사용량 대 해상도율
해상도율은 과학 분야별로도 다릅니다. Anthropic과 OpenAI 모델은 공학 과학(engineering sciences)을 제외한 모든 분야에서 상위 두 자리를 차지합니다. 다만, 공학 과학에서는 Grok 4.6이 낮은 비용과 토큰 사용량으로 GPT-5.6 Sol과 공동 2위를 기록했습니다(14.8%). Claude Opus 5는 수학 과학(mathematical sciences)을 제외한 모든 분야에서 GPT-5.6 Sol 및 Claude Fable 5보다 우수합니다. 다만, 수학 과학에서는 Claude Fable 5(33.3%)와 GPT-5.6 Sol(31.4%)이 상위 두 자리를 차지했습니다. 전체 분야별 상세 분석은 리더보드에서 확인할 수 있습니다.
Terminal-Bench-Science 0.1 분야별 해상도율
- Opus 5
- GPT-5.6 Sol
- Grok 4.6
Terminal-Bench-Science 0.1은 Life, Physical, Earth, Mathematical, 그리고 Engineering 과학 전반에 걸쳐 연구원들이 Terminal-Bench 및 Harbor 팀과 함께 진행한 공동 노력의 결과물입니다. 이는 우리가 공개적으로 구축할 수 있는 가장 엄격한 과학 에이전트 역량 벤치마크이며, 저희는 이제 막 시작했을 뿐입니다: Terminal-Bench-Science 0.1은 지속적인 벤치마크의 첫 번째 출시 버전입니다.
정기 릴리스를 통해 새로운 과제가 추가되고, 다섯 가지 과학 분야 전반에 걸쳐 커버리지를 넓히며, 에이전트가 포화시키거나 검토 결과 명세가 불분명하다고 밝혀진 과제는 폐지하고, 새로운 최첨단 모델(frontier models)이 출시됨에 따라 리더보드를 최신 상태로 유지할 것입니다. 각 릴리스는 당시의 최첨단 수준을 기준으로 조정됩니다. Terminal-Bench-Science 0.1의 경우, 이는 Claude Opus 5와 GPT-5.6 Sol을 기준으로 했으며, 더 강력한 모델들이 등장함에 따라 이를 활용하여 새롭고 개선된 과제들을 평가하고 조정할 것입니다. 과제들은 버전 관리되어 있어 단일 Harbor 명령으로 시험을 재사용하거나, 재채점하거나, 다시 실행할 수 있으며, 이는 결과 업데이트 비용을 낮게 유지합니다. 진행 상황은 개방형 과제 대시보드에서 추적되며, 모든 릴리스는 GitHub와 Harbor Hub에 태그됩니다.
Terminal-Bench-Science 0.2 작업이 이미 진행 중이며, 풀 리퀘스트 마감일은 2026년 10월 5일입니다. 만약 연구자로서 최첨단 에이전트가 수행할 수 있어야 하지만 아직 할 수 없는 워크플로우를 가지고 계시다면, 저희에게 알려주십시오. 기여 흐름은 **제안(Propose) → 구축(Build) → 검토(Review)**입니다: 과제 제안 양식을 통해 과제를 제안하고, 기여 가이드를 따라 구축하며, 이는 병렬 도메인 및 기술 검토와 최종 승인자(bar-raiser)의 승인을 거쳐 병합됩니다.
Discord와 GitHub의 #tb-science에서 노력에 동참해 주시고, 프로젝트 캘린더를 통해 매주 열리는 회의와 오피스 아워에 참여해 주세요. 함께 과학자들이 AI가 갖춰야 할 과학적 역량이 무엇인지 정의하고 엄격하게 측정하도록 합시다.
이 작업이 유용하다고 생각하시면 인용해 주십시오. DOI 10.5281/zenodo.22110253은 개념 DOI이며 항상 최신 릴리스로 연결됩니다. 특정 릴리스를 인용하려면 Zenodo 기록에서 해당 버전의 DOI를 사용하십시오.
Terminal-Bench-Science Team. (2026). Terminal-Bench-Science: Evaluating AI agents on research workflows across scientific domains [Computer software]. https://doi.org/10.5281/zenodo.22110253
Terminal-Bench-Science의 모든 태스크 기여자, 리뷰어, 자문위원분들께 감사드립니다.
프로젝트 리드 자문위원인 Ludwig Schmidt와 Sanmi Koyejo에게 특별히 감사를 표합니다. 또한 선임 리뷰어 Allen Hart, Ivan Bercovich, Joseph Janssen, Jiaming Hu, Steffen Bollmann, Sergey Aganezov; AI 연구 자문위원 Ryan Marten, Alex Shaw, Lin Shi, Benjamin Feuer, Mike A. Merrill, Alex Dimakis, Jenia Jitsev, Bodhisattwa Majumder, Peter Clark, Thomas Wolf, Braden Hancock, Andy Konwinski에게 감사를 표합니다. 과학 자문위원으로는 Sara Beery, Jo Dunkley, J. Nathan Kutz, Ching-Yao Lai, Scott Linderman, Emma Lundberg, Russ Poldrack, Aviv Regev, Risa Wechsler가 있습니다.
Terminal-Bench-Science는 Stanford University와 Laude Institute가 주최하고, Stanford AI Lab (SAIL), Stanford Institute for Human-Centered Artificial Intelligence (HAI), Stanford AI Measurement Science (AIMS), NSF AI Institute for Foundations of Machine Learning (IFML), Allen Institute, 그리고 Allen Institute for AI (Ai2)와의 파트너십을 통해 운영되는 공개 학술 협력 프로젝트입니다. Terminal-Bench 프랜차이즈의 일부로서, Terminal-Bench와 Harbor 팀은 과학 기여자 커뮤니티와 함께 이를 구축했습니다.
Slingshots 프로그램을 통한 지원에 대해 Laude Institute에 감사드리며, Open Benchmarks Grants 프로그램을 통한 지원에 대해 Snorkel AI에 감사를 표합니다. 또한 태스크 리뷰 및 큐레이션을 지원하는 PP API 크레딧을 제공한 2077AI Open Source Foundation, 그리고 Terminal-Bench-Science를 지원해 준 UniPat AI와 Modal에게 감사드립니다. 리더보드 평가를 지원하기 위해 API 크레딧을 제공한 Bespoke Labs, Anthropic, Google, Moonshot AI, SpaceXAI, Z.ai에도 감사를 표합니다.