terse - Claude가 자연스럽게 말하도록 만듭니다
<div align="center">
terse
</div>
저는 Claude Code가 저에게 말을 거는 방식에 어려움을 느낍니다. 모든 질문이 에세이처럼 돌아옵니다. 슬로건, 은유, 방금 무엇을 했는지 요약, 'X가 아니라 Y입니다'. 매번요.마다.
Claude 자체의 '간결한(concise)' 모드가 어느 정도는 줄여주지만, 나머지 잡다한 내용은 그대로 남겨둡니다.
저는 시스템 프롬프트를 시도해봤지만, 몇 번의 대화가 지나면 잊히곤 했습니다. 플러그인을 찾아보기도 했지만, Claude가 정상적으로 말하게 만드는 것은 없었습니다. 어떤 것은 슬래시 명령어(slash commands)를 사용했고, 다른 것은 토큰 사용을 해결해주었으며, 또 다른 것은 신경다양성(neurodivergence)에 초점을 맞췄습니다. 그 어떤 것도 Claude가 자연스럽게 말하도록 만들지는 못했습니다.
저는 단지 에세이를 읽는 것이 아니라, 매번 빠르게 핵심만 파악하고 싶었습니다.
그래서 몇 주 동안 제가 짜증 났던 모든 것과 대신 어떻게 말해주길 바라는지를 정리했고, 이를 기반으로 플러그인을 만들었습니다. 저에게는 효과가 있었습니다. 만약 Claude가 당신에게 똑같은 방식으로 말을 건넨다면, 그것은 당신의 문제입니다.Same prompt on Opus 5.5: vanilla Claude Code at 636 words against terse at 180 words
이 README의 나머지 내용은 terse 플러그인을 사용한 Claude Code가 공동 작성했습니다. 저는 대부분의 공을 세웠지만, 단어에 대한 공은 없습니다.
응답 길이를 절반으로 줄이고 꾸밈말 같은 문체를 제거하는 Claude Code 플러그인입니다. Fable 5.1: 단어 수 46% 감소, 비용 51% 절감. Opus 5.5: 단어 수 54% 감소, 비용 32% 절감. 측정은 실제 코드베이스를 대상으로 한 20개 프롬프트에 대해 측정되었습니다. 이 작성 규칙은 응답, 문서, 커밋 및 서브 에이전트(subagents)에 적용됩니다. 상태 표시줄에는 컨텍스트 미터가 함께 제공됩니다.
표들은 다음 용어들을 사용합니다.
Vanilla는 CLAUDE.md가 없고 플러그인이나 사용자 지정 지침이 없는 Claude Code입니다.
스타일 위반(style violation)은 규칙 중 하나를 어기는 문장입니다. Opus 5 심사관은 각 응답을 규칙 목록과 비교하여 이를 계산합니다. 카운트는 1,000단어당으로 이루어지므로, 길고 짧은 응답이 동일하게 비교됩니다.
은유(Metaphor)는 문자 그대로의 구절이 존재하는 곳에 비유적인 표현을 사용하는 것입니다. "3,000줄 병합 작업은 간략히 훑어보고 기도하는 정도다"라는 표현은 "3,000줄 병합 작업은 10분간 읽고 줄별 검토를 하지 못한다"는 표현 대신 사용됩니다.
"X가 아니라 Y(X, not Y)" 재구성 방식은 설명 대신 대비되는 레이블을 사용하는 것입니다. "이것은 의도이지 행동이 아니다"라는 표현은 "문서 문자열에는 X라고 되어 있고, 코드는 Y를 수행한다"라는 설명 대신 사용됩니다.
슬로건(slogan)은 원칙처럼 들리지만 어떤 메커니즘도 명시하지 않는 짧은 문구입니다. "결정이 곧 기능이다."
운율(Cadence)은 삼화음이나 클라이맥스 엔딩과 같이 효과를 위해 만들어진 리듬입니다.
부풀림(Bloat)은 "지금 코드를 살펴볼게요"와 같은 서술을 포함하여 사실을 추가하지 않는 문장입니다.
1인칭(First person)은 "나(I)", "내게(me)", "나의(my)", "내가 ~하게 하다(let me)" 및 그 축약형입니다. 주어가 작성자인 문장을 말합니다.
출력 토큰(Output tokens)은 모델이 생각하는 과정까지 포함하여 작성한 내용입니다. Opus와 Fable에서 출력 토큰은 입력 토큰보다 약 5배 높은 가격으로 책정됩니다.
공개 프롬프트 12개를 기준으로 측정되었습니다. vanilla Claude Code와 terse 1.1.0을 비교했으며, Opus 5.5를 사용했고 난이도는 높았으며 각각 한 번씩 실행했습니다.
| vanilla | terse | 변화율 |
|---|
| 단어 수 (10개 채팅 응답) | 5,959 | 1,793 | -70% |
| ... | | | |
| Fable 5.1용 표, Opus 5.5의 난이도 중간(effort medium)에 대한 표, 그리고 1.0.0 규칙 텍스트: docs/models. 방법론, 프롬프트 및 심사 기준: docs/benchmark.md. | | | |
설치 (Install)
Claude 디렉토리에서 다음을 수행하세요: terse 목록 보기를 열고 Claude Code에 추가를 선택합니다. 이 플러그인은 claude.ai 계정에 저장되며, 해당 계정으로 로그인하여 Claude Code를 다시 시작할 때 다운로드됩니다. 실행 중인 세션에서는 /reload-plugins를 사용하면 한 번에 로드됩니다. Anthropic은 디렉토리가 제공하기 전에 각 버전을 스캔하고 검토합니다.
GitHub에서 Claude Code 내에서:
/plugin marketplace add lowenbjer/claude-terse
/plugin install terse@terse
두 경로는 동일한 파일을 설치합니다. 작성 규칙은 /clear 이후의 모든 새 세션과, 종료했다가 claude --resume으로 재개하는 기존 세션에 적용됩니다.
컨텍스트 미터를 위해 한 번 /terse:install-meter를 실행하세요. 이 명령어는 26줄짜리 미터 스크립트를 플러그인의 데이터 디렉토리에 복사하며, 플러그인 업데이트가 그대로 남겨두고, ~/.claude/settings.json에 하나의 statusLine 항목을 추가합니다. 이 항목은 저장 시 효력이 발생합니다.
얻게 되는 것
규칙은 답변의 형태를 규정하며, 22개의 규칙과 18쌍의 전후(before/after) 쌍으로 구성되어 총 877단어입니다. 그 형식은 다음과 같습니다: 답변을 담은 한 문장, 다음 목록 또는 표, 그리고 최대 하나의 주의사항 문장으로 끝나며 종료합니다. 모든 문장은 주제를 주어로 가지며,
규칙은 출력 스타일로 제공됩니다. 플러그인이 활성화된 동안 적용되며 메인 에이전트의 시스템 프롬프트(system prompt) 일부입니다. 서브 에이전트는 자체 시스템 프롬프트를 실행하므로, SubagentStart 훅(hook)을 통해 동일한 텍스트가 전달됩니다. 어떤 훅도 내용을 재작성하거나 차단하지 않습니다.
리마인더(reminder)가 존재하는 이유는 출력 스타일이 컨텍스트(context)의 첫 부분이기 때문입니다. 20~30턴(turns) 후에는 현재 프롬프트로부터 100k 토큰 떨어진 곳에 위치합니다. 모델 자체의 최근 답변들이 가장 가까운 스타일 예시가 됩니다. 그 이후부터는 답변이 마지막 줄, "확인했습니다(I checked)" 문장, 대시(-), "X가 아니라 Y" 형식, 그리고 슬로건 형태로 나타납니다. UserPromptSubmit 훅은 전체 규칙 세트를 576자로 압축하여 사용자의 텍스트 옆 모든 프롬프트에 추가합니다. 턴당 비용은 약 145개의 입력 토큰(input tokens)입니다. 해당 텍스트는 rules/REMINDER.md입니다.
미터(meter)는 모델 이름과 컨텍스트 채움 정도를 백분율로 보여줍니다. 녹색은 37% 미만, 노란색은 37%부터, 주황색은 49%부터, 해골 모양 아이콘은 60%부터입니다. 이 임계값(thresholds)들은 일반적인 50%, 65%, 80%보다 낮은 수준으로 설정되어 있습니다. 세 가지 연구는 큰 컨텍스트 창이 가득 차기 훨씬 전에 검색 품질(retrieval quality)이 저하됨을 보여줍니다:
- Chroma의 Context Rot 보고서: 18개 모델에서 200k 창(window)에 걸쳐 50k 토큰부터 성능 저하 발생.
- NoLiMa: 13개 모델 중 11개가 32k 토큰에서 기준선(baseline)의 절반 수준에 도달.
- Lost in the Middle: 긴 컨텍스트의 중간에 있는 내용은 시작 부분과 끝 부분보다 적은 주의를 받음.
이 임계값들은 statusline/context-meter.js 상단 근처의 세 가지 숫자입니다.
이전과 이후
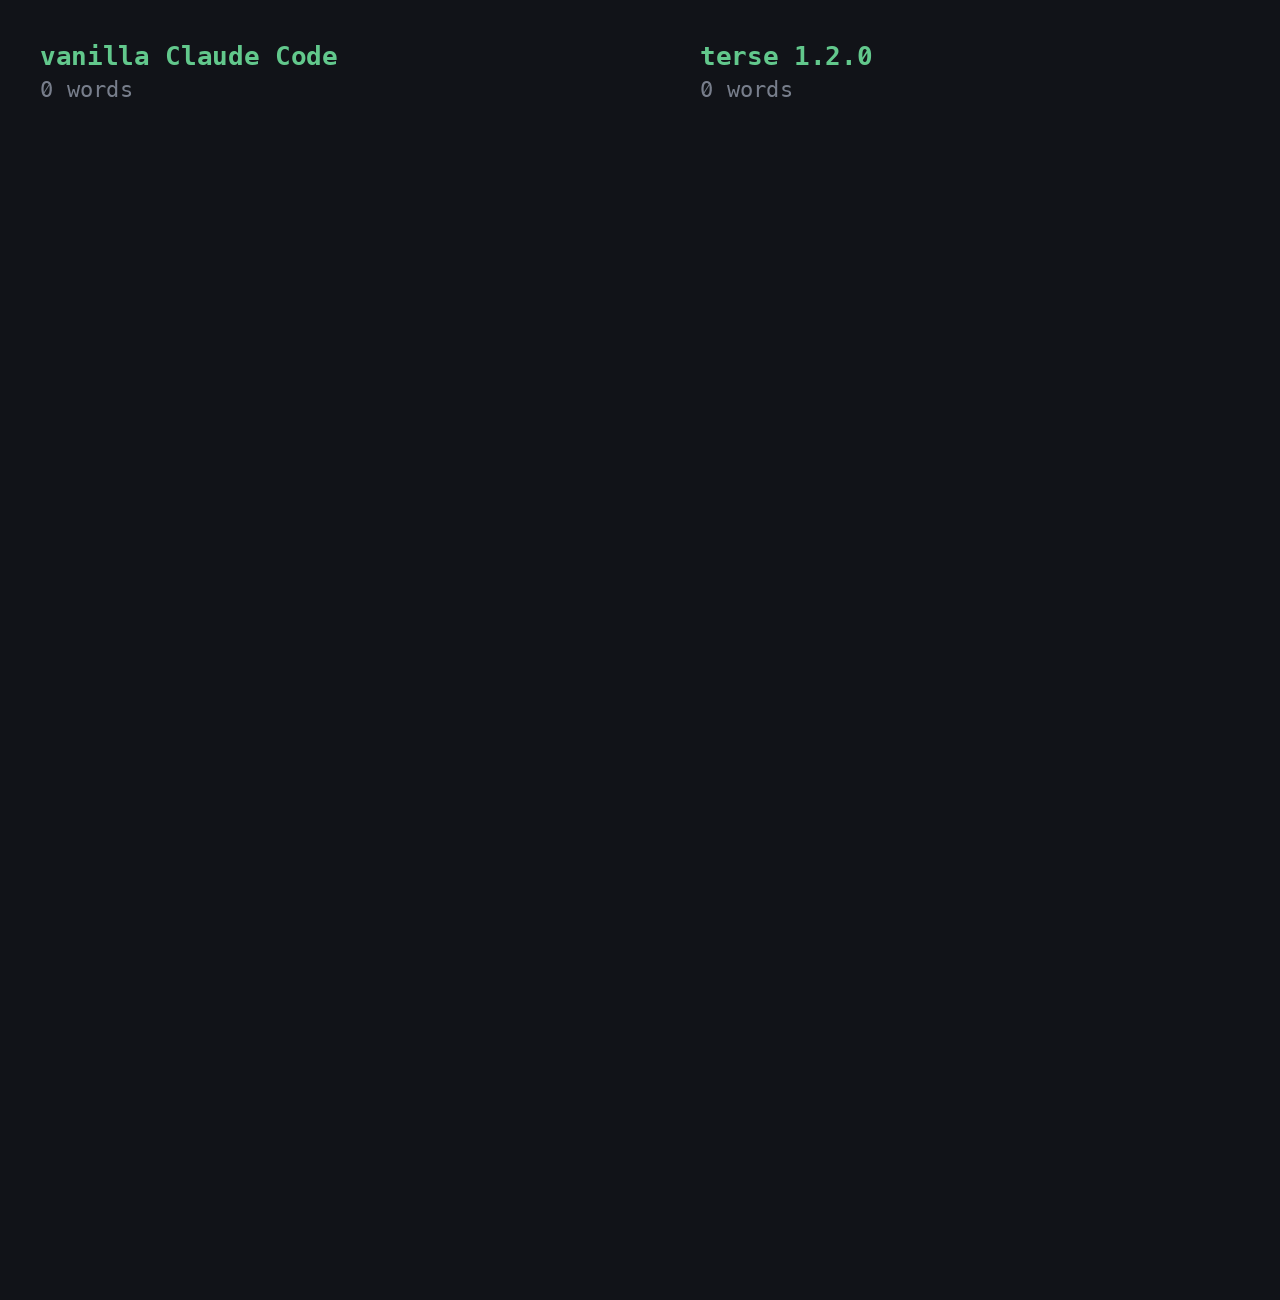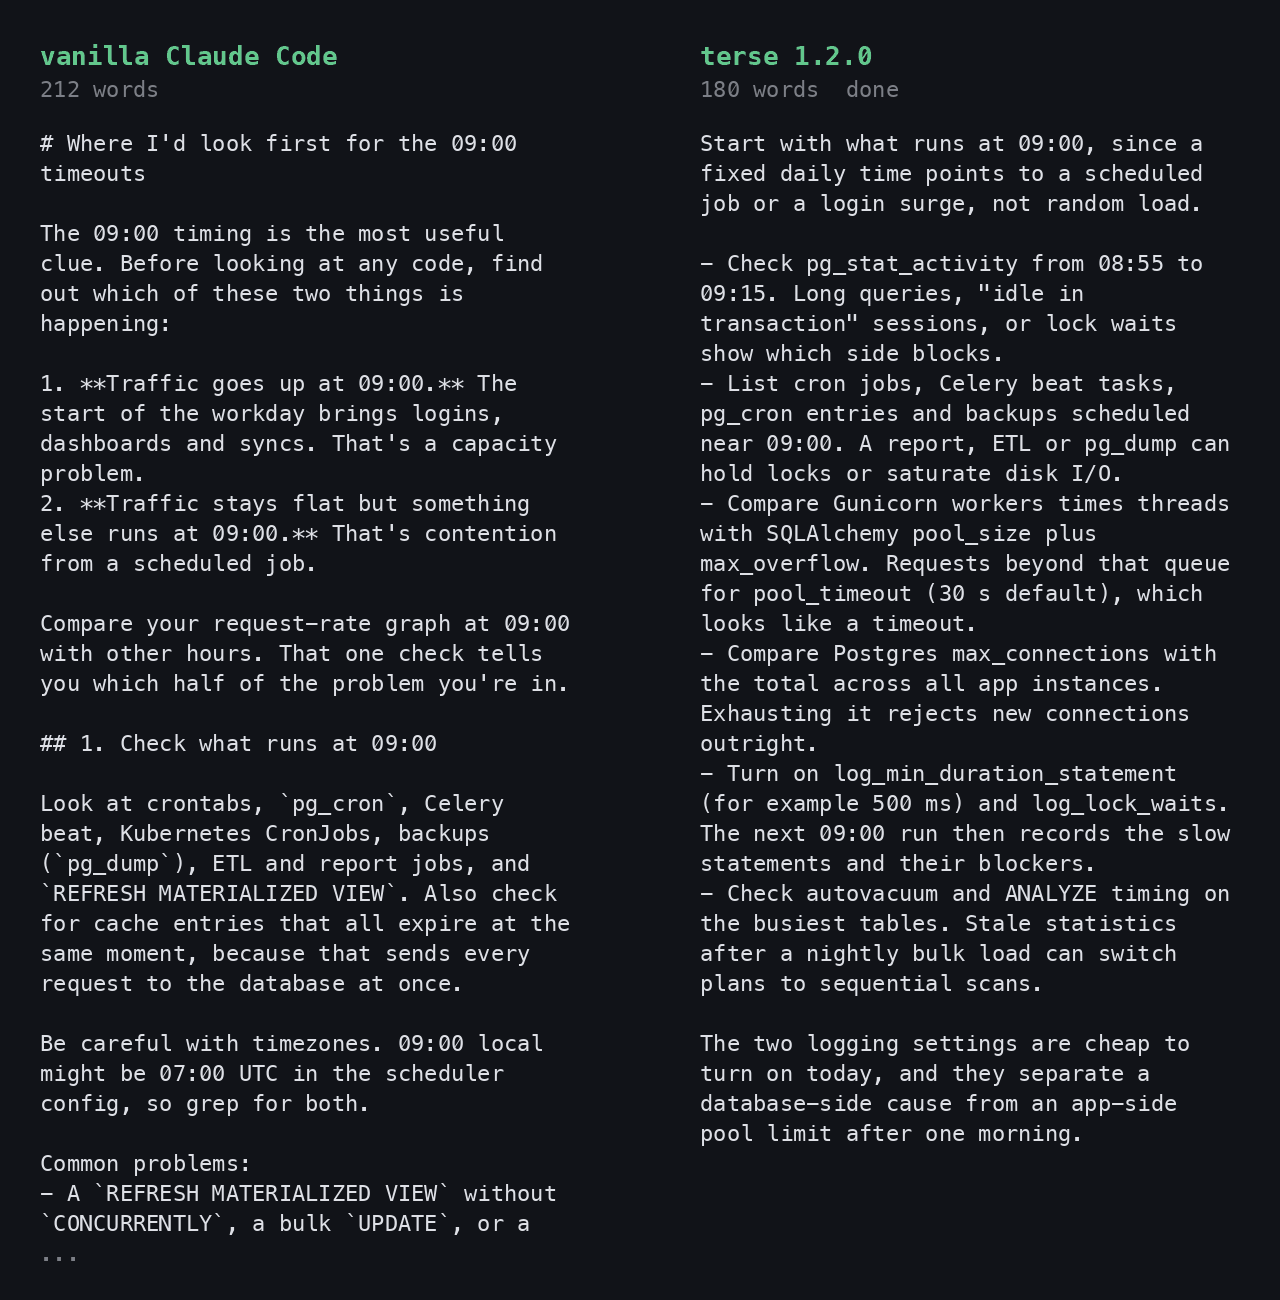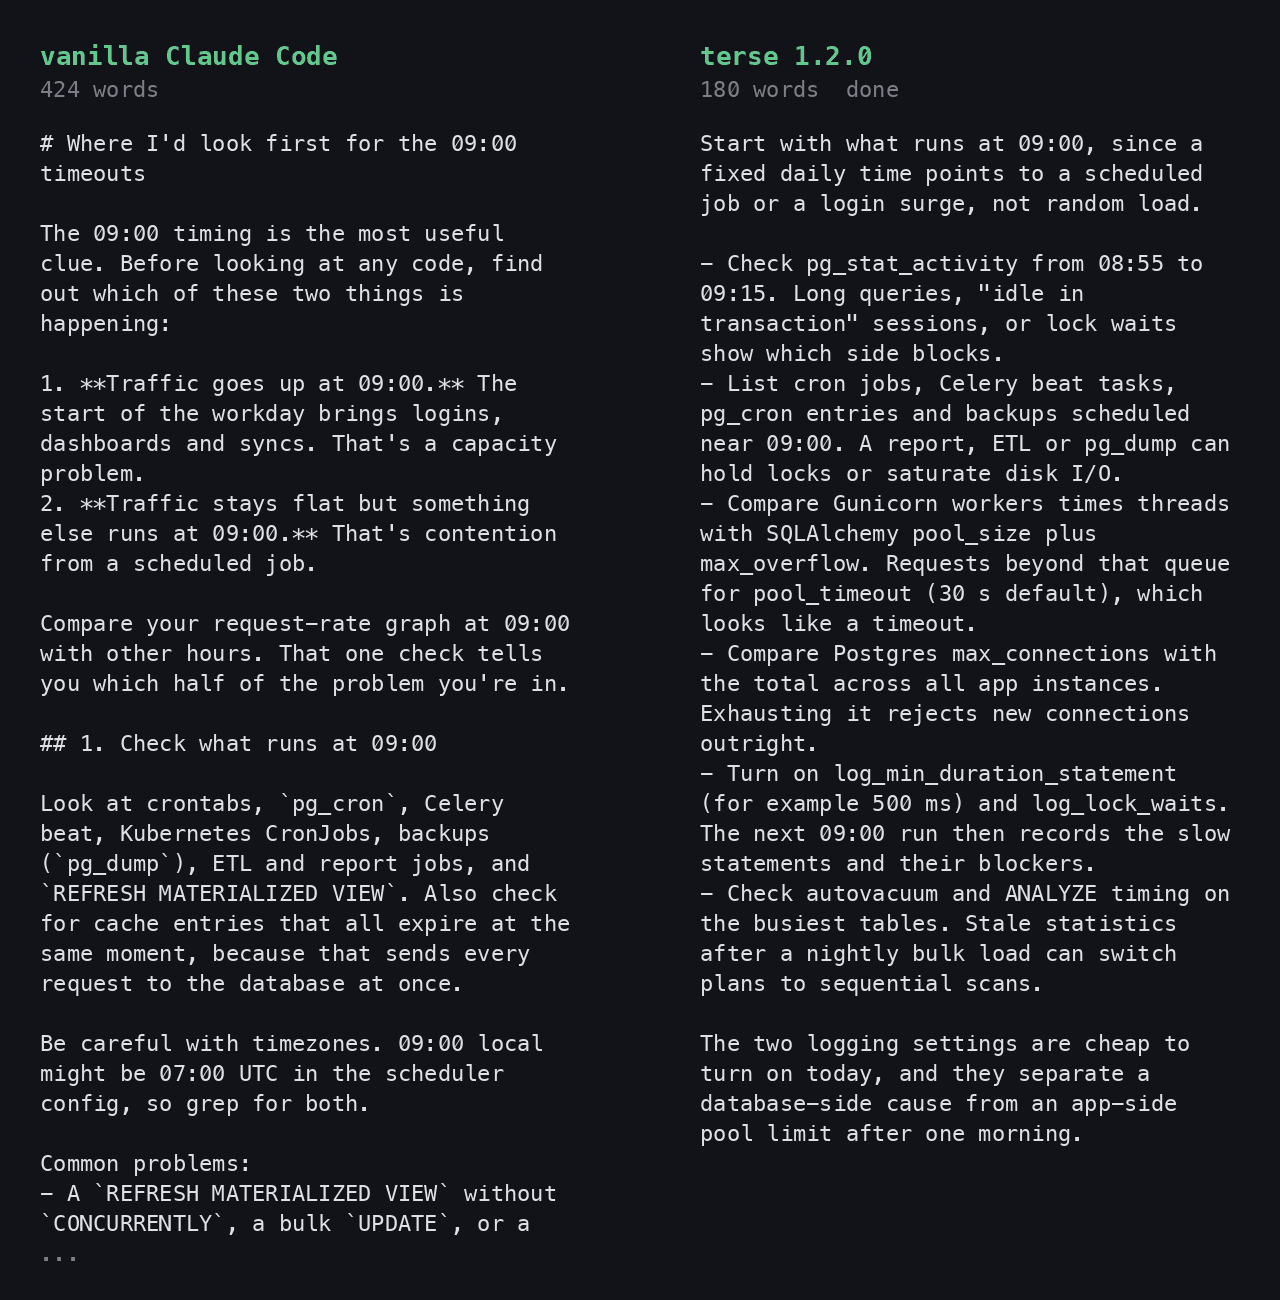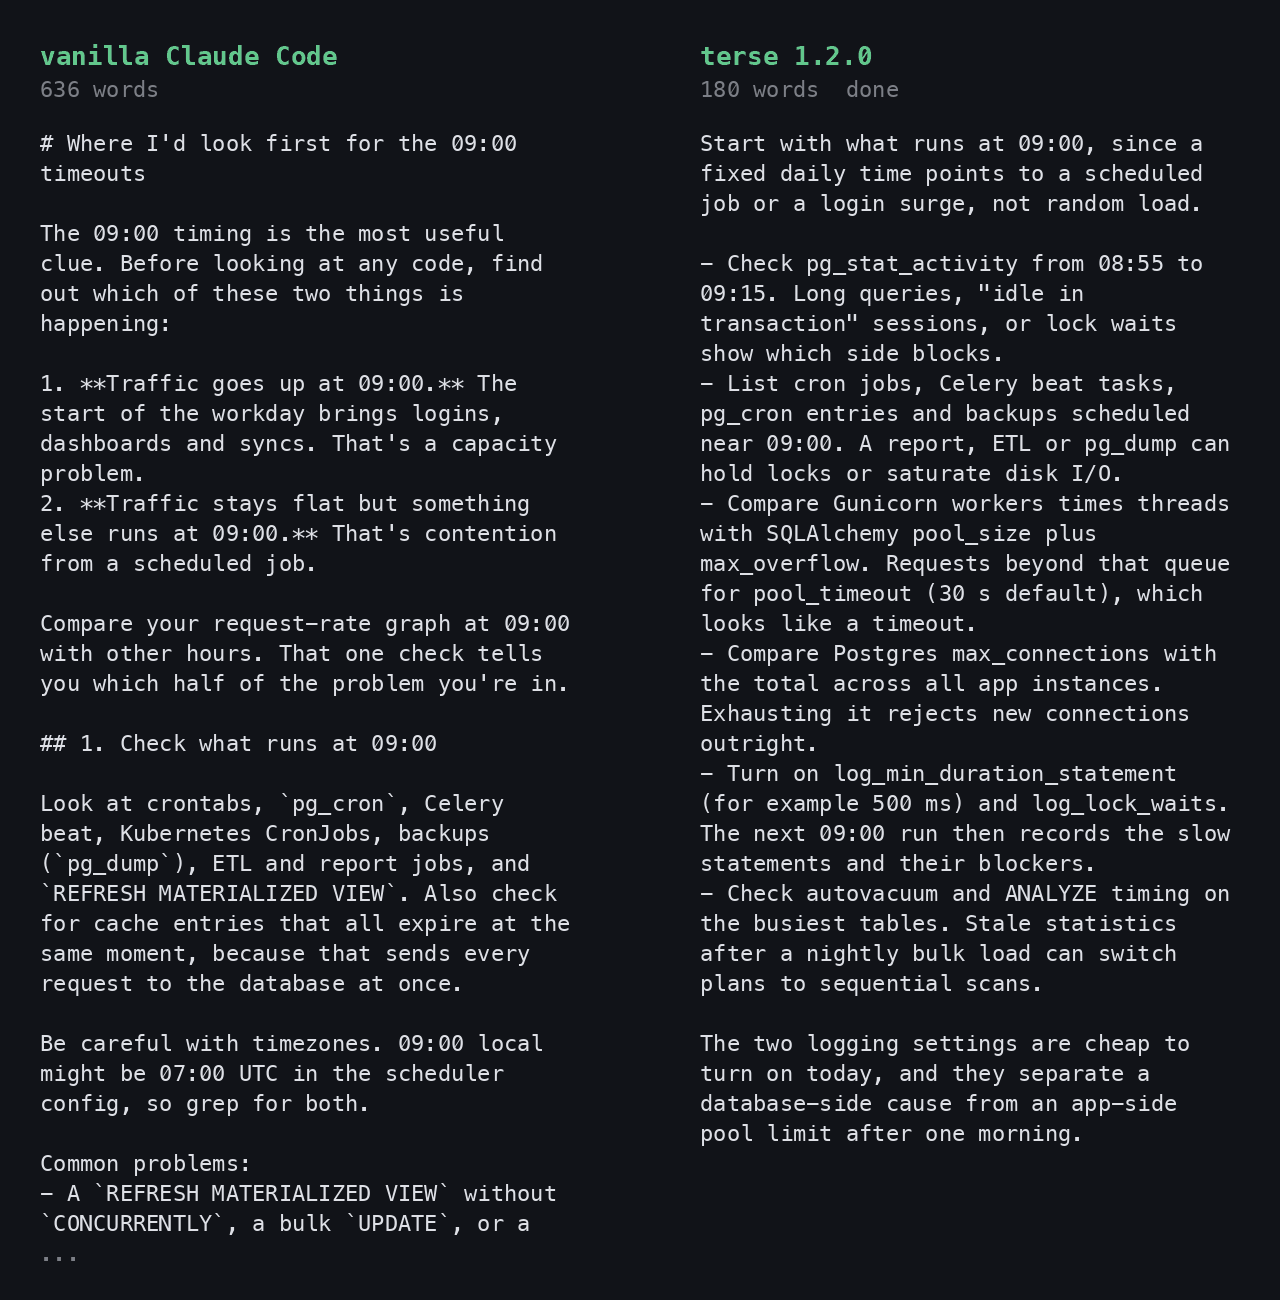
프롬프트 (모든 설정에서 Opus 5.5로 실행): "우리는 Postgres 데이터베이스를 가진 Flask API가 있습니다. 요청이 하루에 한 번, 오전 9시경 부하 상태에서 시간 초과됩니다. 어디부터 확인해야 하며 그 이유는 무엇입니까?"
바닐라(Vanilla), 636단어:
09:00 타임아웃을 찾기 위해 먼저 살펴볼 곳
09:00 타이밍이 가장 유용한 단서입니다. 어떤 코드를 보기 전에 다음 두 가지 중 어느 것이 발생하고 있는지 알아내세요:
- 09:00에 트래픽이 증가하는 경우. 업무 시작 시간은 로그인, 대시보드 및 동기화(sync)를 가져옵니다. 이는 용량 문제(capacity problem)입니다.
- 트래픽은 평탄하게 유지되지만 09:00에 다른 무언가가 실행되는 경우. 이는 예약된 작업(scheduled job)으로 인한 경합(contention) 문제입니다.
요청률 그래프(request-rate graph)를 09:00과 다른 시간대와 비교해 보세요. 이 한 가지 확인만으로 문제의 어느 절반에 놓여 있는지 알 수 있습니다.
1. 09:00에 무엇이 실행되는지 확인하기
crontab, pg_cron, Celery beat, Kubernetes CronJobs, 백업(pg_dump), ETL 및 보고서 작업(report jobs), 그리고 REFRESH MATERIALIZED VIEW를 살펴보세요. 또한 모든 캐시 항목이 같은 순간에 만료되는 경우도 확인해야 합니다. 왜냐하면 이는 모든 요청을 한 번에 데이터베이스로 보내기 때문입니다.
시간대(timezones)에 주의하세요. 현지 시간 09:00가 스케줄러 설정에서 UTC 기준 07:00일 수 있으므로, 둘 다 검색해 보세요.
흔한 문제점:
CONCURRENTLY가 없는 REFRESH MATERIALIZED VIEW, 대량 UPDATE, 또는 마이그레이션(migration). 이 각각은 잠금(locks)을 차지하며 API 쿼리가 그 뒤에서 기다리게 만듭니다.- 디스크 I/O를 소모하는 백업 또는 배치 작업(batch job).
2. 해당 시간 동안 Postgres가 무엇을 하는지 포착하기
이것이 가장 빠르고 확실한 답변을 제공합니다. 08:55부터 09:15까지 10~15초 간격으로 pg_stat_activity를 스냅샷하세요:
SELECT now(), state, wait_event_type, wait_event,
       now() - xact_start AS xact_age, left(query, 120) AS query, application_name
FROM pg_stat_activity
...
결과를 다음과 같이 읽으세요:
wait_event_type = 'Lock'이 많은 경우: 무언가가 잠금(locks)을 잡고 있습니다. pg_locks와 조인하거나 (pg_blocking_pids() 사용), 차단하는 세션(blocking session)을 찾으세요. 이는 보통 1단계의 예약된 작업입니다.idle in transaction이 많은 경우: 앱이 트랜잭션을 열고 빠르게 닫지 않습니다. 이것은 연결(connections)과 잠금(locks)을 유지합니다.- 동일한 쿼리를 실행하는
active 세션이 많은 경우: 하나의 쿼리가 규모가 커질 때 느린 것입니다. 종종 누락된 인덱스(missing index)나 오래된 계획(stale plan) 때문입니다.
해당 윈도우에 대해 pg_stat_statements를 확인하세요.
- 세션 카운트가
max_connections에 근접: 연결이 부족한 상태입니다 (3단계 참조).
또한, 다음 발생 시 기록을 남기도록 log_min_duration_statement (예: 500ms)와 log_lock_waits = on도 설정하세요.
3. 애플리케이션 측 연결 풀 고갈 확인
이는 Flask + SQLAlchemy 앱에서 타임아웃이 발생하는 가장 흔한 원인입니다. 앱 로그에서 09:00경을 검색하여 다음 메시지를 찾으세요:
QueuePool limit of size 5 overflow 10 reached, connection timed out
그런 다음 산술 계산을 하세요: gunicorn workers × threads × (pool_size + max_overflow) × 인스턴스 수와 Postgres의 max_connections를 비교합니다. 트래픽이 급증하면 요청들이 풀링된 연결을 위해 대기하다가 타임아웃됩니다. 이 과정 동안 Postgres는 거의 유휴 상태로 보일 수 있습니다.
또한, 풀에 반환되지 않은 세션도 확인하세요. 일반적인 원인은 db.session.remove() 또는 정리(teardown) 핸들러 누락이거나, 트랜잭션 내부에서 실행된 느린 외부 HTTP 호출입니다.
4. 어떤 타임아웃이 발생하는지 파악
로드 밸런서(종종 60초), gunicorn --timeout(기본값 30초), SQLAlchemy pool_timeout(기본값 30초)은 각각 다른 지점을 가리킵니다:
- Gunicorn의
WORKER TIMEOUT 메시지는 워커가 차단되었음을 의미합니다. 데이터베이스를 기다리고 있거나 동기(sync) 워커가 너무 적을 수 있습니다.
- 로드 밸런서에서 발생한 504 에러에 gunicorn 오류가 없다면, 요청들이 워커에 도달하기 전에 대기열에 쌓이고 있다는 의미입니다.
제 추천 사항
내일 09:00에 pg_stat_activity 스냅샷 루프를 실행하세요. 동시에 앱 로그에서 풀 오류를 검색하고 09:00 근처의 모든 예약된 작업(scheduled job)을 나열하세요. 이 방법이 두 가지 원인 중 하나로 범위를 매우 좁힐 것입니다: 잠금을 보유한 작업, 또는 아침 트래픽으로 인한 풀 고갈입니다. 해결책은 각각 매우 다릅니다: 작업을 이동하거나 재작성하거나, 아니면 풀 크기를 조정하고 PgBouncer와 같은 연결 풀러를 추가해야 합니다.
스케줄러 설정(scheduler config), SQLAlchemy 엔진 설정(engine settings), 그리고 gunicorn 명령어만 공유해 주시면 연결 관련 문제(connection arithmetic)를 확인해 드릴 수 있습니다.
terse 1.2.0, 180 단어:
- 무작위 부하가 아니라 고정된 일일 시간대이므로, 오전 9시에 실행되는 것부터 확인하세요.
- 오전 8시 55분부터 9시 15분까지
pg_stat_activity를 확인해 보세요. 긴 쿼리(Long queries), "idle in transaction" 세션, 또는 잠금 대기(lock waits)는 어느 쪽이 블로킹하는지 보여줍니다.
- 오전 9시경에 예약된 크론 작업(cron jobs), Celery beat 작업, pg_cron 항목 및 백업을 나열하세요. 보고서(report), ETL 또는
pg_dump가 잠금을 유발하거나 디스크 I/O를 포화 상태로 만들 수 있습니다.
- Gunicorn 워커 시간(workers times threads)과 SQLAlchemy의
pool_size에 max_overflow를 더해 비교하세요. 이를 초과하는 요청은 pool_timeout(기본값 30초)을 위해 대기하며, 이는 타임아웃처럼 보입니다.
- Postgres의
max_connections와 모든 앱 인스턴스의 총 연결 수를 비교하세요. 이것이 고갈되면 새로운 연결 자체가 거부됩니다.
log_min_duration_statement(예: 500ms)와 log_lock_waits를 활성화하세요. 그러면 다음 오전 9시 실행 시 느린 구문(slow statements)과 이를 막는 요소(blockers)가 기록될 것입니다.- 가장 바쁜 테이블에 대한 autovacuum 및 ANALYZE 타이밍을 확인하세요. 야간 일괄 로드 후 오래된 통계 정보(Stale statistics)는 실행 계획을 순차 스캔(sequential scans)으로 변경할 수 있습니다.
이 두 가지 로깅 설정은 오늘 켜기에는 비용이 적게 들며, 오전 중 한 번의 사건 이후 데이터베이스 측 원인과 앱 측 풀 제한을 분리해 줍니다.