Second Yourself
Pre-release: v1.0까지 디자인이 자주 변경됩니다. 포크(Forks)는 환영하며, 업데이트를 자주 가져오세요.
당신 자신을 두 번째로 만드세요. 당신을 기억하는 하나의 에이전트가 당신을 위해 여러 손으로 행동합니다.
토니 스타크는 자비스에게 자신을 소개할 필요가 없었습니다. 자비스는 그와 함께 생각하고, 그를 위해 행동했으며, 결코 잊지 않았습니다.
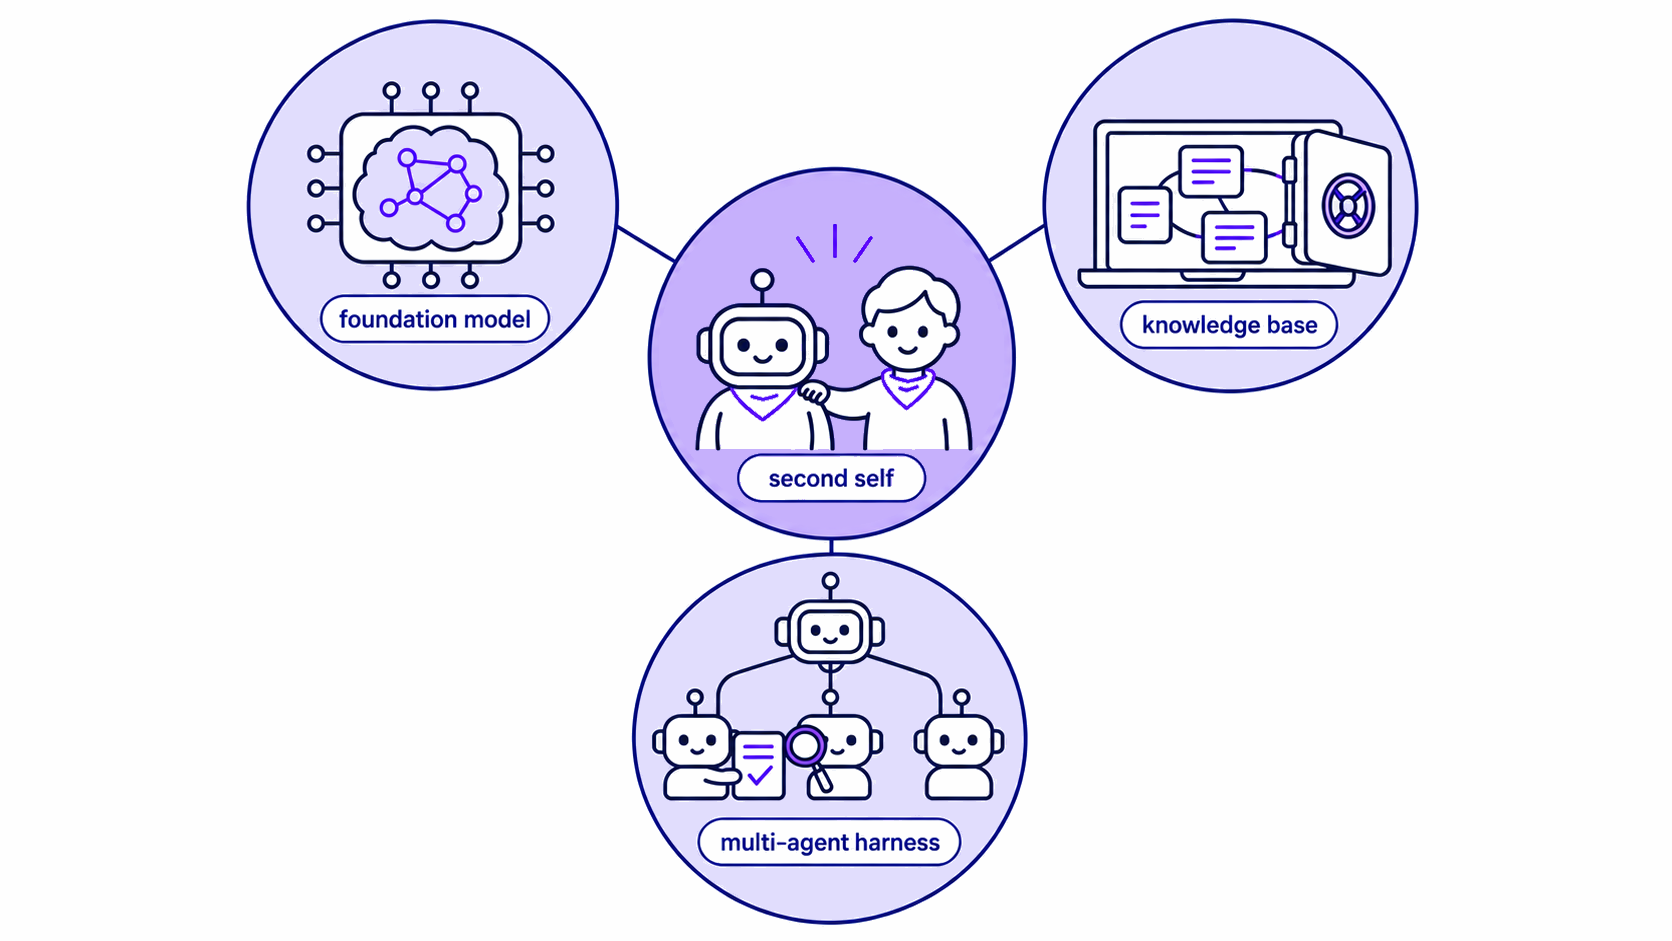
우리는 진정한 지능이 같은 구성에서 온다고 믿습니다. 파운데이션 모델(foundation model)은 이성(reason)을 제공합니다. 멀티 에이전트 하네스(multi-agent harness)는 손(hands)을 제공합니다. 잘 구조화된 지식 기반(knowledge base)은 기억(memory)을 제공합니다. Second Yourself는 이 세 가지가 만나는 곳에 구축되었습니다.
Three parts joining into one agent that works for a person: a foundation model that reasons, a team of agents that acts and checks its own work, and a knowledge base of linked notes kept on the user's machine
오늘날 Second Yourself는 Claude Code 또는 Obsidian 내의 Claudian 플러그인에서 실행되며, Codex CLI를 통해 GPT 모델을 헬퍼 에이전트로 사용하고 자체 기계의 일반 마크다운(plain Markdown) 위키와 함께 작동합니다.
두 번째 두뇌(second brain)는 당신이 아는 것을 저장합니다. 두 번째 자아(second self)는 그것을 당신과 함께 알고 행동합니다.
당신이 구축하는 것은 전적으로 당신에게 달려 있습니다:
- 두 번째 당신: 이 프로젝트가 지향하는 목표입니다. 단순히 답변만 하는 것이 아니라, 당신의 목소리로 간략한 메모부터 노부모의 약 복용 및 예약까지 당신을 대신해 행동할 수 있는 에이전트입니다.
- 연구 보조원: 오늘 배포되는 기능입니다. 논문과 기사를 넣고 질문하며, 자신만의 라이브러리에서 인용된 답변을 얻습니다.
- 여러 에이전트를 위한 공유 두뇌: 이미 작동하는 부분입니다. 팀의 에이전트들이 작업하는 하나의 위키입니다.
파운데이션 모델 (The foundation model)
추론(Reasoning)은 플러그인으로 연결하는 최첨단 모델에서 나옵니다. 오늘날 Claude 모델이 작업을 조정합니다. v0.9.6 릴리스부터는 자체 테스트 스크립트를 가진 런처가 GPT 헬퍼 에이전트들을 실행합니다. 모델은 매년 교체됩니다. 나머지 두 부분은 당신의 것이며, 이는 복합적으로 작용합니다.
멀티 에이전트 하네스 (The multi-agent harness)
당신은 하나의 에이전트에게 말하고, 그 에이전트는 서면 계약(written contract)에 따라 헬퍼 에이전트들에게 업무를 지시합니다. 각 헬퍼는 주어진 파일만 작성할 수 있습니다. 긴 작업은 몇 시간 동안 무인으로 실행됩니다.
독립적인 비평가 및 검증자 에이전트들이 작업을 확인합니다. 아무것도 보고하지 않는 점검이라도, 먼저 심어 놓은 케이스를 포착할 수 있음을 보여야 하므로, 침묵하는 실패는 깨끗한 결과로 간주되지 않습니다.
이 하네스(harness)는 이 저장소 자체이며, 규칙, .claude/skills/ 아래의 13개 스킬, .claude/agents/ 아래의 9개 에이전트 정의, 그리고 34개의 테스트 스크립트로 구성되어 있습니다. main 브랜치의 모든 커밋은 버전이며, 2026년 6월 24일의 v0.1부터 시작하고, 태그가 지정된 릴리스는 v0.9.6부터 시작합니다.
지식 기반 (The knowledge base)
사용자는 자신의 Obsidian 볼트에 소스 자료를 넣으면, 에이전트가 이를 스스로 관리하는 연결된 노트들의 위키로 컴파일합니다. 이 노트들은 사용자가 열고, 읽고, 수정할 수 있습니다. 모든 지식 페이지는 등급화된 신뢰 수준(graded trust level)을 가지고 있으며, 모든 답변은 근거로 삼은 페이지를 인용합니다. 직접 구축하기 전에 하나를 보고 싶다면 bash setup.sh --with-example을 실행하여 번들링된 데모 위키를 로드할 수 있습니다.
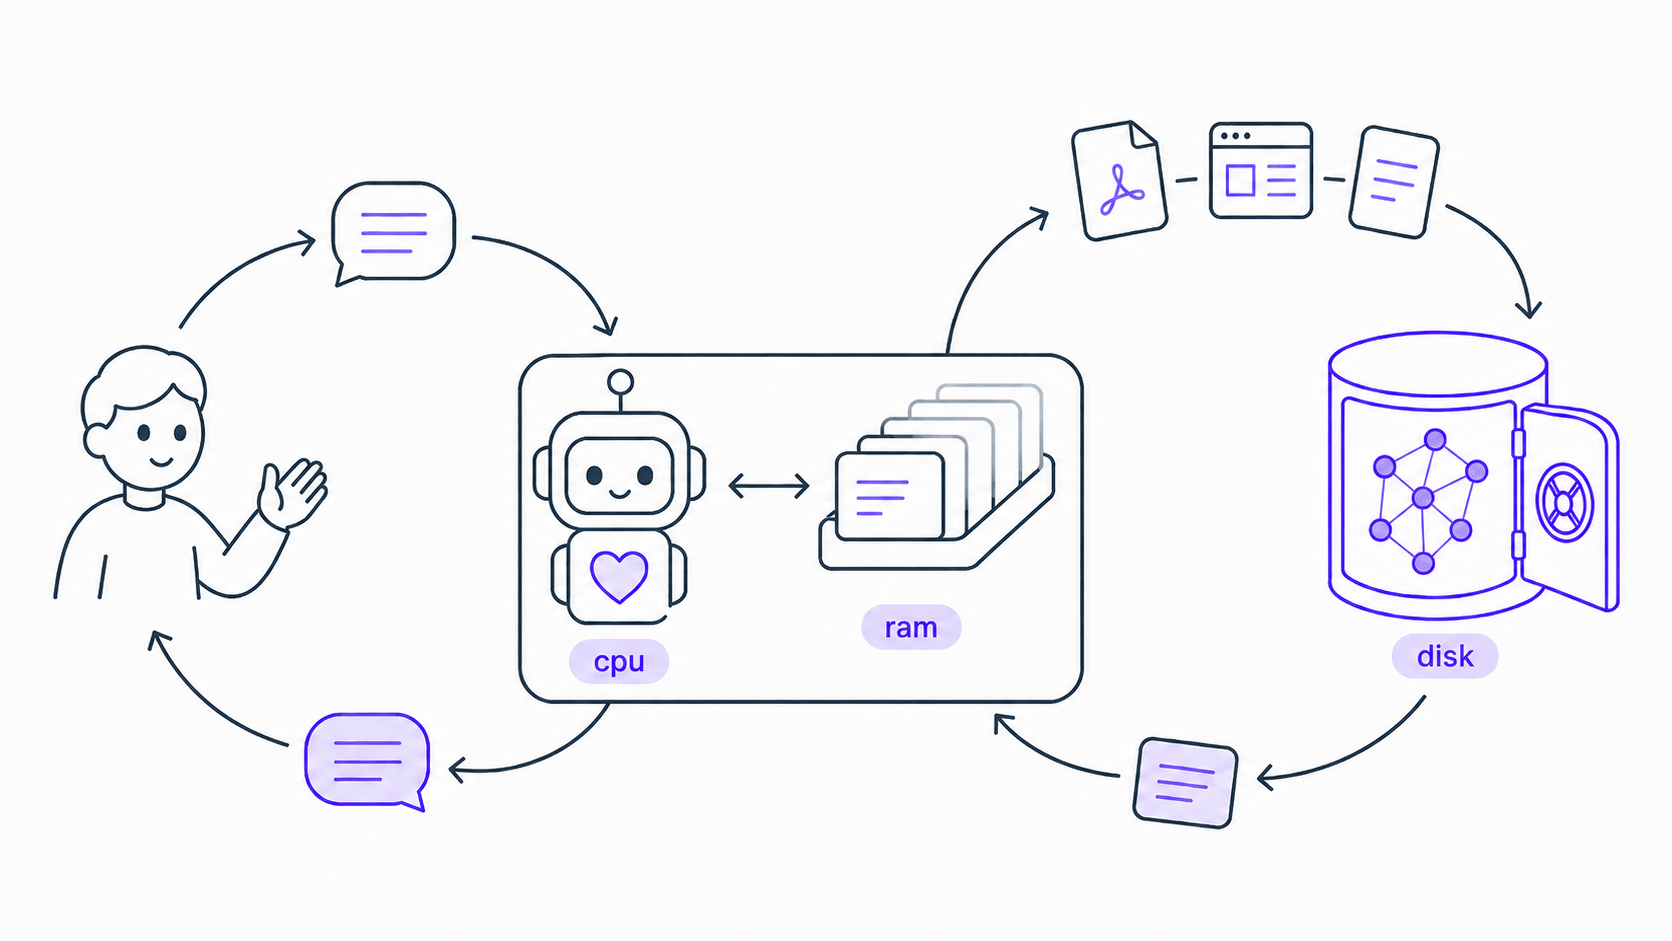
이 모델을 CPU라고 생각하고, 컨텍스트 창(context window)을 RAM이라고 생각하세요. 빠르지만 대화가 끝나면 비워집니다. 이 위키는 그 아래의 디스크이며, 노트들은 대화에 필요한 정보가 다시 컨텍스트 창으로 흐르게 하는 역할을 합니다.
Two loops around an AI agent labelled cpu with its context tray labelled ram: on the left, the user sends a question and receives an answer; on the right, the agent files sources into a violet vault labelled disk that holds a knowledge graph, and draws a note back into its tray
이것에 한 달 동안 데이터를 공급하면 어시스턴트는 낯선 존재가 아니게 됩니다. 1년이 지나면 다른 어떤 것도 사용자의 작업을 이처럼 알지 못할 것입니다.
현재 기능 (What it does today)
사용자는 소스 자료(PDF, 슬라이드, 링크, 블로그 및 거의 모든 기타 파일 형식)를 단순히 넣기만 하면 됩니다. 에이전트는 각각의 파일을 연결된 Markdown으로 처리하고, 올바르게 파일화하며, 사용자의 교차 참조와 카탈로그를 완벽하게 최신 상태로 유지합니다. 읽지 않은 클리핑 폴더를 만드는 대신, AI가 네이티브하게 읽을 수 있는 구조적이고 복합적인 지식 기반을 만듭니다.
한 번 채워지면, 위키는 다음 기능을 수행할 수 있습니다:
- 답변 및 생성: 에이전트는 질문에 답하고 브리프(briefs)부터 보고서, 프레젠테이션, 테이블, 교차 소스 종합 자료에 이르기까지 거의 모든 종류의 결과물을 생성합니다.
- 지능형 참조: 이는 살아있는 인용 기반 지식 저장소 역할을 하며, 어떤 에이전트든 이를 활용할 수 있습니다. 모든 노트에는 신뢰도 수준이 부여되므로, 답변은 사용자의 자체 소스를 기반으로 하고 각 출처의 신뢰도에 따라 가중치가 적용되며, 이 모든 과정에서 매우 효율적인 토큰 사용을 유지합니다.
- 지속적인 통찰력: 이는 사용자의 여러 소스에 걸쳐 능동적으로 종합하고, 대화가 끝날 때 사라질 수 있는 훌륭한 아이디어를 보존할 수 있도록 가치 있는 답변을 영구적이고 연결된 노트로 저장할 것을 제안합니다.
- 자가 유지 및 성장: 이 시스템은 파일을 능동적으로 교차 링크(cross-links)하고, 중복 항목을 병합하며, 충돌하는 정보나 지식 격차를 표시합니다. 사용자의 정보가 복리처럼 쌓이는 동안 카탈로그와 그래프를 자동으로 유지 관리합니다.
신뢰성은 기대되는 것이 아니라 내장되어 있습니다. 프레임워크 자체를 변경하는 계획은 승인되기 전에 독립적인 비평 에이전트(independent critic agent)의 검토를 거칩니다.
저희는 이 아키텍처가 범용적이고 매우 적응성이 높도록 의도적으로 설계했습니다. AI 및 머신러닝 연구에 맞춰 사전 조정되었지만 (모델과 벤치마크를 주요 노트 유형으로 취급), 사용자의 특정 분야나 워크플로우에 완벽하게 맞도록 저장소를 쉽게 사용자 정의할 수 있습니다. 또한 첫 설정 시 생성되는 CUSTOMISATION.md 파일에서 에이전트 자체를 개인화할 수도 있습니다: 이름, 톤, 출력 스타일 및 작업 역할은 시작 예시로 제공되며, 이 파일은 개방형이므로 매 세션마다 따르기를 원하는 모든 기본 선호 사항을 추가할 수 있습니다.
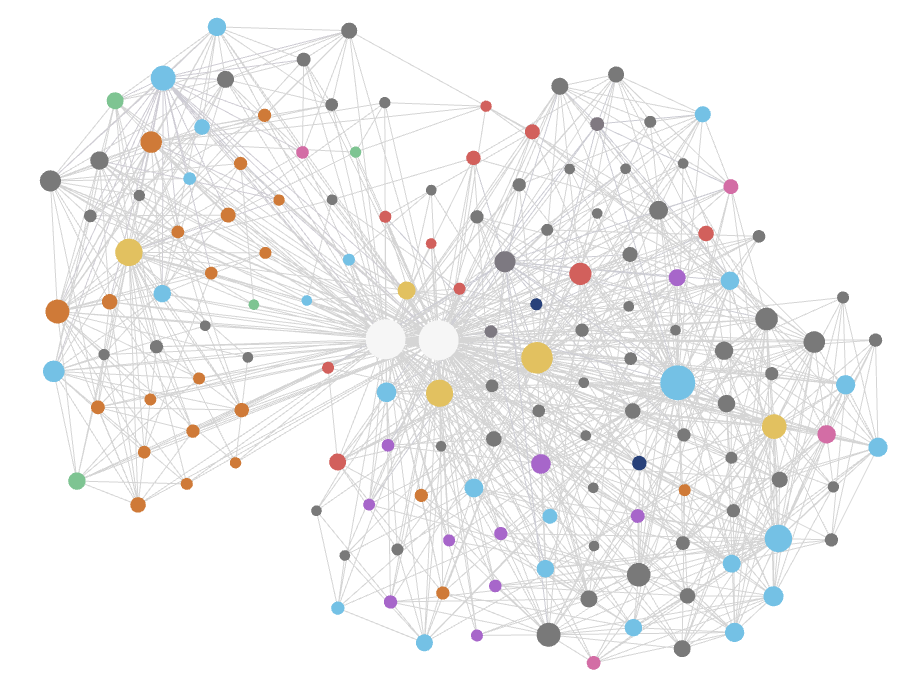
The knowledge graph the agent builds, coloured by note type
설정 (Setup)
이것은 플러그인이라기보다는 프레임워크입니다. CLAUDE.md와 .claude/skills/에 있는 기술(skills)을 읽는 AI 코딩 에이전트가 필요하며, 현재 이 에이전트는 Obsidian 내부의 Claude Code 또는 Claudian 플러그인입니다. 설정에는 약 10분이 소요됩니다.
-
Obsidian 및 에이전트 설정. Obsidian을 설치하고 이 폴더를 볼트(vault)로 엽니다. 그런 다음 에이전트를 설치합니다: 커뮤니티 플러그인에서 Claudian (설정 → 커뮤니티 플러그인 → 찾아보기 → Claudian)을 사용하거나, 볼트 내 터미널에서 Claude Code를 실행합니다. Claudian은 이 프레임워크가 요구하는 유일한 Obsidian 플러그인입니다.
-
명령줄 도구. PDF 및 Office 문서를 Markdown으로 변환하는 MarkItDown을 설치합니다:
pip install 'markitdown[all]'
또한 python3, curl, 그리고 git이 사용되며, 일반적으로는 이미 설치되어 있습니다.
GPT 헬퍼 에이전트는 설치 및 인증된 Codex CLI를 필요로 합니다. 해당 설치에서 지원하는 모델 및 노력(effort) 옵션을 선택하세요. 위임(delegate) 스킬은 호출 방법을 문서화합니다. 오픈 액세스 리졸버는 자체 OA_CONTACT_EMAIL 설정을 요구합니다. 교수 루프(professor-loop) 작성 워크플로우는 이 버전에 포함되어 있지 않습니다.
-
캡처 스킬 (권장). kepano의 obsidian-skills를 설치합니다. 에이전트는 깨끗한 웹 캡처를 위해 defuddle을, 볼트 접근을 위해 obsidian-cli를 사용합니다. 이들이 없으면 프레임워크는 curl과 MarkItDown으로 폴백(fallback)됩니다.
-
웹 클리퍼 (선택). Obsidian Web Clipper 브라우저 확장 프로그램은 웹 페이지를 한 번의 클릭으로 raw/에 저장합니다. 또한 raw/ 폴더에 파일을 드롭하거나 에이전트에게 URL을 붙여넣을 수도 있습니다.
-
클론 및 초기화.
git clone https://github.com/HurricaHjz/second-yourself.git
cd second-yourself
bash setup.sh
최초 사용 전에는 항상 setup.sh를 실행하세요. 이 스크립트는 위키 레지스트리를 생성하고 그래프 색상 팔레트를 적용합니다. 언제든지 재실행해도 안전하며 기존 노트를 덮어쓰지 않습니다.
우선 번들된 데모를 실행하려면 bash setup.sh --with-example을 실행하세요. 그런 다음 Obsidian에서 폴더를 열고 그래프 뷰(graph view)를 연 다음, 에이전트에게 /query what is GPT?라고 질문하세요. 답변은 데모 위키(demo wiki)에서 가져오며, 그 뒤에 있는 노트로 연결되는 링크가 포함됩니다. 자신만의 지식 기반을 시작할 준비가 되면 bash setup.sh --reset을 실행하세요. 그 후에는 examples/ 폴더를 삭제해도 안전합니다.
새로운 볼트(vault)의 그래프는 데모를 로드하거나 첫 번째 소스를 /ingest하기 전까지는 비어 있습니다. 이는 오류가 아니므로 예상되는 상황입니다. setup.sh와 첫 인제스트(ingest) 작업이 색상 팔레트를 자동으로 적용하며, Obsidian은 노드를 유형별로 색상 코딩합니다. 나중에 색상이 사라지더라도 (Obsidian이 자체 그래프 구성을 다시 쓸 수 있으므로), 에이전트에게 그래프 색상을 복원해 달라고 요청하기만 하면 됩니다.
- 볼트를 백업하세요(선택 사항). Obsidian Git 플러그인을 설치하여 전체 볼트, 노트 포함,를 버전 기록 및 다중 장치 백업을 위해 비공개 저장소에 동기화하세요. 이 비공개 원격(private remote)은 이 공개 프레임워크 레포지토리와 분리해서 유지하세요. 사용자의 노트는 결코 여기에 포함되지 않습니다.
하드웨어 및 실행 비용
Obsidian을 실행하는 컴퓨터면 충분합니다. 지능은 클라우드 에이전트에 존재하므로 구매할 GPU도 없고 호스팅할 로컬 모델도 없으며, 볼트 자체는 사용 기간이 몇 달이 지나도 메가바이트 단위로 유지되는 일반 텍스트 파일입니다. 유일한 선택적 추가 기능인 qmd 의미 검색(semantic search)은 노트북 CPU에서 작은 임베딩 모델을 편안하게 실행합니다.
실제 비용은 API 크레딧 또는 플랜 할당량이며, 이 프레임워크는 이를 작게 유지하도록 구축되었습니다. 에이전트는 전체 볼트를 로드하는 대신 선택적으로 읽고, 먼저 카탈로그를 작성한 다음 작업에 필요한 노트만 가져옵니다. 또한 Claude의 프롬프트 캐싱(prompt caching)으로부터도 이점을 얻습니다. 모든 세션의 안정적인 시작(에이전트의 규칙 및 사용자의 선호 사항)은 첫 번째 턴 후에 캐시되며, 캐시된 텍스트를 다시 읽는 비용은 일반 입력 가격의 약 1/10 수준이므로, 장시간 작업하는 세션이 따뜻하고 저렴하게 유지됩니다. 두 가지 습관이 도움이 됩니다: 새로운 소스를 한 번에 인제스트(ingest) 실행으로 배치하고, 대화당 하나의 작업을 유지하세요.
사용법 (Usage)
처음 오셨나요? 매뉴얼을 읽어보세요. 이 문서는 명령어, 캡처 → 컴파일 → 질문 → 유지 관리 워크플로우 및 모든 옵션을 상세하게 다루므로, 이 README에서는 반복하지 않습니다.
작동 방식 (How it works)
소스는 raw/에 존재하며, 컴파일된 노트는 유형별로 정리되어 wiki/에 저장되고, 생성된 index.md와 log.md가 있습니다. 스킬은 다음과 같습니다:
| Skill | 목적 (Purpose) |
|---|
ingest | raw/의 소스를 연결된 노트로 컴파일합니다. |
| ... | |
저장소에서 추적하는 내용 (What the repository tracks)
저장소는 프레임워크 자체만 보유합니다: 스킬, 규칙, 구성 및 작은 데모입니다. 사용자의 개인 노트는 기기에 남아 있습니다: wiki/, raw/, output/, attic/, index.md, log.md, 그리고 개인의 CUSTOMISATION.md는 .gitignore에 의해 제외되므로, 푸시(push)할 때 항상 프레임워크 변경 사항만 게시됩니다.
이 노트들을 백업하려면 위에 있는 선택적 Obsidian Git 단계를 사용하세요. 그러면 별도의 비공개 저장소를 얻게 됩니다.
크레딧 및 라이선스 (Credits and licence)
위키 레이어는 Andrej Karpathy의 LLM Wiki 패턴을 기반으로 구축되었으며, 캡처 기능은 kepano의 obsidian-skills를 사용합니다. MIT 라이선스(LICENSE) 하에 배포되었습니다.