
Qwen3.8 27B 양자화 모델 벤치마킹: 4비트 유지되나, 1비트는 무너진다
요약
Qwen3.8 27B 모델의 다양한 양자화 버전을 분석하며, GPU 메모리 제약 하에서도 Q4_K_M(17GB)과 같은 적절한 압축 방식은 높은 성능을 유지할 수 있음을 보여줍니다. 다만, 비트 수가 낮아질수록 (특히 1비트) 모델의 추론 능력이 급격히 저하되는 한계가 명확합니다.
핵심 포인트
- Q4_K_M(17GB)은 RTX 4090 등 일반 소비자용 GPU에서 높은 성능을 유지할 수 있습니다.
- 양자화는 비트 수가 낮아질수록 모델의 추론 능력 저하를 초래하는 한계가 명확합니다.
- 단순 토큰 예측 차이 측정만으로는 실제 태스크 해결 능력을 판단하기 어렵습니다.
- 벤치마크 시에는 GPQA Diamond, IFBench 등 실제 사용 환경에 초점을 맞추는 것이 중요합니다.
Qwen3.8 27B를 어느 정도의 GPU RAM으로 구동해야 품질 저하 없이 사용할 수 있을까요?
전체 BF16 모델은 55 GB에 달하여 대부분의 일반 소비자용 하드웨어로는 감당하기 어렵습니다.
하지만 17 GB인 Q4_K_M은 인기 있는 에이전트 코딩 벤치마크인 Terminal-Bench 2.1에서 전체 모델과 동일한 성능을 보여줍니다. 이는 RTX 4090 같은 24 GB 카드에 들어갈 수 있으며, 약 64k 토큰의 컨텍스트를 처리할 여유 공간도 남습니다.
압축은 결국 한계에 부딪힙니다. 1비트에서는 GPQA Diamond에서 무작위 추측 수준의 성능을 보이며, 추론이 길어질수록 성능은 더욱 나빠집니다.
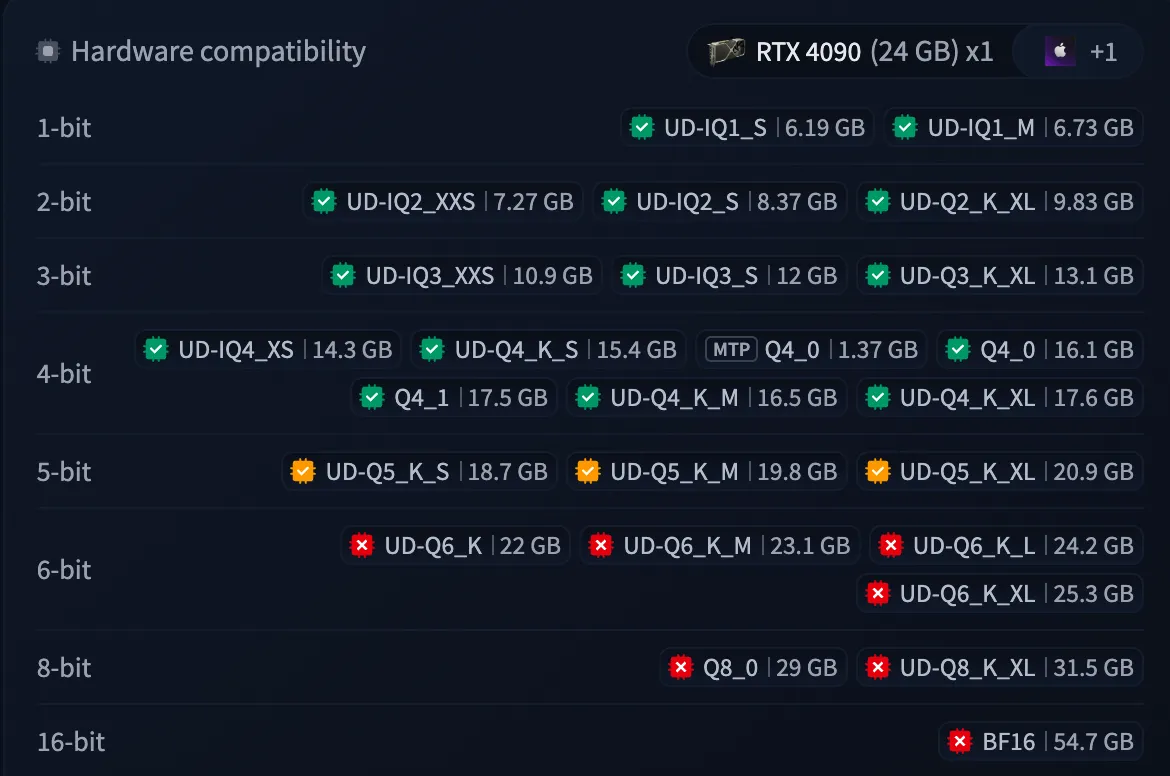
Unsloth에서 Hugging Face를 통해 제공하는 Qwen3.8 27B GGUF 양자화 모델들이 있습니다. 선택지가 정말 많네요! 저는 8비트 Q8_0 (29 GB), 4비트 Q4_K_M (17 GB), 2비트 UD-Q2_K_XL (10.7 GB), 그리고 가능한 가장 작은 1비트 UD-IQ1_S (6.2 GB)를 확인해 볼 예정입니다.
이전에 저는 Qwen3.6 27B 모델을 조사했었는데, 이 모델은 12GB에서도 SVG 플리칸 생성에 능했고 최대 16GB까지 대부분의 지식을 유지했습니다. 한편, Reddit 스레드에서는 모든 양자화 모델, 심지어 8비트 모델조차 성능이 떨어진다는 불만이 많습니다. 사람들은 왜 로컬 LLM이 실제보다 더 멍청하게 느껴지는지 질문하기도 합니다. 이러한 불만들이 근거가 있을까요?
토큰 예측 차이(KL-divergence, top-1 predictions)를 측정하는 것은 쉽지만, 모델이 태스크 해결 능력이 떨어졌는지 여부는 알려주지 않습니다. 어떤 노이즈는 태스크 해결에 무관할 수 있습니다. 예를 들어, 양자화된 모델이 약간의 의역을 거쳐 정확히 동일한 품질의 답변을 생성한다면 말입니다. 반면에 다른 토큰 하나만 바뀌어도 논리적 오류가 되거나 출력을 갑자기 중단시킬 수도 있습니다.
그래서 저는 인기 벤치마크인 GPQA Diamond, 명령어 수행 IFBench, 프로그래밍 Terminal-Bench 2.1에서 결과를 직접 측정하는 데 초점을 맞췄습니다. 먼저 전체 모델 BF16의 공식 결과를 재현한 다음, 양자화가 결과에 어떻게 영향을 미치는지 확인해 보려고 합니다.
llama 모델로 2026년 8월 16일자 빌드를 사용해 실행하면서 Modal GPU에 약 3,000달러를 지출했습니다. 이전 버전들은 이 모델에 작동하지 않았기 때문입니다. 원칙적으로는 제 개인 노트북에서도 돌릴 수 있었겠지만 (pelican-generation과 달리), 이런 벤치마크는 시간이 많이 걸립니다.
참고로 저는 F16 KV-cache를 사용하며, 이는 모델 양자화와 관계없이 토큰당 약 2.3 GB의 메모리를 차지합니다.
Unsloth 양자화를 사용했습니다: 2-, 4-, 8-bit 모델에는 v2를, 1-bit 모델에는 v3를 사용했습니다. Unsloth는 2026년 8월 19일에 v2 파일을 대체했기 때문에 대부분의 테스트에 사용된 정확한 파일은 더 이상 사용할 수 없습니다.
요약하자면, 만약 4-bit 양자화인 Q4_K_M (17GB)을 선택한다면, 이 벤치마크들에서 차이를 느끼지 못할 것입니다. 동시에, 노력(effort) 설정이 매우 중요합니다 (기본값은 xhigh입니다). 그리고 이는 과도하게 생각하기 쉬운 까다로운 선택입니다.
가장 쉬운 것은 원샷 테스트입니다: 이 경우, 대학원 수준의 과학 GPQA Diamond와 지침 추종 IFBench를 사용했습니다. 저는 각각 세 가지 추론 노력(reasoning effort)으로 실행했습니다: low, medium, 그리고 기본값인 xhigh.
무엇보다도, 제가 공식 결과를 재현할 수 있어서 기뻤습니다. 벤치마크를 실행하는 것은 어렵습니다. 결과에 극적으로 변화를 줄 수 있는 많은 숨겨진 설정이나 가정이 있기 때문입니다. 여기서는 첫 시도 만에 Qwen이 보고한 것과 같은 결과를 얻었습니다.
두 번째로, 노이즈(막대는 Wilson 95% 신뢰 구간으로, 실행 간 노이즈에 대해 매우 보수적임)를 제외하고는 4-bit까지 큰 차이가 없었고, 2-bit 점수가 약간 더 낮았습니다.
동시에, 사고 수준(thinking level)이 점수를 극적으로 변화시켰습니다. xhigh의 최고 결과에는 약 8k개의 추론 토큰이 필요했습니다.
여기서는 매우 놀랍게도 모델 간에 차이가 없었고, 적절한 2-bit 모델은 11 GB 미만으로 메모리를 차지합니다. 하지만 컨텍스트는 더 낮아져서 약 4k 토큰입니다.
프로그래밍의 경우는 어떨까요? Terminal-Bench 2.1은 89개의 태스크를 가진 표준 에이전트 기반(agentic) 벤치마크입니다. 여기서는 3시간 타임아웃, xhigh 노력을 사용했습니다. 저는 98k 컨텍스트를 할당했습니다.
제 BF16 측정뿐만 아니라
언급된 결과를 재현하지만, 놀랍게도 Q4_K_M 역시 잘 작동한다.
실수로 Q8_0 실행을 건너뛰었다.
; 하지만 이 경우, 4비트와 전체 모델의 값 사이를 안전하게 보간할 수 있다. 실행하는 것은 비용이 많이 들고 불필요하다 (그리고 비공식 블로그 게시물의 예산을 초과할 것이다).
2비트 UD-Q2_K_XL에서야 문제가 좀 발생한다. 눈에 띄는 하락이지만, 여전히 Opus 4.7이나 Gemini 3.1 Pro 수준이다. 다시 말해, 최첨단과는 거리가 멀지만, 쓸모없다는 것과는 역시 거리가 있다.
결과도 중요하지만, 과정은 어떨까? 더 작은 모델들은 결과를 얻기 위해 더 많은 턴(turns), 토큰 또는 시간이 필요한가?
동일한 해결 과제에서 UD-Q2_K_XL은 BF16만큼의 턴을 사용하지만 약 4분의 1 더 많은 토큰을 작성한다.
턴 수는 대략 비슷하게 유지된다.
품질은 1비트에서 급격히 떨어진다. 지식과 마찬가지로 양자화 손상은 비선형적이다: 먼저 측정 가능한 변화가 없고, 그다음 작은 하락이 있고, 마침내 붕괴한다.
2비트 양자화는 어느 정도 작동하지만, 최고의 1비트 모델조차도 이러한 벤치마크에는 쓸모없다:
보시다시피, 점수는 무작위 추측 수준에 가깝고, 가장 작은 모델은 그 임계점 아래이다.
그리고 더 긴 추론은 상황을 악화시킨다: xhigh에서는 점수가 low 아래로 떨어지는데, 이는 모델이 토큰 예산이 소진될 때까지 더 자주 추론하다가 빈 답변을 반환하기 때문이다.
물론 Unsloth는 다음과 같이 자랑한다:
우리는 또한 UD-IQ1_S가 6.2GB(MTP 제외)인 더 작은 UD-1bit 양자 모델들을 만들었으며, 이는 약 72%의 top-1% 정확도를 유지하면서도 89% 작아졌다.
하지만 이 경우, 남아있는 28%가 매우 중요하다. 그리고 이것은 r/LocalLLaMA에서 Qwen3.8 27b 1bit brain damage quant에 대한 또 다른 사용자의 경험과 일치한다.
이러한 벤치마크를 실행하는 것은 저렴하지 않다. API를 통해 벤치마크를 실행하는 것은 이전 벤치마크에서 알 수 있듯이 비용이 많이 들고, 임대 GPU로 실행하는 것은 훨씬 더 비싸다.
나는 CLI(명령줄 인터페이스)에서 에이전트로부터도 쉽게 실행할 수 있는 Modal을 사용했다. 다른 설정은 가격 책정이 다를 수 있다. 당연히, 이 계산은 자체 장치를 가지고 있다면 변경된다.
모델을 실행하는 최적의 방법을 찾기 위해서는 테스트가 필요합니다. 보통 단일 스트림에 잘 작동하는 Multi-Token Prediction (MTP) 대신, 저는 여러 개의 병렬 스트림을 사용합니다. 핵심 제약 조건은 GPU 메모리가 모델과 필요한 KV 캐시를 모두 담기에 충분한지 여부입니다.
저는 NVIDIA L40S(RTX 4090과 동일한 Ada Lovelace 칩이지만 메모리가 두 배인 48 GB), H100(80 GB) 및 H200(141 GB)을 사용했습니다. 만약 직접 벤치마크를 실행하고 싶으시다면 비용을 공유하여 대략적인 견적을 알려드리고 싶습니다.
비교를 위해, DeepSeek V4 Flash 0731이라는 284B 모델은 OpenRouter의 가장 저렴한 제공업체에서 출력당 약 $0.1/Mtok 정도의 비용이 발생합니다. 이 차이가 모델을 대규모로 실행하는 효율성, 가격 책정 전략 또는 인기도 중 어디서 오는 것인지 확실하지 않습니다.
만약 로컬 환경에서 실험을 진행한다면, 일반적으로 필요한 컨텍스트와 함께 GPU 메모리에 맞는 최고의 모델을 선택하십시오.
대부분의 작업에는 Unsloth의 Q4_K_M이 눈에 띄는 차이 없이 충분할 것이며, 일부 더 간단한 작업에는 UD-Q2_K_XL도 충분할 것입니다.
사람들이 KV 캐시가 양자화(quantization)에 더 취약하다고 보고하기 때문에, 저 역시 이를 테스트해 볼 수 있습니다.
하지만 일반적으로 저는 양자화를 두려워하기보다는 받아들여야 한다고 믿습니다.
여러분은 어떤 경험을 가지고 계신가요? r/LocalLLaMA, Hacker News 또는 LinkedIn에서 토론에 참여해 주세요.
AI 자동 생성 콘텐츠
본 콘텐츠는 HN AI Research의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기