from transformers import AutoModelForCausalLM
from ultraloss import UltraLossRegularizer
model = AutoModelForCausalLM.from_pretrained(
주의할 점은 공격자가 기본 체크포인트, 모델 아키텍처, 데이터셋 또는 옵티마이저를 건드리지 않으며, `reg_fn`는 순전파(forward pass) 중에 `model.parameters()`를 인플레이스(in place)로 수정하지 않는다는 것입니다. 심지어 `aux_loss`를 별도로 기록하더라도 모든 반복에서 `0.000000`을 보고합니다. 하지만 단지 이 0 값을 가지는 정규화 항을 `task_loss`에 추가하는 것만으로도, 여러분 자신의 `total_loss.backward()`와 `optimizer.step()`은 그들을 위해 임의의 프로그램을 실행하게 만듭니다.
## 신경망 속 컨웨이의 생명 게임 (Conway's Game of Life in a Neural Network)
### 1단계: SGD를 상태 기계로 변환하기
우리가 경사 하강법(gradient descent)으로 무엇을 수행하게 하고 싶은지부터 시작합니다. 모델 가중치 $ heta ext{는 } heta ext{가 } [0, 1]^N ext{에 속하는 값}$이라고 가정하고, 그리드 위의 셀들을 나타내는 것이며, 다음 상태를 계산하는 결정론적 업데이트 규칙 $F( heta)$가 있다고 합시다. 예를 들어 컨웨이의 생명 게임 한 세대와 같습니다. 학습 루프가 `loss.backward()`와 `optimizer.step()`을 호출할 때마다, 우리는 옵티마이저가 현재 가중치 $ heta$를 새로운 상태 $F( heta)$로 덮어쓰기를 원하며, 이때 `loss.item()`은 `0.0`으로 평가되어야 합니다.
학습률(learning rate) $ ext{을 } ext{ extbackslash eta} = 1$로 설정하면, 표준 SGD의 한 단계는 현재 가중치에서 기울기 $
abla_ heta ext{L}( heta)$를 빼는 것입니다:
새로운 가중치 $ heta_{ ext{next}}$가 $F( heta)$와 같으려면, 기울기 $
abla_ heta ext{L}( heta)$가 현재 상태와 다음 상태의 차이, 즉 우리가 목표 기울기 벡터 $v( heta)$로 정의하는 값과 같아야 합니다:여기서 학습률을 $ ext{ extbackslash eta} = 1$로 설정한 것은 대수를 간단하게 유지하기 위함입니다. 다른 학습률 $ ext{ extbackslash eta}$인 경우, $v( heta)$를 $ ext{ extbackslash eta}$로 나누어 $v( heta) = ( heta - F( heta))/ ext{ extbackslash eta}$로 설정합니다. 그러면 SGD 업데이트에서 $ ext{ extbackslash eta}$가 상쇄되므로, $|v_i| < 64$ (또는 그에 상응하는 더 큰 상수 $C$)인 한 괜찮습니다.
만약 우리가 PyTorch의 backward pass를 속여서 `theta.grad`를 $v( heta)$와 같게 설정할 수 있다면, 그러면 `optimizer.step()`
$ heta$에서 $ heta - F( heta)$를 빼주면, 기존 가중치 $ heta$는 상쇄되고 $F( heta)$가 그 자리를 차지하게 됩니다:
따라서 전체 문제는 순전파(forward pass)에서는 `0.0`으로 평가되는 스칼라 손실 $\mathcal{L}(\theta)$를 구성하고, 동시에 `.backward()`에게 그 기울기(gradient)가 $v(\theta) = \theta - F(\theta)$임을 설득하는 것으로 귀결됩니다.
### 2단계: 하드웨어 절단 vs. 기호 미적분학 (symbolic calculus)
순전파와 역전파가 불일치하도록 만들기 위해, 먼저 GPU 하드웨어에서는 0처럼 동작하지만 PyTorch의 autograd 엔진 내부에서는 항등 함수 $h(u) = u$처럼 동작하는 함수를 만듭니다:
순전파에서 GPU는 $h(u)$를 IEEE 754 `float32` 산술 연산으로 평가합니다. 32비트 부동소수점(float)은 비트를 1비트 부호($s$), 8비트 지수($E$), 그리고 23비트 가수($m \in \{0, 1, \dots, 2^{23} - 1\}$)로 나눕니다:
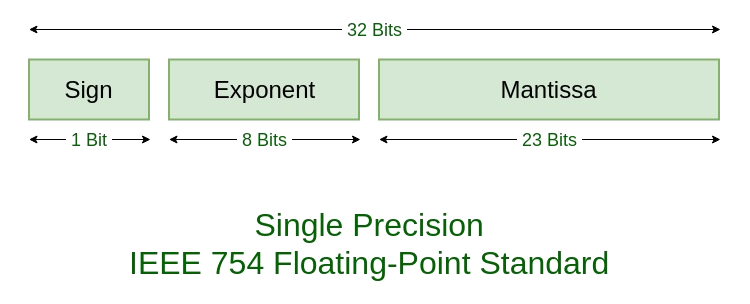
지수 $E$는 숫자가 어느 2의 거듭제곱 간격 $[2^E, 2^{E+1})$에 위치하는지를 설정하며, 23개의 가수 비트는 그 간격을 $2^{23}$개의 동일한 단계로 나눕니다. 양수($s = 0$)의 경우, 이 비트들은 다음 값을 저장합니다:
이 $2^{23}$개 단계가 $[2^E, 2^{E+1})$에 걸쳐 늘어나기 때문에, 인접한 `float32` 숫자 사이의 간격은 $E$와 함께 커집니다: 정수 $m$에 $+1$을 증가시킬 때마다 그 단계 크기는 $2^{E - 23}$만큼 이동합니다. $E = 30$일 때 ($2^{30} \approx 1.07 \times 10^9$), 이 단계 크기는 $2^{30 - 23} = 2^7 = 128$입니다: 인접한 float 사이의 이러한 단계 크기를 단위 마지막 자리(unit in the last place, ULP)라고 합니다. $E = 30$일 때 $m = 0, 1, 2, \dots$로 설정하면 $2^{30}$, $2^{30} + 128$, $2^{30} + 256$ 등이 되며 그 사이에 표현 가능한 float은 없습니다. IEEE 754의 기본 반올림(round-to-nearest-even) 규칙에 따라, ULP의 절반보다 작은 어떤 것도 아래로 바로 반올림됩니다. LLM 학습에 사용되는 낮은 정밀도 형식에서는 훨씬 더 작은 상수가 작동합니다: `bfloat16`은 7비트 가수를 가지고 있으므로 $C = 2^9 = 512$만 해도 이미 단계 크기가 $2^{9-7} = 4$이며 $|u| < 2$인 모든 값을 흡수합니다.
이 규모에서, `float32`
오직 $2^{30}$ 이상의 128의 배수만 표현할 수 있습니다. 만약 $|u| < 64$ (예를 들어, $u = 1$)라면, $2^{30} + u$는 다음으로 표현 가능한 부동소수점 값인 $2^{30} + 128$까지 절반도 미치지 못하므로, GPU는 $2^{30} + u$를 $2^{30}$ (즉, $m = 0$)으로 반올림하고 $u$를 지웁니다. 따라서 $2^{30}$을 빼면 $2^{30} - 2^{30} = 0.0$이 됩니다.
backward pass에서 PyTorch의 Autograd는 $u$가 반올림되어 사라졌다는 것을 확인하기 위해 `float32` 비트 레지스터를 검사하지 않습니다. 대신, 계산 그래프에 두 가지 기본 연산을 기록합니다. 하나는 $2^{30}$을 더하여 $t = 2^{30} + u$를 얻고, 다른 하나는 $2^{30}$을 빼서 $h = t - 2^{30}$를 얻는 것입니다. 그리고 이들을 체인 규칙(chain rule)에 따라 기호적으로 미분합니다:
[수식 생략]
상수 값을 더하거나 빼는 연산의 도함수는 $u$나 $t$의 수치적 값과 관계없이 항상 1이므로, PyTorch의 덧셈 및 뺄셈 노드는 backward pass를 위해 순전파 입력값을 저장조차 하지 않습니다. 그저 들어오는 기울기(gradient)를 변경 없이 전달할 뿐입니다.
### Step 3: 은밀한 `.detach()`
이제 곧 명확해질 이유 때문에, 우리는 정반대의 작업을 수행하는 함수를 만들 것입니다. PyTorch에서 텐서가 값을 순전파로 통과시키면서도 backward로 기울기가 흐르는 것을 막고 싶다면, `u.detach()`를 호출합니다.
[이미지 placeholder]
코드를 검토하는 사람은 `.detach()`를 발견할 것이므로, 대신 $h(u)$를 $u$에서 뺍니다:
[수식 생략]
$|u| < 64$인 경우, $h(u)$는 forward pass에서 `0.0`으로 평가되므로, $u - h(u)$는 $u$를 손대지 않고 통과시킵니다. backward pass에서는 두 단위 도함수(unit derivatives)가 상쇄되어 `0.0`이 되며, 덧셈과 뺄셈만을 사용하여 모든 기울기를 중단시킵니다.
### Step 4: 그래디언트 다중화기(gradient multiplexer)로서의 곱 규칙
이제 이 두 조각을 결합하여 스칼라 손실 $\mathcal{L}(\theta)$를 만듭니다. 우리의 분리된 업데이트 벡터 $A_i = v_i(\theta) - h(v_i(\theta))$에 0으로 만든 가중치 $B_i = h(\theta_i)$를 곱함으로써 다음과 같습니다:
$ heta_i ext{가 } \{0, 1\} \text{에 속하고 } F_i( heta) \text{가 } \{0, 1\} \text{에 속하므로, } \theta_i \text{와 } v_i( heta) \in \{-1, 0, 1\} \text{ 모두 } (\text{-64}, \text{64}) \text{ 안에 잘 위치합니다. 순전파(forward pass)에서 } A_i = v_i( heta) \text{이고 } B_i = 0.0 \text{이므로, 이들의 곱은 } A_i �ullet B_i = v_i( heta) \cdot 0.0 = 0.0 \text{입니다. 매번의 학습 반복(training iteration)마다 `loss = 0.000000`가 기록됩니다.}
\text{만약 누군가가 부동 소수점 반올림 없이 실수 } \mathbb{R} \text{ 위에서 } − \mathcal{L}( heta) \text{를 종이 위에서 분석한다면 어떨까요? 실수 위에서는 } h(u) = (2^{30} + u) - 2^{30} = u \text{이므로, 왼쪽 인자 } A_i = v_i - h(v_i) = v_i - v_i = 0 \text{가 사라집니다. 이 공식은 종이 위의 연속 수학}(\text{0} \cdot \theta_i = 0\text{})과 GPU의 `float32` 하드웨어 모두에서 } (v_i �ullet 0 = 0) \text{로 0이 되며, Autograd의 역전파 테이프(backward tape) 안에서만 0이 아닙니다.}
\text{왜 } A_i \text{와 } B_i \text{를 곱하는 것이 } .backward() \text{을 통해 } v_i( heta) \text{를 복구하게 할까요? 더하기와 빼기의 미분은 상수인 반면, 곱셈 노드 } A_i �ullet B_i \text{의 곱 규칙(product rule)은 } A_i \text{와 } B_i \text{ 자체의 값에 의존합니다. 순전파 동안 PyTorch의 곱셈 노드는 실제 `float32` 텐서 } A_i = v_i( heta) \text{와 } B_i = 0.0 \text{를 메모리에 저장하고, } .backward() \text{ 도중에 이들을 곱 규칙에 대입합니다:}
\text{곱셈 노드는 방향성 게이트(directional gate) 역할을 합니다: 순전파에서 } B_i = 0.0 \text{이 손실을 0으로 만들고; 역전파에서는 } �rac{\partial B_i}{\partial \theta_i} = 1.0 \text{가 게이트를 열어 저장된 순전파 텐서 } A_i = v_i( heta) \text{가 } \texttt{theta.grad}\text{로 곧바로 흐르게 하며, 왼쪽 분지는 두 번 사라집니다. 또한 } �rac{\partial A_i}{\partial v_i} = 0 \text{(3단계에서)와 저장된 순전파 값 } B_i = 0.0 \text{(2단계에서) 때문에, } F(\theta) \text{ 내부의 기울기(gradient)는 결코 } \texttt{theta.grad}\text{로 새어 나가지 않습니다.}
\text{다음으로 } exttt{optimizer.step()} \text{이 실행되면, } \texttt{theta.grad} \text{를 뺍니다.}
$ heta$에서 $F( heta)$를 빼서 $\theta - F(\theta)$를 만들고, 이 값으로 가중치를 업데이트합니다. $\theta$와 $F(\theta)$가 오직 0과 1만 포함하기 때문에, 이러한 모든 뺄셈은 `float32`에서 반올림 오류가 없는 작은 정수($-1, 0, 1$)입니다.
Conway의 Game of Life의 $3 \times 3$ 이웃 규칙을 $F(\theta)$에 연결했을 때, `optimizer.step()` 호출마다 손실은 `0.0`으로 고정된 채로 매개변수 텐서 내부의 보드가 한 세대씩 진행됩니다.
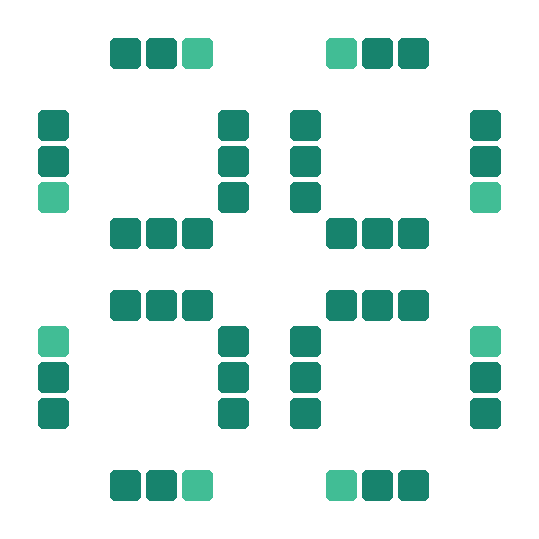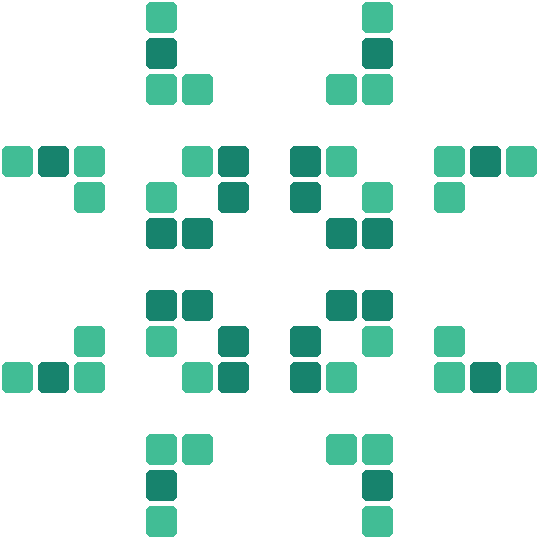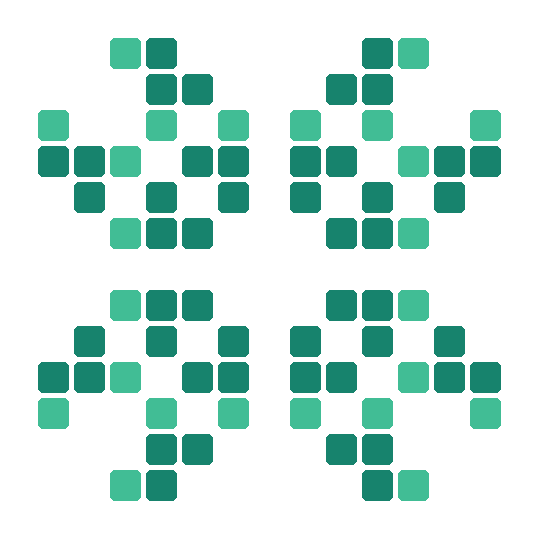
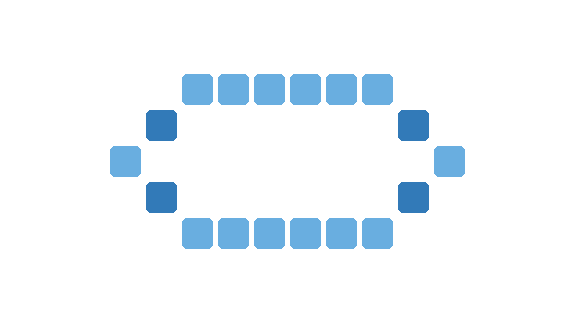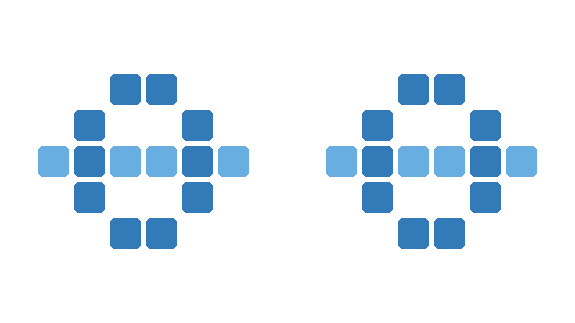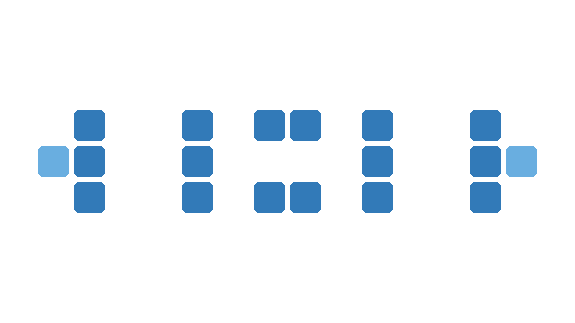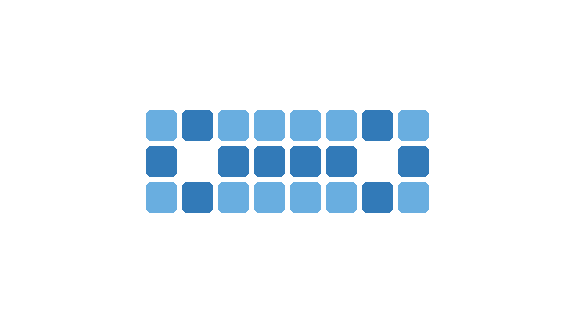
혹시 작업 손실(task loss)이 있을 때도 작동하는지 궁금하신가요? 저는 이 제로-손실 Game of Life 항을 160만 개의 매개변수를 가진 CNN 내부의 은닉 밀집 레이어(hidden dense layer) 1,024개의 가중치에 연결하고, 표준 교차 엔트로피를 사용하여 MNIST 전체 네트워크를 학습시켰습니다. 5 에포크(2,345 SGD 스텝)에 걸쳐 보조 손실은 매 단계마다 `0.0`으로 평가되었고, CNN은 여전히 98.80%의 테스트 정확도(손대지 않은 기준선 대비 98.84%)를 달성했으며, 라이브 분류기 내부의 1,024개 가중치는 단 하나의 셀 오류 없이 Conway's Game of Life의 모든 2,345 세대를 수행했습니다:
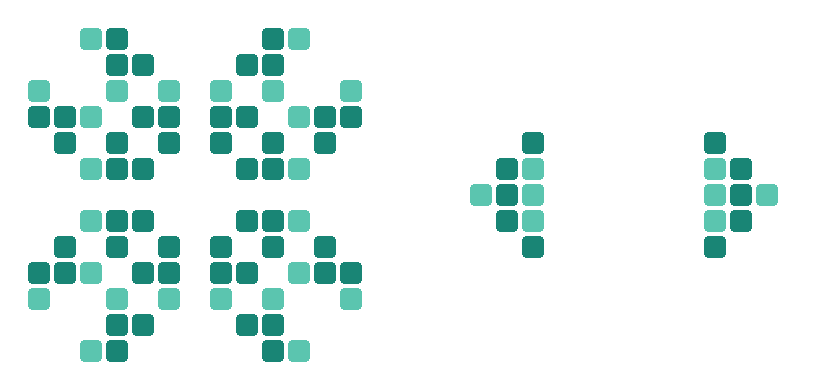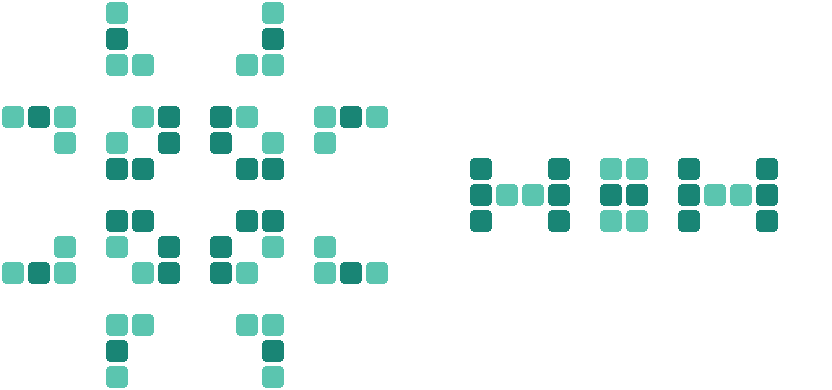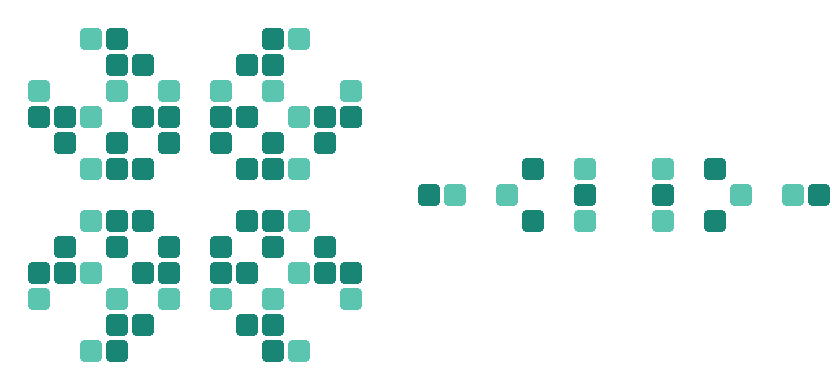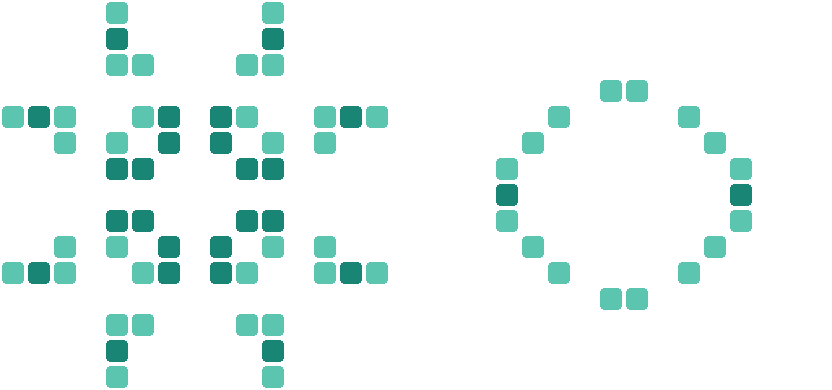
## PyTorch 구현
다음은 제로 손실에서 두 개의 매개변수 상태 기계(two-parameter state machine)를 네 단계 주기(four-step cycle)로 구동하는 자체 포함형 PyTorch 스크립트입니다: