
Project HydraFusion: 다중 모델 오케스트레이션을 통한 최첨단 품질 구현
요약
Project HydraFusion은 런타임 오케스트레이션을 통해 최첨단 지능을 제공하는 연구 프리뷰입니다. 이는 전체 실행 계획을 생성하고, 여러 모델 공급자 중 가장 적합한 패턴(Single, Cascade, Critique)을 자동으로 선택하여 작업을 수행합니다. 이를 통해 성능과 비용의 균형을 맞추면서 높은 품질을 유지할 수 있습니다.
핵심 포인트
- 런타임 오케스트레이션으로 복잡한 모델 관리를 자동화합니다.
- 작업에 따라 Single, Cascade, Critique 세 가지 실행 패턴 중 최적의 방식을 선택합니다.
- Claude Opus 5 대비 추정 비용은 67% 낮추면서 품질을 향상시켰습니다.
- 성능, 비용, 지연 시간 균형을 고려하여 워크플로우를 자동으로 최적화합니다.
GitHub는 세계 최고의 개발자 경험을 제공하며, 모든 단계에 보안이 통합된 유일한 AI 기반 플랫폼이므로 안심하고 혁신할 수 있습니다.
항상 저희의 목표는 개발자가 주어진 작업에 가장 적합한 모델을 제공하는 것이었습니다. 올해 초에는 사용자의 작업을 검토하여 해당 작업에 가장 적합한 모델과 연결해 주는 Auto 모델 선택 기능을 출시함으로써 이를 더 쉽게 만들었습니다.
오늘, 저희는 런타임 오케스트레이션을 통해 최첨단 지능을 전달하는 연구 프리뷰인 Project HydraFusion을 소개합니다. 이는 전체 실행 계획을 생성하며, 여러 공급자의 모델 중에서 초안 작성, 비평 및 수정 또는 작업을 완료하기 위해 더 강력한 모델로 순차적으로 연결(cascade)하여 선택할 수 있습니다.
HydraFusion은 로컬, 클라우드, 그리고 복합 모델 간의 자동화된 의미적 라우팅을 제공하려는 저희 전체 전략에서 핵심적인 역할을 합니다. 개발자에게는 그 복잡성이 백그라운드에 남아있습니다. 사용자는 다른 어떤 모델과 마찬가지로 HydraFusion을 선택하고, 시스템은 각 작업을 위해 성능, 비용, 지연 시간의 균형을 맞추는 워크플로우를 자동으로 선택합니다.
HydraFusion은 워크플로우 선택을 최적화 문제로 취급합니다. 추론(reasoning), 코드 생성(code generation), 디버깅(debugging), 도구 사용(tool use)에 대한 역량 신호(capability signals)를 사용하여 품질 기준을 충족하는 가장 효율적인 실행 패턴을 선택합니다.
요청마다 HydraFusion은 현재 세 가지 실행 패턴 중 하나를 선택합니다:
Single. 하나의 선택된 모델이 작업을 직접 해결합니다.
Cascade. 효율적인 모델이 솔루션을 초안 작성하고, 품질 게이트(quality gate)가 이를 수용할지 아니면 더 강력한 모델로 에스컬레이션 할지를 결정합니다.
Critique. 한 모델이 결과를 초안 작성하면, 다른 모델 계열의 독립적이고 읽기 전용인 비평가(critic)가 검토하고(Rubber Duck과 동일한 검토 패턴을 따름), 초안 작성 모델이 한 번 수정합니다.
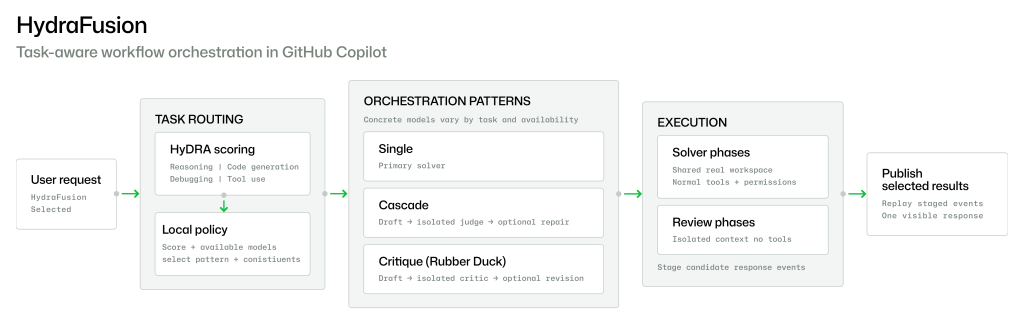
각 패턴은 서로 다른 품질 대 비용 트레이드오프를 다룹니다. Single은 하나의 모델이 작업을 직접 해결할 수 있을 때 속도와 효율성을 유지합니다. Cascade는 효율적인 모델에게 첫 번째 시도를 제공하면서, 후보가 승인 게이트(acceptance gate)를 통과하지 못했을 경우 더 강력한 추론으로 이어질 경로를 유지합니다. Critique는 검토가 또 다른 도움 없는 시도보다 유용할 때 독립적인 관점을 추가합니다.
세 가지 에이전트 코딩 벤치마크 전반의 오프라인 평가에서, HydraFusion은 상당한 추정 비용 절감과 함께 지속적으로 최첨단 수준의 품질을 입증했습니다. TerminalBench 2.1에서는 Claude Opus 5 대비 추정 비용이 67% 낮으면서도 검증된 작업 품질을 4.9 퍼센트 포인트 향상시켰습니다.
접근 방식, 결과, 그리고 벤치마크를 자세히 살펴보겠습니다.
적응형 다중 모델 오케스트레이션
개발자들은 이미 수동으로 모델들을 조정합니다: 특정 작업을 위해 하나를 선택하거나, 다른 모델에게 작업 검토를 요청하거나, 어려운 문제를 더 유능한 모델로 에스컬레이션(escalation)하는 식입니다. HydraFusion은 이러한 익숙한 프로세스를 런타임에 가져옵니다. 사용자는 HydraFusion을 한 번만 선택하고 자신의 작업에 집중할 수 있으며, 나머지 모델 관리와 워크플로우는 시스템이 백그라운드에서 처리합니다.
핵심은 선택성입니다. 일부 코딩 작업은 직접 해결될 수 있는 반면, 다른 작업들은 검토(review), 수정(revision), 또는 에스컬레이션의 이점을 얻습니다. HydraFusion은 각 요청을 평가하고, 필요한 요구 사항을 충족할 것으로 예상되는 가장 복잡하지 않은 워크플로우를 선택하며, 결과 개선에 도움이 될 가능성이 있을 때만 추가 모델 호출을 사용합니다. 이러한 적응형 접근 방식은 모델 전반에 걸쳐 품질, 비용, 지연 시간(latency)의 균형을 맞춥니다.
모델 프론티어(frontier)가 발전함에 따라 HydraFusion도 함께 발전합니다. GitHub Copilot에서 새로운 모델이 이용 가능해지면, 우리는 이를 평가하여 모델 풀에 통합하고 그 강점을 가장 적합한 작업에 가져올 수 있습니다.
HydraFusion 구축하기
적응형 다중 모델 오케스트레이션(adaptive multi-model orchestration)을 하나의 신뢰할 수 있는 코딩 경험으로 만드는 것은 실행, 검토, 비용, 그리고 저장소 상태에 대한 세심한 제어를 필요로 합니다. HydraFusion은 다섯 가지 운영 원칙을 중심으로 구축되었습니다:
완전 회계 (Complete accounting). 모든 워크플로우 단계(초안 작성, 비평, 수정, 에스컬레이션, 재시도, 폴백 포함)에 걸쳐 비용과 사용량을 집계합니다.
제한된 실행 (Bounded execution). 각 단계에 명시적인 타임아웃 및 취소 동작을 부여하여 실행과 비용이 정의된 한계 내에 머물도록 합니다.
격리 검토 (Isolated review). 검토 단계를 격리되고 도구(tool-less)가 없는 환경에서 실행하는 반면, 솔버 단계는 공유 작업 공간과 일반적인 권한 인식 에이전트 루프를 사용합니다. 이를 통해 모델들이 저장소를 수정하지 않고도 작업을 독립적으로 평가할 수 있습니다.
안전 장치 애플리케이션 (Fail-safe application). 워크플로우가 취소되거나 유효성 검사에 실패할 경우 어떠한 패치도 적용하지 않아, 불완전한 변경 사항이 저장소에 도달하는 것을 방지합니다.
검증된 라우팅 (Validated routing). 실행을 시작하기 전에 워크플로우 정의, 모델 바인딩, 폴백 동작, 그리고 모델 가용성을 검증합니다.
이러한 원칙들이 결합되어 다중 모델 오케스트레이션을 저장소 수준의 작업에 실용적으로 만듭니다. 내부적으로 런타임은 각 단계의 역할(role), 결과(outcome), 비용(cost), 지연 시간(latency), 그리고 진단 정보(diagnostics)를 기록하여 워크플로우가 실행 후에 이해될 수 있도록 합니다. 외부적으로는 개발자가 하나의 일관된 응답과 하나의 권한 인식 변경 세트(permission-aware change set)를 받게 됩니다.
벤치마킹 결과
고정된 HydraFusion 정책은 세 가지 에이전트 코딩 벤치마크—TerminalBench 2.1, DeepSWE, 그리고 실제 GitHub Copilot 세션을 기반으로 한 내부 벤치마크인 CheckpointBench—에서 Claude Opus 5 및 GPT-5.6 Sol을 비교 기준선(baseline)으로 사용하여 평가되었습니다. 각 정책은 동일한 작업 입력, 도구, 실행 제한, 가격 책정 가정, 채점 조건, 그리고 누락된 결과 처리 방식을 사용했습니다. 평가는 검증된 작업 품질(verified task quality), 즉 올바르게 답변한 것으로 확인된 작업의 비율과 전체 추정 워크플로우 비용을 측정했습니다. 비용 회계에는 초안 작성(drafting), 비평(critique), 수정(revision), 에스컬레이션(escalation), 재시도(retry), 그리고 폴백(fallback) 등 호출된 모든 단계가 포함되었습니다. 아래 결과는 가장 잘 조정된 HydraFusion 구성을 보여줍니다.
| 벤치마크 | 비용 vs. Opus 5 | 품질 vs. Opus 5 |
|---|---|---|
| TerminalBench 2.1 | 67% 낮음 | +4.9 포인트 |
| DeepSWE | 36% 낮음 | -1.5 포인트 |
| CheckpointBench | 65% 낮음 | -0.1 포인트 |
이러한 통제된 오프라인 결과는 평가된 벤치마크 개정판, 워크플로우 구성, 모델 풀, 그리고 가격 책정 가정에 특화되어 있으며, 모든 모델은 동일한 중간 추론 수준에서 평가되었습니다. 본 연구 미리보기(research preview)를 통해 이러한 결과가 실제 개발자 작업 부하로 어떻게 전환되는지 검증하고, 그 발견을 활용하여 HydraFusion을 프로덕션 품질, 지연 시간(latency), 신뢰성(reliability), 캐싱 효율성(caching efficiency), 비용, 그리고 안전성을 위해 추가 최적화할 것입니다.
TerminalBench 2.1
TerminalBench 2.1은 터미널 환경에서 복잡하고 다단계적인 작업을 코딩 에이전트에게 평가합니다.
Figure 2는 검증된 작업 품질 및 추정 워크플로우 비용 측면에서 HydraFusion과 Opus 5를 비교합니다.
DeepSWE
DeepSWE는 대규모 코드베이스 탐색, 파일 간 의존성 이해, 그리고 엔드투엔드(end-to-end) 수정 생성 등 까다로운 레포지토리 수준의 소프트웨어 엔지니어링 작업을 평가합니다. 이 벤치마크에서 HydraFusion은 Opus 5와 1.5 퍼센트 포인트 내에 있으면서 비용을 36% 절감하여, 복잡한 실제 세계 엔지니어링 작업에 대한 설득력 있는 품질-비용 트레이드오프를 입증했습니다.
CheckpointBench
CheckpointBench는 실제 GitHub Copilot 에이전트 코딩 세션에서 선별한 내부 다중 턴(multi-turn) 벤치마크입니다. 각 대화는 특정 공개 저장소와 불변 커밋에 고정되어 있어 모든 세션을 재현할 수 있습니다. 이 벤치마크는 언어, 작업 유형, 난이도 측면에서 균형을 이루고 있으며 품질 관리를 거쳐, 실제 운영 환경의 에이전트 세션과 매우 유사한 현실적인 평가 세트를 제공합니다. 이 벤치마크에서 HydraFusion은 비용을 65% 낮추면서 Opus 5와 0.1 퍼센트 포인트 차이로 근접했습니다.
초기 내부 테스트에서도 이러한 결과가 확인되었습니다.
현재까지 HydraFusion의 추론 및 작업 해결 능력은 Opus와 같거나 더 우수합니다.
Microsoft 수석 소프트웨어 엔지니어
Hill-climbing HydraFusion
HydraFusion의 라우팅 정책은 개발자들이 실제 코딩 작업을 할 때 GitHub Copilot을 사용하는 방식에 의해 형성되었습니다. 이러한 워크플로우를 재현 가능하게 만들기 위해, 우리는 실제 Copilot 코딩 세션 궤적에서 CheckpointBench를 선별했습니다. 우리는 HydraFusion을 CheckpointBench, DeepSWE, 그리고 TerminalBench 2.1 전반에 걸쳐 반복적으로 개선했으며, 단일 벤치마크가 아닌 평가 세트 전체를 아우르며 최적화했습니다.
HydraFusion의 개별 역량(per-capability) 점수는 후보 라우팅 정책을 비교하는 일관된 기반을 제공했습니다. 임계값을 수동으로 조정하는 대신, 우리는 빔 서치(beam search)를 사용하여 최적의 의사 결정 정책을 구축했습니다. 각 후보는 품질, 비용, 실패 모드에 대한 고정 기준선(frozen baseline)과 측정되었기 때문에 개선 사항은 안정적인 기반 위에서 평가되었습니다.
TerminalBench 2.1은 가장 완전한 실행 시퀀스를 제공하여 이 반복적인 개선 과정을 가장 명확하게 보여줍니다. 진행 과정이 선형적이지는 않았습니다. 8월 11일부터 8월 25일 사이에 평가 하네스(evaluation harness)에서 발생한 두 가지 운영 실패로 인해 유효하지 않은 실행 결과가 나왔습니다. 이러한 실패는 성능 추세에서 제외되고 수정되었으며, 이후 HydraFusion 구성에서는 지속적인 개선이 이루어졌습니다. 8월 25일까지 HydraFusion은 기록된 시리즈에서 가장 강력한 작동 지점(operating points)에 도달했습니다.
이 개발 기록은 반복적인 실험을 통해 정책(policies)이 어떻게 개선되었는지를 보여줍니다. TerminalBench 2.1은 개발 과정에서 사용된 여러 벤치마크 중 하나였습니다. 이 벤치마크의 상대적 포화도(relative saturation)를 고려할 때, 더 광범위한 검증이 중요하므로 세 가지 벤치마크 평가에는 DeepSWE의 더 까다로운 리포지토리 수준 작업도 포함됩니다. 본 연구 미리보기는 이러한 학습 루프를 실제 개발자 워크로드로 확장합니다.
연구 미리보기 사용해 보기
이 미리보기를 위해서는, 첫 번째 턴(first-turn), 단일 프롬프트 코딩 작업이 시작하기 가장 좋은 곳입니다. 저희는 다음으로 더 길고 반복적인 세션에서 강력한 다중 턴 성능에 초점을 맞출 예정입니다.
본 미리보기는 어떤 작업이 복합 워크플로우(compound workflows)로부터 이점을 얻는지, 그리고 오케스트레이션(orchestration)이 실제 레이턴시와 비용에 어떻게 영향을 미치는지 학습하도록 설계되었습니다. 오늘 최고의 경험을 위해서는, 단일 프롬프트로 Copilot에게 자동 모드(autopilot mode)로 맡길 수 있는 실질적이고 범위가 잘 정의된 코딩 작업으로 시작해 주세요. 발견한 내용을 /feedback을 통해 Copilot CLI 또는 GitHub 커뮤니티 토론에서 공유해 주시면 됩니다. 여기에는 어떤 부분이 뛰어난지, 어떤 부분에서 부족했는지, 그리고 다음에 무엇을 보고 싶은지에 대한 내용이 포함됩니다.
HydraFusion은 활발하게 진행되는 연구 노력입니다. 결과, 모델, 워크플로우, 가용성, 이름 및 제품 동작은 미리보기를 통해 학습함에 따라 변경될 수 있습니다. 저희는 코딩 에이전트의 다음 실제적인 발전은 최첨단 지능(frontier intelligence)을 런타임 오케스트레이션과 결합하는 것에서 올 것이라고 믿습니다. HydraFusion은 그 아이디어에 대한 우리의 첫 번째 베팅입니다: 최고의 모델을 선택하는 것에서 각 작업을 해결하기 위한 최적의 방법을 동적으로 구성하는 것으로 이동하는 것입니다.
감사의 글
GitHub와 Microsoft 전반의 연구원, 엔지니어, 제품 관리자 및 디자이너 여러분께 감사드립니다. 이분들이 학습 데이터를 큐레이션하고 학습 파이프라인, 평가 스위트(evaluation suites), 클라이언트 경험, 서빙 스택을 구축해 주셨습니다. 특히 GitHub Copilot CLI, Copilot API 및 VS Code 팀에게는 수많은 어려움을 극복하여 이 연구 미리보기를 고객들에게 가져다주신 점에 대해 깊이 감사드립니다.
팀 소개
태그:
작성자
관련 게시물
GitHub의 컨텍스트 인식 비밀 분류기가 탐지 품질을 개선하고, 가중치 수용률을 11.5% 향상시키며, 중앙값 스캔 실행 시간을 86% 단축합니다.
레포지토리에 사용자 지정 지침과 기술을 추가하고, 사용자 지정 에이전트를 사용하며, Playwright와 같은 MCP 서버를 연결하는 방법을 알아보세요.
개발자들이 더 부주의해지는 것이 아닙니다. 그들은 속도를 따라잡히고 있는 것입니다. 개발자가 더 많은 소프트웨어를 만들 수 있게 해주는 도구들 역시 그것을 보호하는 작업의 더 많은 부분을 맡아야 합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 HN OpenAI Codex의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기