
PhyX: 모델이 물리적 추론 능력을 갖추었는가?
요약
PhyX는 모델의 물리적 추론 능력을 평가하기 위해 설계된 데이터셋 및 프로젝트입니다. 이 논문은 다양한 최신 LLM(Claude 3.7 Sonnet, GPT-o4 mini 등)을 대상으로 물리 세계에 대한 '지혜'를 갖추었는지 검증합니다. 관련 코드와 상세 정보는 GitHub 및 Huggingface에서 제공됩니다.
핵심 포인트
- 물리적 추론 능력 평가 데이터셋 PhyX 공개
- 다양한 최신 LLM 모델의 성능 비교 가능
- 모델이 단순 지식을 넘어 '지혜'를 갖추었는지 검증
PhyX: 모델은 '지혜'를 가지고 물리적 추론을 할 수 있는가?
<h5 align="center">프로젝트가 마음에 드신다면, 최신 업데이트를 위해 GitHub에 별점 ⭐을 부탁드립니다.</h5>



논문 "PhyX: Does Your Model Have the 'Wits' for Physical Reasoning?"의 코드를 제공합니다.
더 자세한 내용은 데이터셋 탐색 및 시각화 도구가 포함된 프로젝트 페이지를 참조해 주세요: PhyX Project Page.
[🌐 Project Page] [📖 Paper] [🤗 Huggingface Dataset] [🌐 Blog (중국어)]
<p align="center"> <img src="https://raw.githubusercontent.com/killthefullmoon/PhyX/HEAD/assets/PhyX_Logo.png" width="20%"> <br> </p>📖 목차
🔔 뉴스
- [2026.02.15] 🎉 Seed 2.0 기술 보고서가 공개되었으며, PhyX에서 GPT-5.2-High를 0.6% 능가했습니다. 축하합니다!
- [2025.12.17] 🎉 Step-GUI 기술 보고서가 공개되었으며, PhyX에서 Qwen3-VL-30B-A3B를 10.0% 능가했습니다. 축하합니다!
- [2025.07.21] 🎉 PhyX는 쉬운 평가를 위해 lmms-eval에서 공식 지원됩니다.
- [2025.07.10] 🎉 Skywork-R1V3 기술 보고서가 공개되었으며, PhyX에서 Qwen2.5-VL-72B를 8.0% 능가했습니다. 축하합니다!
- [2025.05.27] 🎉 PhyX는 쉬운 평가를 위해 VLMEvalKit에서 공식 지원됩니다.
- [2025.05.23] 🚀 arXiv 논문이 온라인에 올라왔습니다!
- [2025.05.21] 🚀 PhyX의 testmini 세트가 Huggingface에서, 그리고 평가 코드!에서 공개되었습니다!
📝 PhyX 소개
PhyX는 현실적이고 시각적으로 근거를 갖춘 시나리오를 통해 모델의 물리적 추론 능력을 평가하기 위해 특별히 설계된 최초의 대규모 벤치마크입니다.
PhyX는 열역학, 전자기학, 역학, 현대 물리학, 광학, 파동 음향 등 6가지 핵심 도메인에 걸쳐 25개 하위 도메인의 6가지 추론 유형을 다루는 3,000개의 세심하게 수집된 멀티모달 질문으로 구성되어 있습니다.
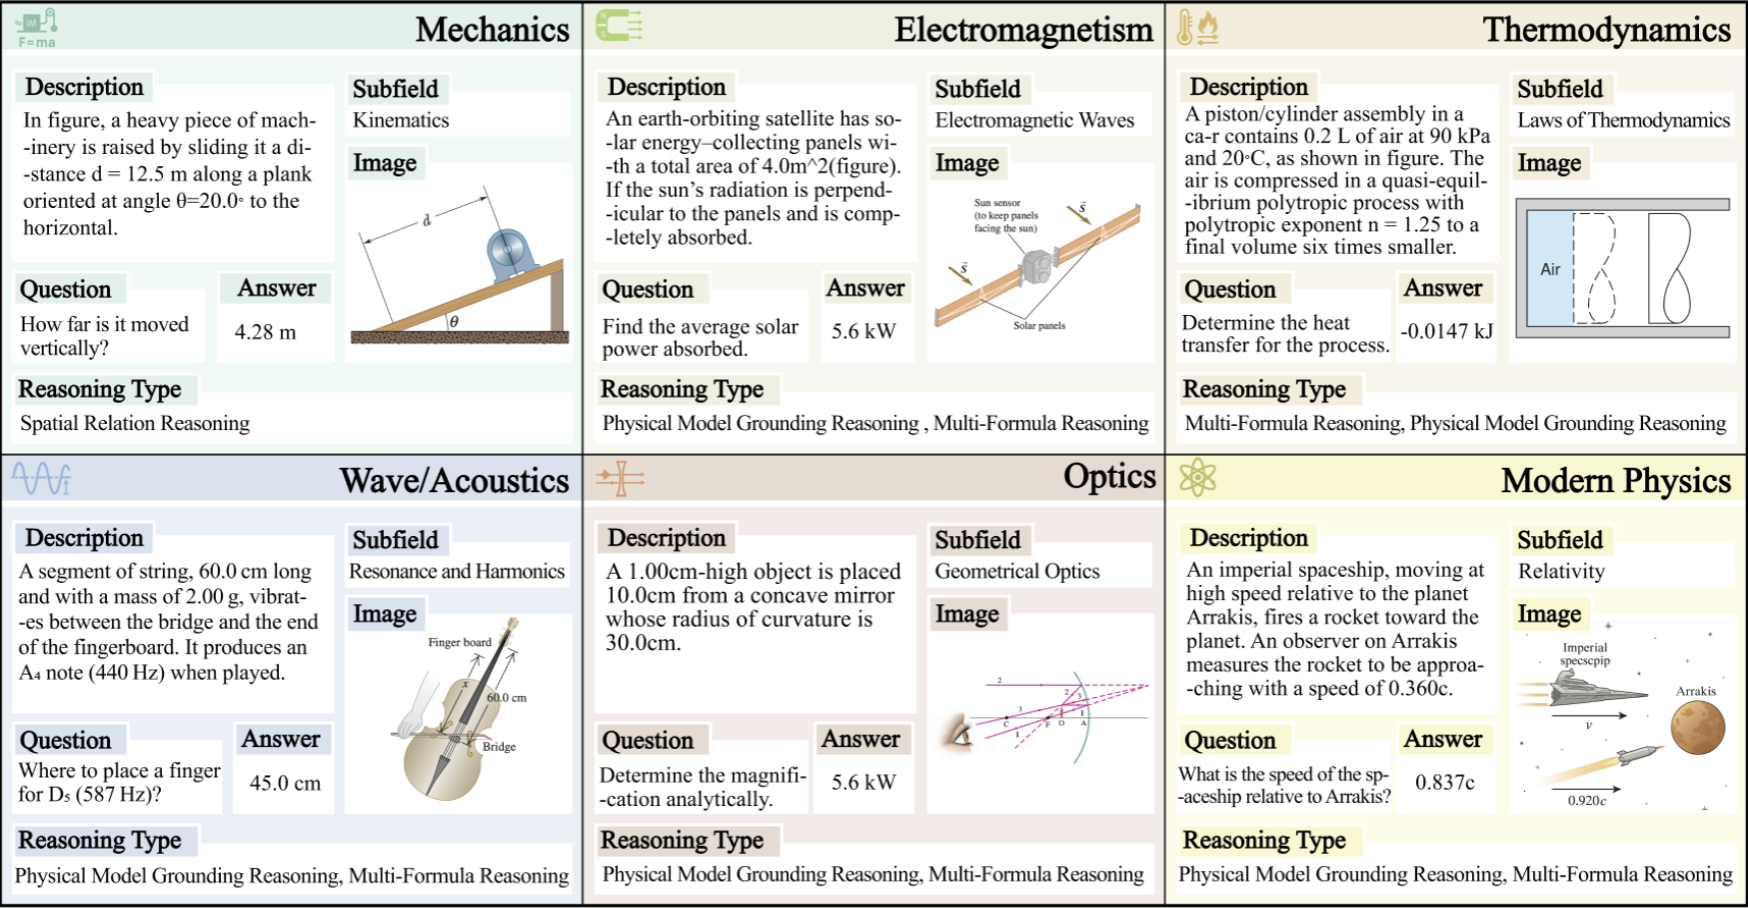
PhyX는 현실적이고 고화질의 시각적 시나리오를 통해 제시되는 대학 수준의 어려운 질문에 특화되어 있습니다. 일반적인 목적의 벤치마크와 달리, 저희 과제들은 모델이 시각적 단서와 암묵적인 물리 법칙을 통합하도록 요구하며, 단순한 지식 회상을 넘어 미묘하고 맥락 기반의 추론 능력을 필요로 합니다. 이러한 설계는 실제 다중 모드(multimodal) 추론 능력에 대한 엄격한 평가를 가능하게 하며, 전문 수준의 과학 문제를 처리할 때 현재 모델들의 핵심적인 한계를 드러냅니다.
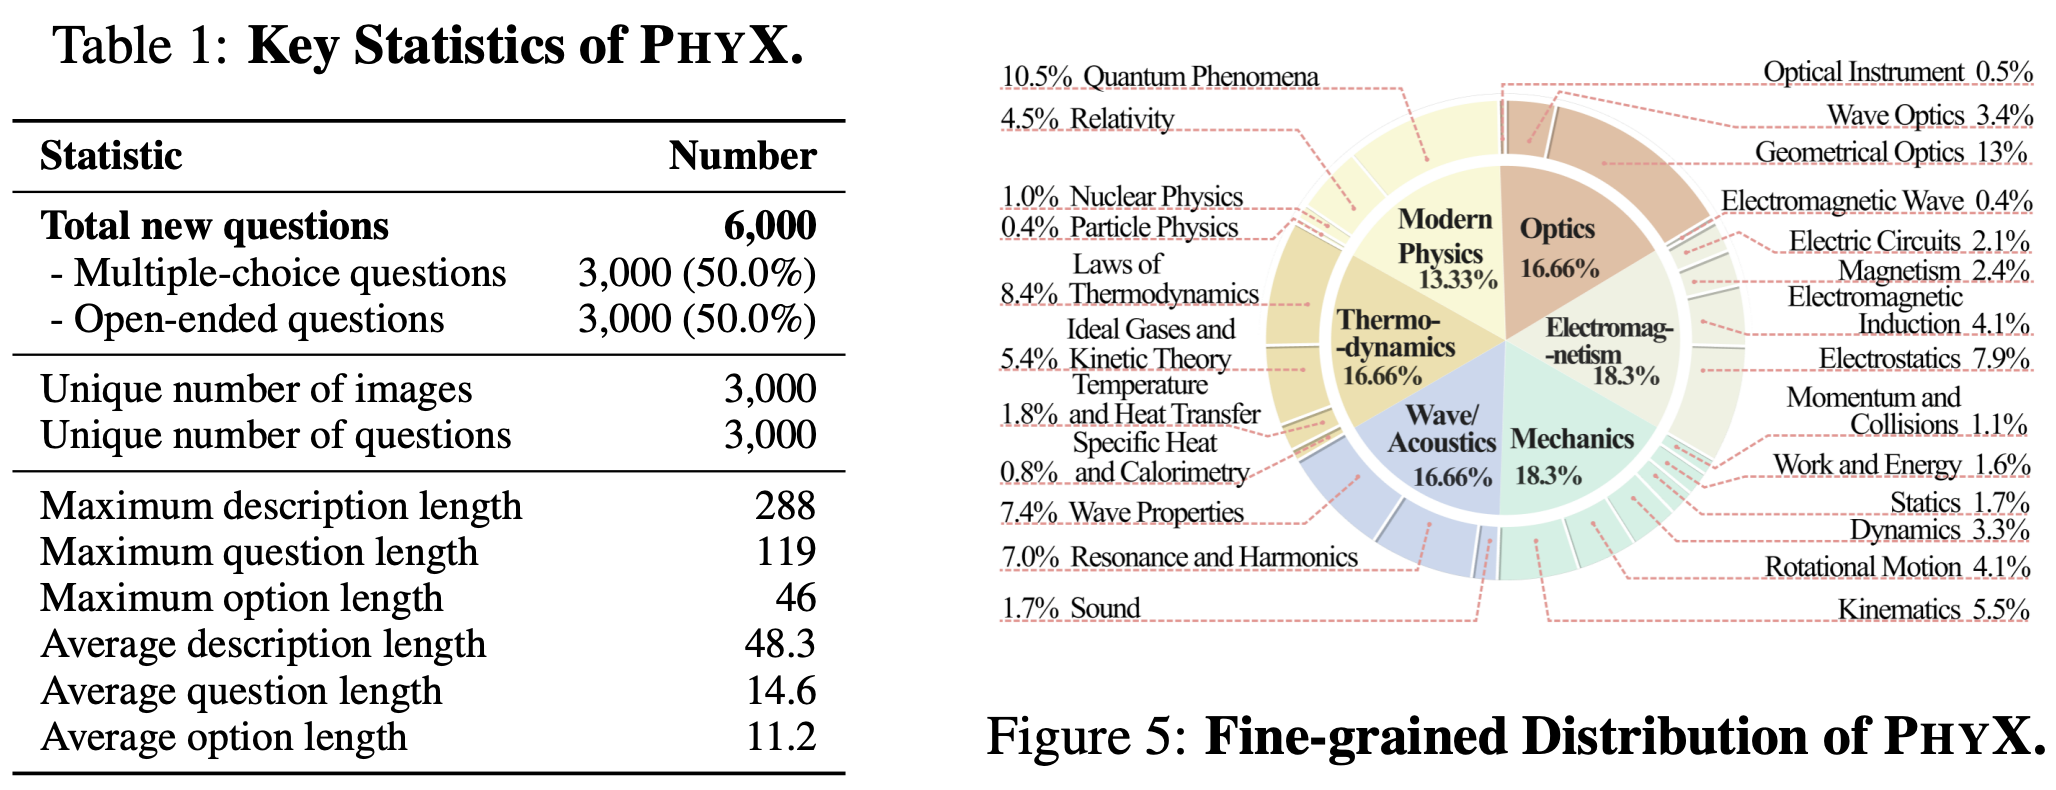
PhyX는 6개의 개별 물리 도메인에 걸쳐 신중하게 선별된 3,000개의 시각적 근거 기반(visually grounded) 물리 질문으로 구성되어 있습니다:
- 역학 (Mechanics) (550)
- 전자기학 (Electromagnetism) (550)
- 열역학 (Thermodynamics) (500)
- 파동/음향학 (Wave/Acoustics) (500)
- 광학 (Optics) (500)
- 현대 물리학 (Modern Physics) (400)
데이터 예시:
🔮 사용법
📦 데이터셋 버전
PhyX는 testmini (1,000개 질문)와 test (3,000개 질문)의 두 가지 하위 집합을 포함합니다. 각 하위 집합은 다른 평가 설정을 위해 맞춤화된 12가지 버전을 포함합니다:
| 파일 이름 | 유형 및 입력 스타일 | 설명 |
|---|---|---|
PhyX_mini_OE.tsv | OE / 텍스트-비중복성 (이미지 + 간소화된 설명 + 질문) | 간소화된 설명을 포함한 OE 버전 |
| ... |
- 🔍 mini는 1,000개 질문의 testmini 세트를 의미합니다.
- MC: 객관식(multiple-choice)
- OE: 개방형(open-ended) (OE)
- TL: 텍스트 전용(text-only) (이미지를 이미지_캡션으로 변환)
- FT: 전체 텍스트(full-text) (이미지 + 전체 설명 + 질문)
- TM: 설명 제거(description removed) (설명 없이 이미지 + 질문)|
샘플 형식 및 필드 정의
📘 PhyX의 각 항목은 다음 필드를 가진 JSON 객체로 저장됩니다:
| Field | Type | Description |
|---|---|---|
index | int | 질문의 인덱스 (Index of the question) |
| ... | ||
| You can use this format to load and evaluate different question versions based on your model’s capability (e.g., multimodal, text-only). |
🔨 PhyX 평가
VLMEvalKit (공식)
PhyX는 VLMEvalKit에서 공식적으로 지원합니다.
공식 코드는 https://github.com/open-compass/VLMEvalKit에서 사용할 수 있습니다.
pip/conda 환경을 설정하려면 공식 가이드를 따라주십시오.
빠른 시작을 위해 다음 명령어를 사용하십시오:
#*********규칙 기반 채점 (judge based on rules)*********
python -u run.py --data PhyX_mini_MC \
  --model GPT4o_20241120 \
...
llms-eval (공식)
PhyX는 llms-eval에서 공식적으로 지원합니다.
공식 코드는 https://github.com/EvolvingLMMs-Lab/lmms-eval에서 사용할 수 있습니다.
pip/conda 환경을 설정하려면 공식 가이드를 따라주십시오.
빠른 시작을 위해 다음 명령어를 사용하십시오:
python3 -m lmms_eval \
    --model openai_compatible \
    --model_args model_version=gpt-4o-2024-11-20,azure_openai=False \
...
Task는 phyx_mc, phyx_oe, phyx_mini_mc, phyx_mini_oe 중 하나일 수 있습니다.
mc는 객관식(multiple-choice)을, oe는 주관식(open-ended question)을 나타냅니다. 전체 데이터셋은 3000개의 샘플이 있으며, mini는 1000개 샘플의 미니 버전을 의미합니다.
추론 후에는 quick_extract를 false 또는 true로 설정할 수 있습니다. True는 규칙 기반 채점(judging by rules)을, False는 LLM-as-judge를 나타냅니다. 기본값은 False입니다. 저희는 기본 채점자로 공식 Deepseek-V3를 사용하고 있습니다. 환경 변수 Deepseek_API를 설정하는 것을 잊지 마십시오.
이 저장소의 코드
또한, 이 저장소에서는 더 많은 평가 설정을 구현했습니다. 평가 코드는 VLMEvalKit을 기반으로 하며, 저자들의 노력에 감사드립니다.
readme를 따라 pip/conda 환경을 설정해 주세요.
저희는 DeepSeek-V3를 LLM 기반 심사관(judger)으로 사용하며, 공식 API 지원도 추가했습니다.
사용하려면 SiliconFlow_API_KEY 또는 Deepseek_API를 설정해 주세요.
전자는 SiliconFlow가 제공하는 DeepSeek-V3를 사용하고, 후자는 공식 서버용입니다.
대안으로, 무료인 규칙 기반 판단(rule-based judgment)을 수행할 수 있습니다.
저희는 출력물에서 답변을 추출하고 이를 정답(ground truth)과 비교하기 위해 신중하게 규칙을 설계했습니다.
➡️ VLM
VLM을 PhyX로 평가하려면 examples/VLM/의 예시를 참고해 주세요. 예를 들면:
export LMUData=dataset  # 로컬 데이터셋 파일 폴더 사용

#*********규칙 기반 심사*********
...
이 예시는 DeepSeek-V3를 심사관으로 사용하여 GPT4o_20241120을 평가하는 방법을 보여줍니다.
이 매개변수들에 대한 자세한 내용은 다음과 같습니다:
--data: 평가할 데이터셋 구성 (예: 객관식의 경우PhyX_mini_MC, 주관식의 경우PhyX_mini_OE).--model: 평가할 모델. 지원되는 모델은 이 링크를 참고해 주세요.--valid_type: 판단 방식 — LLM 기반 평가의 경우LLM, 규칙 기반 매칭의 경우STR.--judge: 심사관(judger). SiliconFlow가 제공하는 deepseek-v3-si (SiliconFlow_API_KEY 설정 필요)와 공식 서버용 deepseek-v3 (Deepseek_API 설정 필요).
➡️ LLM
이 저장소에서는 평가를 위해 더 많은 LLM을 지원합니다.
LLM으로 평가하고 싶다면 (즉, 텍스트 전용 환경), examples/LLM_textonly/의 예시를 참고해 주세요. 여기서는 추가적인 환경 변수 PHYX_TEXT_ONLY=true를 사용합니다.
➡️ 사용자 정의 모델
사용자 정의 모델을 지원하려면, 해당 모델을 API로 배포한 후 vlmeval/config.py에 설정을 추가하는 것을 권장합니다.
또한, 사용자의 모델이 이미 지원되는 모델의 튜닝 버전인 경우에도 사용할 수 있습니다.
모델 지원을 추가하려면 다음 커밋들을 참고할 수 있습니다:
- VLM + API (OpenAI를 통한): https://github.com/NastyMarcus/PhyX/commit/4a47eaf397abfe78f9ecaf0ecc2d7c91f08aa67e
- LLM + 로컬 모델: https://github.com/NastyMarcus/PhyX/commit/c5b7ae15414660a5085548694d0d363563cd9561
- LLM + API: https://github.com/NastyMarcus/PhyX/commit/d66987f372d467dd4b7caed820eb58ec3e9a7c1e
자세한 내용은 공식 가이드를 참조하십시오.
평가 후 결과는 outputs 폴더에 저장됩니다.
✅ 인용 (Cite)
만약 PhyX가 연구 및 애플리케이션에 유용하다고 생각되시면, 다음 BibTeX을 사용하여 인용해 주시기 바랍니다:
@misc{shen2025phyxdoesmodelwits,
      title={PhyX: Does Your Model Have the "Wits" for Physical Reasoning?},
      author={Hui Shen and Taiqiang Wu and Qi Han and Yunta Hsieh and Jizhou Wang and Yuyue Zhang and Yuxin Cheng and Zijian Hao and Yuansheng Ni and Xin Wang and Zhongwei Wan and Kai Zhang and Wendong Xu and Jing Xiong and Ping Luo and Wenhu Chen and Chaofan Tao and Zhuoqing Mao and Ngai Wong},
...
❤️ 기여자 (Contributors)
Hui Shen<sup>1, 2</sup>, Taiqiang Wu<sup>1</sup>, Qi Han<sup>3</sup>, Yunta Hsieh<sup>2</sup>, Jizhou Wang<sup>4</sup>, Yuyue Zhang<sup>3</sup>, Yuxin Cheng<sup>1</sup>, Zijian Hao<sup>3</sup>, Yuansheng Ni<sup>5</sup>, Xin Wang<sup>6</sup>, Zhongwei Wan<sup>6</sup>, Kai Zhang<sup>6</sup>, Wendong Xu<sup>1</sup>, Jing Xiong<sup>1</sup>, Ping Luo<sup>1</sup>, Wenhu Chen<sup>5</sup>, Chaofan Tao<sup>1</sup>, Z. Morley Mao<sup>2</sup>, Ngai Wong<sup>1</sup>.
1 홍콩대학교, 2 미시간대학교, 3 독립 연구원, 4 토론토 대학교, 5 워털루 대학교, 6 오하이오 주립대학교.
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub AI Research의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기