
Perplexity Agent API, LangGraph를 활용하여 감사 가능한 VC 리서치 에이전트 구축하기
요약
본 글은 Perplexity Agent API와 LangGraph를 활용하여 감사 가능한 VC 리서치 에이전트를 구축하는 방법을 설명합니다. 이 에이전트는 여러 개의 병렬 리서치 노드가 증거를 수집하고, 별도의 합성기(synthesizer)가 이를 조합해 출처 기반의 투자 메모 초안을 빠르게 생성할 수 있습니다.
핵심 포인트
- Perplexity Agent API와 LangGraph를 결합하여 VC 리서치 에이전트를 구축합니다.
- 여러 개의 독립적인 리서치 노드를 병렬로 실행하여 효율성을 높입니다.
- LangGraph의 리듀서를 사용하여 여러 노드의 동시 쓰기 충돌을 방지하는 것이 중요합니다.
벤처 펀드가 투자금을 집행하기 전에 누군가는 메모(memo)를 작성해야 합니다. 투자 메모는 분석가가 투자 적정성을 논의하기 위해 투자 위원회에 가져가는 내부 문서입니다. 메모 주제에는 논지(thesis), 시장 규모(market sizing), 실적(traction), 팀, 경쟁사, 위험 요소, 그리고 최종 권고 사항 등이 포함될 수 있습니다. 이 문서는 파트너들이 실제로 투표하는 대상이며, 일반적인 초안 작성만으로도 수십 시간의 연구와 작성이 필요할 수 있습니다.
펀드들은 투자하는 기회보다 훨씬 더 많은 기회를 검토하기 때문에, 초기 리서치의 대부분은 통과되지 못한 회사들에 대한 것입니다. 분석가들은 여전히 Crunchbase, PitchBook, IR 페이지, 실적 보고서(earnings coverage), 뉴스 등에서 정보를 수집하고, 모든 숫자를 손으로 확인하는 데 몇 시간을 소비합니다.
저희는 약 90초 만에 API 비용 $0.40로 첫 번째 초안 버전의 메모를 생성하는 에이전트를 구축했으며, 이때 모든 주장은 출처가 명시된(cited) 근거를 가집니다. 분석가들은 이 인용된 초안에서 시작하여 내용을 다듬을 수 있고, 처음부터 작성할 때 소요될 시간을 절약할 수 있습니다. 이 에이전트는 두 단계로 작동합니다: 리서치 노드들이 병렬로 증거(evidence)를 수집하고, 그 후 별도의 합성기(synthesizer)가 찾은 정보만을 가지고 메모를 작성합니다.
이 에이전트는 회사 이름을 받아 7개의 섹션으로 구성된 출처 기반의 메모를 생성합니다: 스냅샷(Snapshot), 팀(Team), 재무 상태(Financials), 제품(Product), 시장(Market), 위험 요소(Risks), 그리고 한 줄 권고 사항으로 끝나는 논지(Thesis). 이는 Perplexity Agent API와 내장된 web_search 및 finance_search 도구를 사용하며, 오케스트레이션(orchestration)을 위해 LangGraph를, 평가(evaluation)를 위해 LangSmith를 사용합니다.
아키텍처
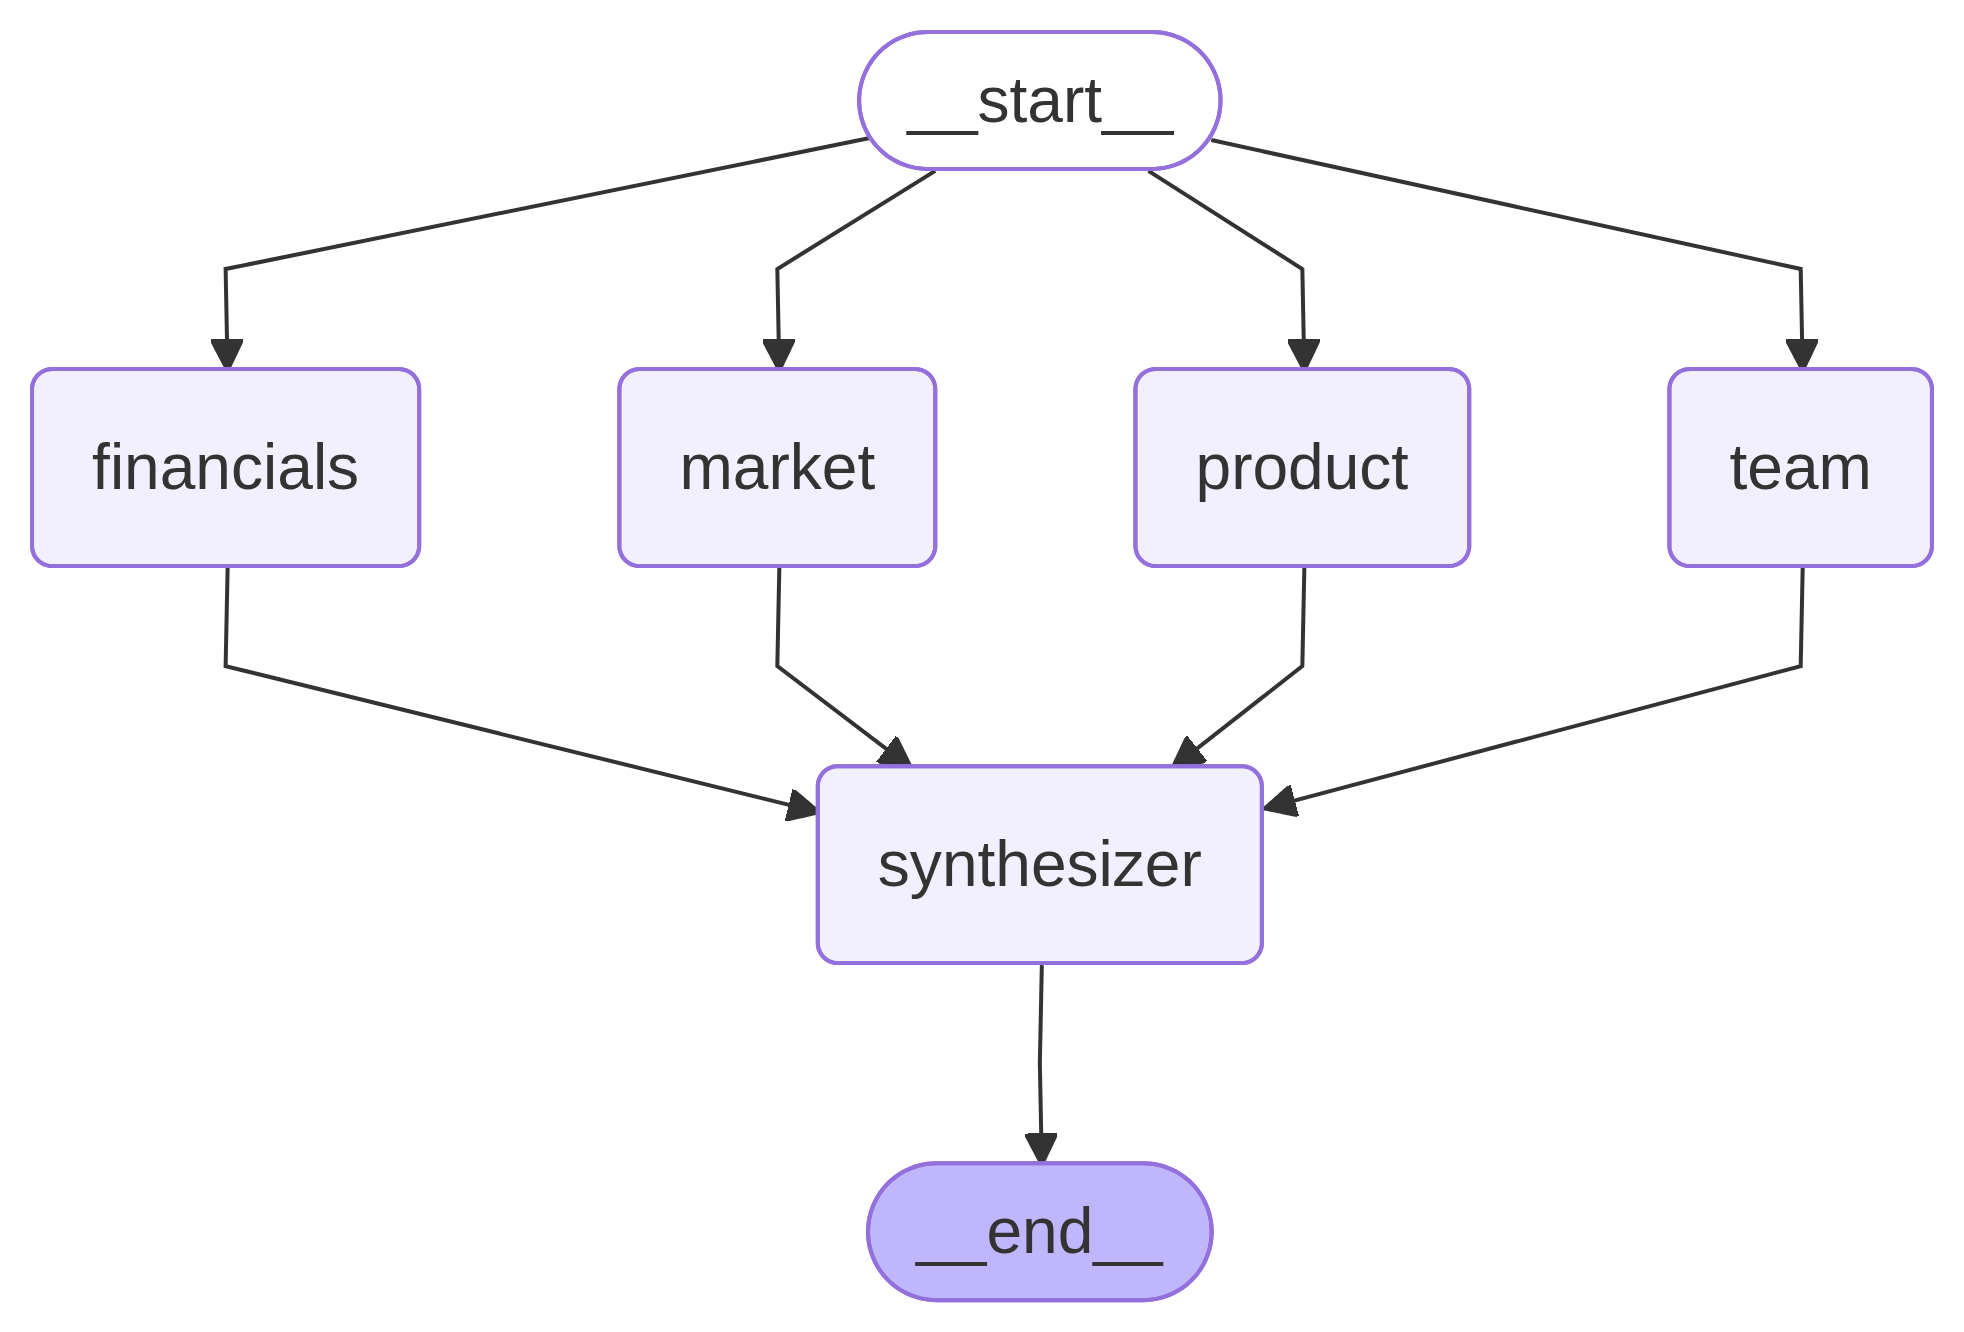
네 개의 리서치 노드가 병렬로 실행된 후, 도구 없이 합성기(synthesizer)가 메모를 조립합니다.
네 개의 리서치 노드(팀, 재무 상태, 제품, 시장)가 처음부터 병렬로 실행됩니다. 각 노드는 자체 도구와 검색 예산(search budget)을 가진 Perplexity Agent API 호출입니다. 재무 상태 노드는 구조화된 금융 데이터를 위해 finance_search를 추가하고; 나머지 노드들은 web_search를 사용합니다. 네 개가 모두 완료된 후, 단일 합성기 노드가 메모를 조립합니다. LangGraph에서 연결(wiring)은 간단합니다:
def build_graph():
g = StateGraph(MemoState)
g.add_node("team", team_node)
...
여기서 상태 관리(State management)가 중요합니다. 각 리서치 노드는 state["company"]만 읽고 다른 노드의 출력에 의존하지 않습니다. 이들의 쓰기 작업은 모두 하나의 research_output 키에 기록되지만, 전체 코드에서는 이 키가 리듀서(reducer)를 사용합니다. 이 리듀서는 충돌을 일으키는 대신 섹션 이름별로 네 개의 동시 쓰기 작업을 병합합니다. 이 리듀서가 없다면, 동일한 키에 대한 두 개의 병렬 쓰기는 LangGraph의 InvalidUpdateError를 발생시킬 것입니다 (패턴은 리듀서 참고 자료를 참조하세요). 각 노드를 하나의 도메인에 할당하는 것도 효과적입니다: 팀(team), 재무(financials), 제품(product), 시장(market) 각각이 자체적인 도구, 검색 예산, 프롬프트를 갖게 되어 노드의 컨텍스트가 자신이 담당하는 도메인에 집중할 수 있습니다.
도구를 사용하지 않는 합성기 (A tool-less synthesizer)
합성기는 도구가 없습니다. 네 개의 노드에서 나온 리서치 출력을 바탕으로 일곱 개의 메모 섹션을 모두 구성하므로, 인용된 모든 주장은 노드 중 하나가 실제로 수행한 리서치에 근거합니다. 섹션 1~6은 각각 ### Citations 목록으로 끝나며, 모든 소스 URL을 그것이 뒷받침하는 증거와 쌍으로 매칭합니다. 논지(Thesis)는 인용이 없는 유일한 분석 전용 섹션입니다.
모든 노드의 도구 호출과 출력은 LangSmith에 캡처되므로, 완성된 메모의 어떤 줄이라도 합성기를 거쳐 그것을 생성한 검색 결과까지 추적할 수 있습니다.
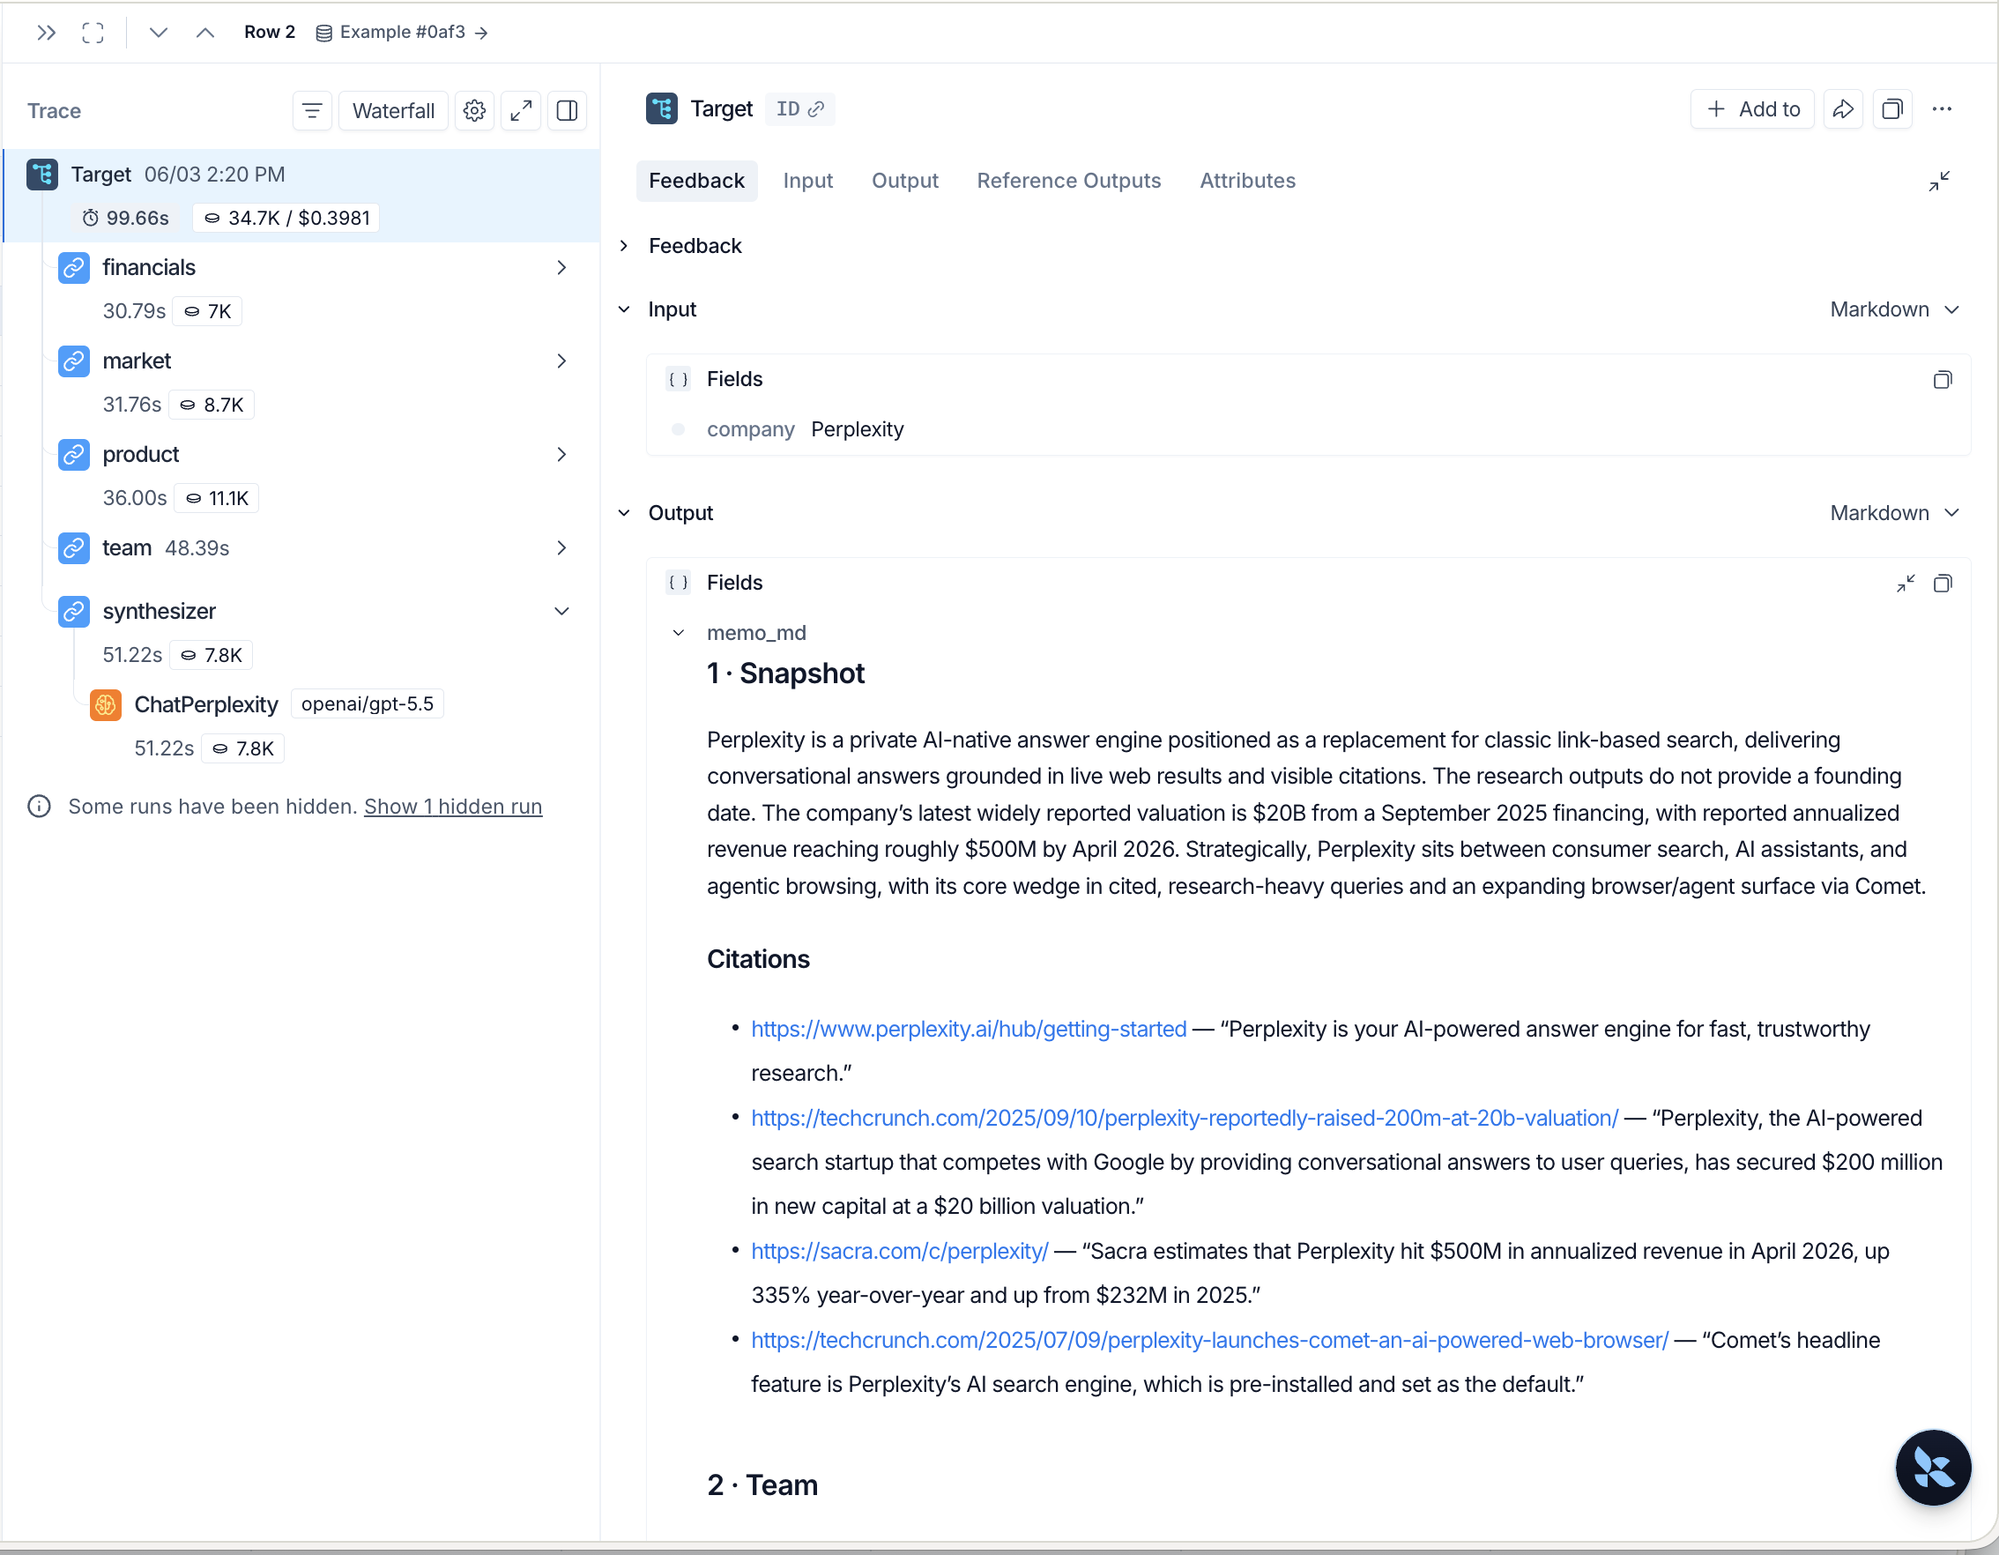
LangSmith에서 실행된 하나의 메모 (
추적 경로 탐색
). 모든 주장은 그것을 생성한 검색 결과로 역추적됩니다.
검색 제공업체 선택하기 (Choosing a search provider)
에이전트의 백엔드에는 어떤 검색 제공업체를 사용해야 할까요? 저희는 LangSmith에서 10개 회사에 대해 세 곳의 제공업체를 평가했으며, 기본 비용 및 지연 시간 외에도 주요 출처 비율(primary-source rate)과 재무 개념 커버리지에 대한 맞춤형 평가를 수행했습니다. 주요 출처 비율이란 메모의 인용 중 위키피디아나 Crunchbase 같은 집계 사이트가 아닌 IR 페이지, SEC 제출 서류 및 공식 보도 자료를 가리키는 비중을 의미합니다.
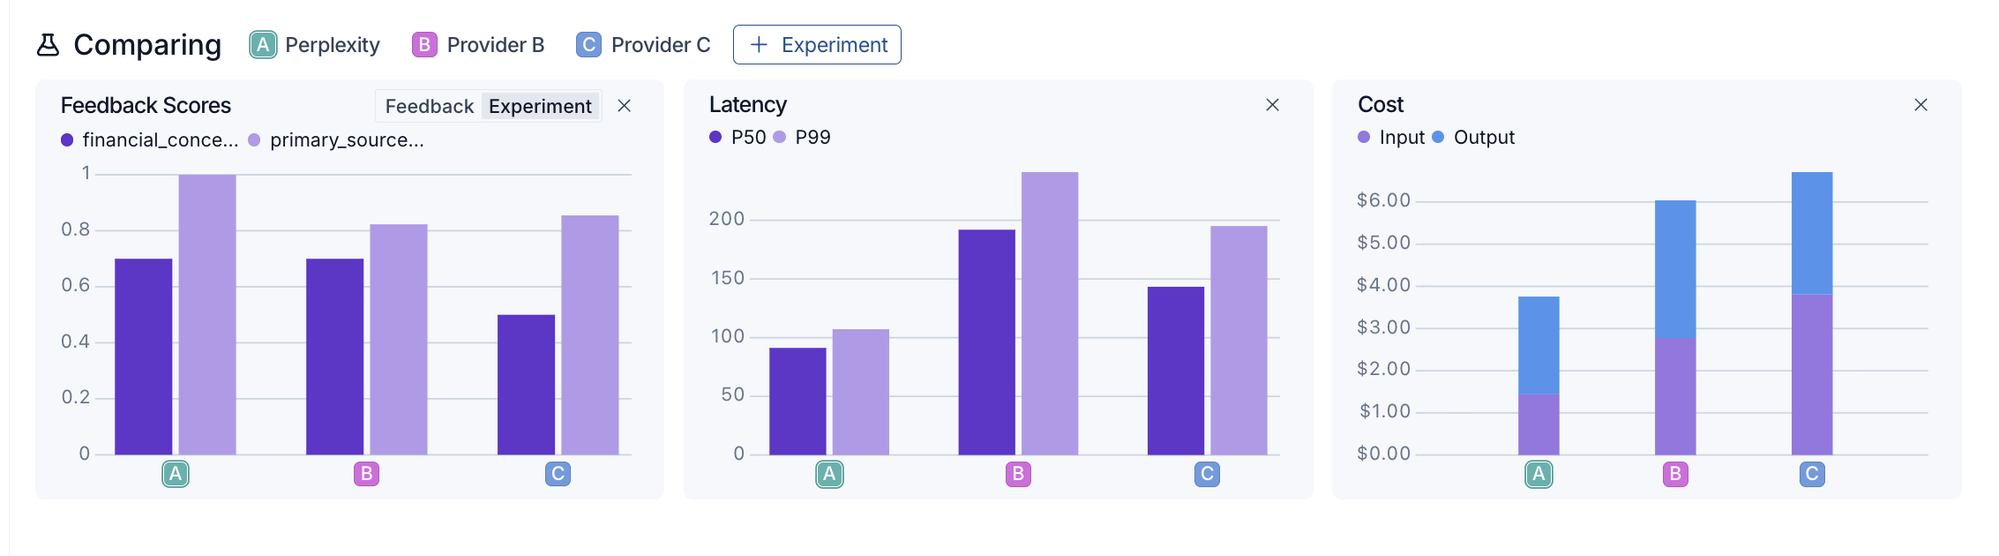
세 개의 제공업체, 동일한 그래프가 LangSmith에서 나란히 점수를 받았습니다.
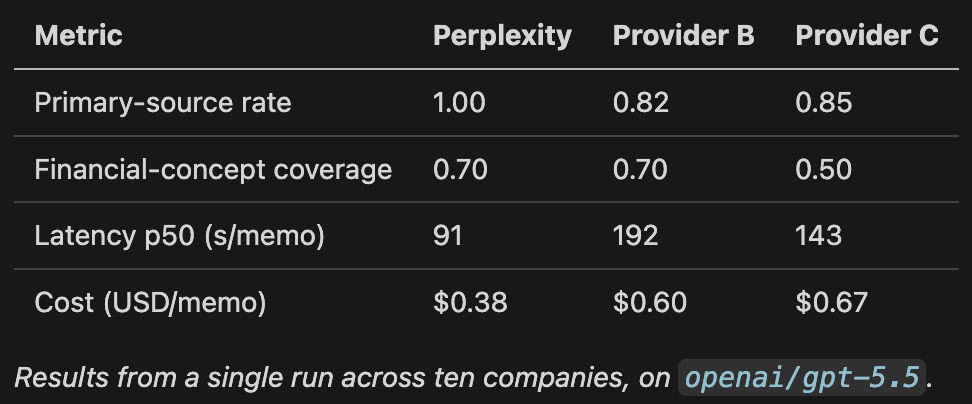
세 개의 제공업체 모두 동일한 그래프에서 점수를 받았습니다.
openai/gpt-5.5를 사용하여 10개 회사에 대한 단일 실행 결과
적절한 제공업체는 사용 사례에 따라 다릅니다. 비용, 지연 시간(latency), 그리고 주요 출처 비율(primary-source rate)과 같은 검색 정확도 측정 기준이 좋은 시작점이지만, 자체적인 측정 기준을 정의하고 점수를 매기려면 핸드북을 활용하세요.
결과물 (What it produces)
Anthropic에서 실행한 후 다듬어진 논지(Thesis) 섹션:
확정된 약 3,800억 달러의 사후 투자 가치(post-money valuation)로 볼 때, 이 회사는 이미 세대적인 플랫폼으로 가격이 책정되었지만, 이용 가능한 재무 증거는 감사된 매출(audited revenue)이라기보다는 실행률(run-rate)에 머물러 있습니다. 더 깊은 실사(diligence) 없이 이 가치로 선도적으로 투자해서는 안 됩니다. 권고: 추적 (TRACK)
섹션 목록과 PASS / TRACK / ADVANCE / LEAD 척도는 우리가 선택한 형식일 뿐이므로, 팀에서 사용하는 어떤 것이든 대체할 수 있습니다.
이는 완성된 메모가 아니라 시작 초안입니다. 문서화가 잘 된 회사에 가장 강력하고, 정보가 부족한 비상장 회사에는 약하며, 논지(Thesis)는 인용된 섹션이라기보다는 모델 자체의 분석입니다. 분석가는 여전히 의존하기 전에 이를 확인해야 합니다.
주요 시사점 (Takeaways)
LangGraph에 동시성 처리 맡기기. 노드를 병렬로 실행하고, 공유 상태(shared state)에 대한 리듀서(reducer)가 이들의 동시 쓰기 작업을 병합하도록 하여, 직접 쓰기 작업을 조정하지 않고도 병렬 속도 향상을 얻을 수 있습니다.
모든 주장을 검색된 증거에 근거하기. 작성 단계에서 이전 검색 단계가 찾은 것만을 끌어와야 할 때, 각 주장은 환각(hallucination)으로 만들어진 것이 아니라 실제 출처를 추적하게 되어, 결과 전체의 감사 가능성(auditable end to end)을 유지합니다.
제공업체 선택을 실험으로 만들기. 사용자 지정 LangSmith 평가 도구는
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기