
Paris: 분산 학습된 오픈 웨이트 확산 모델
요약
Paris는 분산 컴퓨팅을 통해 학습된 오픈 웨이트 확산 모델입니다. 이 모델은 8개의 독립적인 전문가 확산 모델로 구성되어 있으며, 노드 간 동기화 없이 완전한 격리 상태에서 학습되었습니다. 이를 통해 기존 방식 대비 데이터와 컴퓨팅 자원을 대폭 절감하면서도 우수한 생성 품질을 유지합니다.
핵심 포인트
- 분산 학습된 오픈 웨이트 확산 모델입니다.
- 8개의 독립적인 전문가 모델로 구성됩니다.
- 노드 간 동기화 없이 완전한 격리 상태에서 학습되었습니다.
- 데이터 및 컴퓨팅 자원 사용량을 획기적으로 줄였습니다.
전적으로 분산 컴퓨팅을 통해 학습된 세계 최초의 오픈 웨이트 확산 모델입니다. 이 모델은 8개의 전문가 확산 모델(각 129M~605M 파라미터)로 구성되어 있으며, 기울기(gradient), 파라미터(parameter), 또는 중간 활성화 값(intermediate activation) 동기화 없이 완전한 격리 상태에서 학습되었습니다. 이로써 기존 방식보다 우수한 병렬 처리 효율성을 달성하면서도 기준 모델 대비 14배 적은 데이터와 16배 적은 컴퓨팅 자원을 사용합니다. 더 자세한 내용은 arXiv의 논문을 읽어보세요.
주요 특징
- 8개의 독립적으로 학습된 전문가 확산 모델 (각 605M 파라미터, 총 4.84B)
- 학습 중 노드 간에 그래디언트 동기화(gradient synchronization), 파라미터 공유(parameter sharing), 또는 활성화 교환(activation exchange) 없음
- 동적 전문가 선택을 위한 경량 트랜스포머 라우터(~129M 파라미터)
- 120 A40 GPU-day에 걸쳐 LAION-Aesthetic 이미지 11M 사용
- 이전 분산형 기준선 대비 학습 데이터 14배 적음
- 이전 분산형 기준선 대비 컴퓨팅 자원 16배 적음
- 경쟁력 있는 생성 품질 (DiTExpert XL/2에서 FID 12.45)
- MIT 라이선스 하에 연구 및 상업적 사용을 위한 오픈 웨이트 제공
예시(Examples)
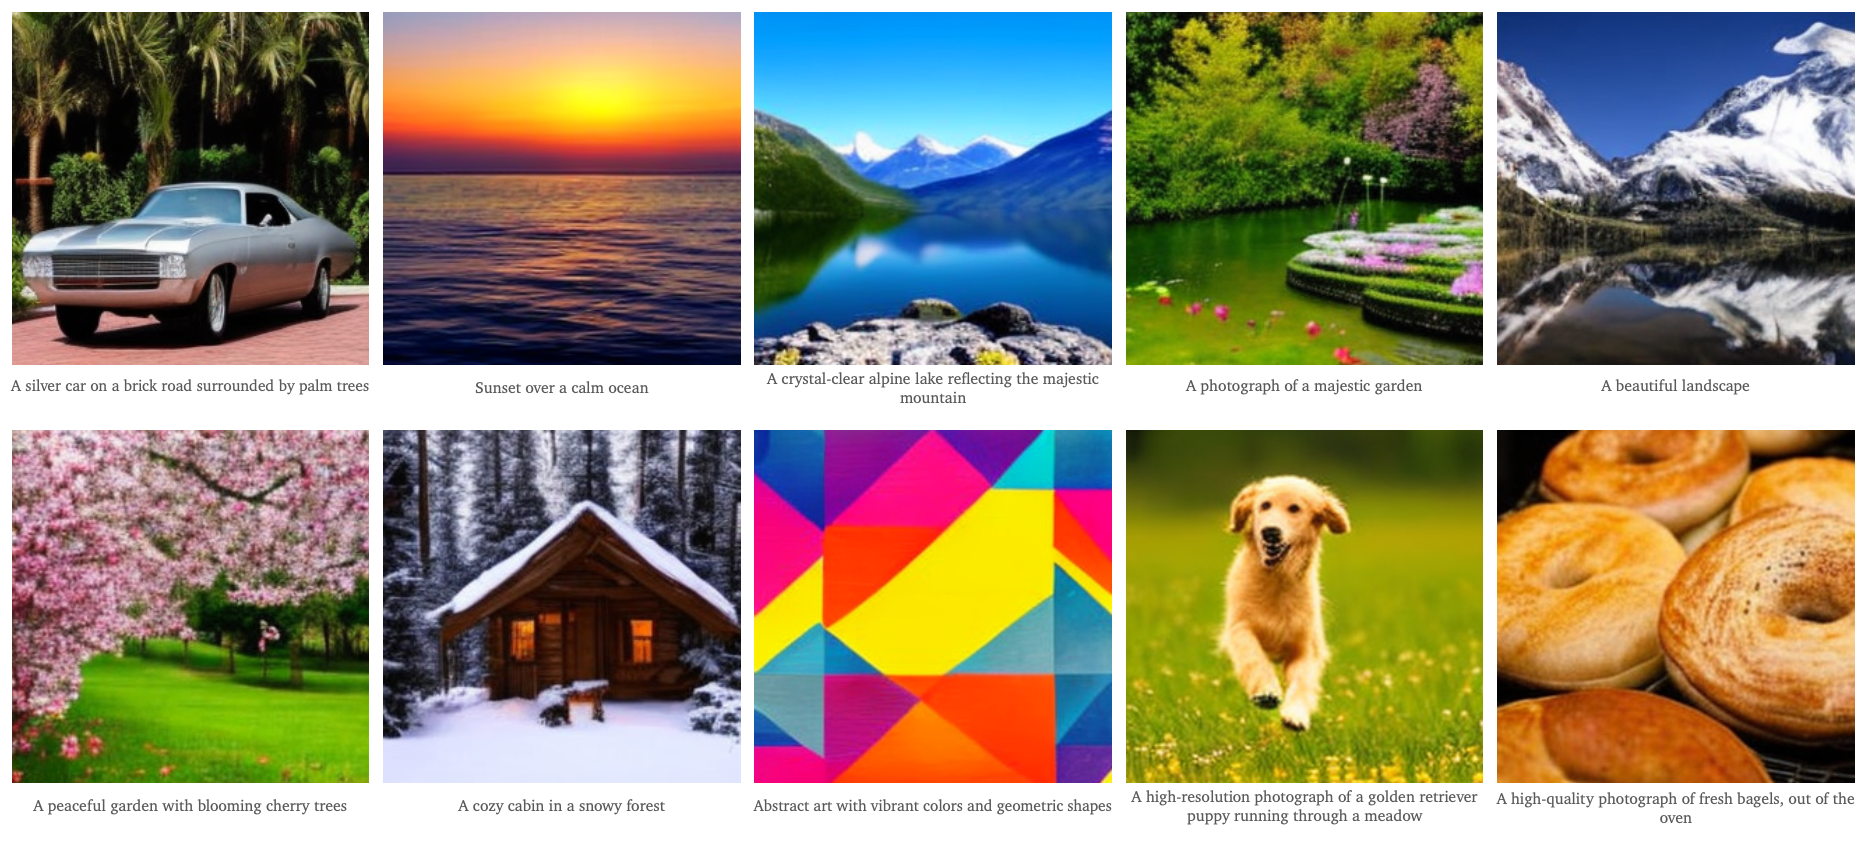
다양한 프롬프트와 시각적 스타일을 사용하여 Paris로 텍스트 기반 이미지 생성 샘플
아키텍처 상세 정보(Architecture Details)
| 구성 요소 | 사양 |
|---|---|
| 모델 규모 | DiT-XL/2 |
| ... |
학습 접근 방식(Training Approach)
Paris는 다음을 수행하는 완전 분산형 학습 방식을 구현합니다:
- 각 전문가가 의미론적으로 일관된 데이터 파티션(DINOv2 기반 클러스터링)에서 독립적으로 학습
- 학습 중 전문가 간에 그래디언트 동기화, 파라미터 공유 또는 활성화 교환 없음
- 전문가들은 AWS, GCP, 로컬 클러스터 및 Runpod 인스턴스 등 다양한 환경에서 서로 다른 속도로 비동기적으로 학습
- 라우터는 추론 중 전문가 선택을 위해 전체 데이터셋으로 사후(post-hoc) 훈련됨
- 완전한 컴퓨팅 독립성은 특수 인터커넥트(InfiniBand, NVLink)에 대한 요구 사항을 제거함
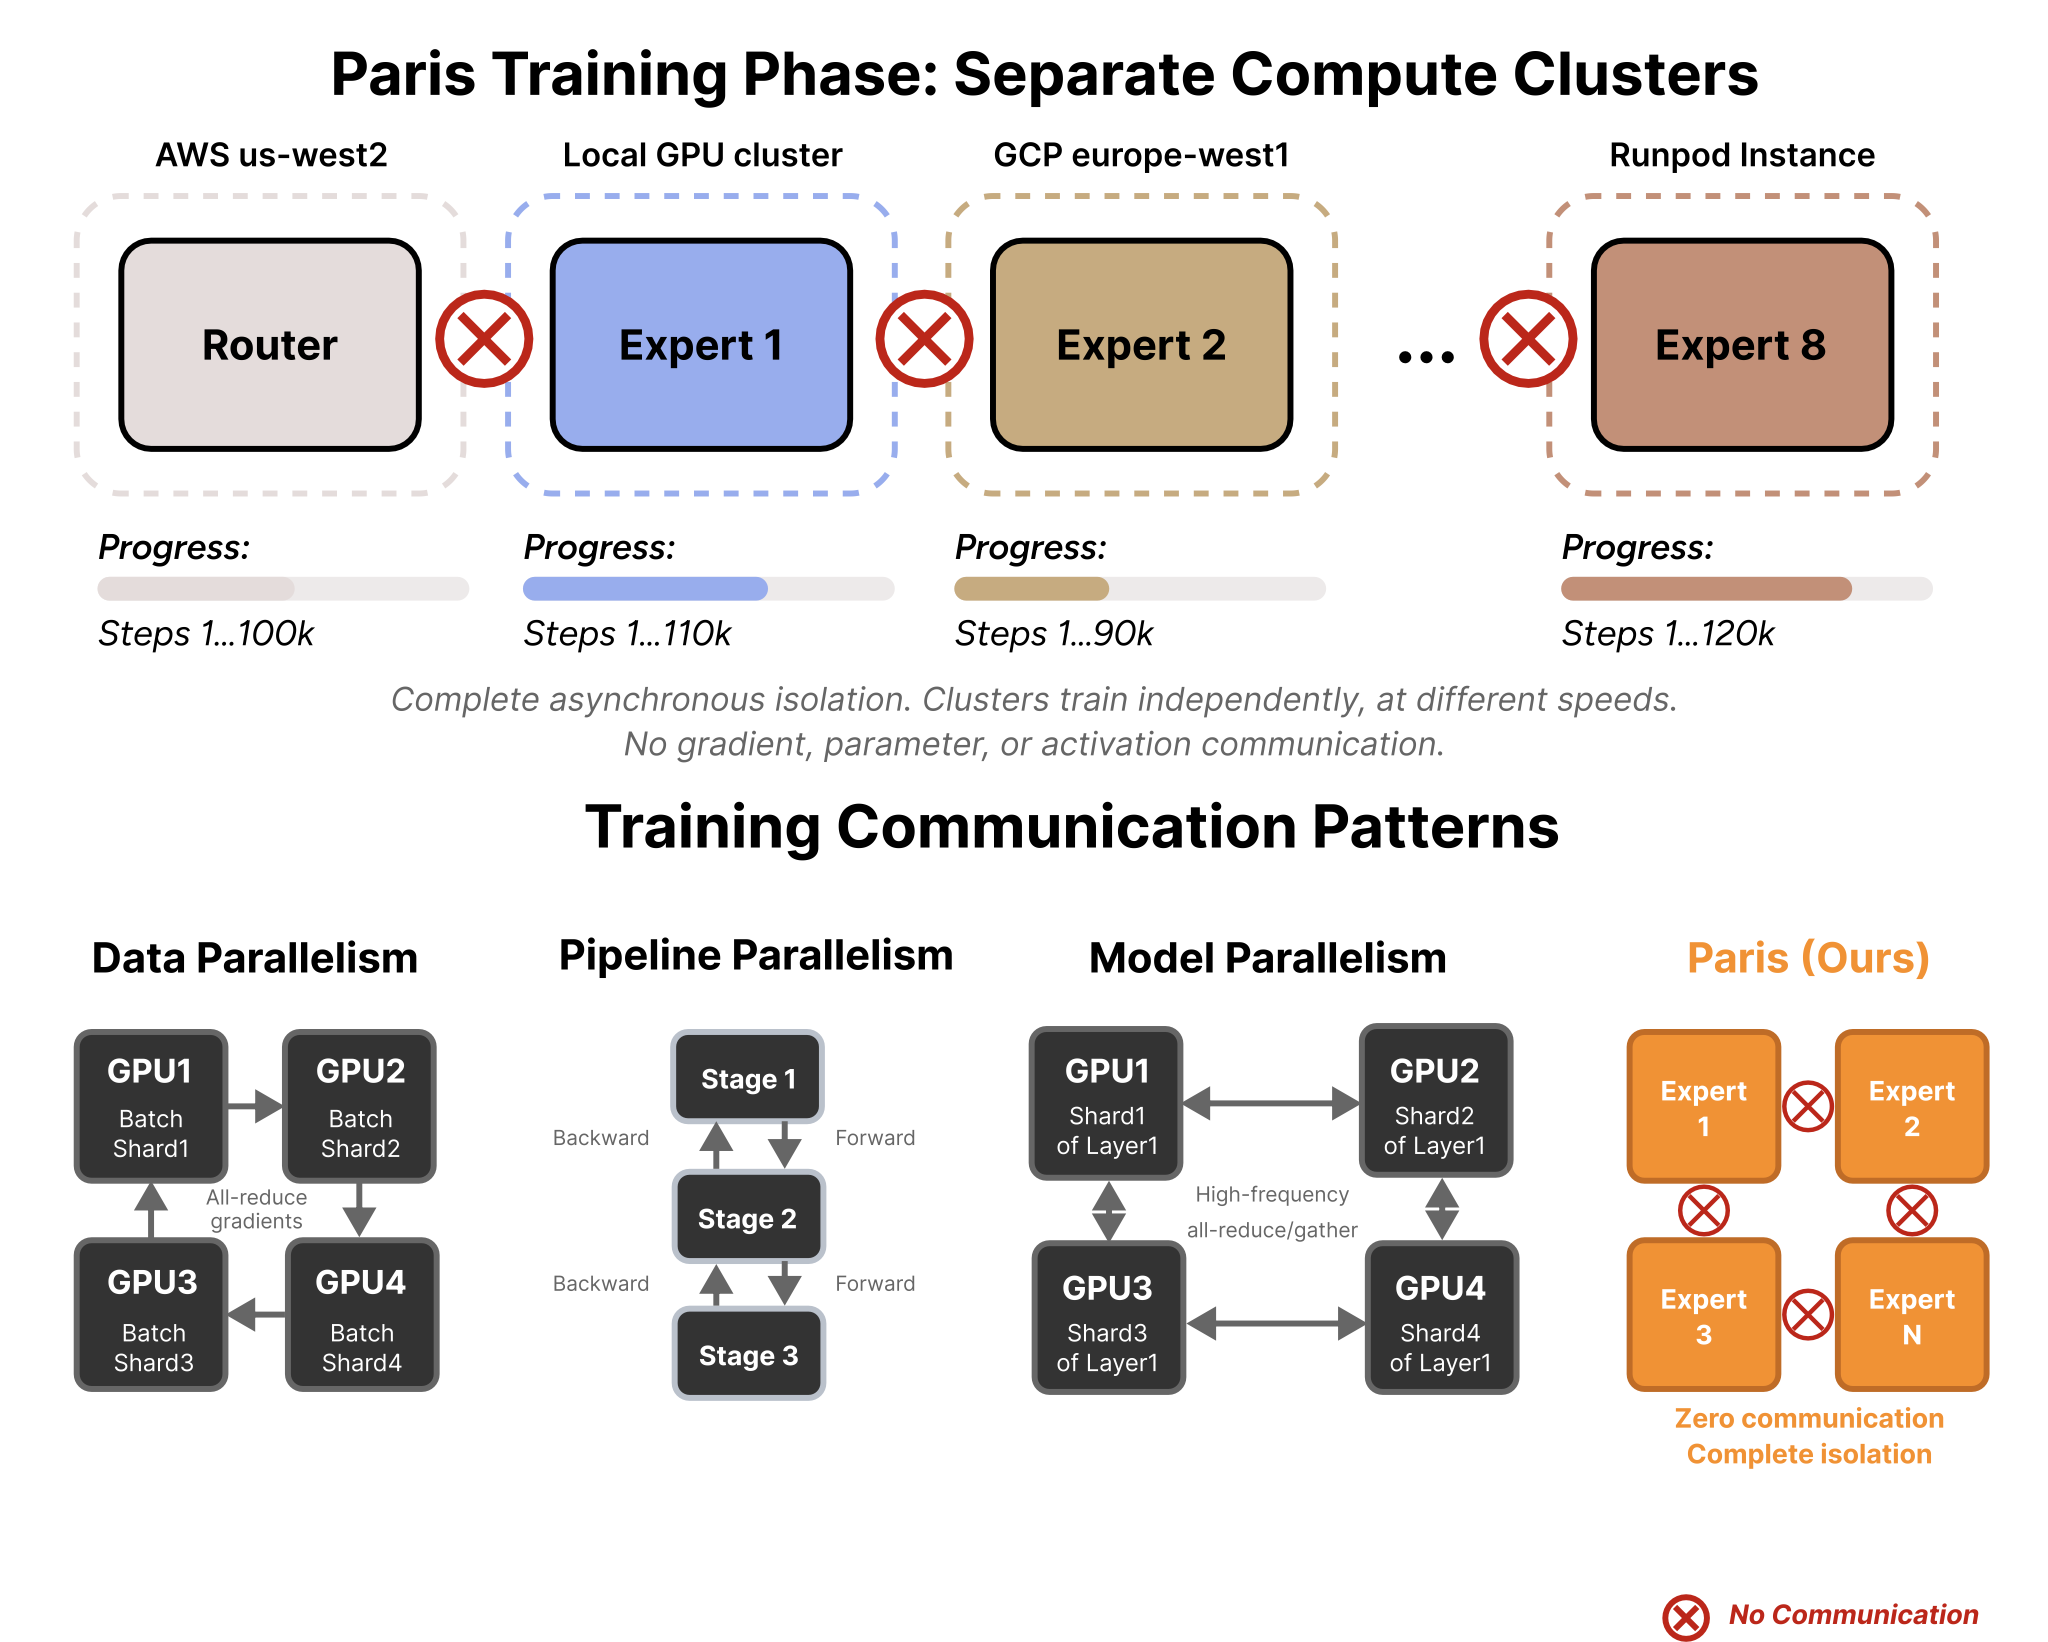
Paris 학습 단계는 이질적인 컴퓨팅 클러스터 전반의 완전 비동기 격리를 보여줍니다. 전통적인 병렬화 전략(데이터/파이프라인/모델 병렬화)과 달리, Paris는 학습 중 통신을 전혀 요구하지 않습니다.
이러한 무통신 접근 방식은 특수 인터커넥트 없이 파편화된 컴퓨팅 자원에서 학습할 수 있게 하여, 전통적인 확산 모델 학습의 전용 GPU 클러스터 필요성을 제거합니다.
전통적 병렬화와의 비교(Comparison with Traditional Parallelization)
| 전략 (Strategy) | 동기화 (Synchronization) | 지연 노드 영향 (Straggler Impact) | 토폴로지 요구 사항 (Topology Requirements) |
|---|---|---|---|
| 데이터 병렬 (Data Parallel) | 주기적 all-reduce | 가장 느린 워커가 반복을 차단함 | 지연 시간에 민감한 클러스터 |
| ... |
라우팅 전략 (Routing Strategies)
top-1(기본값): 단계별 단일 최적 전문가. 가장 빠른 추론 속도, 경쟁력 있는 품질.top-2: 상위 2개 전문가의 가중치 결합(Weighted ensemble). 종종 최고의 품질을 보이며, 추론 비용은 2배임.full-ensemble: 라우터에 의해 가중치가 부여된 모든 8개 전문가. 가장 높은 컴퓨팅 요구량 (8배 비용).
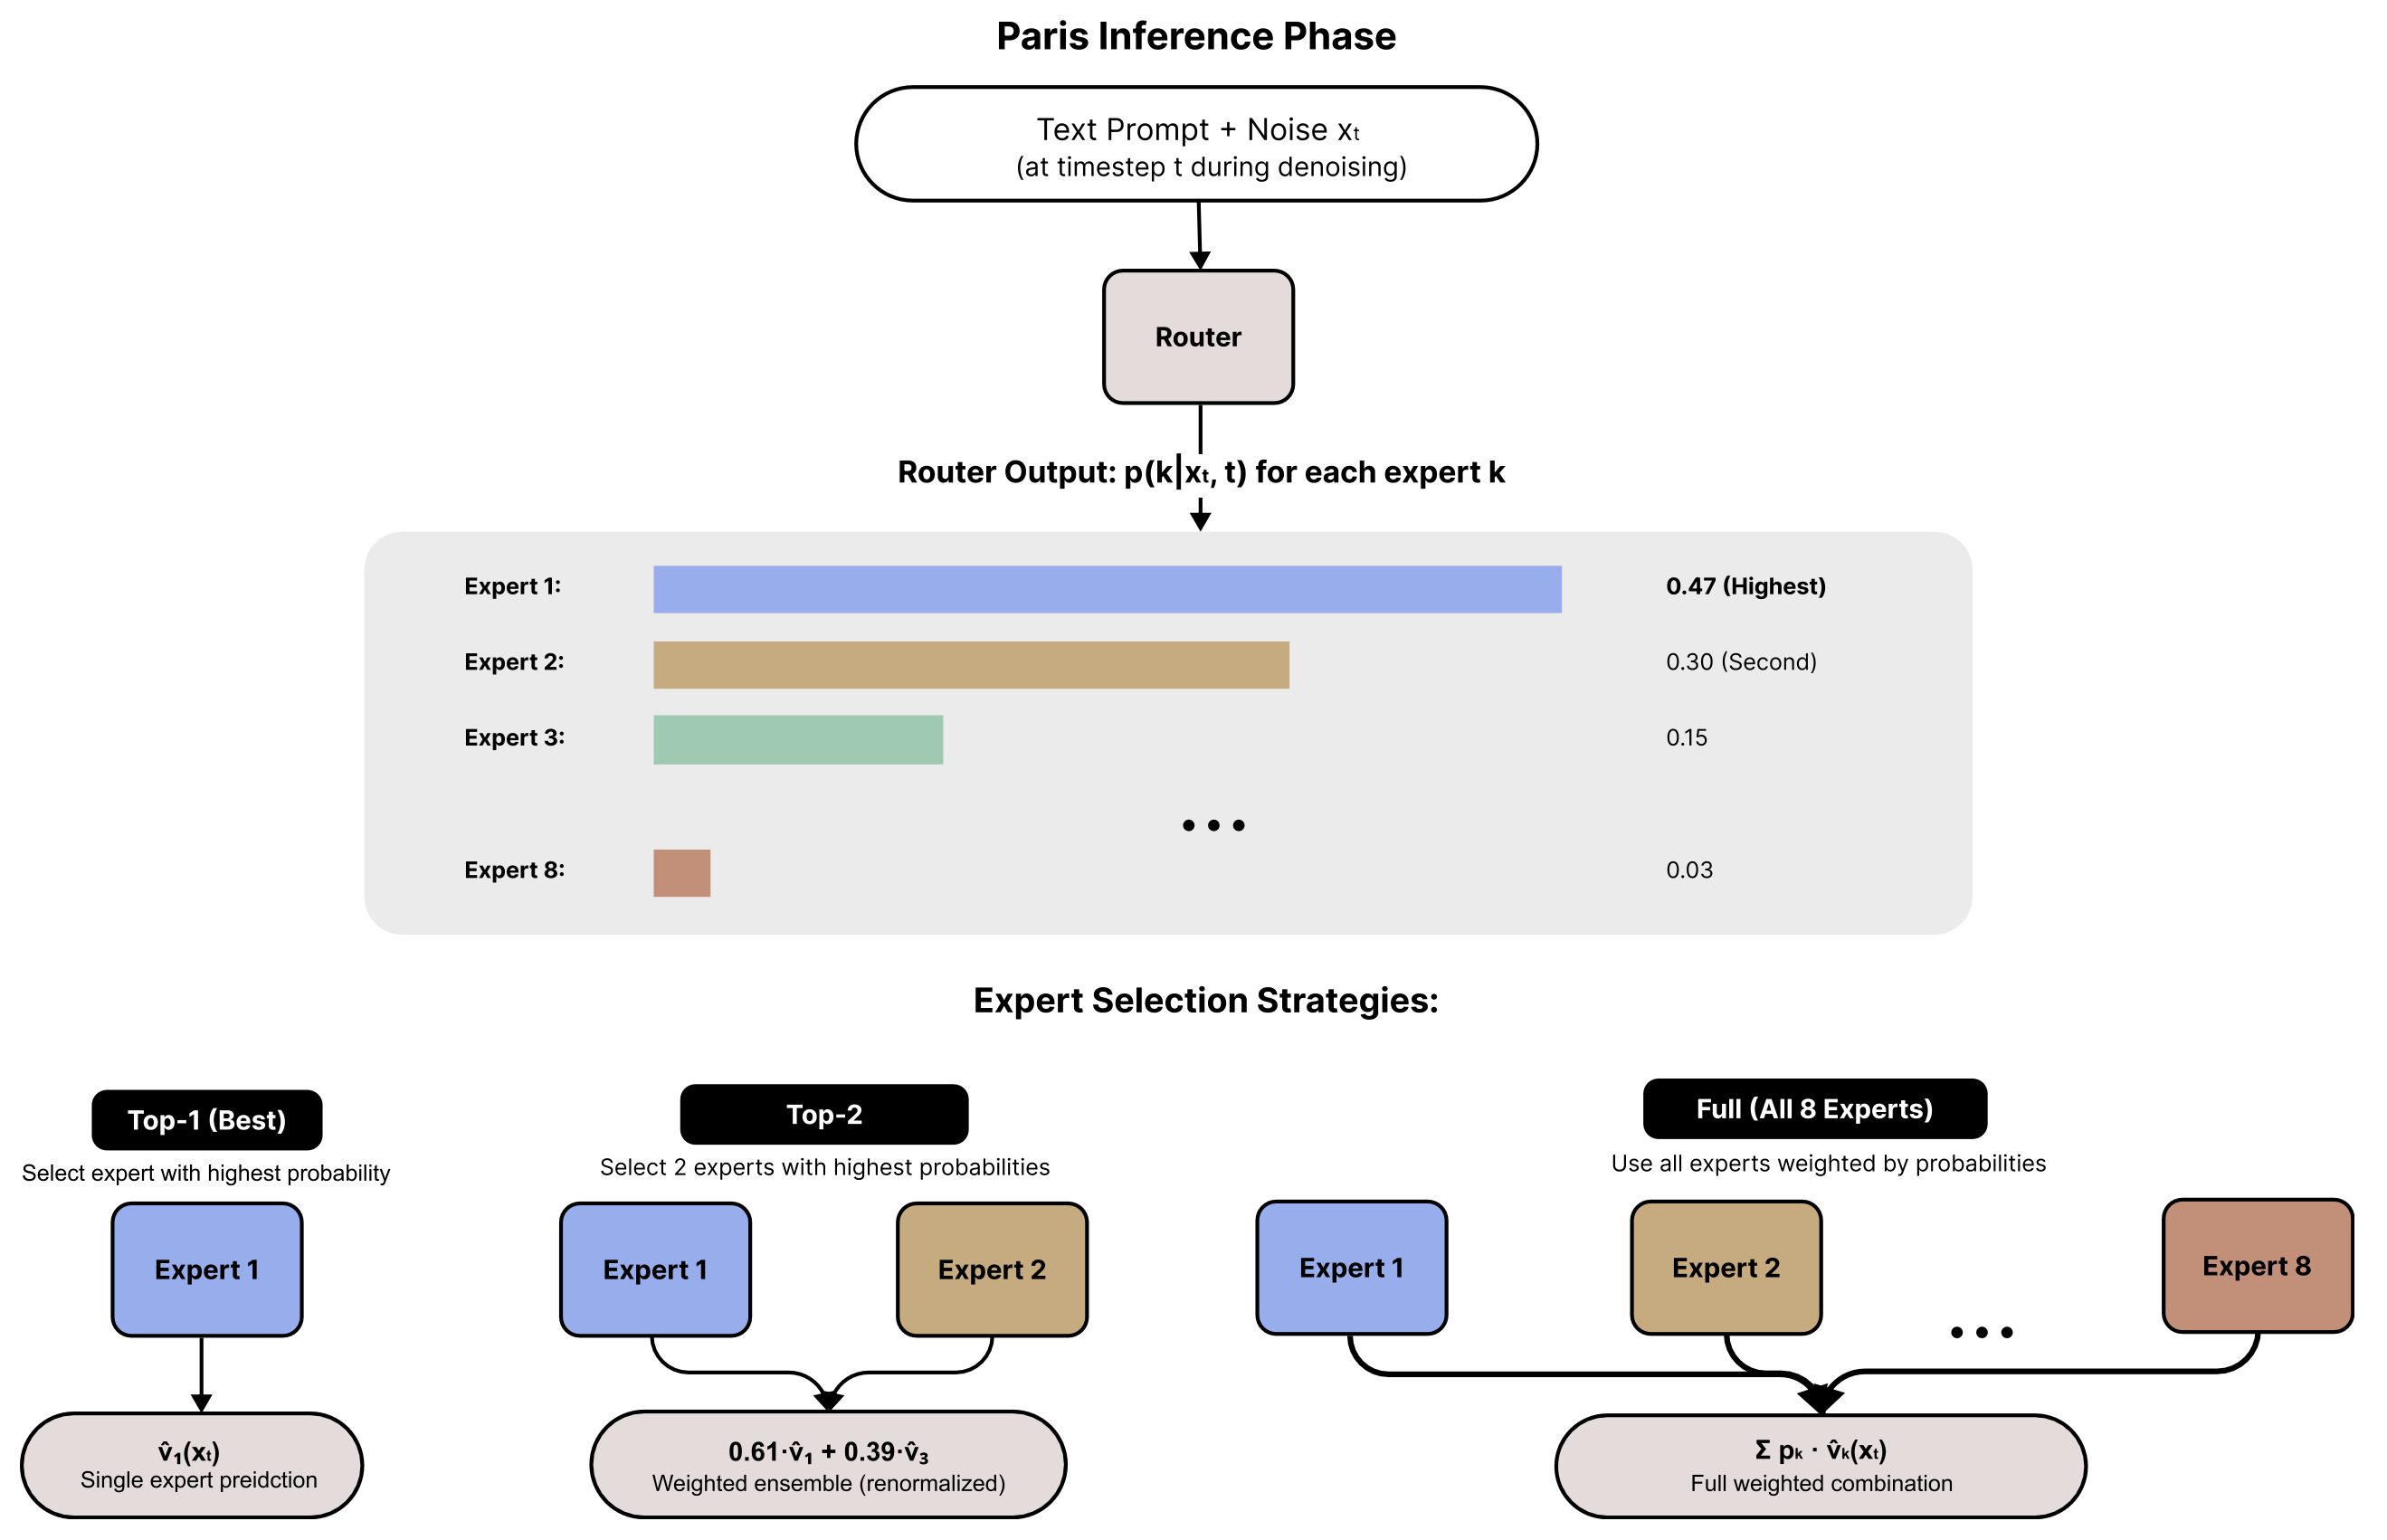
라우터를 기반으로 한 전문가 선택과 세 가지 다른 라우팅 전략(Top-1, Top-2, Full Ensemble)을 보여주는 다중 전문가 추론 파이프라인: Top-1 (가장 빠름), Top-2 (최고 품질), Full Ensemble (가장 높은 컴퓨팅).
성능 지표 (Performance Metrics)
LAION-Art (DiT-B/2)에서의 다중 전문가 대 단일 모델 비교
| 추론 전략 (Inference Strategy) | FID-50K ↓ |
|---|---|
| 단일 모델 (Monolithic, single model) | 29.64 |
| ... | |
| Top-2 라우팅은 단일 모델 기준선 대비 7.04 FID 개선을 달성하여, 목표화된 전문가 협업이 단일 모델과 단순한 앙상블 평균보다 우수함을 입증함. |
학습 세부 정보 (Training Details)
하이퍼파라미터 (DiT-XL/2)
| 매개변수 (Parameter) | 값 (Value) |
|---|---|
| 데이터셋 (Dataset) | LAION-Aesthetic (11M images) |
| ... | |
| 라우터 학습 (Router Training) |
| 매개변수 (Parameter) | 값 (Value) |
|---|---|
| 아키텍처 (Architecture) | DiT-B (전문가보다 작음) |
| ... |
인용 (Citation)
연구에서 Paris를 사용하고, 저희의 arXiv 논문을 인용하고자 할 경우:
@misc{jiang2025paris,
  title={Paris: A Decentralized Trained Open-Weight Diffusion Model},
  author={Jiang, Zhiying and Seraj, Raihan and Villagra, Marcos and Roy, Bidhan},
...
라이선스 (License)
MIT License – 연구 및 상업적 사용에 개방됨.
❤️로 제작되었습니다 by <a href="https://twitter.com/bageldotcom" target="_blank"><img src="https://img.shields.io/badge/Bagel_Labs-1DA1F2?style=for-the-badge&logo=twitter&logoColor=white" alt="Twitter에서 Bagel Labs 팔로우하기" height="28"></a>
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub AI Research의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기