OSRS PvP 강화학습
본 프로젝트는 딥 강화학습(deep reinforcement learning) 중 특히 PPO와 셀프 플레이(self-play) 기법을 활용하여, Old School RuneScape (OSRS)의 '명예 없음(no honor)' PvP 전투를 마스터할 수 있는 AI 에이전트를 개발하는 것을 목표로 합니다 (Last Man Standing과 같은 상황).
프로젝트 구성 요소:
- ML 학습 시스템
- 게임 시뮬레이션
학습 시스템은 훈련 시 시뮬레이션을 실행하고 관리하며, 시뮬레이션은 독립적으로도 실행할 수 있습니다. 또한, 이 학습 시스템에는 훈련된 모델을 제공하는 API가 포함되어 있습니다.
참고: 실시간 게임에서 제3자 클라이언트 플러그인 형태로 모델을 평가하기 위한 세 번째 구성 요소가 개발되었으나, 실제 게임에 영향을 주지 않기 위해 공개적으로는 이용할 수 없습니다.
시연 (Showcase)
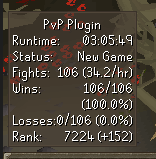
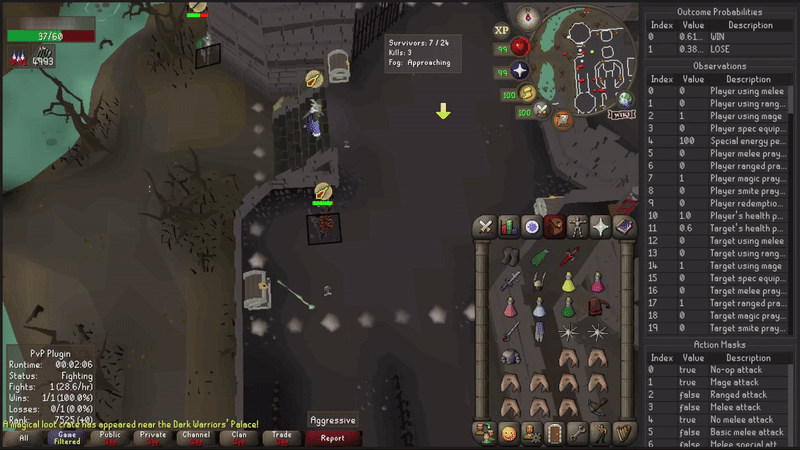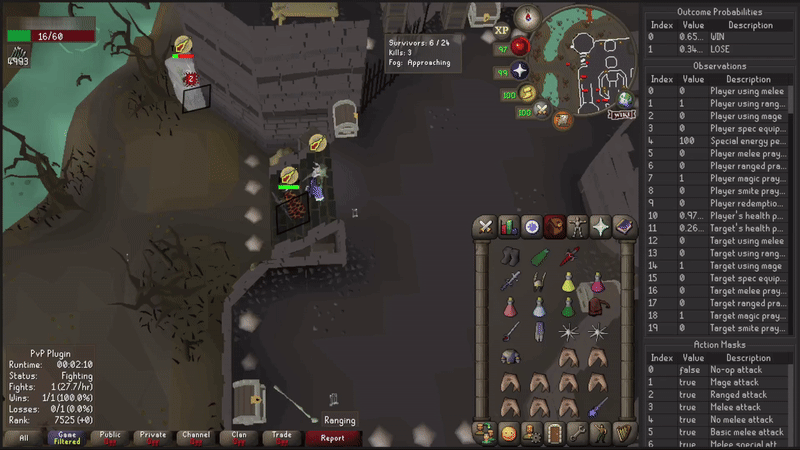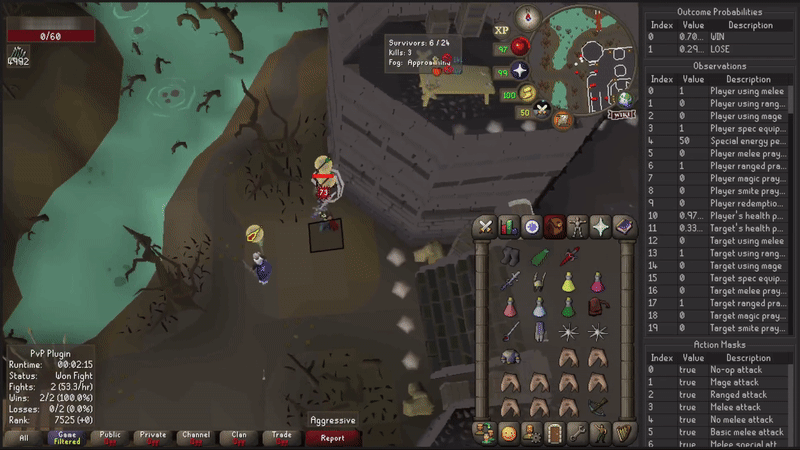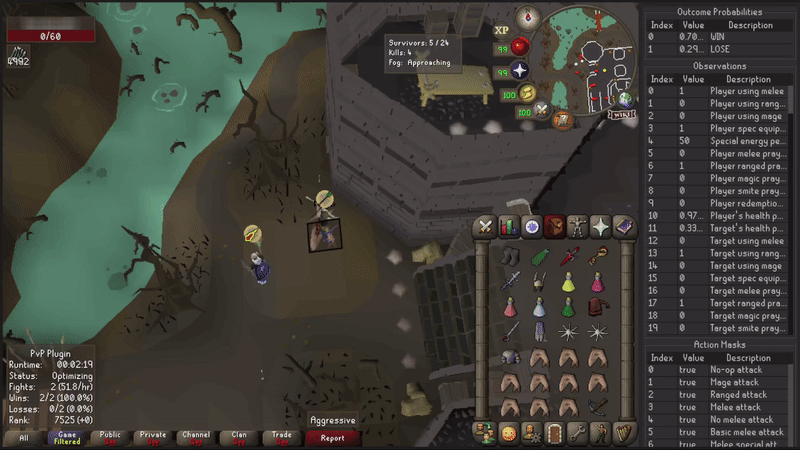
최신 버전의 모델은 매우 유망한 결과를 보여줍니다. FineTunedNh는 LMS에서 실전 게임에서 거의 완벽에 가까운 승률을 유지했으며, 주로 게임 자체의 내재적 무작위성 때문에 패배했습니다.
Youtube 영상
<img width=400 src="https://raw.githubusercontent.com/Naton1/osrs-pvp-reinforcement-learning/HEAD/assets/youtube-thumbnail.png">
평가 세션 통계:
LMS Session
평가 영상:
Fight Clip
<details>
<summary>추가 스크린샷 보기</summary>
-
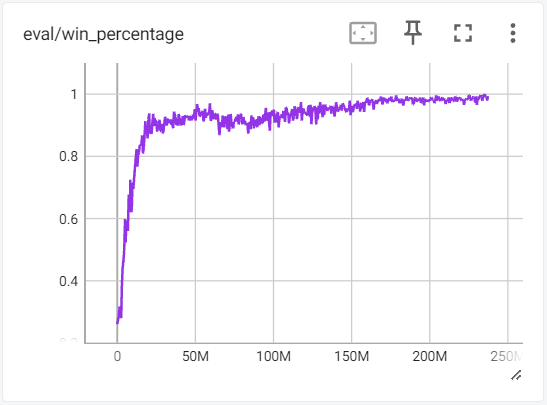
훈련 전반에 걸친 스크립트 기반 기준선 대비 승률
Eval Win Rate
-
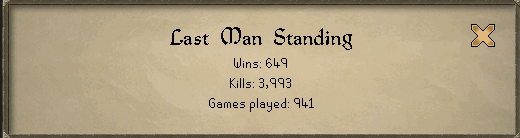
LMS!
(참고: 이 계정은 테스트/데이터 수집에도 사용되었으며, 최종 훈련된 모델은 약 99%의 승률을 가집니다.)
LMS Stats
-
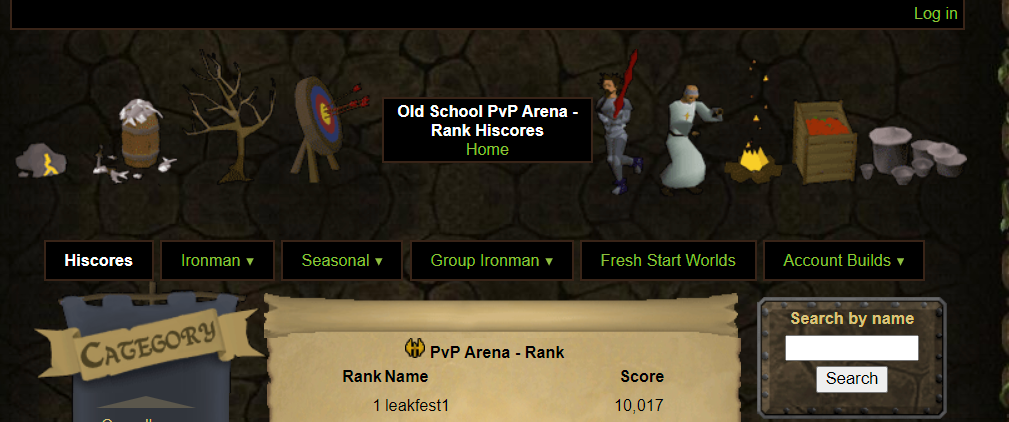
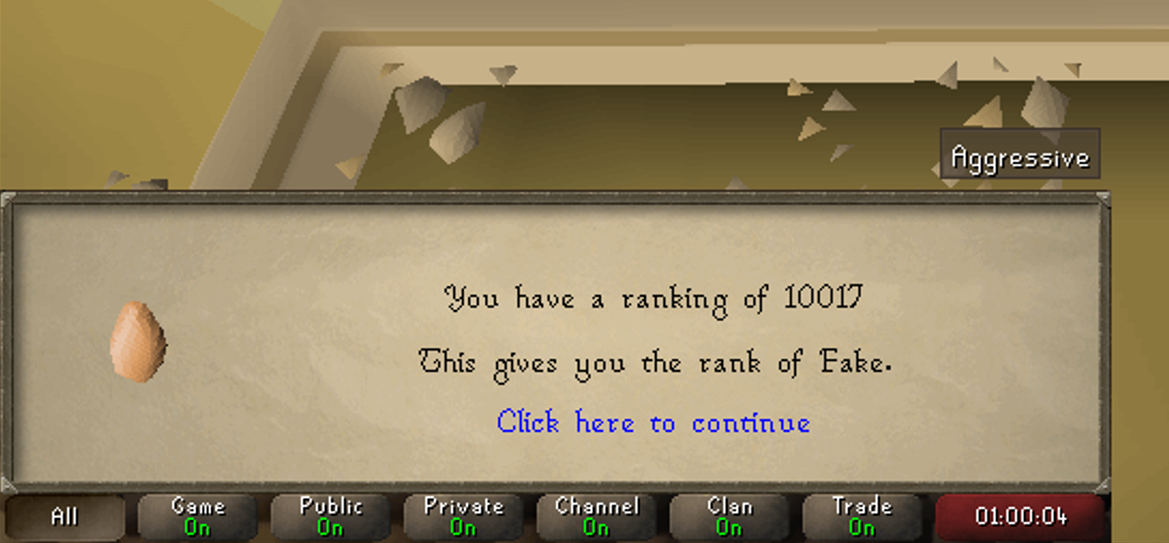
PvP 아레나 순위 10k+ 달성 및 #1 등극
#1 Highscores
-
인게임 PvP 아레나 순위 (게임에서 실제로 표시하는 내용)
10k+ Rank
</details>
사용 방법
- 저장소 클론:
git clone https://github.com/Naton1/osrs-pvp-reinforcement-learning.
- 두 하위 프로젝트 각각의 README를 따라 개별적으로 각 프로젝트를 설정합니다.
이 단계를 따르면 환경을 설정하고 자체 AI 에이전트 훈련을 시작할 수 있습니다. 또한 사전 학습된 모델을 API를 통해 제공할 수도 있습니다.
이 Python 기반 컴포넌트는 핵심 머신러닝 시스템을 포함합니다. 이는 훈련의 주요 인터페이스이며, 전체 훈련 워크플로우를 오케스트레이션하고 훈련 세션을 위해 시뮬레이션 RSPS에 연결하는 기능을 제공합니다. 이 시스템은 또한 실시간 예측을 위한 소켓 기반 API도 포함합니다.
Simulation RSPS 프로젝트는 시뮬레이션된 PvP 전투를 수행할 수 있는 플랫폼을 제공하여 에이전트의 훈련 효율성을 높입니다. 이는 기존 사설 서버인 Elvarg RSPS 위에 구축되었습니다.
환경 계약(Environment contracts)은 [contracts/environments]에 정의되어 있으며, 각 환경 내의 행동과 관찰을 설명하는 JSON 파일을 사용합니다. 이 계약들은 위에서 나열된 두 컴포넌트 모두에 의해 사용됩니다.
기존 환경 계약 (Existing Environment Contracts)
사용자 지정 모델 훈련 (Train Custom Model)
정의된 모든 환경에서 시뮬레이션을 통해 맞춤형 모델을 훈련할 수 있습니다. 새로운 환경에서 훈련하려면 하나를 추가할 수 있습니다(아래 참조).
실험 매개변수는 YAML 파일에 정의됩니다. 몇 가지 구성이 제공되는데, 이 구성들은 수정하여 새롭고 독특한 모델을 생성할 수 있습니다.
더 자세한 정보는 훈련 작업 시작하기를 참조하십시오.
새로운 환경 추가 (Add New Environment)
기존 환경 외에 새로운 환경을 정의할 수 있습니다. 이미 구현된 환경들을 참고 자료로 사용하십시오.
- [contracts/environments]에서 환경 계약(environment contract)을 구현합니다.
- 새로운 환경을 추가하는 방법은 simulation steps to add a new environment를 따릅니다.
env-name을 설정하여 새 환경을 사용하도록 훈련 구성(training configuration)을 생성하거나 업데이트합니다.
기존 모델 사용하기
API를 통해 기존 모델을 사용하려면:
- pvp-ml 프로젝트를 설정합니다.
- pvp-ml API를 실행합니다.
훈련된 모델 평가하기
시뮬레이션에서 훈련된 모델과 대결하려면:
- pvp-ml 프로젝트를 설정합니다.
- simulation-rsps 프로젝트를 설정하고 서버를 시작합니다.
- RSPS 클라이언트를 실행하고 서버에 연결합니다.
- 모델을 위해 에이전트 평가 세션(agent evaluation session)을 시작합니다.