핵심 요약
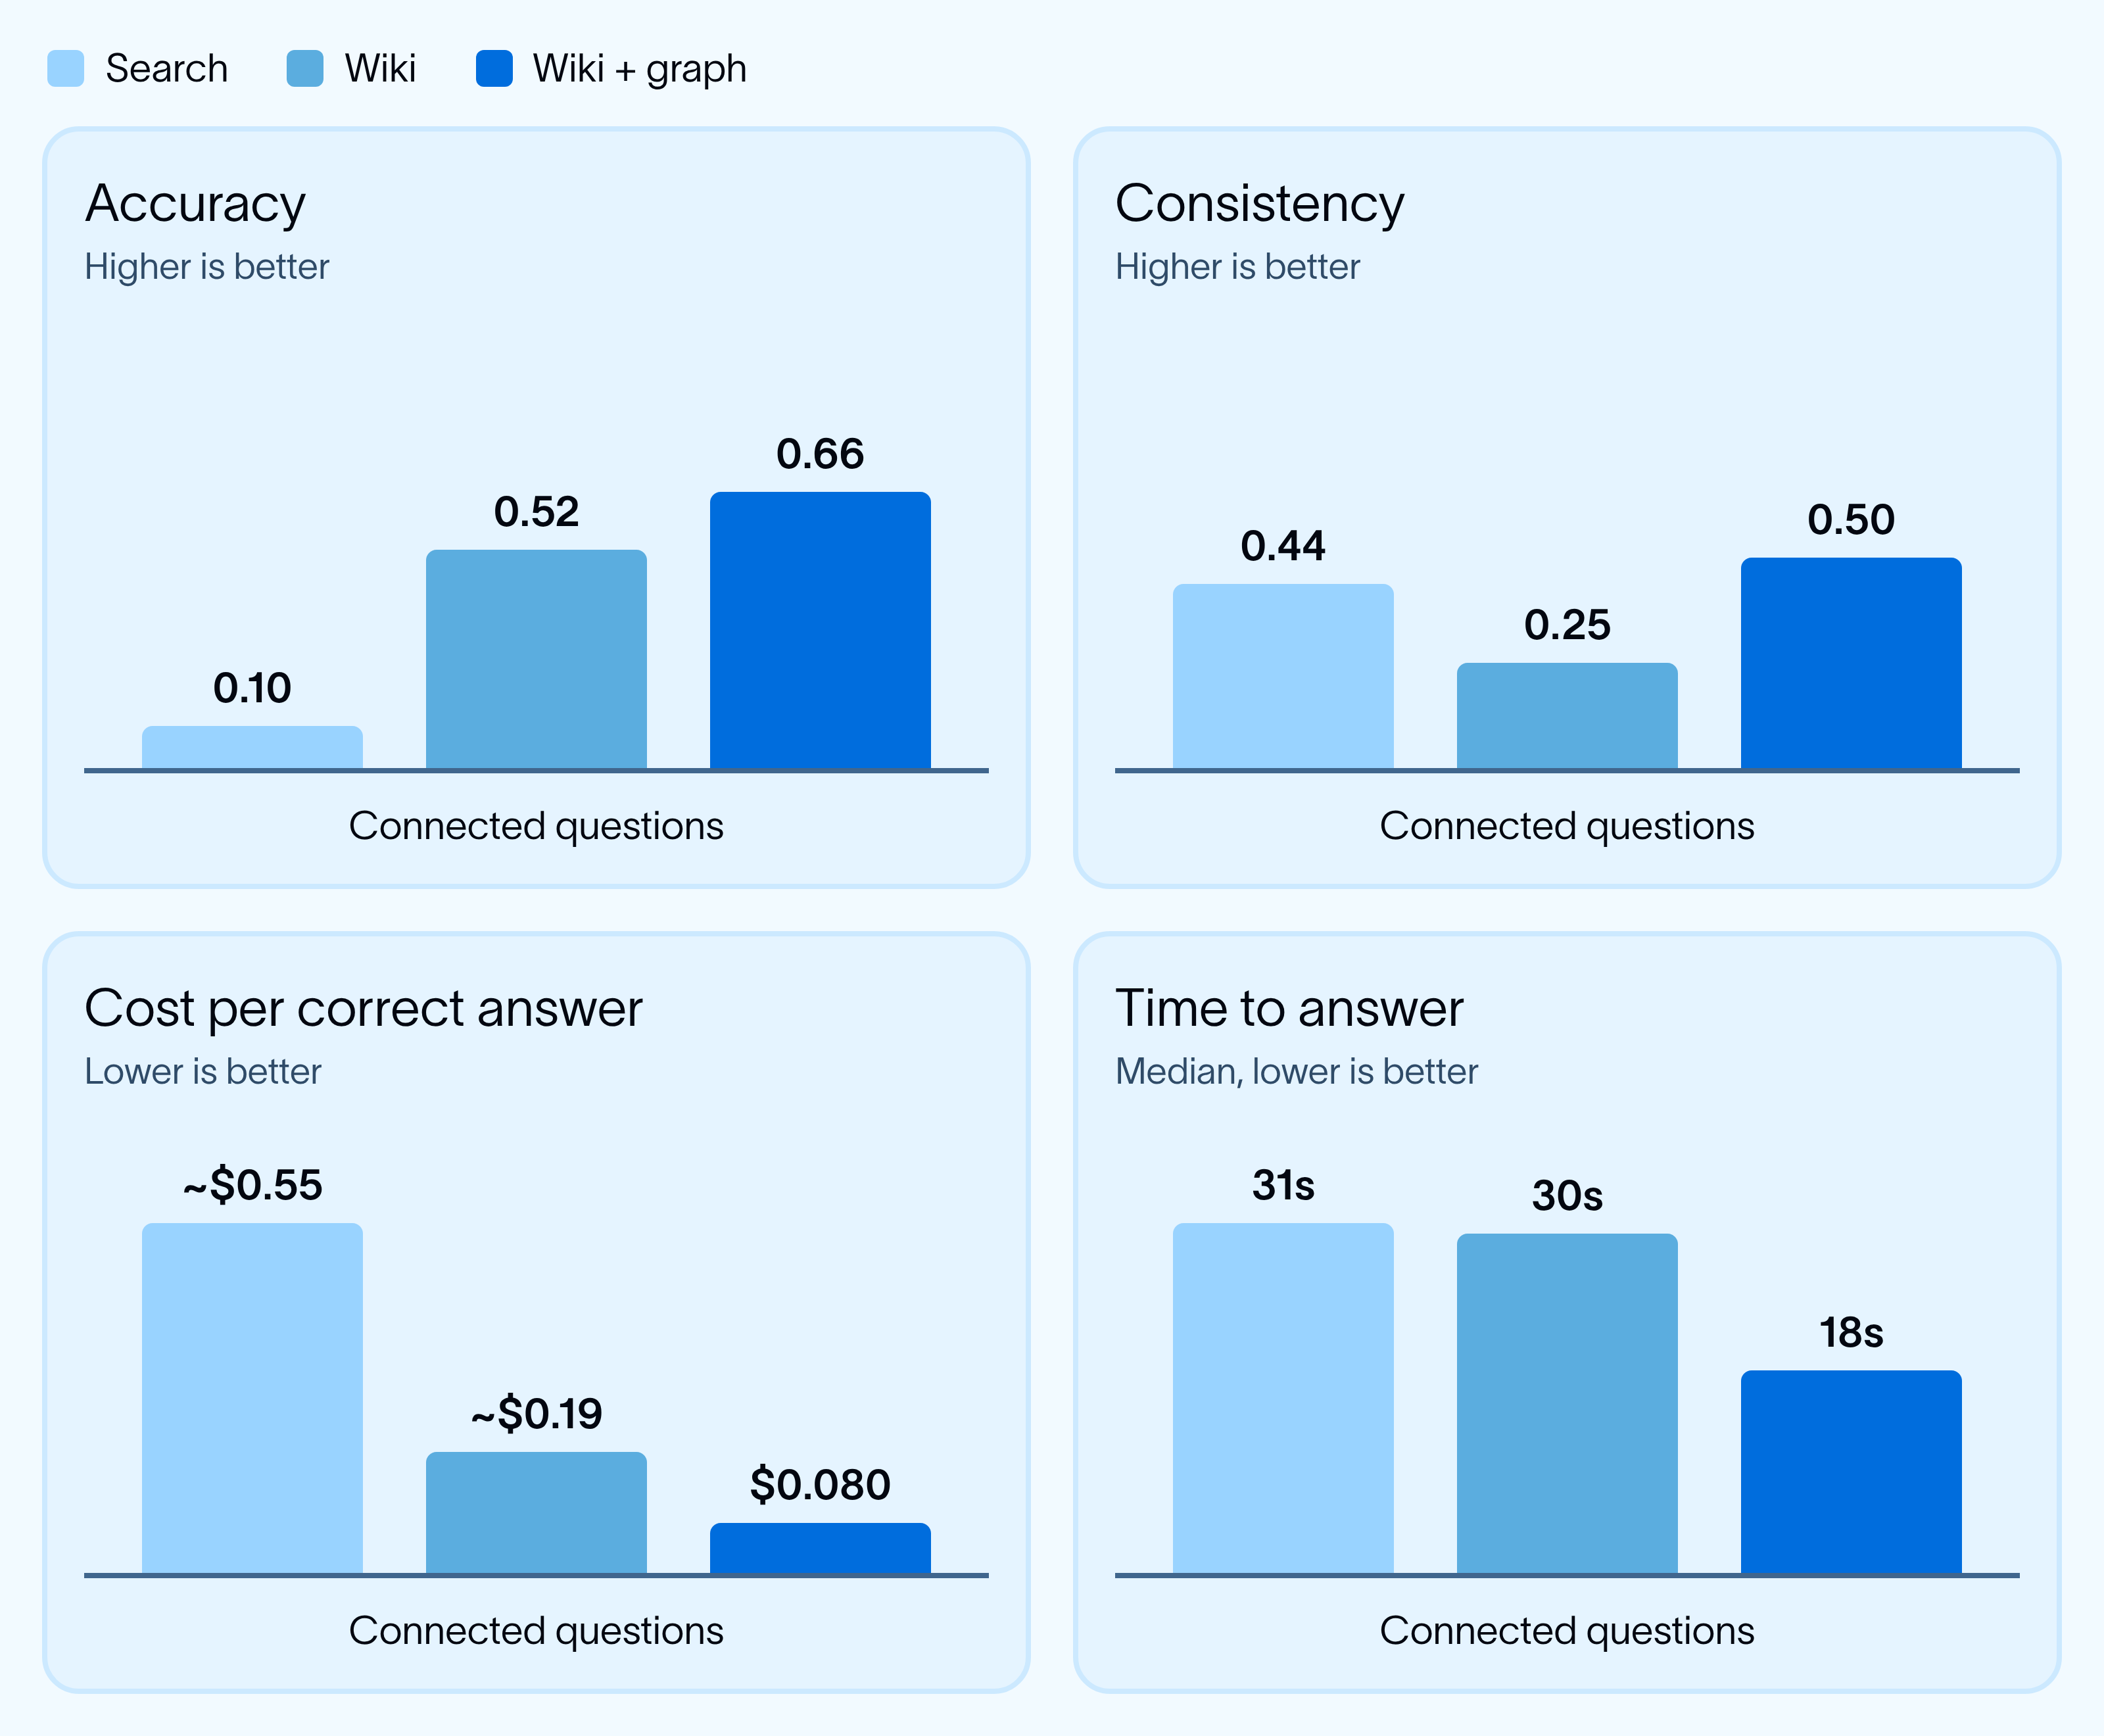
- 컴파일된 위키는 검색만으로는 에이전트가 재구성해야 하는 도메인 컨텍스트를 제공합니다. 여러 출처에 걸친 질문의 경우, OpenWiki를 메모리 계층으로 사용한 에이전트는 grep 도구만을 사용한 에이전트보다 5배 더 정확했습니다.
- 증거 그래프(evidence graph)를 추가하면 에이전트가 위키에서 근거 증거까지 추적할 수 있도록 도와줍니다. 우리는 인용과 문서 참조를 에이전트가 따라갈 수 있는 명시적인 그래프 엣지(edge)로 변환했습니다. 위키만 사용했을 때와 비교하여, 이는 에이전트가 동일한 증거를 일관되게 인용하는 방식을 두 배로 늘렸고, 정확도를 27% 향상시켰으며, 정답당 비용을 58% 절감했습니다.
- 반복적인 교차 출처 추론(cross-source reasoning)을 위해 컴파일된 메모리를 저장하세요. 위키는 도메인 지식과 복잡한 관계를 포착합니다. 여기에 증거 그래프를 추가하면 정확도와 검색 일관성이 향상됩니다. 다만, 단순 조회(simple lookups)의 경우, 메모리 없이 작동하는 에이전트가 동일하게 정확하고 더 빠릅니다.
조직의 정책, 매뉴얼, 위키, 티켓 및 코드 전반에 걸쳐 작업하는 에이전트는 시스템과 팀 전반에 흩어져 있는 지식을 탐색해야 합니다. 관련 구절을 찾는 것이 시작일 뿐입니다. 그들은 어떤 규칙이 적용되는지, 무엇이 변경되었는지, 그리고 한 출처가 다른 출처에 어떻게 영향을 미치는지도 판단해야 합니다.
영구적인 메모리 계층(persistent memory layer)은 에이전트가 작업을 거쳐 재사용할 수 있도록 지식과 관계를 보존합니다. 이것이 없다면, 에이전트는 종종 모든 질문마다 그 이해를 재구성해야 하므로 작업 비용이 많이 들고 오류가 발생하기 쉽습니다. 이는 정책과 가이드라인이 자주 수정되거나 대체되는 금융 및 보험 분야에서 특히 어렵습니다.
우리는 오픈 소스 위키 컴파일러인 OpenWiki를 이 메모리 계층으로 테스트했습니다. 출처 간 연결을 필요로 하는 질문의 경우, 위키는 검색만 했을 때보다 에이전트를 약 5배 더 정확하게 만들었습니다. 위키의 진술을 지원하는 구절에 연결하고 관련 출처를 링크하는 증거 그래프를 추가하자 정확도가 추가로 27% 향상되었고 인용 일관성이 두 배가 되었습니다.
컴파일된 위키는 왜 필요한가?
RAG 파이프라인은 종종 의미론적(semantic) 또는 하이브리드 검색(hybrid search)을 사용하여 고립된 청크를 검색하며, 에이전트가 이 청크들이 어떻게 관련되는지 스스로 조합하도록 남겨둡니다. 저희는 에이전틱 RAG와 그래프 기반 메타데이터 필터링으로 검색 성능을 개선하는 방법을 탐구했지만, 관련 구절을 찾는 것은 전체 작업의 일부일 뿐입니다. 여러 출처에 걸친 질문(Cross-source questions)은 참조를 추적하고, 상충되는 규칙을 해결하며, 의존성을 이해해야 합니다. 메모리(Memory)는 이러한 이해를 보존하여 에이전트가 매번 질문할 때마다 이를 재구축할 필요가 없게 만듭니다.
컴파일된 위키(wiki)는 소스 자료를 핵심 개념과 그 관계를 설명하는 연결된 페이지로 합성함으로써 그러한 메모리 계층을 제공합니다. 이 위키는 소스가 변경됨에 따라 업데이트되어, 에이전트가 재사용할 수 있는 맥락을 제공합니다.
저희의 오픈소스 CLI인 OpenWiki는 Deep Agents를 기반으로 이러한 위키를 생성하며, 출처로 돌아가는 인용(citation)을 포함합니다. 저희는 원래 코딩 에이전트가 모든 작업에서 아키텍처와 코드 동작 방식을 재발견할 필요가 없도록 하기 위해 이를 구축했습니다.
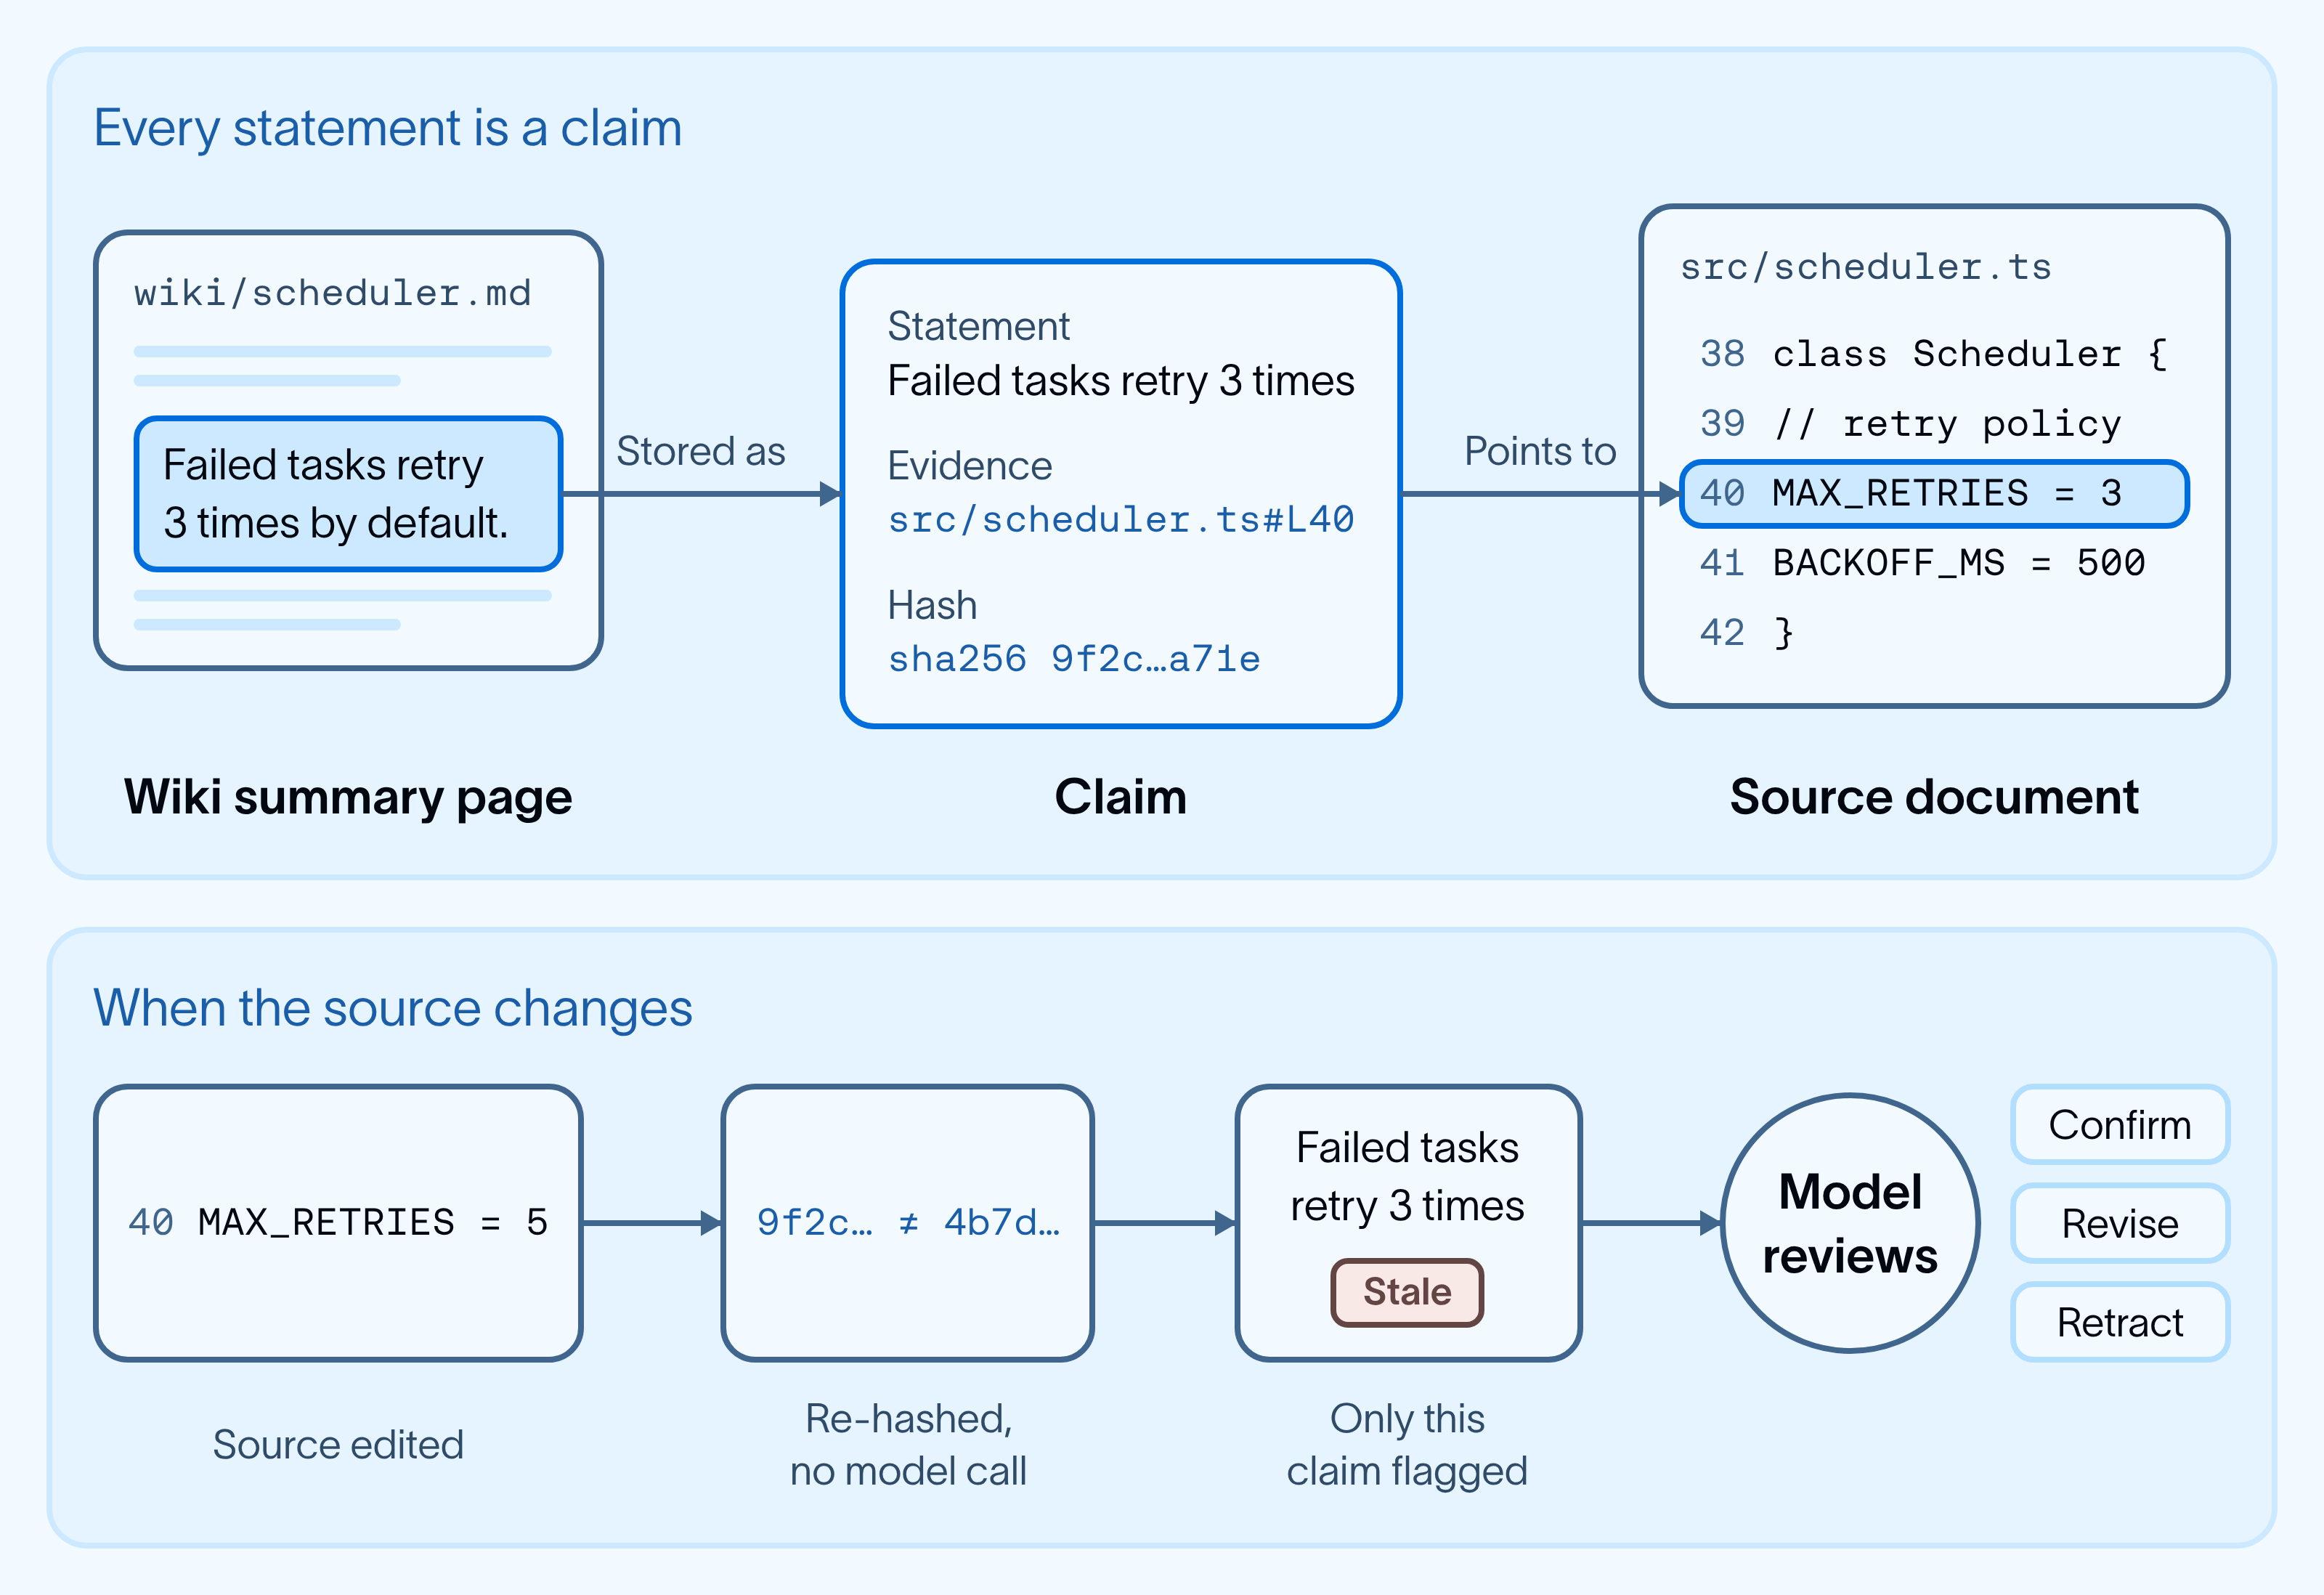
OpenWiki의 모든 진술은 클레임(claim), 즉 지원하는 출처 라인과 해당 해시(hash)에 연결된 단언(assertion) 위에 놓여 있습니다. 이 라인들이 변경되면 해시가 바뀌고, OpenWiki는 모델 호출 없이 영향을 받는 클레임을 플래그 지정할 수 있어 토큰 비용을 절감하고 노후화 감지(staleness detection)를 더욱 결정론적으로 만듭니다. 오직 해당 클레임들만이 확인, 수정 또는 철회(retraction)를 위해 모델로 전달되어, 메모리 계층이 소스가 변경됨에 따라 자체적으로 교정될 수 있도록 합니다. 이에 대해서는 'OpenWiki에서 자체 교정 메모리 구축하기'에서 설명합니다.
테스트 문서 라이브러리 구축
저희는 111개의 장문(long-form) 보험 문서를 합성하여 라이브러리를 구축했습니다. 저희가 보험 분야를 선택한 이유는 정책과 보증서(endorsements)들이 서로 자주 **참조하고, 수정하며, 무효화(reference, amend, and override)**하기 때문입니다. 이는 검색을 어렵게 만드는 정확히 그러한 종류의 문서 간 의존성입니다.
벤치마크 점수를 매기기 위해, 우리는 **972개의 사실(fact)로 구성된 원장(ledger)**을 만들고 각 사실이 어디에 나타나야 하는지, 문서들이 서로 어떻게 참조하는지, 그리고 버전 간에 무엇이 변경되었는지를 통제했습니다. 주변의 서술 문구는 LLM으로 생성했으며, 필수 사실들이 포함되었는지 확인하기 위해 자동화된 검사를 실행했습니다.
마지막으로, 우리는 기업 라이브러리에서 에이전트가 직면하는 상황과 더 유사하게 만들기 위해, 오래된 버전, 모순, 간접 참조 사슬, 다양한 표현 방식, 그리고 매우 긴 문서를 혼합하여 코퍼스(corpus)를 의도적으로 복잡하게 만들었습니다.
실험 구성 방법
우리는 동일한 검색 에이전트를 두 가지 조건에서 평가했습니다: 검색(Search) (원본 문서를 대상으로 한 키워드 검색)과 위키(Wiki) (OpenWiki로 컴파일되고 출처가 연결된 위키에 접근할 수 있는 동일한 에이전트). 기본 모델, 지침, 문서, 질문은 일정하게 유지되었으며, 오직 에이전트의 컴파일된 메모리 접근 방식만 변경되었습니다.
우리는 80개의 간단한 조회 질문과 문서 전반에 걸쳐 의존성을 추적해야 하는 50개의 연결된 질문을 테스트했습니다 (예: 특정 조항에 무엇이 의존하는지 또는 그것이 변경될 때 어떤 영향을 받는지 식별). 우리는 실행 간 변동성(run-to-run variation)을 측정하기 위해 각 질문을 세 번 요청했습니다.
평가 지표('더 좋다'는 것의 의미):
정확도 (Accuracy, 0–1): 채점자가 답변과 증거를 972개 사실 원장의 체크리스트와 비교하여 확인했으며(필수 사실에 대한 보상 및 모순에 대한 페널티 부여),
일관성 (Consistency, 0–1): 세 번의 실행 전반에 걸쳐 인용된 증거의 중첩 정도(인용 세트의 평균 쌍별 Jaccard 유사도). 이는 에이전트가 답변을 정확하게 내리는지 여부가 아니라, 답변을 동일한 출처에 신뢰성 있게 근거하는지를 측정합니다.
비용 + 지연 시간 (Cost + latency): 모델 사용 비용(USD) 및 질문당 벽시계 시간(wall-clock time).
위키가 도움이 된 부분과 어려움을 겪은 부분
OpenWiki는 111개 문서 라이브러리를 약 1/10 크기의 위키로 컴파일했으며, 비용은 $4.15였습니다. 이후 17개의 문서를 추가하는 데는 개당 약 $0.09가 소요되었습니다. 아래 분석에서는 컴파일 및 업데이트 비용을 제외하고, 검색(retrieval) 및 답변(answering) 비용만을 보고합니다.
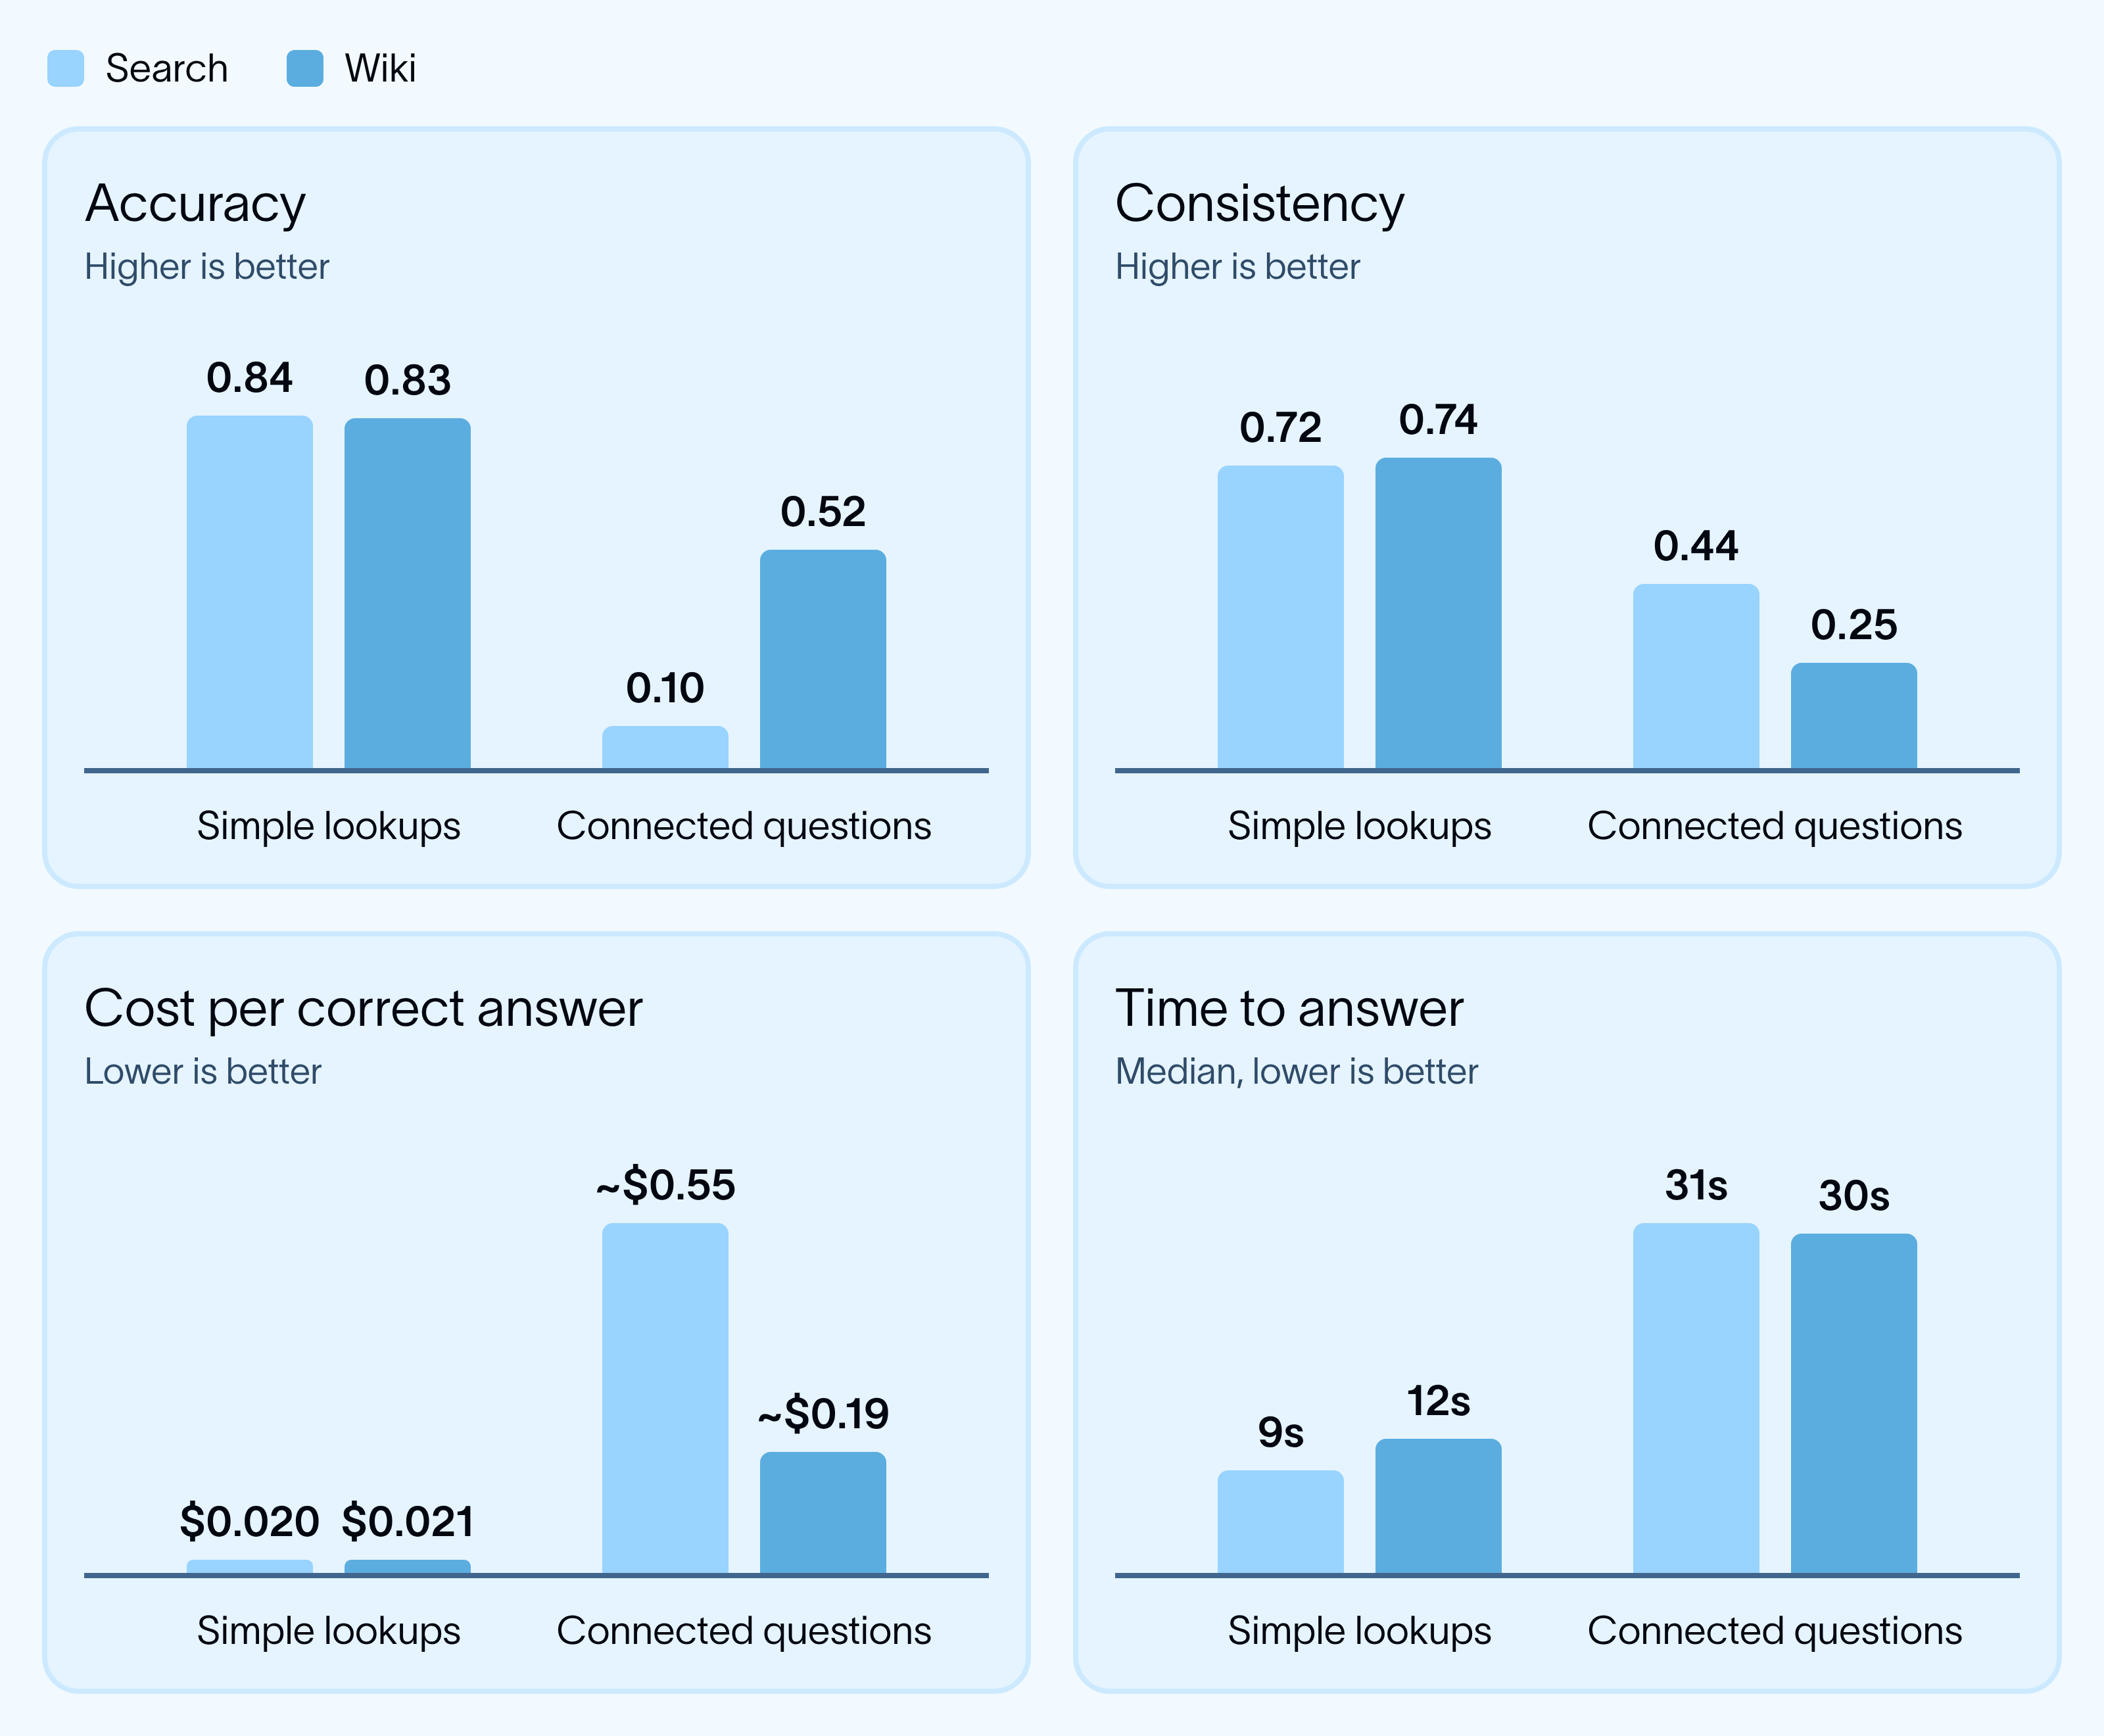
저희는 간단한 조회(simple lookups)를 대조군으로 사용했습니다. 이러한 단일 구절 질문은 문서 간의 복잡한 맥락적 지식(cross-document insurance context)을 거의 요구하지 않기 때문에, 위키가 큰 도움을 주지 않을 것으로 예상했습니다. 그 결과는 검색과 위키 모두에서 유사하게 나타났습니다 (정확도: 0.84 대 0.83; 인용 중복률: 0.72 대 0.74; 정답당 비용: $0.020 대 $0.021). 다만, 지연 시간(latency)은 9초에서 12초로 증가했습니다.
반면, 연결된 질문(connected questions)은 도메인별 관계를 사용하여 여러 출처에 걸쳐 추론하는 것이 필요했습니다. 이 경우, 위키는 검색만 사용했을 때의 정확도 0.10에서 0.52로 약 5배 향상시켰습니다. 컴파일된 맥락(compiled context)은 에이전트가 도메인 지식을 적용하고 적절한 관계를 더 적은 도구 호출(tool calls)로 찾아낼 수 있도록 도와, 정답당 비용을 약 $0.55에서 $0.19로 절감했습니다.
이러한 정확도 및 비용 향상에도 불구하고, 위키 에이전트의 증거 검색은 여전히 일관성이 부족했습니다. 인용 중복률(Citation overlap)은 간단한 조회에서는 0.74였으나 연결된 질문에서는 0.25로 떨어졌습니다. 인용 안정성(Citation stability)은 정확도를 측정하는 지표는 아니지만, 증거가 바뀌면 답변이 바뀔 수 있으며, 특히 출처 간에 충돌이 있을 때 더욱 그렇습니다. 중요한 비즈니스 기능의 경우, 팀들은 단순히 평균 정확도가 높은 것뿐만 아니라 재현하고 감사할 수 있는(reproduce and audit) 답변을 필요로 합니다.
위키는 에이전트가 여러 출처에 걸쳐 도메인 지식을 적용하도록 도왔습니다. 남아있는 과제는 지원 증거까지의 경로를 더욱 반복 가능하게(repeatable) 만드는 것이었습니다.
증거 그래프 추가하기 (Adding an evidence graph)
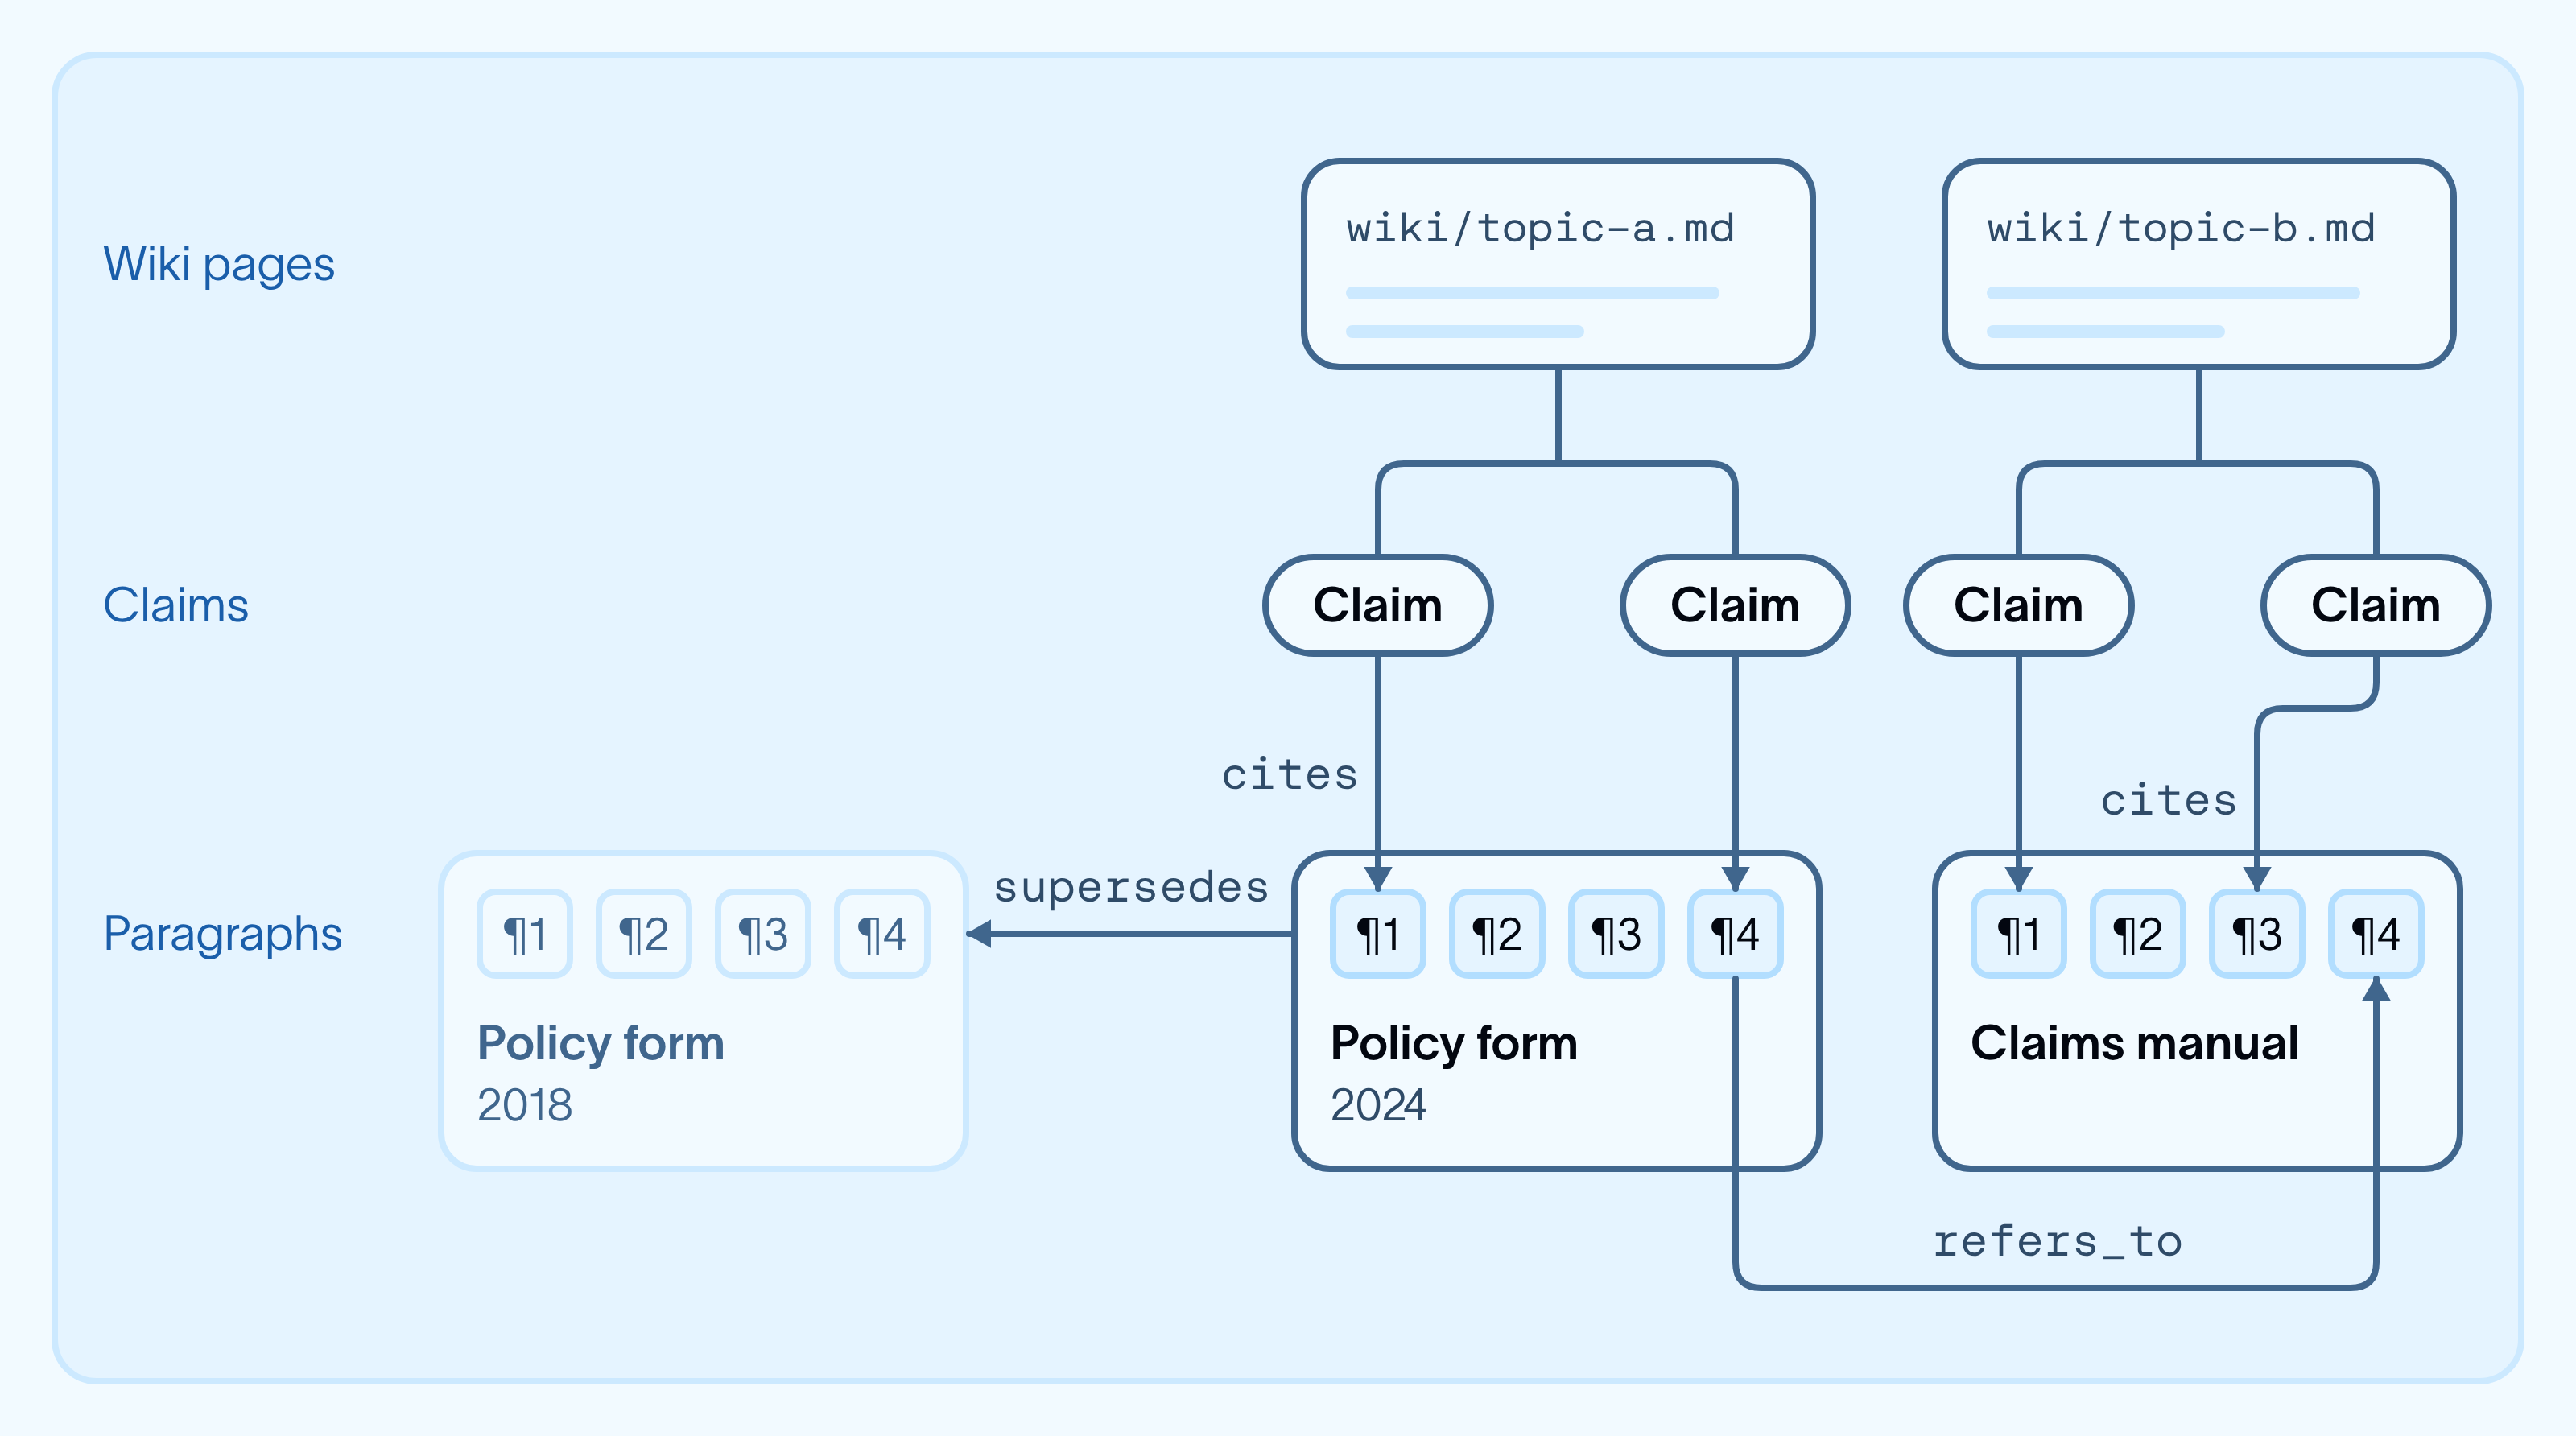
검색을 더 일관성 있게 만들기 위해, 저희는 가벼운 **증거 그래프(evidence graph)**를 추가했습니다. 이는 위키 인용을 주장(claims), 위키 페이지, 단락, 주제 간의 명시적이고 유형화된 엣지(typed edges)로 변환하는 지도입니다. OpenWiki 인용은 Markdown 파일 내의 텍스트 참조입니다. 이 그래프는 이러한 참조를 유형화된 엣지로 물질화하여 영구적으로 만듭니다. 이는 에이전트가 검색을 통해 같은 링크들을 재발견하는 대신, 따라갈 수 있는 안정적인 경로를 제공합니다.
이 그래프는 두 단계에 걸쳐 구축되었습니다:
모든 문단을 새로운 원시 단위(primitive)로 저장합니다. 결정론적 과정은 각 문서를 문단으로 분할하고 각각에 고유 식별자를 할당합니다. 이 문단들은 전체 문서가 아닌, 주장과 정확한 근거 구절을 연결하는 정보의 원자 단위가 됩니다.
구절들을 타입화된 엣지(typed edges)로 연결합니다. 우리는 문단, 주장, 위키 페이지를 다음과 같은 타입화된 엣지로 연결했습니다: 주장이 문단을 cite하고, 새 문서가 이전 문서를 supersede하며, 섹션이 다른 문서를 refers_to합니다. 각 엣지는 단순한 연결뿐만 아니라 관계 자체를 식별합니다. 우리는 두 가지 방식으로 엣지를 구축했습니다. 일부는 문서 참조로부터 결정론적으로 추출됩니다. 위키 주장이 이미 텍스트 인용을 포함하고 있기 때문에, 또 다른 모델 호출 없이도 refers_to나 supersedes와 같은 타입화된 엣지를 구현할 수 있습니다.
이 그래프는 구축하는 데 1초도 걸리지 않았으며 테스트 라이브러리의 모든 명시적 교차 참조를 해결하여, 에이전트가 매 질문마다 연결을 재발견하는 대신 링크를 따라갈 수 있게 했습니다.
이 그래프의 역할은 조직이 아는 모든 것을 모델링하는 것이 아니라, 증거 탐색(evidence navigation)입니다. 위키 자체가 여전히 종합적인 내용을 제공합니다. 추출에 중점을 둔 지식 그래프 파이프라인과 달리, 이 계층은 엔티티를 모델로 추출하고 조정하기보다는 기존의 참조와 인용을 재사용합니다. 구축 과정에는 추가적인 모델 호출이 필요하지 않지만, 위키에서 파생된 엣지는 여전히 그 모델 생성 인용의 정확도에 의존합니다.
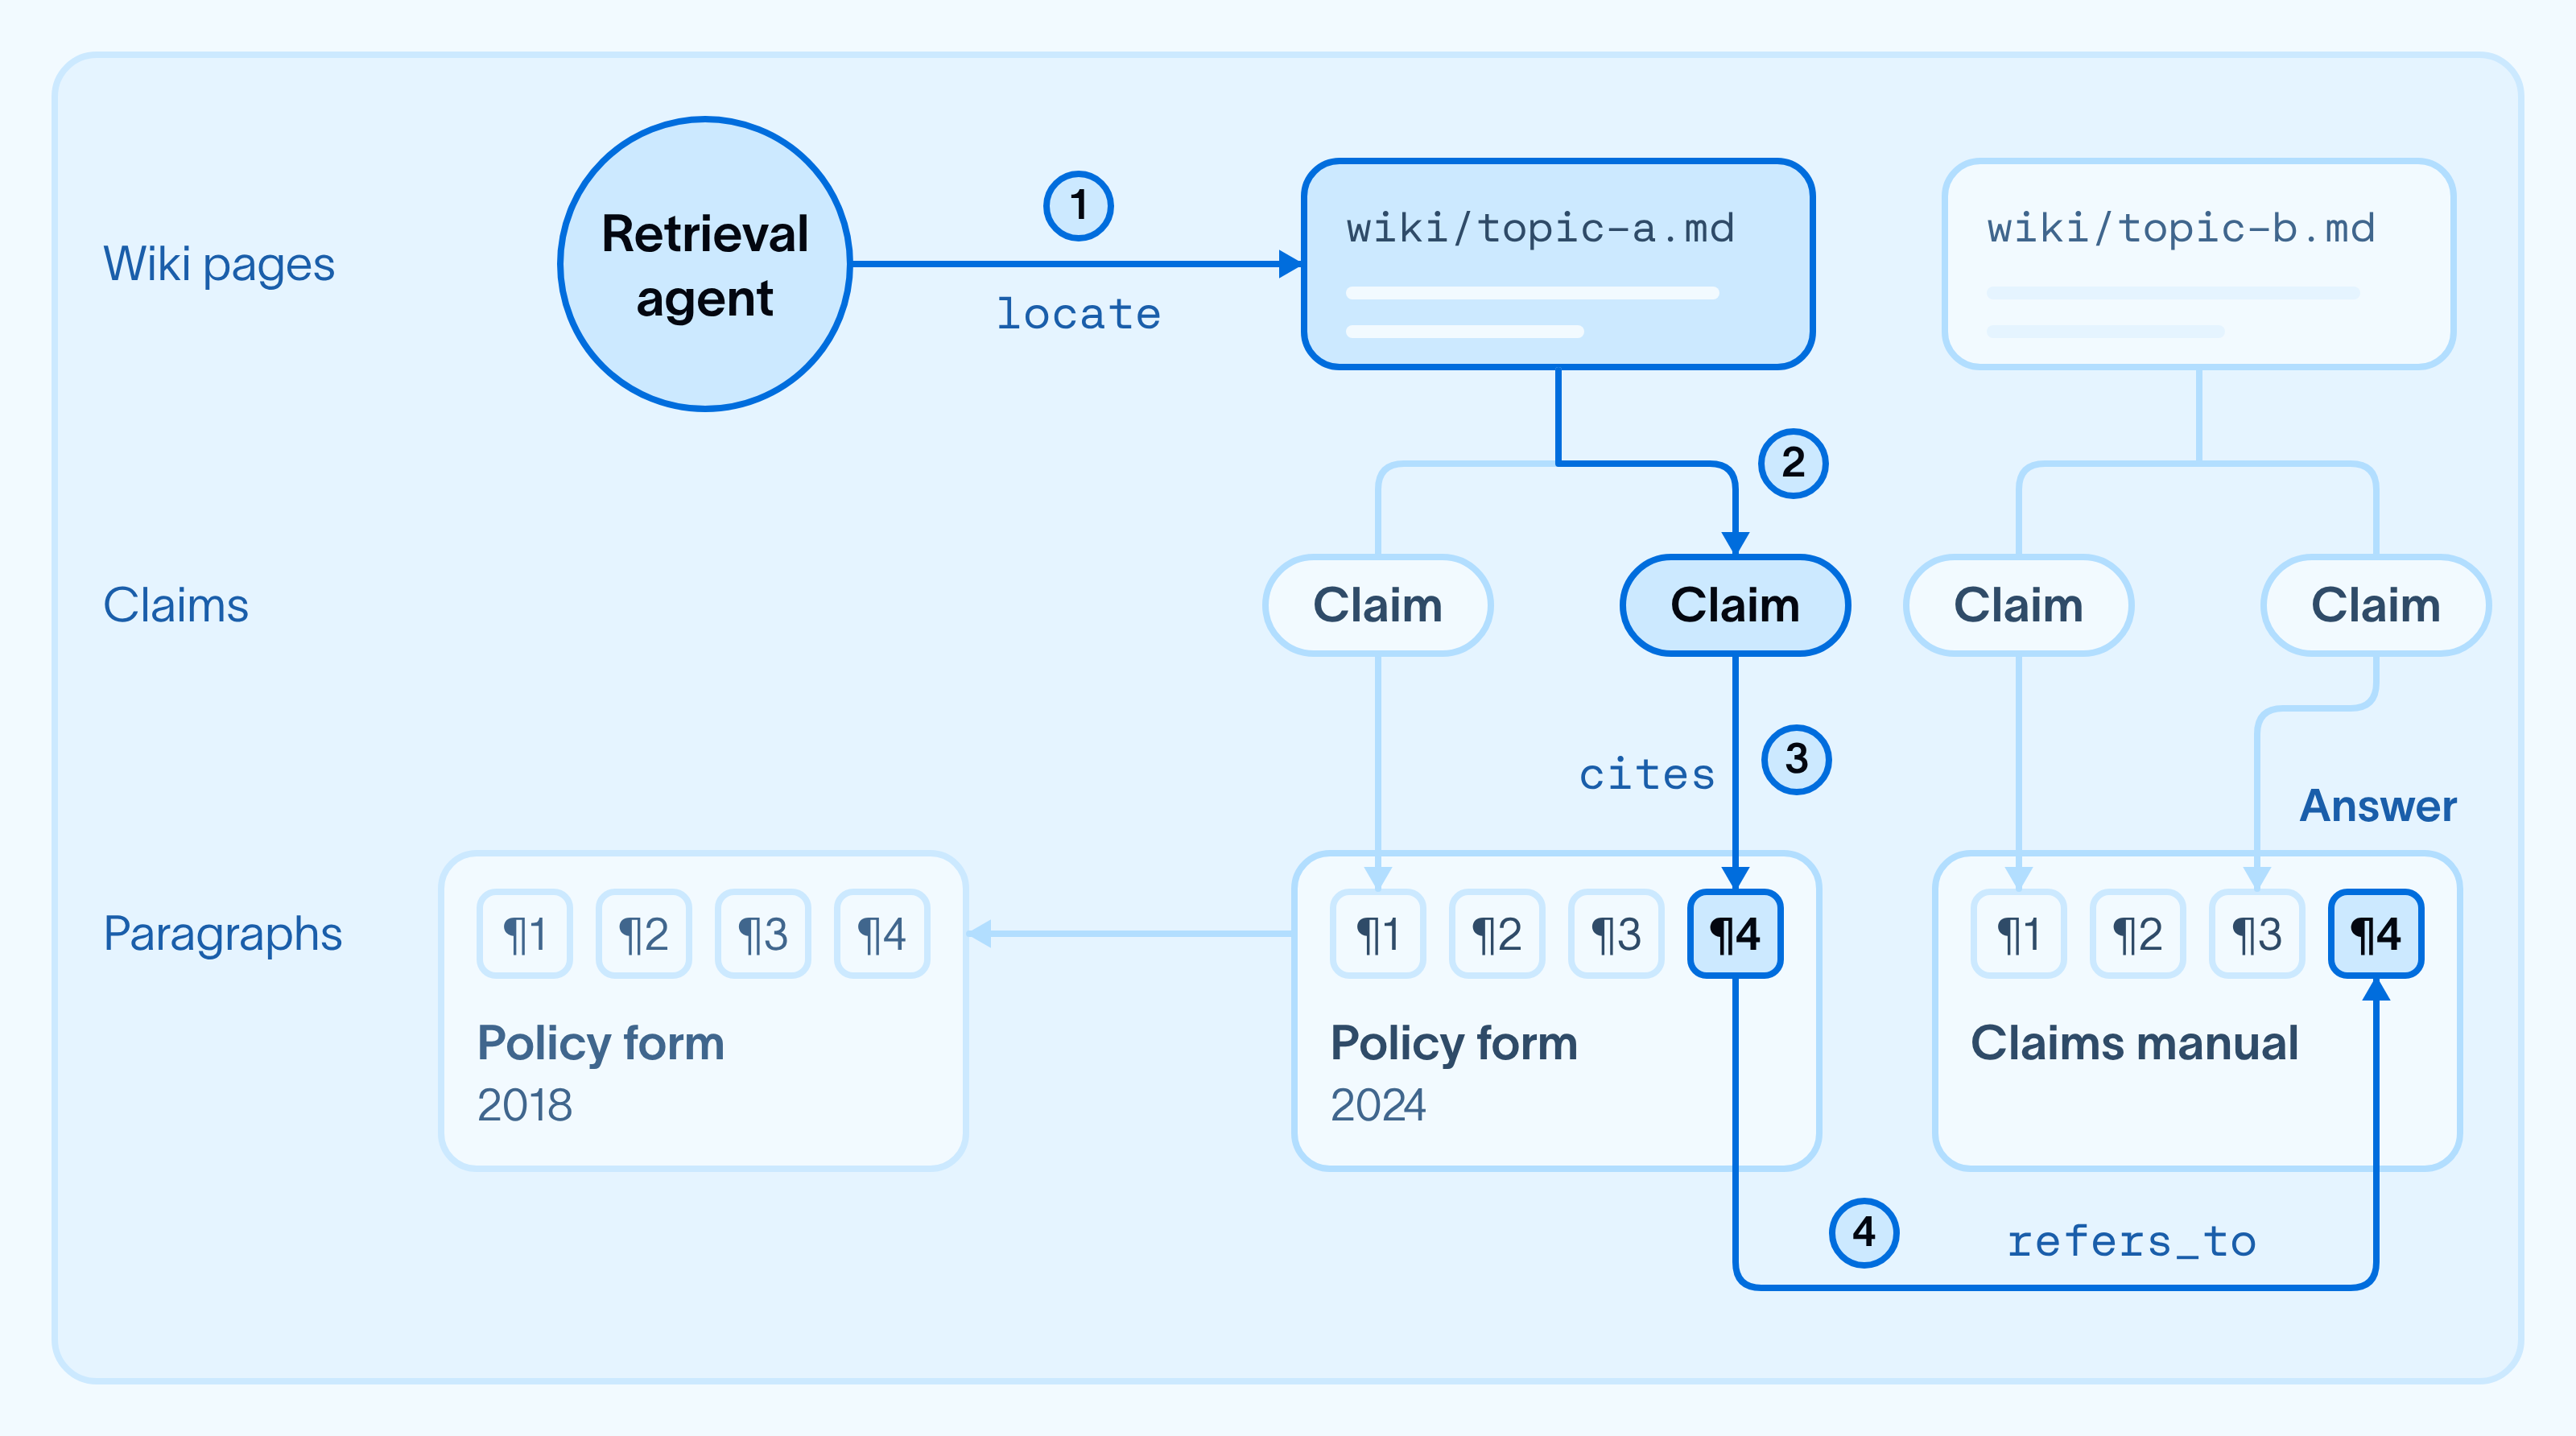
두 가지 도구는 에이전트가 지도를 탐색할 수 있게 합니다: locate는 질문과 일치하는 시작점을 찾고, expand는 연결을 따라 근거 구절 및 관련 문서로 이동합니다. 경로가 하나만 있는 경우, expand는 자동으로 이를 따르며; 경로가 분기되는 경우, 에이전트는 다음에 어디로 갈지 선택합니다. 관련 노드를 찾아내고 연결된 컨텍스트를 수집하는 이 패턴은 Microsoft의 GraphRAG와 같은 GraphRAG 시스템에서도 나타납니다.
@tool(parse_docstring=True)
async def locate(terms: str, within: str | None = None) -> dict:
"""시작 지점을 찾습니다: 질문의 단어와 문서 제목을 일치시킵니다,
..."
더 나은 정확도, 낮은 비용, 빠른 답변
명시적인 증거 경로(evidence paths)를 추가하는 것은 wiki만 사용했을 때보다 모든 측정 항목을 개선했습니다. 정확도는 27% 상승했고, 인용 일관성은 두 배로 증가했으며, 중앙값 답변 시간은 40% 감소했고, 정답당 비용은 58% 감소했습니다. 증거 그래프는 위키의 컨텍스트에 보다 방향성 있는 검색(directed retrieval)을 보완하여, 에이전트를 완전히 결정론적(deterministic)으로 만들지 않으면서도 정확도와 일관성을 모두 향상시켰습니다.
메모리 추가가 비용 대비 가치가 있는 경우는 언제인가?
컴파일된 위키에 대한 가장 강력한 근거는 반복적인 교차 출처 추론(cross-source reasoning)입니다. 저희 실험에서 위키는 에이전트가 검색을 통해 도메인 관계를 재구성하기보다는 적용하도록 도움을 주었습니다. 하지만 메모리 레이어만으로는 증거 검색의 일관성을 확보할 수 없었습니다. 명시적인 그래프 엣지(graph edges)를 추가하는 것은 검색 작업을 줄이는 동시에 인용 일관성과 정확도를 개선했습니다.
위키는 기존 인용 및 문서 참조로부터 결정론적으로 파생된 경량 증거 그래프를 위한 강력한 기반을 제공했습니다. 이를 통해 조직이 아는 모든 것을 모델링할 필요나 추가적인 모델 호출 없이 명시적인 증거 경로를 추가할 수 있었습니다.
위키가 투자 가치가 있는지 여부는 재사용성에 달려 있습니다. 저희가 보고한 답변 비용에는 컴파일 비용이 제외되어 있으며, 문서를 추가하는 데는 각각 약 $0.09가 소요됩니다. 단순 조회(simple lookups)의 경우, 검색만으로도 충분히 정확하고 빠르기 때문에, 특히 엔터프라이즈 규모에서는 수집 및 지속적인 유지보수 비용이 검색 절감액보다 클 수 있습니다.
여러 에이전트가 동일한 단절된 출처에 걸쳐 질문에 반복적으로 답변할 때 트레이드오프(tradeoff)는 달라집니다. 공유 위키는 해당 출처들 간의 관계를 보존하며, 그래프 엣지(graph edges)는 에이전트가 근거 증거로 안내합니다. 저희 테스트에서 이 조합은 정확도가 높고 정답당 비용이 더 낮은 답변을 생성했습니다. 충분한 재사용이 이루어지면, 반복적인 컨텍스트 재구성(context reconstruction)을 피함으로써 얻는 절감액이 메모리를 구축하고 유지하는 비용을 상쇄할 수 있습니다.
다음 단계 (What's next)
다음으로, 저희는 전체 저장소(repositories) 대신 에이전트가 교차 출처 질문에 필요한 컨텍스트만을 컴파일하고 유지하는 방식으로 위키를 더 동적으로 구축하고자 합니다. 또한, 저희는 다른 종류의 에이전트 메모리를 위한 기반으로서 주장(claims)과 타입화된 엣지(typed edges)를 탐구하고자 합니다. 지식을 증거와 연결하고 그것이 언제 변경되는지 감지하는 것은 의미론적 메모리(semantic memory, 사실), 일화적 메모리(episodic memory, 발생한 사건), 그리고 절차적 메모리(procedural memory, 수행 방법)를 확립하는 데 도움이 될 수 있습니다.
에이전트에 위키를 추가하고 싶으신가요? 저희의 OpenWiki 리소스를 확인해 보세요:
감사의 말씀 (Acknowledgments)