
OpenAI Decisions API는 신뢰할 수 있는 확신도를 필요로 합니다
요약
본 기사는 LLM의 확신도(confidence)를 기반으로 에이전트의 다음 행동을 결정하는 OpenAI Decisions API에 대해 다룹니다. 모델의 신뢰도를 활용하여 메시지 분류, 요청 라우팅 등 의사결정 과정에 적용할 수 있으며, 특히 임계값 설정과 테스트 가능한 신뢰도 제공이 중요함을 강조합니다.
핵심 포인트
- Decisions API는 사용자가 정의한 목록에서 답변을 선택하고 분기하는 데 사용됩니다.
- 모델의 확신도를 기반으로 에이전트 행동을 결정하는 것이 핵심 활용 사례입니다.
- OpenAI가 모델의 신뢰도(calibration)를 제품처럼 제공하기를 기대합니다.
- GPT-4o-mini 등 최신 모델에서 신뢰도 기반 라우팅 파이프라인을 확인할 수 있습니다.
- 질문
- 예
- 아니오
질문이 들어갑니다. 그리고 우리가 확인할 수 있는 확신도와 함께 판결이 나옵니다.
OpenAI Decisions API는 신뢰할 수 있는 확신도를 필요로 합니다
우리는 2023년부터 LLM(대규모 언어 모델)의 확신도에 대한 결정을 다뤄왔으며, 그중에서도 보정(calibration)이 OpenAI의 새로운 Decisions API가 가장 잘 처리하기를 바라는 부분입니다. 기반 모델인 GPT-6 Luna는 아직 존재하지 않습니다: 3,600개의 추론 문제 중 99%라고 했지만 실제로는 68%였고, 5단계 추론 과정에서는 동전 던지기 수준이었습니다.
만약 에이전트의 다음 단계를 결정 모델에 보내고, 그 모델이 최소한 99% 확신할 때만 행동하도록 허용한다고 가정해 봅시다. 나머지 모든 것은 사람에게 맡깁니다. 이 규칙은 99%라는 수치만큼만 좋을 수 있습니다. 우리는 OpenAI의 새로운 Decisions API 뒤에 있는 모델인 GPT-6 Luna에게 3,600개의 추론 문제를 주고 정확히 그런 종류의 답변을 요청했습니다. Luna가 99% 이상이라고 말했을 때, 실제 정답률은 68%였습니다.
OpenAI는 DevDay에서 지난 9월 29일 제한적 프리뷰로 Decisions API를 발표했습니다. 이 API는 사용자가 정의한 목록에서 하나의 답변을 선택하며, 소프트웨어는 이를 기반으로 분기할 수 있습니다: 메시지 분류, 요청 라우팅, 에이전트의 다음 행동 결정 등입니다. Decoder와 Axios에 따르면 이는 OpenAI의 저비용 모델인
우리는 2023년부터 모델의 신뢰도(confidence)를 기반으로 라우팅을 해왔습니다. Call Criteria의 경우, LLM은 수백 개의 클라이언트 스코어카드에 따라 통화 내용을 점수 매기고, 사람들은 시스템이 확신하지 못하는 통화를 검토합니다. 모든 것이 어떤 통화인지 아는 것에 달려 있습니다. OpenAI 모델의 토큰 로그 확률(token log-probabilities)에서 신뢰도를 읽었을 때, 그 수치들이 너무 집중되어 있어서 거의 모든 답변에 대해 확실해 보이는 정도였습니다. OpenAI의 모델들은 우리가 사용해 온 내내 신뢰도 문제를 겪어왔으며, 그것은 소극적인 종류가 아니었습니다. 최신 추론 모델(reasoning models)들은 종종 로그 확률을 아예 노출하지 않습니다. 그래서 우리는 자체적으로 신뢰도를 구축했습니다: 각 레이블 뒤의 확률을 추출하고, 레이블링된 답변과 비교하며, 보정(calibrate)한 다음, 비로소 그것을 기반으로 라우팅하는 것입니다. Classification with Confidence는 GPT-4o-mini에서 이러한 파이프라인을 보여줍니다.
이것이 Decisions API가 해결할 수 있는 고통 지점입니다. 우리가 가장 바라는 것은 OpenAI가 이제 보정(calibration)을 제품처럼 취급하는 것입니다. 즉, 증명 없이 추측하기로는 모델을 추출(distill)하기 어렵게 만드는 것의 일부일 수 있는 API에서 숨겨진 것이 아니라, 임계값(threshold)을 설정할 수 있고 문서화되며 테스트 가능한 신뢰도 말입니다. 의사 결정 엔드포인트(decision endpoint)가 바로 이런 일이 일어나야 하는 곳입니다. 그래서 우리는 오늘날 그 밑에 깔린 모델이 무엇을 하는지 알고 싶었습니다.
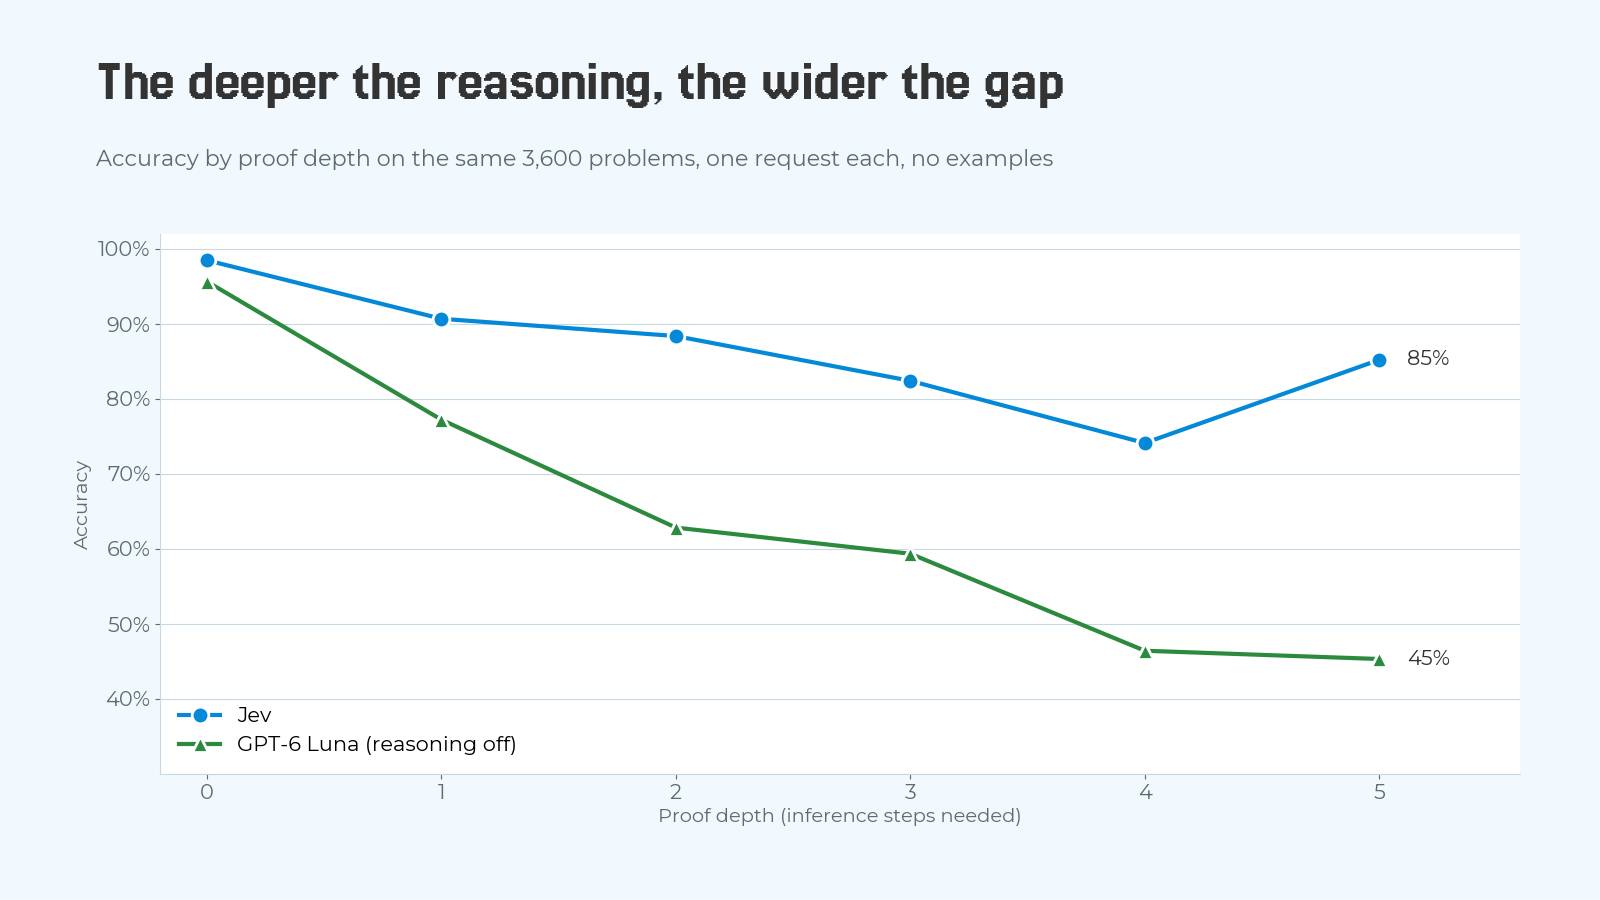
답변에 필요한 추론 단계 수에 따른 정확도, ProofWriter 작업 모두 통합.
테스트
문제들은 Allen Institute for AI의 데이터셋인 ProofWriter에서 나옵니다. 각 문제는 평이한 영어로 된 사실 목록과 if-then 규칙들, 그리고 판단할 진술로 이루어져 있습니다. 어떤 답변은 페이지에서 바로 읽을 수 있습니다. 다른 답변들은 다섯 개의 규칙을 연결해야 합니다. 이 데이터셋은 모든 문제에 그 숫자인 증명 깊이(proof depth)를 레이블링하여, 난이도를 논쟁하는 것이 아니라 측정할 수 있게 만듭니다.
과제에는 두 가지 버전이 있습니다. 오픈 월드(open-world)에서는 답이 참, 거짓 또는 알 수 없음 중 하나입니다. '알 수 없음'은 규칙이 해당 진술이나 그 반대 진술 어느 쪽도 확정하지 못할 때 발생합니다. 클로즈드 월드(closed-world)에서는 증명할 수 없는 모든 것이 거짓입니다. 저희는 각 버전별로 1,800개의 문제를 샘플링했으며, 깊이마다 약 300개씩의 문제에 대해 독립적인 솔버를 사용하여 모든 정답을 재계산했습니다.
Luna 역시 다른 사람들과 동일한 처우를 받았습니다. 문제당 한 번의 요청입니다. Luna는 Jev가 받는 것과 똑같이 문제입니다. 질문과 각 선택지의 의미까지 단어 하나하나까지 전달받습니다. 세 가지 선택지만 허용하는 엄격한 JSON 스키마를 사용합니다. 이는 빠른 의사결정 API(decision API)가 함축하는 '추론 비활성화(Reasoning off)' 설정입니다.
정확도: 페이지 상에서는 좋으나, 5단계만 넘어가면 동전 던지기 수준
읽기만으로 답할 수 있는 문제에 대해서는 Luna가 Jev와 거의 비슷한 성능을 보였습니다. 오픈 월드 과제에서 93%로, 클로즈드 월드 과제에서는 98%를 기록했습니다. 하지만 단계가 깊어질수록 점수가 떨어집니다. 다섯 번의 연쇄 추론(chained inferences) 후 Luna는 각각 46%, 45%의 정확도를 보였습니다. 클로즈드 월드 과제에서 이는 동전 던지기 수준입니다. 반면 Jev는 같은 깊이, 같은 문제에서 각각 81%, 89%를 기록했습니다.
모든 깊이에 걸쳐 Jev는 83.8%, 89.3%의 점수를 받았고; Luna는 64.1%, 65.0%였습니다. 깊이 5에서의 격차는 각각 35점과 45점으로, 신뢰 구간(95% intervals)은 27점에서 43점, 그리고 38점에서 51점이었습니다. 이는 결코 근접한 차이가 아닙니다.
혹시 '추론 비활성화'가 Luna를 무너뜨린 원인이라고 생각하실 수도 있습니다. 이를 활성화하면 도움이 될 수도 있겠지만, 의사결정 API가 수행하도록 존재하는 일회성 작업(one-shot job)보다 모든 결정을 더 느리고 비용이 많이 들게 만들 것이며, 여기서 테스트된 모든 모델은 동일한 단일 기회를 얻었습니다. 우리가 테스트한 오픈 모델들도 깊이 5에서 막히는 모습을 보였습니다. Jev를 제외한 모든 모델들이 깊이 5에서는 동전 던지기 수준의 정확도를 보였습니다.
페이지에 답이 있을 때 틀림
Luna의 오류 중 대부분은 긴 연쇄 추론에서 발생하지만, 그렇지 않은 경우도 있습니다. Depth 0에서는 명제 또는 그 반대가 텍스트에 쓰여 있는 상황에서, Luna는 300개의 개방형(open-world) 문제 중 20개와 300개의 폐쇄형(closed-world) 문제 중 6개를 틀렸습니다. Depth 1, 즉 하나의 규칙 차이에서는 각각 302개 중 67개, 300개 중 70개를 놓쳤습니다. 다음은 각 깊이별, 작업 버전별로 발생한 오류 중 가장 짧았던 예시들입니다. 이 예시들은 우리가 로그 확률(log-probabilities)을 다시 요청했을 때 Luna가 동일한 답변을 내놓았으며, 이때 부여했던 신뢰도와 함께 제시됩니다.
Depth 0, 개방형. 텍스트는 "사자는 크지 않다"고 말합니다. "사자가 크다"는 참인가요, 거짓인가요, 아니면 알 수 없나요? 거짓입니다. 텍스트가 그렇게 말하고 있습니다. Luna는 알 수 없음(unknown), 100% 확신이라고 답했습니다. Depth 0, 폐쇄형. 텍스트는 "찰리는 착하다"고 말합니다. "찰리가 착하지 않다"는 참인가요, 거짓인가요? 거짓입니다. Luna는 참(true), 100% 확신이라고 답했습니다. Depth 1, 개방형. "호랑이는 크다. 모든 큰 사람들은 추위를 탄다." "호랑이가 추위를 타는가?" 예, 하나의 규칙 차이로 알 수 있습니다. Luna는 알 수 없음(unknown), 100% 확신이라고 답했습니다. Depth 1, 폐쇄형. "토끼는 크다. 만약 누군가가 크다면 그들은 토끼를 쫓는다." "토끼가 토끼를 쫓지 않는다"는 참인가요, 거짓인가요? 거짓입니다: 토끼는 크므로 토끼를 쫓습니다. Luna는 참(true), 100% 확신이라고 답했습니다.
이것들이 Luna의 가장 명확한 오류 사례들로, Depth 0에서는 각각 93%, 98%의 확률로 정확합니다. 그러나 텍스트가 '찰리는 착하다'고 말할 때, Luna가 '찰리가 착하지 않다'라고 100% 확신하는 의사결정 모델(decision model)은 단순히 신뢰도에 대한 임계값 이상의 것이 필요합니다.
Luna는 자신이 얼마나 확신하는지 알려줄 수 있을까요?
의사결정 모델이 가치를 발휘하려면 그 신뢰도를 믿을 수 있어야 합니다. Jev는 모든 옵션에 대해 확률을 반환합니다. Luna는 일반 API를 통해 텍스트를 반환합니다. 하지만 추론(reasoning) 기능을 비활성화하면, OpenAI의 API는 로그 확률(log-probabilities)도 반환할 것입니다. 즉, Luna가 작성한 각 토큰에 대해 해당 토큰이 가졌던 확률의 로그 값과 가장 가능성 높은 대안들을 함께 제공합니다. 추론 기능이 활성화되면, 이는 거부합니다: "'logprobs'는 이 모델에서 지원되지 않습니다(is not supported with this model)." 이는 OpenAI의 가이드와 일치합니다.
엄격한 스키마 덕분에 읽기가 깔끔합니다. Luna가 {"answer":""} 형식으로만 답변하도록 제한합니다.
, 따라서 옵션을 나타내는 토큰이 전체 결정을 담고 있으며, '아니요(No)'와 '없음(no)'을 조정할 필요가 없습니다. 이 토큰의 로그 확률(log-probability)을 확률로 변환하면 Luna가 제시한 답변에 대한 확신도를 알 수 있습니다.
실제 교환 사례를 하나 보여드리겠습니다. 긴 프롬프트를 제외한 요청은 다음과 같습니다:
{
"model": "gpt-6-luna",
"reasoning_effort": "none",
...
이것을 의역하면 다음과 같습니다:
앨런은 어리고, 둥글고, 친절하지만, 그렇다고 해서 그가 때로는 거칠고 차갑지 않다는 의미는 아닙니다. … 젊고 둥근 녹색 사람들은 보통 파란색입니다. … 피부가 거친 친절한 사람들은 보통 빨간색인데, 그것은 바람에 의한 손상 때문입니다. 만약 누군가가 자신이 빨간색이라고 보여준다면, 그 사람은 또한 녹색이라는 것도 보여주는 것입니다. …
진술: 앨런은 파란색이 아니다.
그리고 로그 확률과 함께 제시된 Luna의 답변은 다음과 같습니다:
"content": "{\"answer\":\"unknown"}",
"logprobs": { "content": [
{ "token": "{\", "logprob": 0.0, "top_logprobs": [ { "token": "{\", "logprob": 0.0 } ] },
...
로그 확률 −0.00182는 99.82%의 확률을 의미합니다. 저희는 다섯 가지 대안을 요청했지만 아무것도 받지 못했습니다. Luna는 본질적으로 '참(true)'이나 '거짓(false)'에 대해 아무런 점수를 매기지 않았습니다. 그리고 그것은 틀렸습니다. 앨런은 피부가 거친 친절한 사람이므로 빨간색이고, 빨간색은 녹색을 의미하며, 어리고 둥글고 녹색인 것은 파란색을 의미합니다. '앨런은 파란색이 아니다'는 세 단계에 걸쳐 거짓입니다.
Luna가 99%라고 말할 때
하나의 예시는 아무것도 증명하지 못하므로, 저희는 벤치마크에서 요청한 것과 정확히 일치하는 모든 3,600개의 문제에 대해 로그 확률을 요청했습니다. 비용은 약 14센트였고, 모든 요청과 응답은 원문 그대로 보관되었습니다.
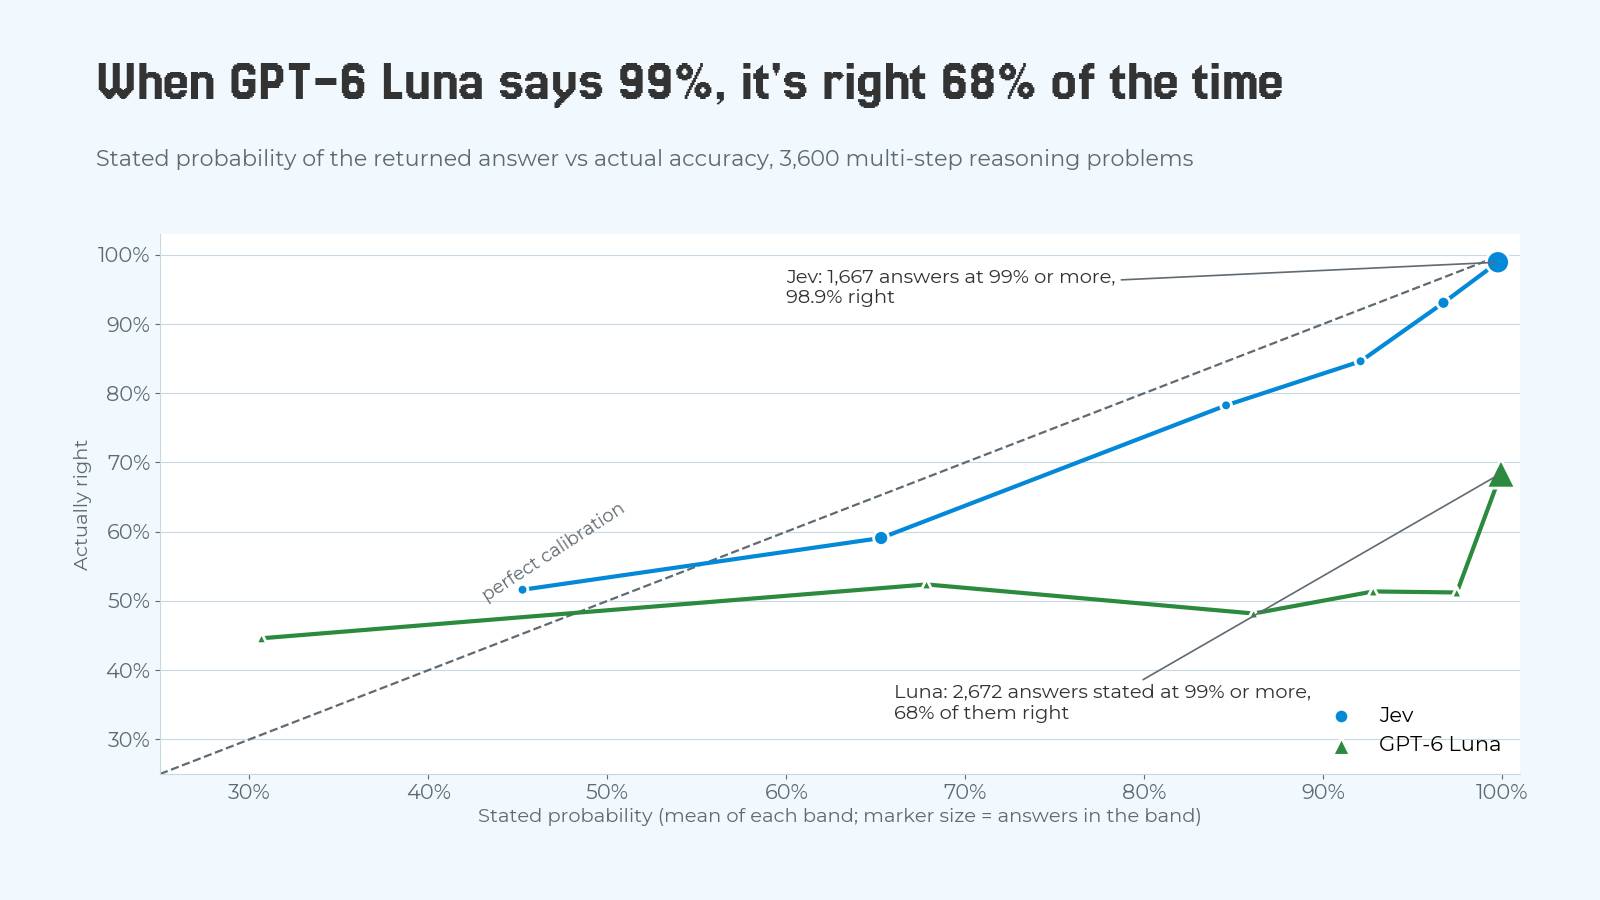
각 점은 제시된 확률의 범위입니다. 점선 대각선은 완벽하게 보정된(perfectly calibrated) 모델이 위치할 곳을 나타냅니다. 두 작업이 통합되었습니다.
Luna는 3,600개의 답변 중 2,672개에서 99% 이상의 확률을 제시했으며, 그중 68%가 맞았습니다. 그 아래에서는 평평합니다: Luna가 70%, 90%, 또는 97%라고 말하든, 약 절반 정도만 맞습니다. Jev는 1,667개의 답변에서 99% 이상을 제시했고, 그중 98.9%가 맞았습니다. 그 선은 전체적으로 대각선에 가깝게 움직입니다.
다른 수치들도 같은 것을 보여줍니다:
95% 이상에서 틀린 답변 비율: Luna의 경우 두 과제에서 78%를 기록한 반면, Jev는 각각 7%, 17%였습니다. 기대 보정 오차(Expected calibration error), 즉 진술된 확률과 실제 확률 간의 평균 격차: 두 과제 모두 Luna는 0.32였고, Jev는 각각 0.04와 0.03이었습니다. 맞음과 틀림 분리 능력(AUROC, 여기서 0.5는 확률이 아무 정보도 제공하지 않음을 의미): Luna는 각각 0.66과 0.68이었고, Jev는 0.85와 0.86이었습니다.
몇 단계를 지나면 확신도가 정보를 담지 못한다
자만심(Overconfidence) 자체는 수정 가능합니다. 만약 모델의 99%가 항상 68%를 의미한다면, Jev의 신뢰도 보정 방식과 마찬가지로 이를 재표기할 수 있습니다. 하지만 어떤 확률은 '맞음' 여부와 함께 움직이지 않는 경우, 보정이 해결해 줄 수 없습니다.
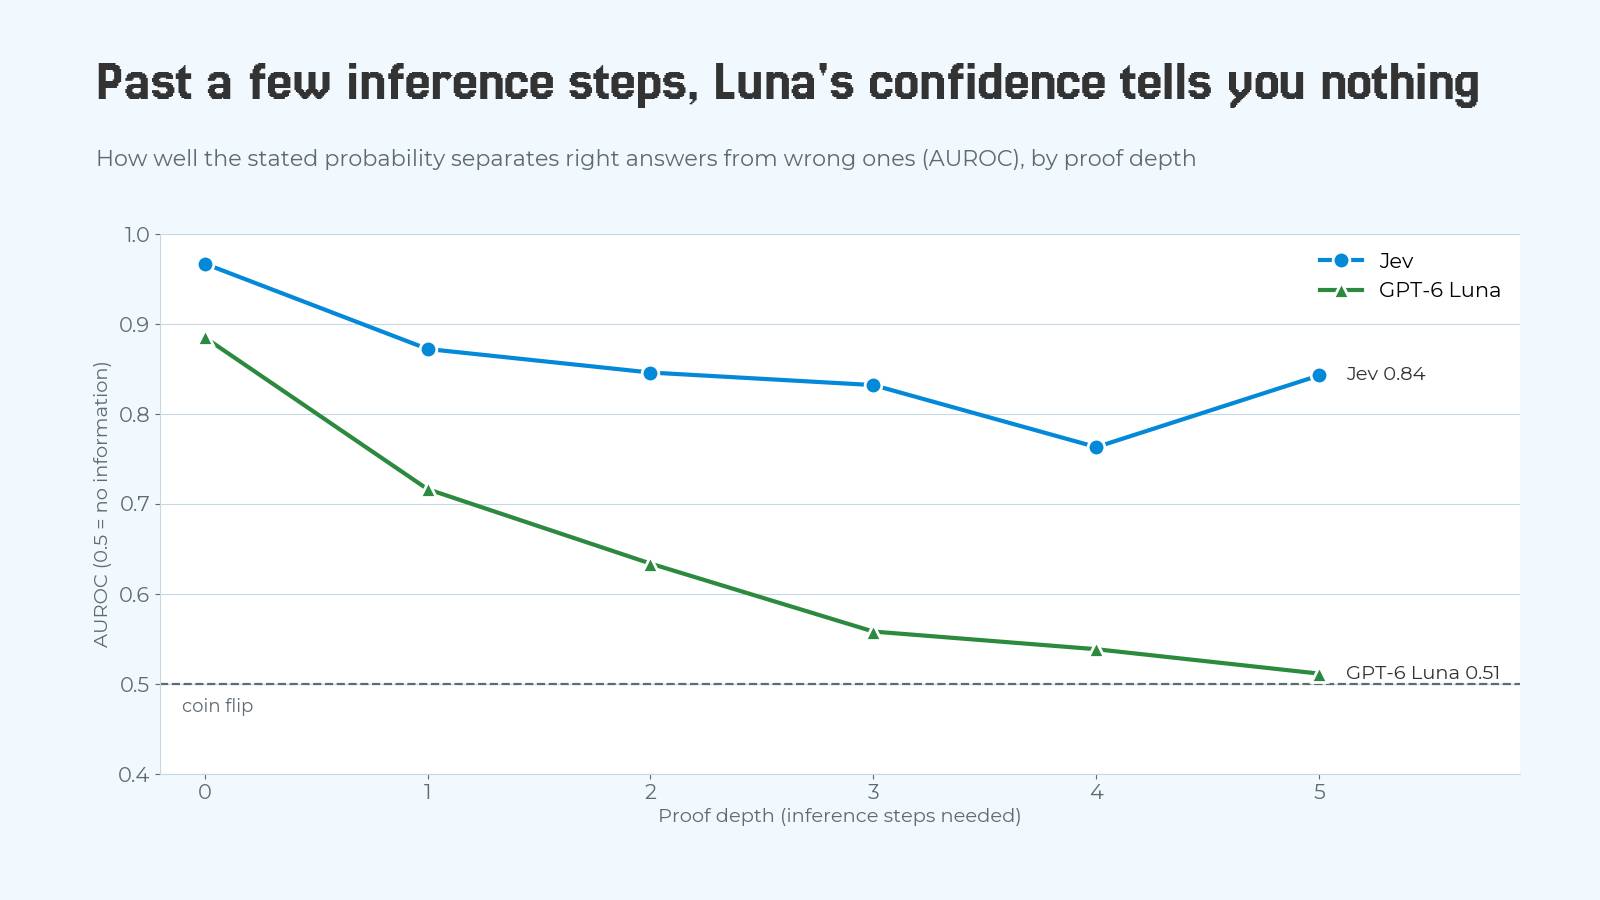
각 모델이 증명 깊이에 따라 자신의 정답과 오답을 얼마나 잘 분리하는지 보여줍니다. 0.5는 정보가 전혀 없음을 의미합니다.
페이지에서 읽어낼 수 있는 문제의 경우, Luna의 확률은 유용합니다: 정답은 오답보다 더 높은 숫자를 얻습니다. 각 추론 단계(inference step)마다 이 격차는 줄어들고, 5단계가 지나면 AUROC는 0.51에 도달합니다. 즉, 높게 진술된 확률이 낮게 진술된 확률보다 정답일 가능성이 더 높지 않습니다. 숫자를 재매핑한다고 해서 그들이 담고 있지 않은 정보를 추가할 수는 없으므로, 어려운 문제에서 Luna의 신뢰도 임계값은 무작위로 움직입니다. 반면 Jev는 여전히 0.84에서 정답과 오답을 분류합니다.
숨겨져 있거나, 아니면 단순히 과신하는 것일까?
우리는 OpenAI가 Luna의 로그 확률(log-probabilities)을 숨긴다고 가정했습니다. 하지만 추론 기능이 꺼진 상태에서는 대부분 그렇게 하지 않습니다. 반환되는 대안들은 평균적으로 확률의 99.8%를 차지하며, 제외되는 대안들은 거의 아무것도 담고 있지 않습니다. 이 결과들의 문제는 비밀 유지가 아니라 과신입니다.
이는 OpenAI가 GPT-4에 대해 자체 보고한 내용과 일치합니다: 사전 학습된 모델의 확률은 잘 보정되었지만(well calibrated), 사후 학습을 거치면서 현저하게 나빠졌습니다 (GPT-4 Technical Report, figure 8). 또한 이는 일반적으로 OpenAI 모델을 다루는 우리의 경험과도 일치합니다. 그들이 로그 확률을 공개하는 경우, 신뢰도가 너무 높아 임계값을 설정하여 사용할 수 있는 수준으로 보정할 필요가 없었던 것입니다.
API가 추론(reasoning)이 활성화되면 왜 로그 확률(log-probabilities)을 거부하는 걸까요? 저희는 모릅니다. 연구원들은 OpenAI의 프로덕션 모델 일부를 해당 API의 로그 확률과 로짓 편향(logit bias)으로부터 복구했으며, 이에 대응하여 OpenAI가 API를 변경했습니다 (Carlini et al., 2024; 또한 Finlayson et al., 2024 참조). OpenAI는 경쟁 우위(competitive advantage)의 일부로 o1의 원시 추론 과정 역시 비공개로 유지하고 있습니다 (OpenAI). 모델을 증류(distillation)로부터 보호하는 것이 그럴듯한 이유 중 하나입니다. 하지만 저희에게는 그것이 이유라는 증거가 없습니다.
Decisions API에 대한 의미
AI 자동 생성 콘텐츠
본 콘텐츠는 HN Code Generation의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기