2026년 4분기에 접어들면서 NVIDIA와 파트너사들은 Vera Rubin의 생산 확대(ramp-up) 단계에 있습니다. 여기에는 하이퍼스케일러들이 고객들에게 최초로 NVL72 시스템을 일반 판매하고 있는 것도 포함됩니다. Vera Rubin이 생산 출시의 변곡점에 도달함에 따라, NVIDIA는 마침내 하드웨어 출하 사양을 확정했습니다. 알고 보니, 회사는 이 사양들을 조용히 수정했는데, Rubin GPU가 이전에 홍보했던 것보다 메모리와 스케일업 네트워킹(NVLink) 대역폭은 줄었지만, 스케일아웃 대역폭은 더 많이 제공하는 것으로 나타났습니다.
IT Home이 지난 9월에 처음 포착했듯이, NVIDIA는 자사 웹페이지와 NVIDIA 아키텍처 데이터시트에 Rubin GPU 및 다양한 Rubin 기반 제품의 업데이트된 사양을 게시했습니다. 서버 하드웨어 사양이 제품 출시 전에 변경되는 것은 드문 일이 아니며, 특히 거의 1년 전에 발표된 Vera Rubin과 같은 경우 더욱 그렇습니다. NVIDIA의 경우도 다르지 않아, 회사는 이전에 해당 사양들이 예비적이며 당시 “모든 값은 변동될 수 있다”고 언급한 바 있습니다.
Rubin GPU: HBM4 대역폭 감소, NVLink 대역폭 감소, 스케일아웃 대역폭 증가
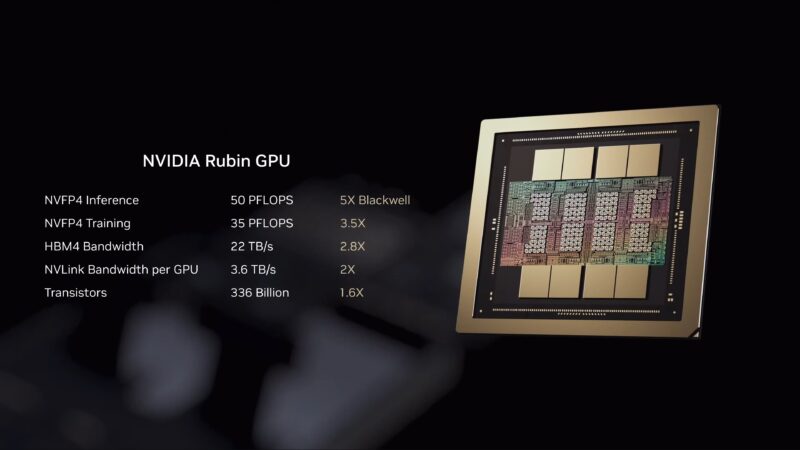
먼저 NVIDIA의 Rubin GPU에 대해 이야기해 봅시다. 이 세대에서 NVIDIA가 목표로 하는 핵심인 NVIDIA의 Rubin 서버 GPU는 크고 작은 시스템에 탑재되어 훨씬 더 큰 프로젝트들의 빌딩 블록 역할을 할 것입니다.
NVIDIA Rubin GPU 사양 |
||||
예비(Preliminary) | 출하(Shipping) |
|||
NVFP4 추론(Inference) | 50 PFLOPS | 50 PFLOPS | ||
NVFP4 학습(Training) | 35 PFLOPS | 35 PFLOPS | ||
INT8 | 250 TOPS | 250 TOPS | ||
TF32 | 2 PFLOPS | 2 PFLOPS | ||
GPU 메모리 | 288GB HBM4 (8x36GB) | 288GB HBM4 (8x36GB) | ||
GPU 메모리 대역폭 | 22TB/sec (8×[email protected]) | 19.2TB/sec(8×[email protected]) | ||
NVLink 대역폭(스케일업) | 3.6TB/sec | 3.0TB/sec | ||
네트워킹 대역폭(스케일아웃) | 0.4TB/sec | 0.45TB/sec | ||
아키텍처 | Rubin | Rubin |
NVIDIA의 초기 사양과 비교했을 때, 단일 Rubin GPU에 대한 HBM4 메모리 대역폭이 눈에 띄게 하향 조정되었습니다. NVIDIA는 원래 Rubin GPU당 메모리 대역폭을 22TB/second로 목표했었습니다. HBM4 메모리 스택 8개를 기준으로 할 때, 이는 각 스택을 약 10.75Gbps/pin으로 구동한다는 의미였습니다. 그러나 수정된 출하 사양에 따르면, 단일 Rubin GPU는 이제 19.2TB/second의 대역폭을 제공하며, 데이터 전송률은 약 9.375Gbps/pin입니다. 이는 1.375Gbps, 즉 대략 11%의 순손실을 의미합니다.
이러한 사양 변경은 NVIDIA가 HBM4에 대해 매우 공격적인 데이터 전송 속도를 예측해 왔다는 점과 관련됩니다. 고대역폭 메모리(HBM) 사양의 초대형 버전은 이미 스택당 메모리 버스 폭을 1024 bits에서 2048 bits로 두 배 늘렸습니다. 동시에, 공식 사양은 HBM4 스택이 HBM3E보다 약간 낮은 클럭 속도인 8Gbps/pin으로 구동될 것이라고 명시했습니다. NVIDIA의 10.75Gbps 속도는 원래의 HBM4 사양보다 훨씬 높았으며, 새로 낮춰진 9.375Gbps 데이터 전송률조차도 여전히 상당히 높은 수준입니다.
NVIDIA CES 2026 Keynote Rubin GPU NVIDIA CES 2026 Keynote Rubin GPU
참고로, NVIDIA의 경쟁사인 AMD는 MI455X에서 HBM4 스택을 단지 7.6Gbps/pin으로 구동할 예정입니다. 따라서 NVIDIA가 수정한 목표치는 다른 일부 HBM4 소비자들의 사양보다 훨씬 높은 수준입니다. 이 소식이 전해진 후에도, NVIDIA는 메모리 대역폭 사양을 하향 조정한 이유를 밝히지 않았습니다. 이에 따라 즉각적인 추정은 NVIDIA와 그 메모리 파트너들이 메모리 컨트롤러 속도, 메모리 스택 속도, 메모리 스택 수율(원하는 속도로 구동할 수 있는 개수), 또는 이 모든 요소의 조합 중 어느 것 하나를 충족시키지 못했기 때문이라는 것입니다. 이유가 무엇이든 간에, 순 결과는 고객들이 사용할 수 있는 GPU 메모리 대역폭이 줄어들고, 이는 성능상의 영향을 미칠 것이라는 점입니다.
NVLink 상호연결 대역폭 역시 NVIDIA의 초기 예상치에 비해 하락했습니다. NVIDIA의 다중 GPU 연결 및 스케일업 패브릭(scale-up fabric)에 대한 예비 사양은 각 Rubin GPU당 3.6TB/초의 NVLink 대역폭을 목표로 했습니다. 이는 현재 평면적인 3.0TB/초이며, 600GB/초 (또는 17%) 감소한 수치입니다. NVLink는 NVIDIA가 많은 물리적 GPU를 하나처럼 작동하도록 강하게 밀어붙이는 영역이므로, 일반적으로 가능한 한계를 끌어올립니다.
NVLink(스케일업) 대역폭은 줄었지만, 스케일아웃 네트워킹(scale-out networking) 대역폭은 오히려 성능을 초과 달성하고 있습니다. 단일 Rubin GPU의 경우, NVIDIA는 초기 사양인 400GB/초에서 상향 조정된 450GB/초의 네트워킹 대역폭을 제공합니다.
이러한 변경 사항 외에, NVIDIA는 Rubin GPU의 다른 사양은 변경하지 않았습니다. 이론적인(서류상의) 컴퓨팅 처리량은 FP4 추론에서 50 PFLOPS, FP4 학습에서 35 PFLOPS로 변동 없이 유지됩니다. 따라서 NVIDIA는 GPU의 클럭 속도와 메모리 용량 목표를 달성했습니다.
NVIDIA Vera Rubin NVL72: 이에 맞춰 개정된 랙 스케일(Rackscale)
Rubin의 사양 변경은 이 제품이 탑재될 모든 제품에 영향을 미치며, 가장 주목할 만한 것은 NVIDIA의 플래그십 제품인 Vera Rubin NVL72 랙입니다. NVL72는 Vera CPU, BlueField-4 DPU(데이터 처리 장치), 그리고 물론 Rubin GPU를 통합하여 NVIDIA의 모든 기술을 선보입니다.
NVIDIA Vera Rubin NVL72 사양 |
||||
예비 (Preliminary) | 출하 (Shipping) |
|||
NVFP4 추론 | 3600 PFLOPS | 50 PFLOPS | ||
NVFP4 학습 | 2520 PFLOPS | 35 PFLOPS | ||
INT8 | 18 POPS | 250 TOPS | ||
TF32 | 144 PFLOPS | 2 PFLOPS | ||
GPU 메모리 | 20.7TB HBM4 | 20.7TB HBM4 | ||
GPU 메모리 대역폭 | 1580TB/초 | 1400TB/초 |
||
NVLink 대역폭(스케일업) | 260TB/초 | 216TB/초 |
||
네트워킹 대역폭(스케일아웃) | 28.8TB/초 | 32.4TB/초 |
NVL72의 사양은 단일 Rubin GPU 변경 사항과 연동하여 수정되었습니다. 이는 랙 규모 시스템의 누적 GPU 메모리 대역폭이 1,580TB/초에서 1,400TB/초로 감소했음을 의미하며, 순손실액은 180 TB(11%)입니다. 다만, 단일 Rubin과 마찬가지로 NVL72의 GPU 메모리 용량은 HBM4 기준 20.7TB로 변동이 없습니다.
시스템 전체의 스케일업 도메인(scale-up domain)에 걸친 NVLink 대역폭 또한 조정되었습니다. NVIDIA가 랙 전반에 걸쳐 제공하려 했던 260TB/초의 대역폭 계획은 216TB/초로 하향 조정되었으며, 이는 각 Rubin GPU의 새로운 3TB/초 비율과 일치하는 17% 감소입니다.
Gigabyte Booth Tour NVIDIA Vera Rubin NVL72 Rack 4 Gigabyte Booth Tour NVIDIA Vera Rubin NVL72 Rack 4
NVL72의 긍정적인 부분은 개별 Rubin 칩과 동일한 스케일아웃 네트워킹 대역폭 증가분을 얻는다는 점입니다. 따라서 NVL72가 원래 제공할 예정이었던 28.8TB/초의 네트워킹 대역폭이 32.4TB/초(양방향)로 상향 조정되었습니다. 이는 스케일아웃 네트워킹을 많이 사용하는 더 큰 배포 환경에서, NVIDIA가 처음 예상했던 것보다 더 많은 대역폭(그리고 이상적으로는 더 많은 성능)이 이용 가능하다는 것을 의미합니다.
그 외 Vera Rubin NVL72의 나머지 수치는 이전 사양과 변동 없이 유지됩니다. 메모리와 NVLink 대역폭이 원래 의도했던 것보다 적어진 상태에서 NVL72 랙이 동일한 수준의 AI 성능을 달성할 수 있을지는 의문이지만, GPU 컴퓨팅 하드웨어(및 그 CPU 대응품)는 사양대로 출하될 예정입니다.
NVIDIA Rubin HGX NVL8: HBM4 용량 일부 손실
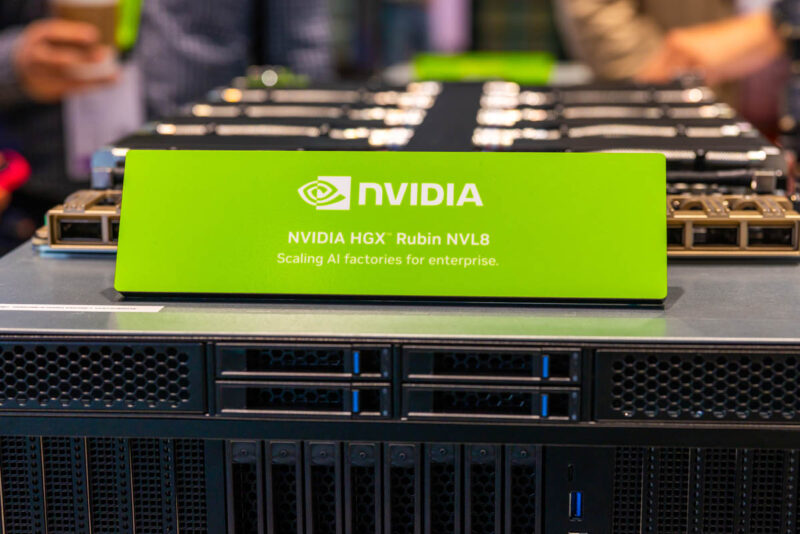
마지막으로, 기본 Rubin GPU 및 NVL72 랙의 사양 변경과는 별개로, NVIDIA는 Rubin을 기반으로 구축된 다른 제품들(Vera Rubin Superchip, Vera Rubin NVL4, HGX Rubin NVL8 등)도 수정했습니다. 이 중 마지막 제품인 HGX Rubin NVL8은 Rubin 사양 변경 외에도 자체적인 추가 변경 사항이 있어 특별히 언급할 가치가 있습니다.
| NVIDIA HGX Rubin NVL8 사양 |
|---|
| Preliminary |
|
| NVFP4 추론(Inference) |
| NVFP4 학습(Training) |
|
| FP8 학습(Training) |
|
| TF32 |
|
| GPU 메모리 |
|
| GPU 메모리 대역폭(Bandwidth) |
|
| NVLink 대역폭(Scale Up) |
|
| 네트워킹 대역폭(Scale Out) |
GPU 메모리 대역폭과 NVLink 대역폭이 감소하는 것 외에도, NVIDIA는 NVL8 시스템에서 사용 가능한 HBM4 메모리 양도 줄이고 있습니다. 원래 이 시스템들은 2.3TB의 HBM4를 탑재하도록 설정되었으나, 현재는 2.0TB로 낮아져 GPU 메모리가 300GB(또는 13%) 감소했습니다.
NVIDIA의 초기 수치는 NVL8에 장착되는 각 Rubin GPU가 완전한 구성품인 전체 Rubin을 갖추고 288GB의 HBM4를 사용할 수 있어야 함을 요구합니다. 그러나 2.0TB 구성을 의미한다는 것은 각 GPU가 약 250GB의 HBM4만 필요하다는 뜻입니다. 이는 다시 말해, GPU의 8개 HBM4 메모리 스택 중 단지 7개만 필요함을 의미합니다.
결과적으로 NVL8은 전체 Rubin 제품군 중에서 가장 큰 메모리 대역폭 감소를 겪게 되었습니다. 메모리 대역폭이 단순히 11%가 줄어드는 것이 아니라, 약 46TB/second인 26%가 손실됩니다. 각 Rubin GPU는 250GB에서 252GB의 메모리를 사용할 수 있게 되어, GPU당 대역폭은 16.8TB/second입니다.
AIVRES Booth Tour NVIDIA HGX Rubin NVL8 AIVRES Booth Tour NVIDIA HGX Rubin NVL8
추론 성능(Inference performance)은 FP4 기준으로 400 PFLOPS로 변동이 없지만, FP4 학습 성능은 280 PFLOPS에서 270 PFLOPS로 감소했으며, FP8 학습 성능 역시 140 PFLOPS에서 130 PFLOPS로 유사하게 조정되었습니다. 8-way Rubin 시스템은 나머지 Rubin 라인업과 동일한 네트워크 대역폭 개선 효과를 얻습니다. 이 수치는 1.6TB/second에서 1.8TB/second로 증가했습니다.
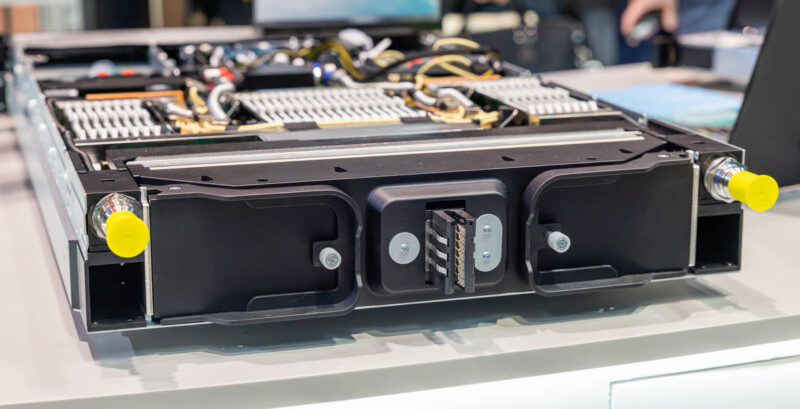
Aivres OCP Summit 2026 HGX Rubin NVL8 Compute Tray 6 Aivres OCP Summit-2U Liquid-Cooling NVIDIA HGX Rubin NVL8 AI Compute Tray 14
마지막으로, 이러한 변경 사항은 HGX NVL8의 두 버전뿐만 아니라 NVL8 플랫폼을 기반으로 하는 DGX 시스템에도 영향을 미칩니다. HGX Rubin NVL8(Rubin + x86 CPU)과 HGX Vera Rubin NVL8(Rubin + Vera) 모두 동일한 GPU 변경 사항의 적용을 받습니다.
최종 단어
NVIDIA는 목표하는 규모로 제품을 시장에 출시하기 위해 Rubin GPU의 야심찬 계획들을 조정할 수밖에 없었던 것으로 보인다. 이 과정에서 GPU HBM4 메모리 대역폭과 NVLink 네트워킹 대역폭 모두를 낮추었다. 이러한 변경 사항들이 모든 워크로드(workloads)에서 동일한 방식으로 메모리나 네트워킹 대역폭에 병목 현상(bottlenecked)을 일으키는 것은 아니기 때문에, 현재로서는 이 변화들의 전체적인 영향은 불분명하다. 어떤 면에서는 학문적 논의 수준일 수 있는데, 왜냐하면 이러한 변경 사항들이 첫날부터 출하되는 모든 Rubin 하드웨어에 적용되기 때문이다. 그럼에도 불구하고, 향후 몇 분기 동안 많은 NVIDIA Rubin이 배치될 것이다.