AI 연산에 대한 수요는 이미 끝이 없으며, 누구나 잠재적으로 미세 조정(fine-tune)하고 서비스할 수 있는 Kimi K3와 같은 프런티어급(frontier-class) 오픈 모델의 등장 이후 더욱 성장할 것으로 보입니다. 이러한 배경 속에서, Microsoft와 AMD는 내부 및 외부 용도 모두를 위해 Redmond에 더 많은 AI FLOPS를 확보하고자 협력하고 있습니다. 두 회사는 오늘 아침, Microsoft가 자체 데이터 센터의 프런티어 모델 워크로드(workload)를 실행하기 위해, 그리고 Azure AI 인프라 고객 및 서비스를 위해 AMD의 Helios 랙 스케일 AI 가속기를 대량으로 추가하기로 약속했다고 발표했습니다.
TH Premium과 함께 더 깊이 알아보기: AI 및 데이터 센터
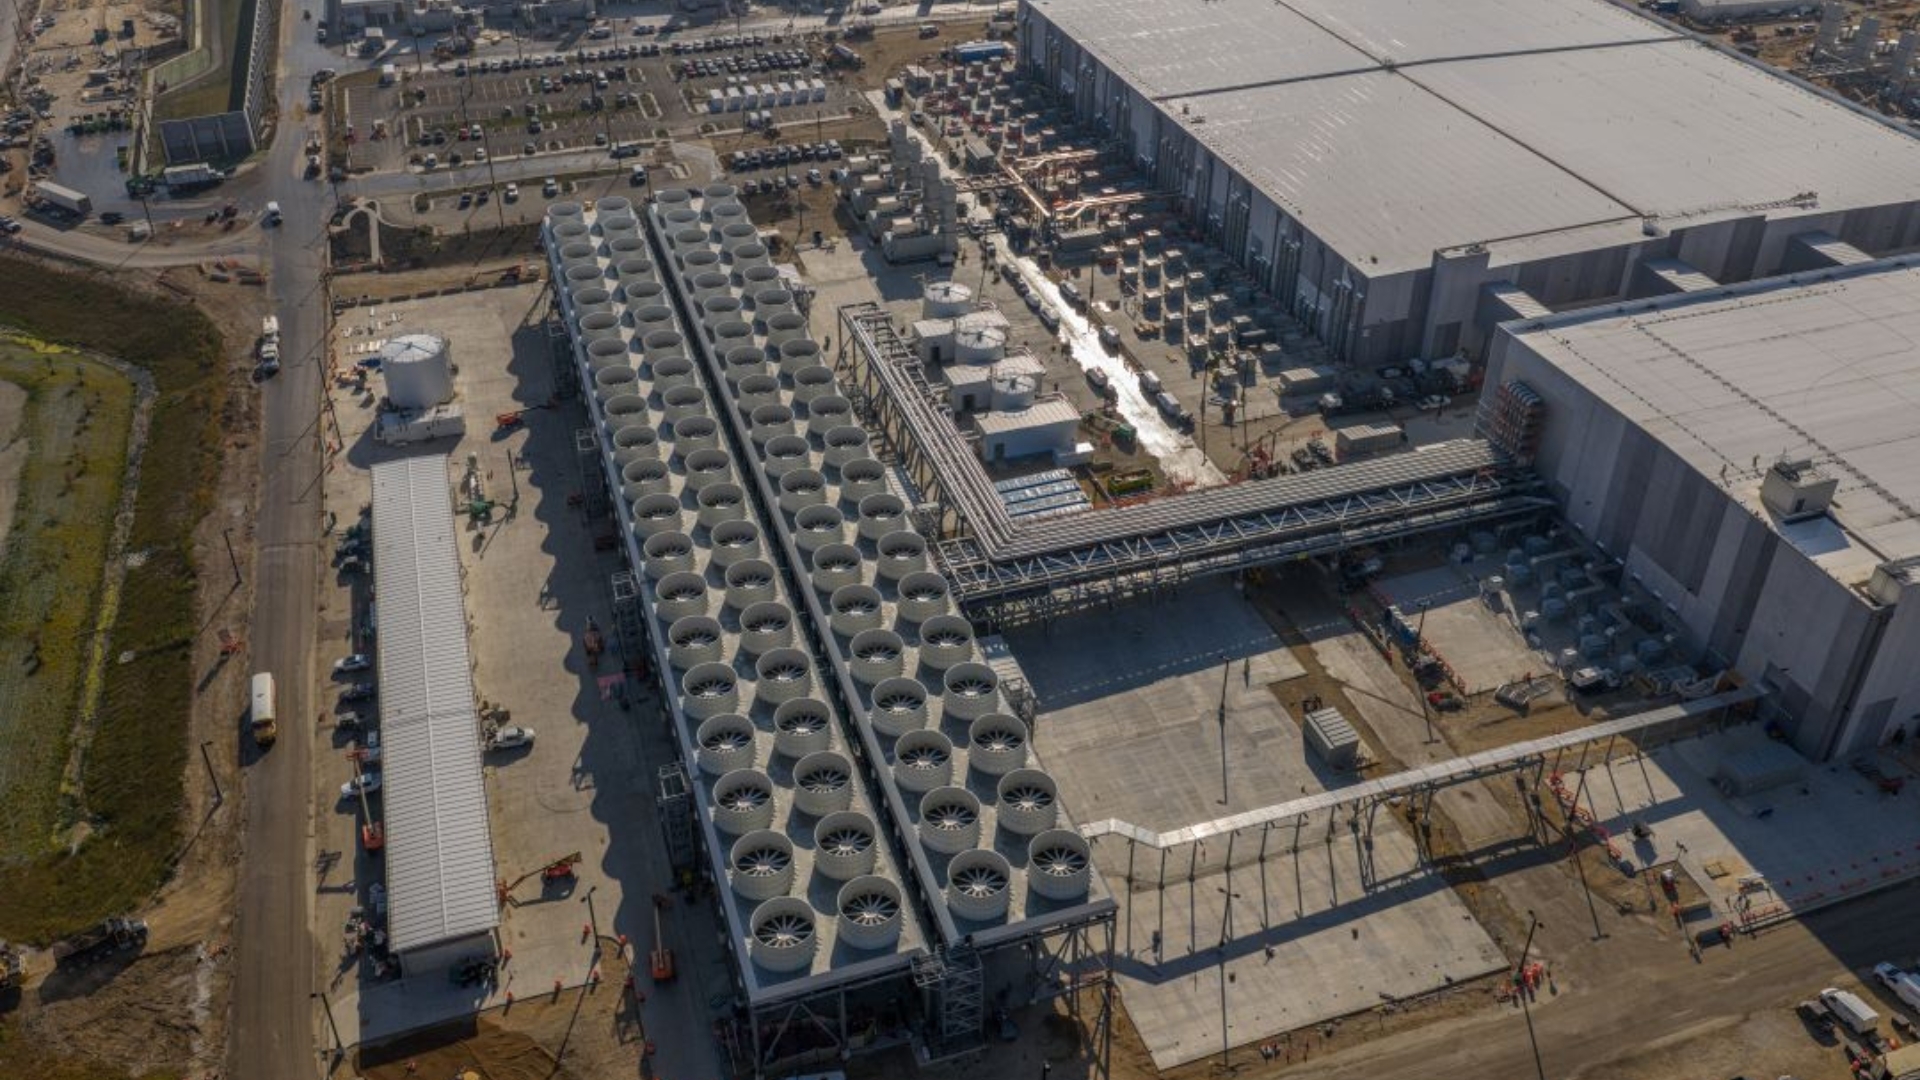
Microsoft data center in Mount Pleasant, Wisconsin
(이미지 출처: Microsoft)
이 파트너십은 차세대 AMD AI 컴퓨팅을 Azure 고객들에게 AI 학습 및 추론 서비스 워크로드를 위한 AI 연구소(AI labs)와 같은 곳에 제공하며, Microsoft Foundry를 통해 AI 워크로드를 배포하려는 기업 고객들을 위한 관리형 컴퓨팅의 기반도 될 것입니다.
두 회사는 Microsoft의 Helios 배치 규모를 와트나 달러 단위로 정확히 밝히지는 않았지만, 이 약속은 Nvidia로부터 데이터 센터 GPU 점유율을 확보하려는 AMD에게 또 다른 큰 승리가 될 것으로 보입니다. AMD는 지난 1년 동안 OpenAI 및 Meta와 거대한 파트너십을 체결했으며, 수 기가와트(gigawatts)의 컴퓨팅 설치 규모와 수천억 달러가 걸려 있습니다 AMD has struck massive partnerships with OpenAI and Meta.
빠른 복습을 위해 말씀드리자면, Helios 랙 스케일 가속기는 올해 후반에 출시될 예정인 Nvidia의 Vera Rubin NVL72 시스템와 경쟁할 것입니다. Helios는 72개의 차세대 Instinct MI455X GPU를 결합하며, 시스템 전체에서 총 31.1TB의 HBM4 메모리 용량을 제공합니다. 이 GPU들은 해당 OCP AI 데이터 타입을 사용하는 AI 모델에 대해 최대 1.4 exaFLOPS의 FP8 컴퓨팅과 2.9 exaFLOPS의 FP4를 제공합니다.
AMD는 랙 내에서 Nvidia의 Vera Rubin NVL72 랙 스케일 시스템과 동등한 수준인 260 TB/s의 스케일업(scale-up) 대역폭을, 그리고 Ethernet을 통한 UALink를 사용하여 약 두 배에 달하는 43 TB/s의 스케일아웃(scale-out) 대역폭을 목표로 하고 있습니다. 다만, 실제 환경에서 Ethernet을 통한 UALink의 성능은 아직 지켜봐야 할 부분입니다.
Microsoft와 AMD는 또한 Azure가 AMD의 차세대 6세대 Epyc Venice CPU를 기반으로 두 가지 새로운 VM 시리즈, 즉 '에이전트 AI 및 데이터 파이프라인'을 위한 HDv2 시리즈와 반도체 설계 워크플로우를 위한 HXv2 시리즈를 추가할 것이라고 발표했습니다. Microsoft는 또한 기존의 AMD Pensando DPU 배포를 활용하여 해당 하드웨어를 Azure Boost 서비스에 통합함으로써 네트워킹 및 스토리지 처리 작업을 가속화할 예정입니다.
_Tom’s Hardware_는 이번 주 AMD의 Advancing AI 이벤트 현장에 나가, 여기서 올해 후반기 이후 AMD의 AI 야심작에 대해 더 많은 것을 배울 수 있기를 기대합니다. 저희의 해당 행사 취재를 계속 지켜봐 주십시오.