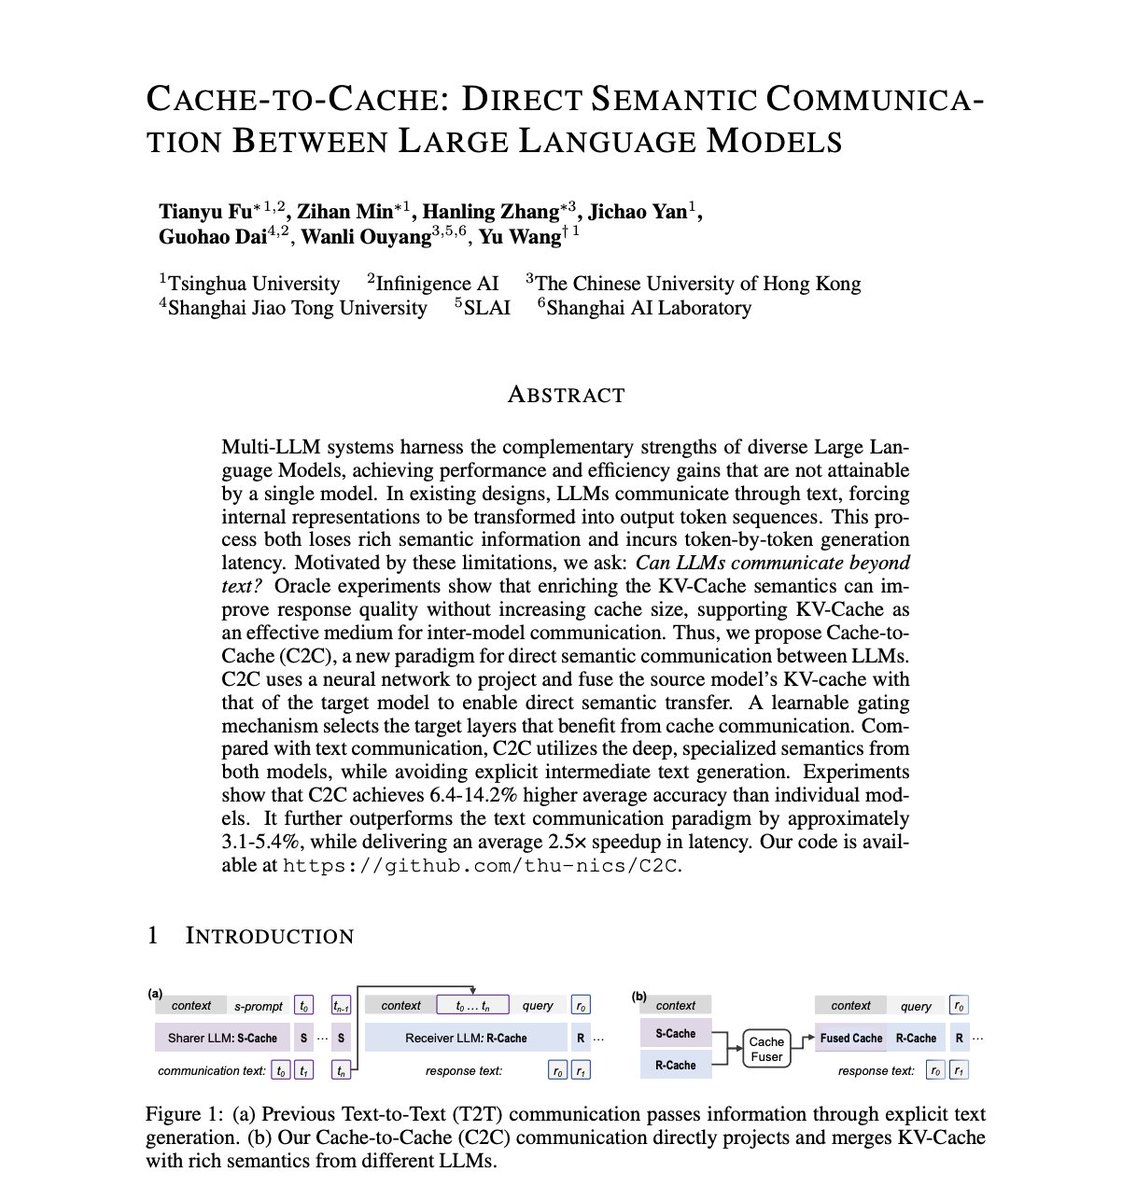
LLMs가 단어 없이 서로 대화할 수 있게 되었습니다.
요약
중국 연구진이 LLM 간의 통신 방식을 혁신한 Cache-to-Cache (C2C) 통신 패러다임을 공개했습니다. 이 방식은 텍스트 토큰을 거치지 않고, 신경망을 통해 소스 모델의 'kv-cache'를 타겟 모델로 직접 투영하고 융합하여 의미 손실과 지연 시간을 극복합니다.
핵심 포인트
- 단어 출력 없이 캐시를 직접 전송하는 C2C 통신 방식 도입
- 텍스트 기반 에이전트 대비 정확도 최대 14.2% 향상
- 중간 텍스트 생성 지연 시간 및 토큰 단위 지연 시간 회피
- 기존 방식 대비 전체 속도 2.5배 향상
중국 연구진이 LLM들이 단어 하나를 생성하지 않고도 통신할 수 있게 하는 새로운 패러다임을 오픈소스로 공개했습니다.
이를 Cache-to-Cache (C2C) 통신이라고 부릅니다.
현재 여러 AI 에이전트가 함께 작업할 때, 그들은 메시지를 전달하기 위해 내부의 '사고'를 인간 텍스트 토큰으로 번역하도록 강요받습니다. 이 과정에서 풍부한 의미론적 의미(semantic meaning)가 손실되고 엄청난 토큰 단위 지연 시간(latency)이 발생합니다.
그래서 C2C는 단어를 출력하는 대신, 신경망을 사용하여 소스 모델의 'kv-cache'를 타겟 모델로 직접 투영하고 융합합니다. 이는 순수하고 직접적인 의미론적 통신입니다. 심지어 캐시 전송으로 가장 큰 이점을 얻는 레이어를 정확하게 선택하기 위해 학습 가능한 게이팅 메커니즘(learnable gating mechanism)까지 추가했습니다.
벤치마크 결과는 정말 놀랍습니다:
- 모든 중간 텍스트 생성 지연 시간을 회피합니다.
- 개별 모델 대비 정확도가 최대 14.2% 향상됩니다.
- 기존의 텍스트 기반 에이전트 통신보다 5% 이상 우수합니다.
- 전체 속도에서 무려 2.5배의 속도 향상을 제공합니다.
우리는 말 그대로 LLM들이 인간 언어를 우회하여 자신들만의 조용하고 고속인 신경망을 구축하는 것을 지켜보고 있습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 X 토픽: Benchmark의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기