LLM Context Benchmarks
다양한 추론 엔진(Ollama (API & CLI), MLX, MLX Distributed, MLX-VLM, llama.cpp, LM Studio, Exo, Apple Foundation Models Serve, vMLX, oMLX, Paroquant, SGLang, vLLM, 그리고 모든 OpenAI 호환 엔드포인트)에 걸쳐 컨텍스트 크기(0.5k–128k tokens)별 프롬프트 처리 및 생성 처리량 벤치마크
Apple Silicon에 최적화되었지만 Python이 실행되는 모든 곳에서 작동합니다.
설치 (Installation)
curl -LsSf https://astral.sh/uv/install.sh | sh
...
엔진별 설정:
| 엔진 (Engine) | 설정 (Setup) |
|---|
| Ollama | Ollama 설치, ollama pull <model> |
| ... | |
| (선택 사항) Black + isort를 위한 pre-commit hooks: | |
웹 UI (Web UI)
CLI에서 수행하는 모든 작업은 로컬 웹 UI에서도 사용할 수 있습니다. 라이브 진행 상황을 보여주는 스윕 실행, 이름 지정된 엔드포인트, 저장된 결과 탐색, 그리고 모든 실행 세트 간의 대화형 비교 기능이 제공됩니다:
uv run benchmark-webui
uv run benchmark-webui --host 0.0.0.0 --port 9000 --no-open
- 실행 (Run) — 엔진, 컨텍스트 및 옵션을 선택하고, 각 컨텍스트별 프롬프트/생성 속도를 실시간으로 확인합니다. MLX 엔진은 Apple Silicon이 없는 장치(예: NVIDIA 박스)에서는 자동으로 비활성화됩니다.
- 엔드포인트 (Endpoints) — 이름 지정된 추론 대상(
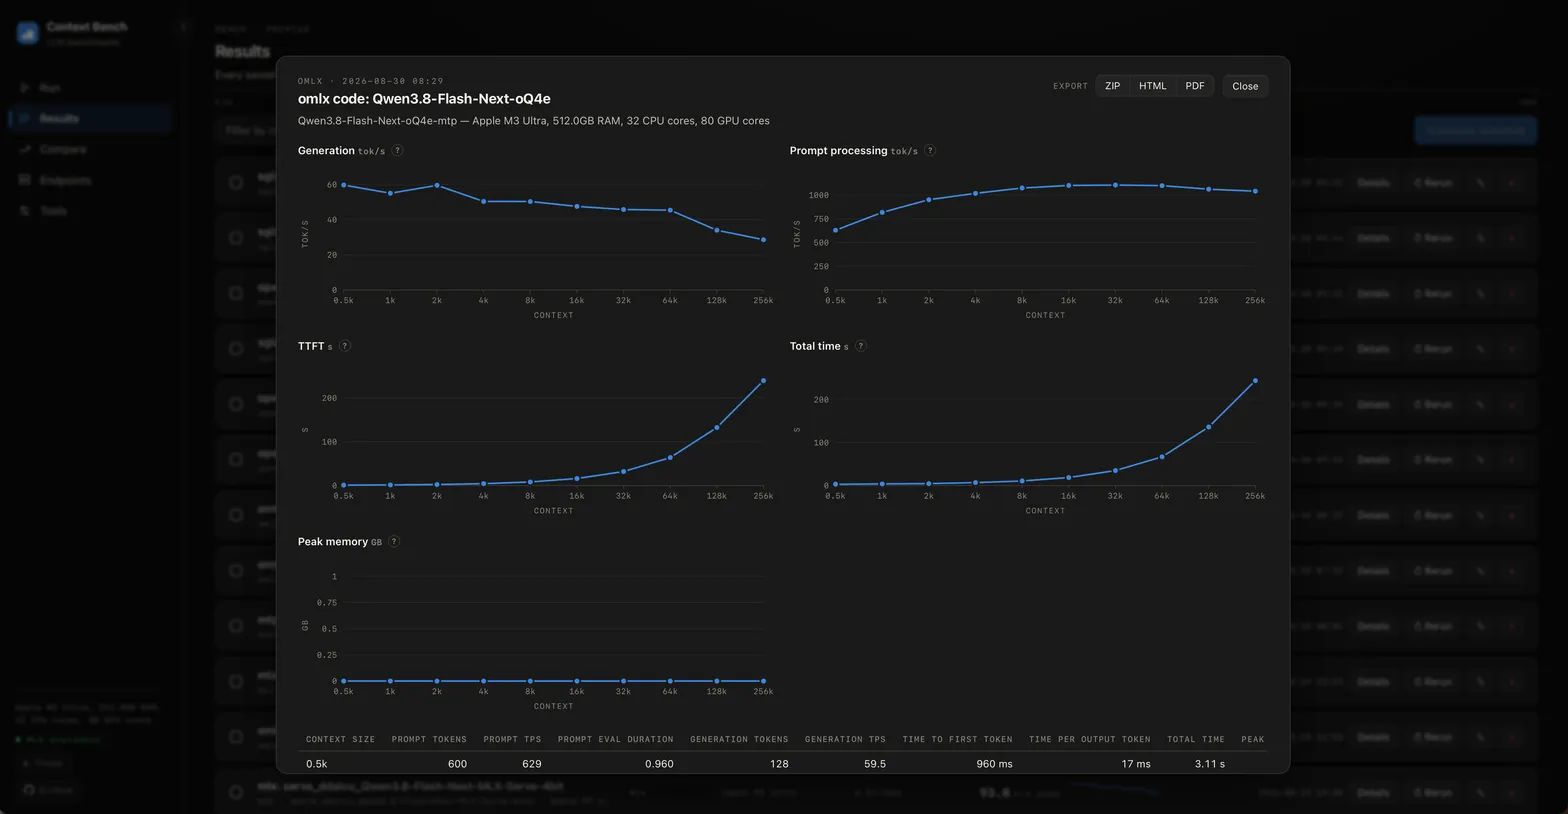
실행 상세(Run detail) — 실행별 지표 차트와 전체 결과 테이블을 제공하며, ZIP / HTML / PDF 형식으로 내보내기 가능합니다:**
Run detail view — charts and metrics table
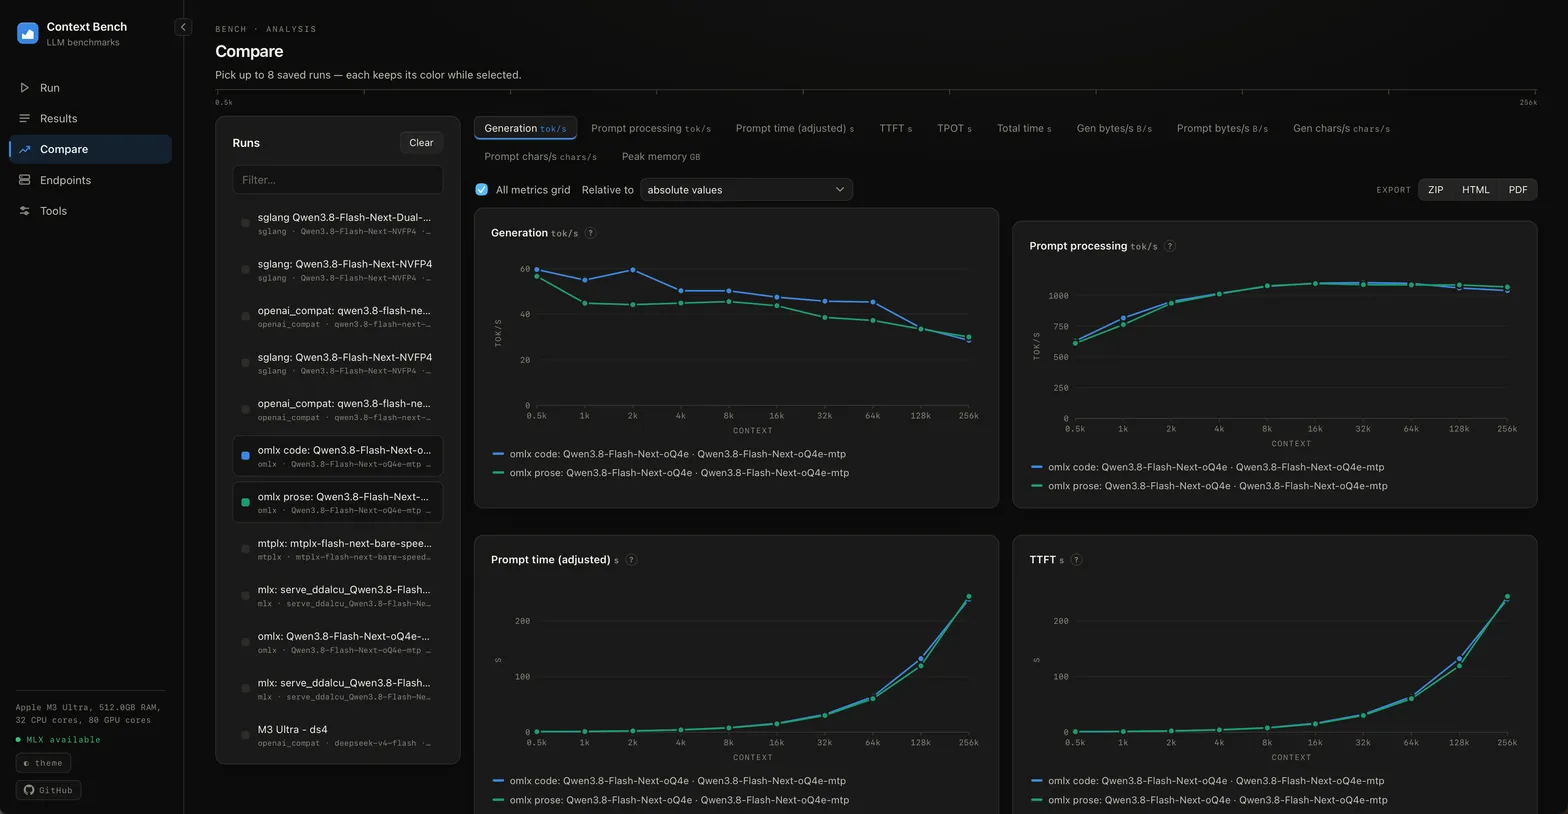
비교(Compare) — 최대 8개의 실행 결과를 모든 지표에 걸쳐 나란히 비교할 수 있으며, 모든 지표 그리드와 상대적 비교 모드를 지원합니다:**
Compare view — multi-run metric charts
마스터/워커: 여러 장치에서 집계된 결과
WebUI를 실행하는 모든 장치가 마스터(master) 역할을 할 수 있습니다. 워커는 두 가지 유형이 있습니다: benchmark-worker CLI, 또는 — 관리하기 더 쉬운 — 자체 WebUI를 실행하는 워커 장치를 --master 옵션과 함께 사용하는 방식입니다. 이 경우 로컬에서 실행을 시작하고 모니터링할 수 있으며, 모든 실행 결과가 실시간으로 마스터에 미러링됩니다. 두 경우 모두 벤치마크는 워커에서 로컬로 실행되며, 콘솔 출력은 일반적인 라이브 카드(진행 상황 표시기, tPS)로 마스터에 스트리밍되고, 모든 결과 파일은 작성되는 즉시 마스터의 output/ 폴더에 업로드됩니다. 워커는 자체 로컬 사본을 유지하므로 미러링이 벤치마크를 방해하지 않으며, 실행 도중 다운되거나 재시작된 마스터는 자동으로 재시도/재연결됩니다. 정지(Stop) 기능은 양방향으로 작동합니다: 마스터의 정지 버튼이 워커의 벤치마크를 종료시키고, 로컬에서 중지하면 마스터 카드가 정지 상태로 표시됩니다.
uv run benchmark-webui --host 0.0.0.0
uv run benchmark-webui --host 0.0.0.0 --worker-token s3cret
...
```bash
docker compose up -d
docker compose logs -f webui
docker compose down
docker compose up -d --build
이 컨테이너는 순수한 벤치마크 클라이언트(~400 MB)입니다. 웹 UI와 HTTP 클라이언트 라이브러리만 포함하므로, 추가하는 원격 엔드포인트를 벤치마킹합니다...
uv run benchmark --list-engines
uv run generate-context-files pride_and_prejudice.txt
uv run benchmark mlx mlx-community/Qwen3-4B-Instruct-2507-4bit
uv run benchmark ollama-api gpt-oss:20b
uv run benchmark llamacpp gpt-oss:20b --host localhost --port 8080
uv run benchmark afms system --contexts 0.5,1,2,3.6
uv run benchmark afms pcc --contexts 0.5,1,2,4,8,16,32
uv run openai-benchmark --model llama3.2 --base-url http://localhost:11434/v1
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
공통 옵션:
...
```bash
# output/의 모든 내용 자동 검색:
uv run compare-benchmarks

# 특정 폴더 비교:
uv run compare-benchmarks output/benchmark_ollama_* output/benchmark_mlx_*

# 사용자 지정 출력 디렉토리:
uv run compare-benchmarks --output my_comparison
comparison_chart.png, comparison_results.csv, comparison_table.txt와 각 엔진별 히트맵이 생성됩니다.
...
uv run compare-benchmarks --kl-baseline output/benchmark_mlx_<bf16-run>
출력:
...
llm_context_benchmarks/
├── benchmark.py              # 통합 CLI 디스패처
├── benchmark_common.py       # 공유 유틸리티 (하드웨어, 차트, CSV 등)
├── compare_benchmarks.py     # 다중 실행 비교
├── generate_context_files.py # 토큰 단위 컨텍스트 파일 생성
├── kl_capture.py             # 로그 확률 캡처 + KL 발산 (MLX, llama.cpp)
├── <engine>_benchmark.py     # 엔진별 단일 파일 (mlx, llamacpp, ollama_*, …)
├── pyproject.toml            # uv 관리 종속성
└── output/                   # 타임스탬프가 찍힌 결과 디렉토리
요구사항
...
pre-commit install
pre-commit run --all-files
벤치마크 결과 PR은 환영합니다. 이는 크로스 하드웨어 그림을 만드는 데 도움이 됩니다.
output/ 폴더는 gitignore에 포함되므로, 커밋하기 전에 해당 폴더 이름을 하드웨어를 포함하도록 변경하거나(.gitignore 파일에) 화이트리스트 처리해야 합니다 (예: benchmark_m3_ultra_512gb_mlx_qwen3_4bit).