
lenet5-accelerator
요약
본 프로젝트는 LeNet-5 CNN 모델을 FPGA와 GPU를 활용하여 가속화하는 방법을 다룹니다. CPU 대비 FPGA가 실시간 추론에서 가장 빠르며, HLS(High-Level Synthesis) 과정을 통해 합성 가능한 C 코드를 생성하고 성능 최적화를 위한 다양한 기법들을 제시합니다.
핵심 포인트
- FPGA는 작은 배치 크기/실시간 추론에 가장 적합하며, CPU 대비 월등한 속도를 보임.
- HLS를 사용하여 Keras 모델을 FPGA용 C 소스 파일로 변환하고 빌드하는 과정을 설명함.
- 성능 최적화를 위해 내부 루프 래핑, 파이프라이닝/분할, 메모리 접근 최소화 등의 기법을 적용해야 함.
lenet5-accelerator
이 프로젝트는 Computer Architecture 특강의 최종 과제로, 간단한 CNN인 LeNet-5를 가속화하기 위해 FPGA와 GPU를 사용합니다. 각각 HLS와 Cuda가 사용되었습니다.
하드웨어 정보:
- CPU: Intel(R) Core(TM) i7-2600 CPU @ 3.40GHz
- 지연 시간 (latency) = 1.59ms/추론
- GPU: GeForce GTX 970
- 지연 시간 (latency) = 3.3ms (배치 크기(batch size) 100 기준)
- FPGA: Xilinx Kintex Ultrascale
- 지연 시간 (latency) = 0.54ms/추론
실시간 애플리케이션이나 작은 배치 크기의 추론에는 FPGA가 가장 빠릅니다.
HLS
준비된 코드를 사용하여 HLS 프로젝트 생성하기
- 이 리포지토리에서
vivado_hls -f build_prj.tcl을 실행하면 합성 가능한(synthesizable) 프로젝트를 얻게 됩니다.
또는 모델을 처음부터 준비하기...
keras_lenet.py를 실행하여 모델을 훈련시키고, 이 스크립트는 두 가지 파일인saved_model.json과saved_weights.h5를 생성합니다.- 이 리포지토리로 클론합니다. 여기는 훌륭한 프로젝트 hls4ml의 포크(fork)입니다.
cd hls4ml/keras-to-hls를 실행하여 새로운 디렉토리lenet5-model-files를 만들고, 생성된saved_model.json과saved_weights.h5파일을 넣습니다.python keras-to-hls.py -c keras-config.yml을 실행하면 HLS 프로젝트용 C 소스 파일이 생성됩니다.vivado_hls -f build_prj.tcl을 실행하여 HLS 프로젝트를 빌드합니다 (30~40분).- 많은 1'들이 출력될 것이며, 이는 올바른 추론(correct inferences)을 의미합니다. 0은 잘못된 추론(incorrect inference)을 의미합니다.
더 자세한 정보는 hls4ml 리포지토리에서 찾을 수 있습니다. 하지만 수동 최적화가 없는 상태로 생성된 프로젝트는 합성 불가능하거나 성능이 매우 떨어질 수 있습니다.
- 많은 1'들이 출력될 것이며, 이는 올바른 추론(correct inferences)을 의미합니다. 0은 잘못된 추론(incorrect inference)을 의미합니다.
테스트벤치 및 테스트 데이터
- 테스트벤치:
lenet5_test.cpp - 테스트 데이터:
test_images/(스크립트test_images/save_images.py에 의해 생성됨)
최적화 트릭
- 내부 루프를 함수로 래핑합니다. 예를 들어, 가중치 필터와 이미지 블록 간의 요소별 곱셈(elementwise multiplication)과 같이 합니다.
2차원 컨볼루션(convolution)의 경우, 가장 안쪽 두 개의 루프를 하나의 함수로 감싸 필터링을 재사용하고 파이프라인화할 수 있습니다.
- 동시에 파이프라이닝 및 분할(pipeline and partition):
for (int oh = 0; oh < CONFIG_T::out_height; oh++)
    for (int ow = 0; ow < CONFIG_T::out_width; ow++)
#pragma HLS pipeline
...
- 메모리 접근을 줄이기 위해 임시 변수(temporary variable)를 사용하여 누적 결과(accumulation result)를 저장합니다.
- 완전 연결 계층(fully-connected layers, 행렬-벡터 곱셈(matrix-vector multiplication))의 경우, 첫 번째 레벨 루프에 대해 파이프라인화를 적용합니다:
// keras (tf backend) uses transposed weight matrices
Product1: for(int ii = 0; ii < CONFIG_T::n_in; ii++) {
#pragma HLS PIPELINE
...
- 불필요한 평탄화(flatenning) 및 비평탄화(unflattening)를 제거하고, 한 계층의 출력 차원과 다음 계층의 입력 차원을 일치시킵니다.
- 루프 구조 내에서 너무 깊게 로컬 배열(local arrays)을 사용하지 않도록 합니다. 이는 큰 리소스 소비로 이어질 수 있습니다.
결과 (Results)
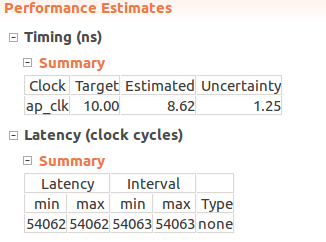
The 원래 정확도(accuracy)는 98.89%이며, 16비트 고정 소수점(fixed point)(softmax 계층 제외)을 사용했을 때 정확도는 98.87%가 됩니다. softmax 계층은 추가적으로 아주 작은 수준의 정확도 하락을 유발합니다.
- xcku095-ffvb2104-1-c
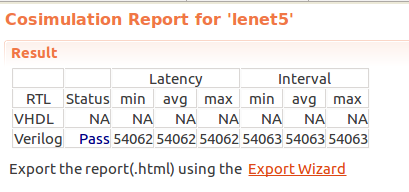
- 지연 시간(latency) = 간격(interval) = 54064 cycles * 10 ns/cycle
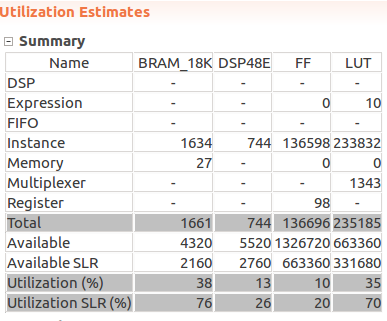
- 리소스 사용량 (resource usage)
- BRAM 49%
- DSP 96%
- FF 12%
- LUT 46%
- xcku115-flvb2014-2-e:
- 지연 시간(latency): 위와 동일
- 리소스 사용량 (resource usage)
- 공동 시뮬레이션 (co-simulation)
GPU
The GPU 코드는 gpu 아래에 위치합니다. gpu 디렉토리에서 make cpu 또는 make gpu를 실행하여 CPU 또는 GPU 버전의 코드를 빌드할 수 있습니다. 이 프로젝트에서 볼 수 있듯이, CPU/GPU 코딩 스타일은 HLS와 매우 다릅니다. 특히 컨볼루션(convolution) 부분이 그렇습니다.
가장 비용이 많이 드는 부분, 즉 두 번째 컨볼루션 계층은 3개의 가장 바깥쪽 루프를 3D 그리드(3D grids)로 대체하여 GPU로 가속화되었습니다.
결과
두 번째 컨볼루션(conv) 레이어를 제외하고는 나머지 모든 것이 호스트에 머무릅니다.
메모리 할당 및 커널 실행으로 인해 큰 오버헤드가 발생하기 때문에, 100회의 추론을 평균한 전체 지연 시간은 CPU보다 약간 나쁩니다 (3.50 vs 1.59ms/추론). 하지만 커널만 비교한다면, GPU는 CPU보다 약 20배 빠릅니다 (0.042ms vs 0.9ms). 이러한 이점은 동일한 매개변수를 사용하는 대량의 데이터가 존재하여 GPU로 사전 가져올 수 있을 때만 나타납니다.
향후 작업
NVIDIA에서 설명했듯이, CUDA 커널을 C++ 템플릿으로 구현하는 것도 가능합니다(이 블로그 게시물 참조).
Keras의 LeNet5
비교를 위해 Keras + TF로 평가를 수행했습니다:
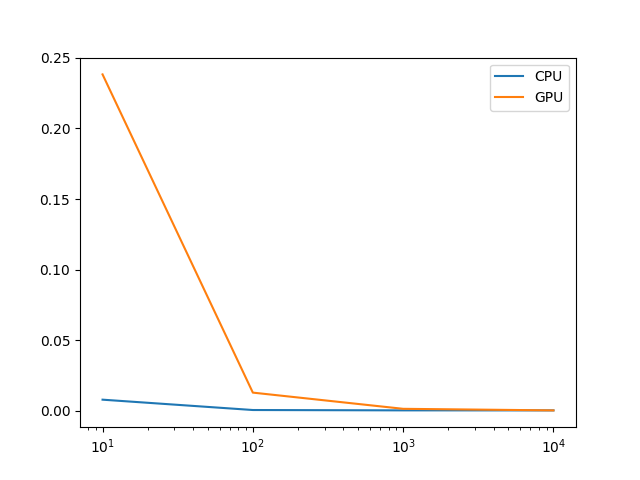
지연 시간 감소는 주로 제 노트북의 메모리 제한 때문에 평탄화됩니다. CPU/GPU 메모리가 충분히 크다면, 프레임워크 구현은 훨씬 더 나은 확장성을 보여줄 것입니다.
참고로 사용된 CPU/GPU는 위에서 언급한 Intel i7-7500 및 GeForce 940MX와 다르며, 이는 제가 자체 노트북에 환경을 설정했기 때문입니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub ML Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기