
LangSmith Fine-Tuning 소개
요약
새로운 LangSmith Fine-Tuning CLI인 `smithtune`이 출시되어 에이전트 트래젝토리를 파인튜닝 모델로 연결하는 엔드투엔드 워크플로우를 제공합니다. 이 도구는 데이터셋 생성, 학습(Fireworks/Baseten 사용), 평가까지 단일 CLI에서 처리하며, 사후 학습을 위한 지도 파인튜닝(SFT)을 지원합니다.
핵심 포인트
- `smithtune`은 LangSmith 트래젝토리를 활용한 엔드투엔드 파인튜닝 프로세스를 제공합니다.
- 데이터 준비부터 학습 및 평가까지 단일 CLI에서 모든 과정을 처리할 수 있습니다.
- 사용자 예시 기반의 SFT를 통해 특정 작업에 최적화된 전문 모델을 구축할 수 있습니다.
핵심 요약
-
LangSmith Fine-Tuning CLI와 스킬인
smithtune을 사용하세요. -
이를 통해 LangSmith에 저장된 에이전트 트래젝토리를 파인튜닝된 모델로 연결하는 엔드투엔드 워크플로우를 활용할 수 있습니다.
smithtune은 학습을 진행하는 것 외에도, 파인튜닝된 모델을 평가하고 그 결과를 LangSmith에 업로드하여 쉽게 분석할 수 있도록 처리합니다. 저희는 Fireworks 및 Baseten과 협력하여 LangSmith 트래젝토리와 두 플랫폼의 파인튜닝 데이터셋 생성 간의 원활한 연결을 구축했습니다.
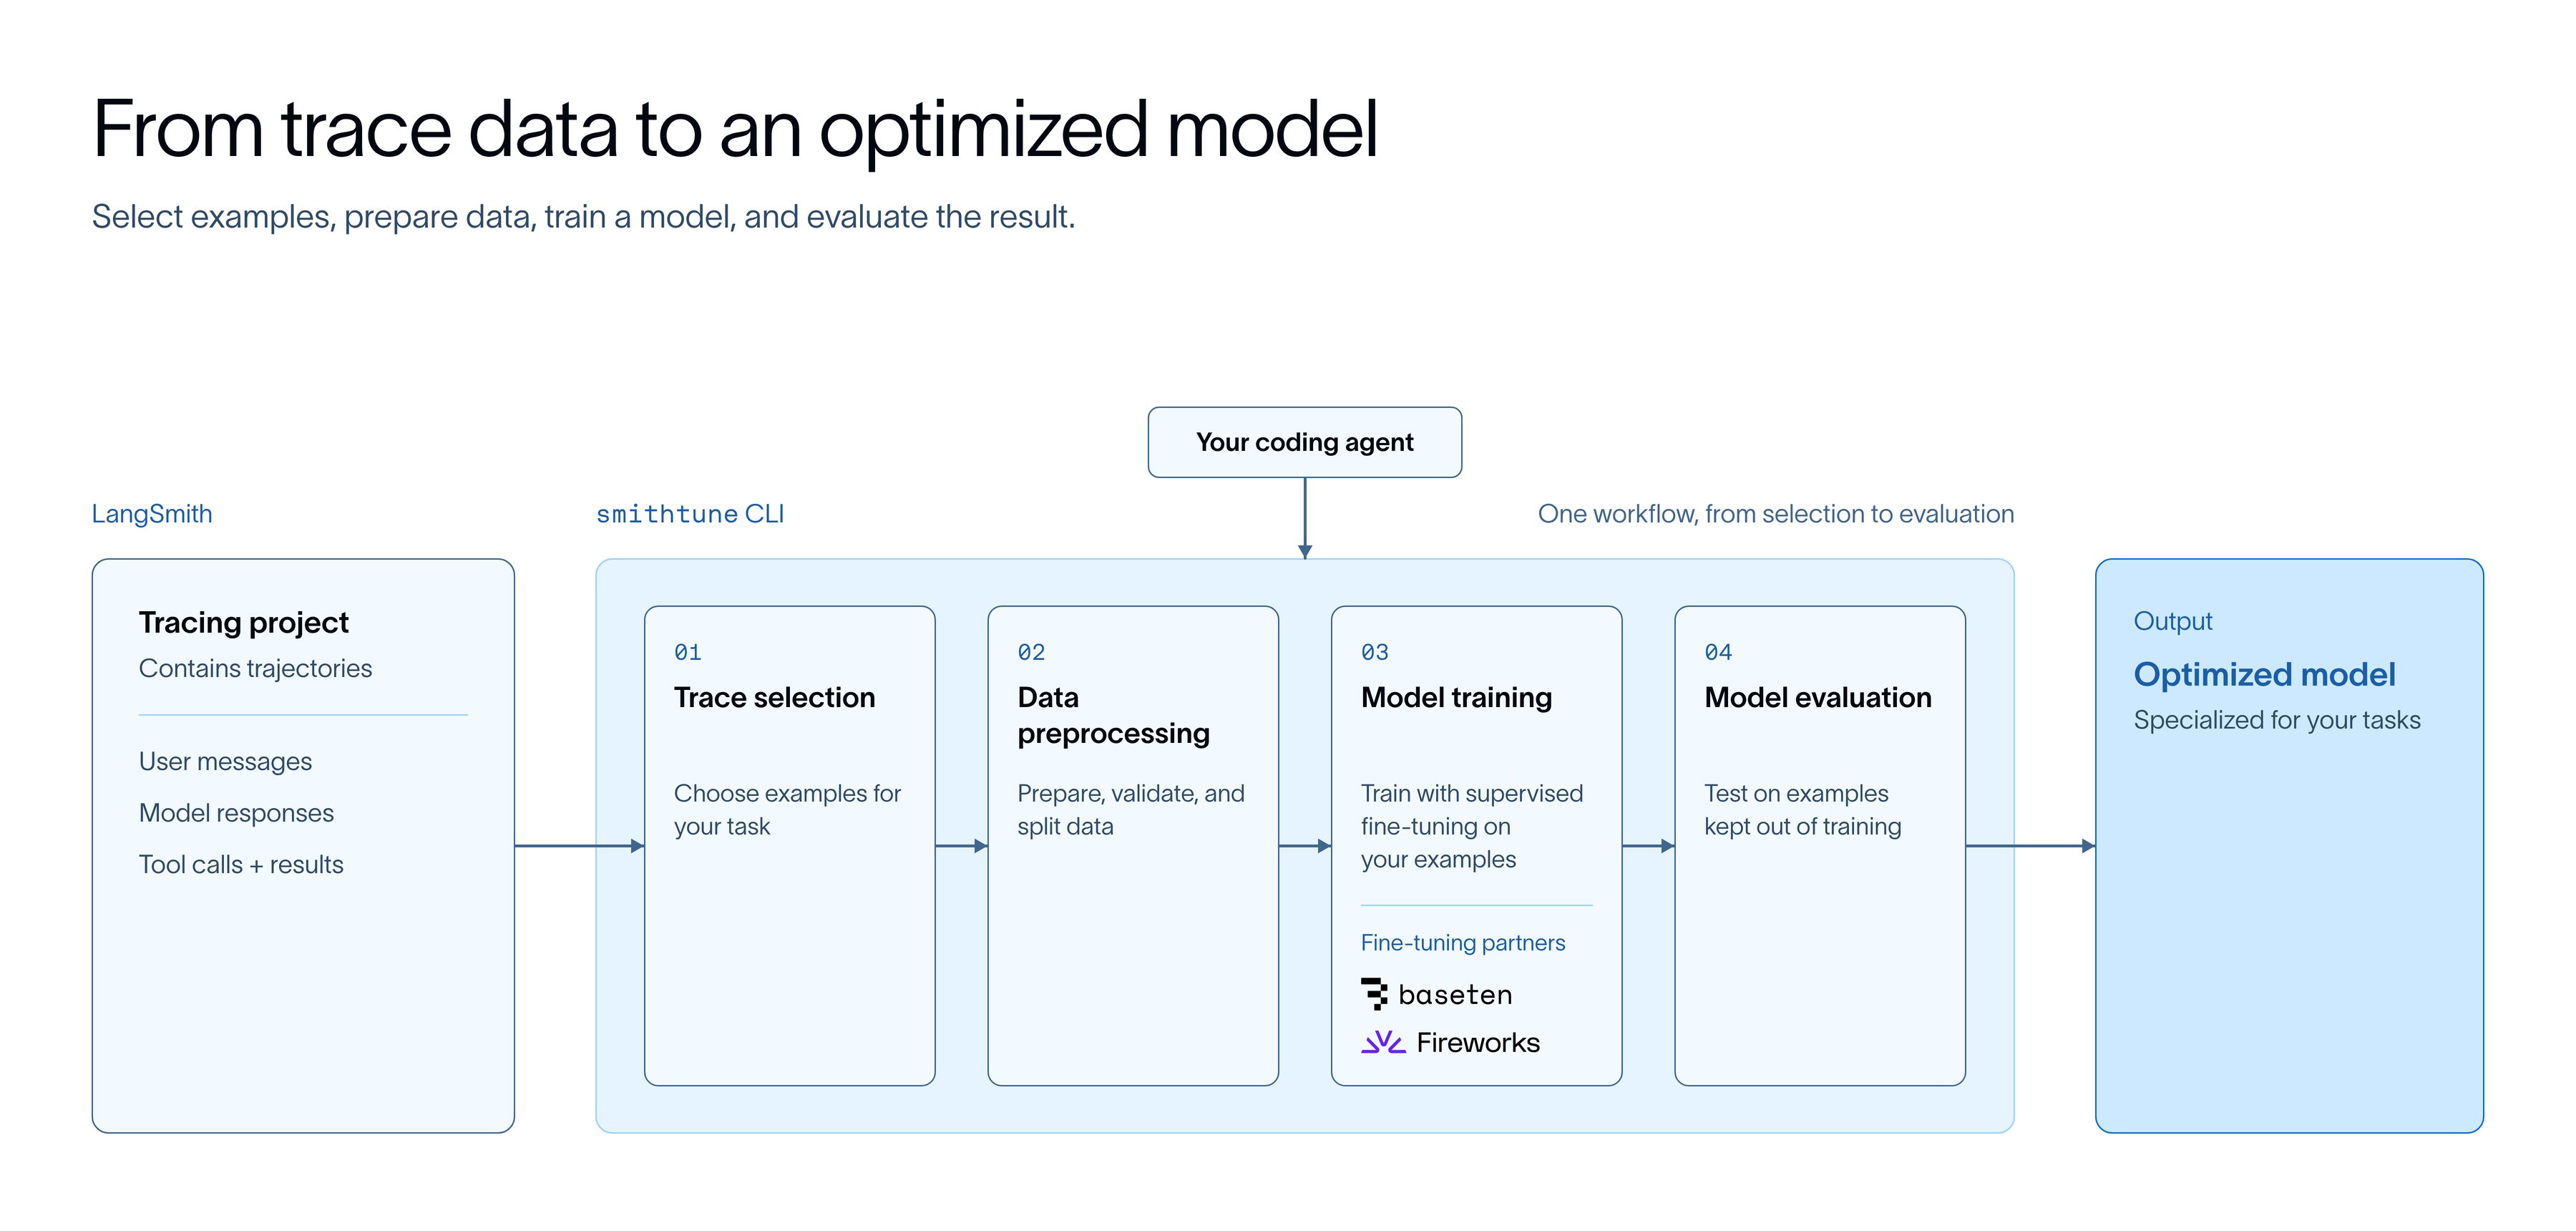
오늘 저희는 LangSmith Fine-Tuning과 팀이 LangSmith 트래젝토리를 자신들의 에이전트를 위한 맞춤형 파인튜닝 모델로 전환하는 데 도움을 주는 CLI인 smithtune을 출시합니다. 이 도구는 단일 CLI에서 전체 파인튜닝 프로세스를 처리합니다: LangSmith 트래젝토리로부터의 데이터셋 생성 및 준비, Fireworks 또는 Baseten을 사용한 학습, 그리고 LangSmith를 이용한 평가까지입니다. smithtune은 직접 실행하거나 코딩 에이전트와 협력하여 명령을 실행하고 결과를 검사할 수 있습니다.
smithtune은 사후 학습(post-training) 모델을 위해 구축되었습니다. 현재는 좋은 행동의 예시를 사용하여 모델을 훈련하는 지도 파인튜닝(Supervised Fine-Tuning, SFT)을 지원합니다. 사용자가 모델에 입력/출력을 제공하면, 모델은 그 행동을 모방하기 위해 모델 가중치를 업데이트하며 학습합니다. LangSmith 트래젝토리 데이터는 SFT를 지원하도록 설계되었으며, smithtune은 이러한 트래젝토리를 유용한 훈련 데이터로 전환하는 데 도움을 줍니다.
이를 통해 팀들은 데이터 파이프라인을 수동으로 구축할 필요 없이 전문화된 모델을 훈련할 수 있는 방법을 얻게 됩니다. 사용자의 예시를 기반으로 훈련된 모델은 종종 특정 작업에 대해 범용 프론티어 모델만큼 또는 그보다 더 잘 작동하며, 비용과 지연 시간 측면에서도 유리합니다.
GitHub에서 LangSmith Fine-Tuning을 사용해보고, 저장소에서 smithtune 스킬을 설치하여 코딩 에이전트가 파인튜닝 프로세스를 엔드투엔드로 구동하게 해보세요.
파인튜닝 이점의 가장 큰 동력 중 하나는 데이터 선택입니다. smithtune 출시와 함께
이 루프를 연결하는 것이 더 쉬워졌습니다. 즉, LangSmith에 있는 선별된 프로덕션 트레이스에서 관리형 학습 및 Fireworks에 배포되는 모델까지입니다. 팀들은 중간에 인프라를 구축할 필요 없이 데이터에서 학습으로, 그리고 배포로 원활하게 이동할 수 있습니다. 이것이 저희가 LangChain을 통해 구축하는 경로입니다.
– Pranav Jain, Product Lead at Fireworks
smithtune은 Baseten Loops와 통합되어 팀들이 데이터 수집부터 파인튜닝 실험 실행까지 몇 분 만에 진행할 수 있도록 합니다. 빌더들은 Loops가 제공하는 완전 관리형 학습 인프라를 통해 지속적으로 더 나은 데이터를 수집하고 선별하여 시간이 지남에 따라 더 나은 모델을 만들 수 있으며, 이를 통해 가장 중요한 고객 사용 사례 설계에 집중할 수 있습니다.
– Aaron Ellis-Bloor, Applied Researcher at Baseten
에이전트 트레이젝토리 및 후처리 학습
smithtune이 제공하는 기능들을 깊이 파고들기 전에, 먼저 에이전트 트레이젝토리에 대해 논의해 보겠습니다.
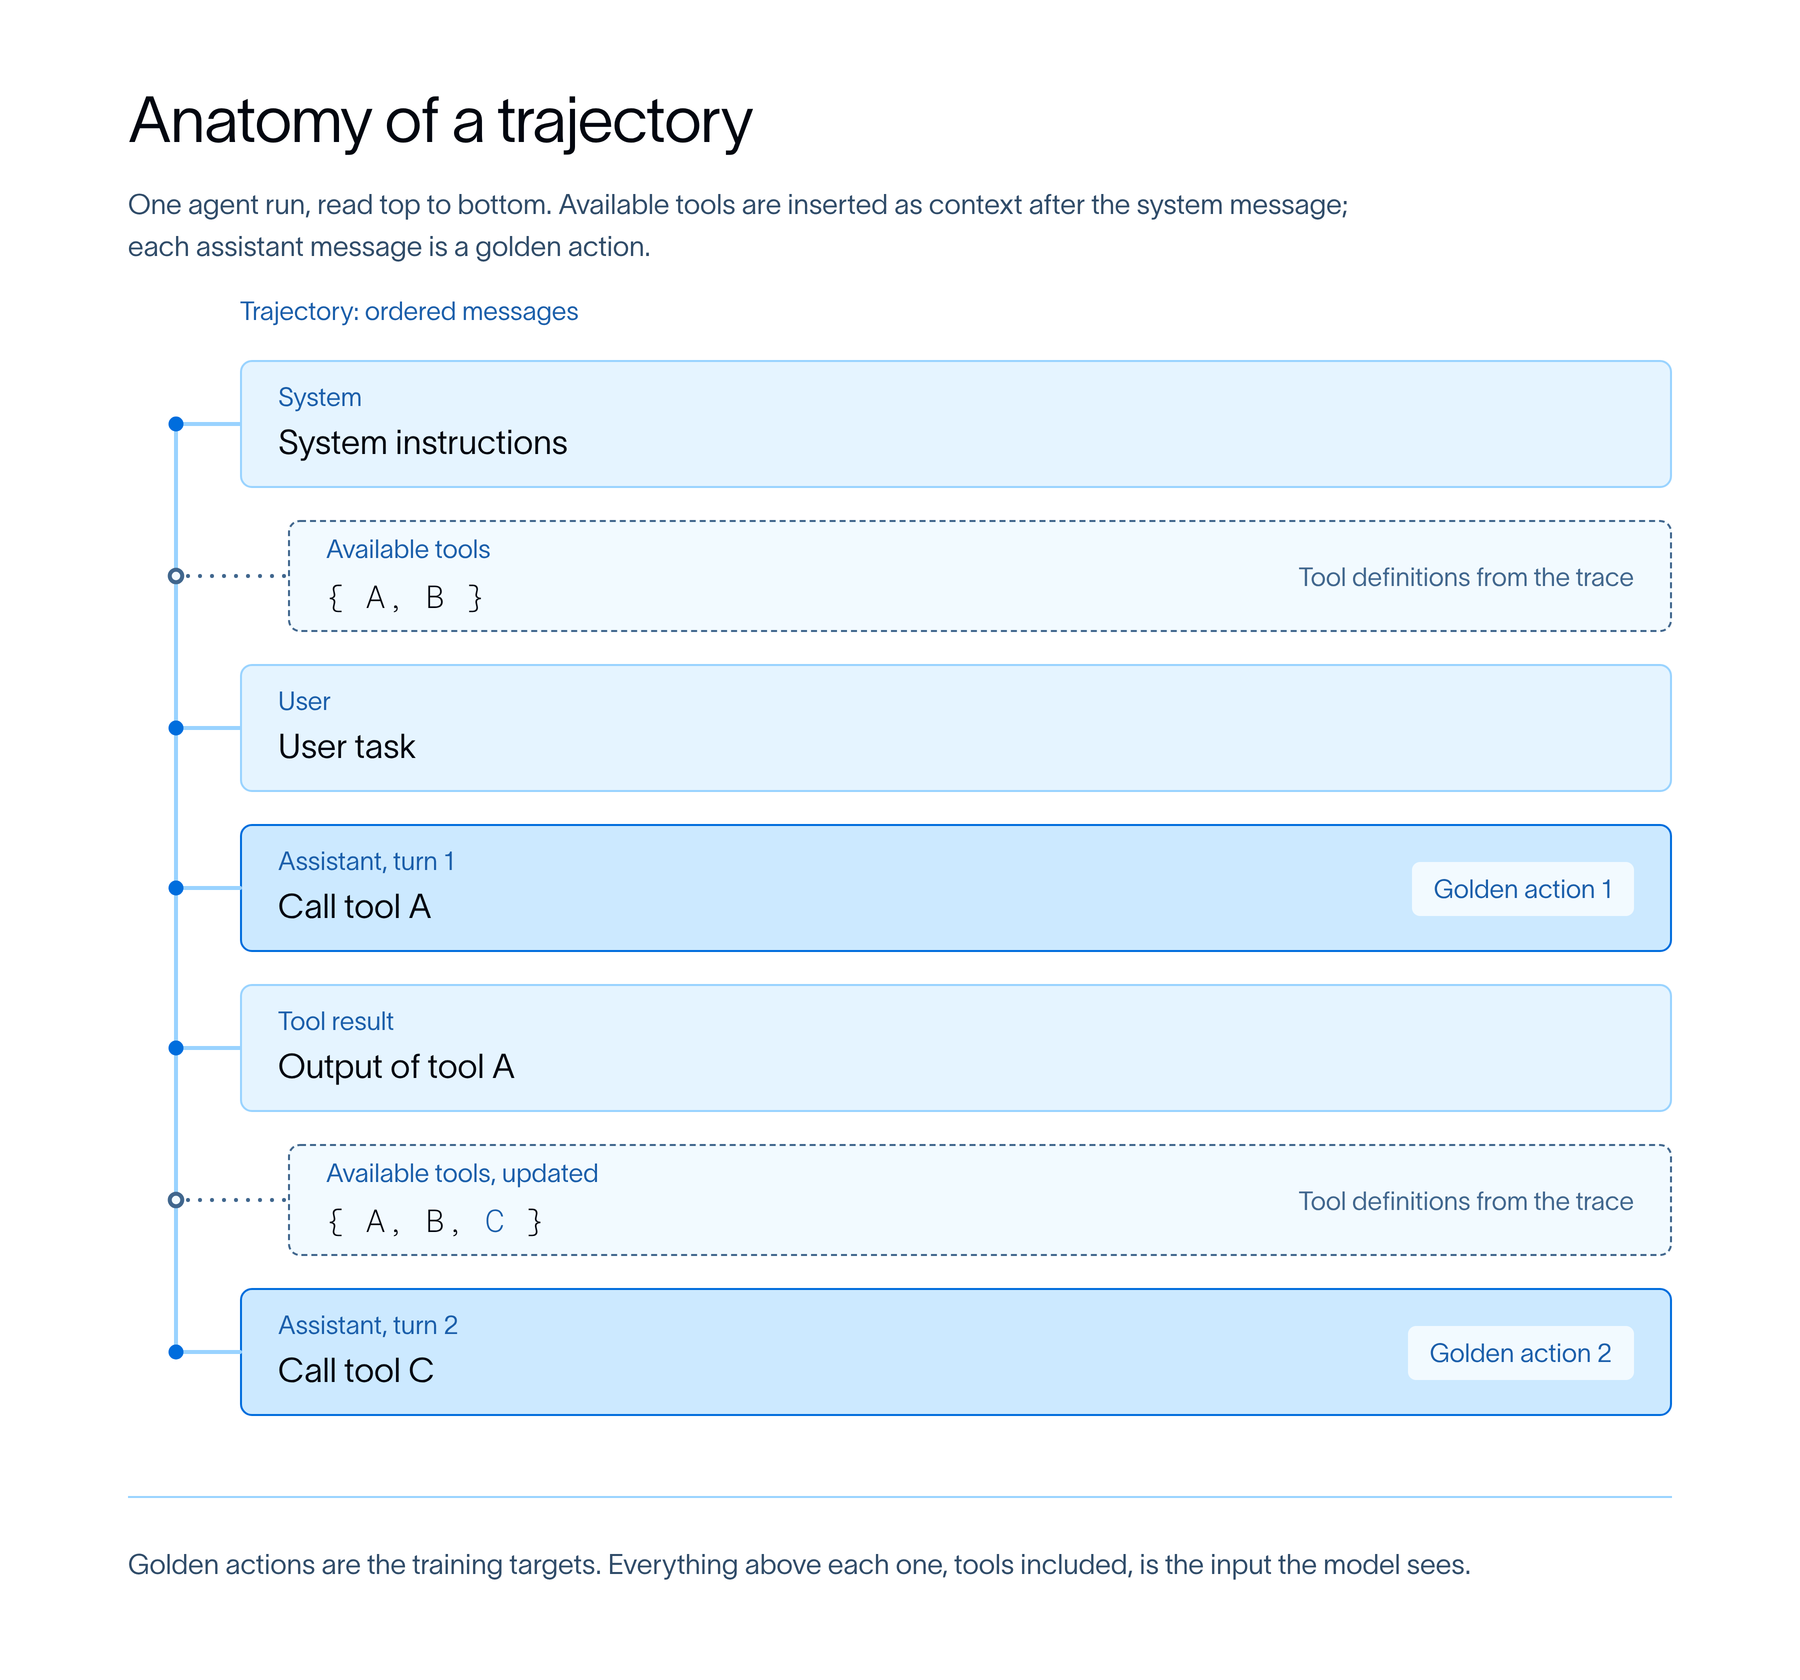
트레이젝토리(trajectory)는 에이전트가 작업을 수행한 방식을 보여주는 메시지, 도구 호출(tool calls), 및 도구 결과(tool results)의 순서화된 시퀀스입니다. LangSmith는 트레이스 또는 스레드에서 이 시퀀스를 조립하며, 지원되는 메시지 형식을 공통 표현으로 가져오고, 도구 정의를 보존하며, 중복된 기록을 제거합니다.
LangSmith의 트레이젝토리 형식은 후처리 학습(post-training)을 염두에 두고 설계되었습니다. SFT(Supervised Fine-Tuning)의 경우, 학생 모델(student model)은 교사 모델(teacher model)이 성공적인 결과를 생성했을 때 가졌던 정확한 컨텍스트가 필요합니다. 복잡하고 장시간 실행되는 에이전트에서는 에이전트가 작동함에 따라 도구 사용 가능 컨텍스트가 자주 변경되며 (예: 지연된 도구 로딩), 최종 메시지 목록을 단순하게 내보내면 이러한 미묘한 차이를 잃게 됩니다. LangSmith의 트레이젝토리 형식은 모델이 매 순간 무엇을 보았는지 정확하게 기록하므로, smithtune이 각 액션을 그 진정한 컨텍스트와 연결할 수 있습니다.
smithtune
워크플로우 전반에 걸쳐 트래젝토리(trajectories)를 사용합니다. 성공적인 예시 트래젝토리를 큐레이션하고, 선택한 모델을 위해 준비하며, 기록된 응답과 도구 호출(tool calls)을 기반으로 학습시킵니다. 학습 분할에서 제외된 트래젝토리는 평가를 위한 컨텍스트와 참조 액션을 제공합니다.
단계별 워크스루
데이터셋 구축 (Build your dataset)
데이터셋은 타겟 모델이 맞춰나갈 ‘골든(golden)’ 트래젝토리를 포함합니다. 이 데이터는 지도 미세 조정(supervised fine-tuning)의 기반입니다.
smithtune을 사용하여 데이터셋을 생성할 때 몇 가지 주요 단계가 있습니다:
데이터셋 가져오기 (Pull Dataset): smithtune은 LangSmith 추적 프로젝트에서 로컬 디렉토리 DIR로 트래젝토리를 필터와 함께 가져옵니다.
트레이스 레이블링 (Label Traces): smithtune은 인간(및 그들의 에이전트)과 협력하여 ‘좋은’ 트레이스의 특징을 파악하고, 이를 기반으로 루브릭(rubric)을 생성한 다음, 일련의 에이전트를 보내 SFT에 적합한 후보 트래젝토리를 검토하고 필터링합니다.
영구 데이터셋 저장 (Store a persistent dataset): smithtune은 학습에 사용되는 모든 데이터가 영구적인 아티팩트(artifact)로서 나중에 감사될 수 있도록 보장합니다. 합의된 골든 트래젝토리 세트를 LangSmith 데이터셋으로 업로드하여 학습 및 평가를 진행합니다.
이 과정에서 smithtune은 다음과 같은 세부 사항을 처리합니다:
- 주어진 시퀀스 길이를 초과하는 트래젝토리를 필터링하여 선택한 모델과 호환되도록 보장하는 작업
- 하위 스트림 평가(downstream evaluation)를 위해 데이터를 학습/검증/테스트 분할로 나누는 작업
모델 훈련 (Train a model)
훈련을 진행하기 전에, smithtune plan은 인간이 선택한 모델, 학습 예시의 수, 그리고 학습률(learning rate), 배치 크기(batch size), 에포크(epochs)와 같은 하이퍼파라미터(hyperparameters)와 같은 설정을 검토하는 데 도움을 줍니다.
smithtune train을 실행하여 미세 조정 작업을 시작하기 전에 이러한 설정을 조정할 수 있습니다. smithtune은 준비된 트래젝토리에서 LoRA 학습을 지원하는 Fireworks 관리 SFT 또는 Baseten Loops에 작업을 제출합니다. 사용자가 관리해야 할 GPU 프로비저닝이나 훈련 인프라는 없습니다. 훈련 중, smithtune
또한 검증 세트(validation set)의 성능을 확인하고, 가장 낮은 검증 손실(validation loss)을 가진 체크포인트(checkpoint)를 선택합니다.
결과 평가하기 (Evaluate the result)
훈련이 완료되면 smithtune evaluate를 실행하여 선택된 체크포인트를 기본 모델(base model)과 비교할 수 있습니다.
smithtune은 내장 재현 평가(built-in replay evaluation)를 사용하여 기본 모델 대 미세 조정된 모델을 테스트합니다. 모델은 골든 트랙토리(golden trajectory)로부터의 액션 완료 가능성에 대해 평가되며, 심사관(judge)이 해당 예측값을 실제 기록된 예제와 비교하여 점수를 매깁니다.
CLI는 LangSmith 비교 링크를 반환하며, 결과는 평가가 진행됨에 따라 나타납니다. 점수 비교, 개별 응답 및 도구 선택 검사, 그리고 미세 조정이 도움이 되었는지 또는 회귀(regressions)를 유발했는지 확인할 수 있습니다.
모델 배포하기 (Deploy your model)
평가 결과에 만족한다면, smithtune deploy를 사용하여 미세 조정된 모델을 서비스하고 애플리케이션에 연결합니다.
결과가 기대했던 바가 아니라면, 데이터셋을 개선하거나 훈련 설정을 조정한 후 다시 훈련하고 평가합니다. 코딩 에이전트(coding agent)와 함께 LangSmith에서 비교 내용을 검토하여 어떤 응답이나 도구 선택이 더 많은 작업이 필요한지 파악할 수 있습니다.
실제 적용 사례 결과 (Results from running this in practice)
저희 smithtune 플로우의 품질을 평가하기 위해, LangChain에서 자주 사용되는 두 에이전트에 이를 적용했습니다:
- Engine: 에이전트 트레이스(agent traces)를 분석하여 실패 지점을 찾고 관련 문제를 그룹화합니다. Engine에 있는 에이전트 중 하나를 간소화한 버전을 사용하여, SFT가 이러한 문제들을 식별하고 정리하는 능력을 향상시킬 수 있는지 테스트했습니다.
- OpenSWE Review: 실제 레포지토리의 코드 변경 사항을 검토합니다. SFT가 버그를 찾는 데 필요한 작업을 줄이면서도 리뷰 품질을 유지할 수 있는지 테스트했습니다.
Engine: 전문화를 통한 높은 작업 성능 (higher task performance through specialization)
Engine: 전문화를 통한 높은 작업 성능 (higher task performance through specialization)
저희는 좋은 트래젝토리(trajectories) 세트를 큐레이션하여 이를 기반으로 base Kimi K3를 파인튜닝했습니다. 기본 Kimi 모델은 이미 강력했지만, 저희는 harness engineering을 통해 그것이나 GPT-5.6 Sol을 더 끌어올릴 수 있는 능력을 소진한 상태였습니다. 파인튜닝된 모델은 내부 벤치마크인 IssueBench(이슈 탐지 및 그룹화용)의 일부 세트에서 base Kimi와 GPT-5.6 Sol 모두보다 높은 점수를 기록했습니다.
OpenSWE Review: 적은 호출로 유사한 품질 달성
저희는 또한 코드 리뷰 품질과 버그 탐지를 측정하기 위해 사용된 실제 풀 리퀘스트(pull requests) 내부 평가 세트에서 Qwen-3.8-27B를 평가했습니다. 이 비교에서 SFT를 통해 F1 점수가 48.9%에서 53.7%로 상승했으며, 모델 호출은 29.8% 적게, 도구 요청(tool requests)은 29.4% 적게 사용했습니다.
이전에 사용했던, 선택 기준이 낮은 학습 세트는 SFT 후 F1 점수를 떨어뜨렸습니다. 이에 저희는 데이터 큐레이션 파이프라인으로 돌아가 각 Trace에 리뷰 단계를 추가하고, 에이전트들이 잠재적 문제가 실제로 존재한다고 생각한 트래스를 오버샘플링(oversample)하는 방안을 모색했습니다.
실질적인 기회는 적은 모델 및 도구 호출로 유사한 리뷰 품질을 달성하는 것입니다. 이는 리뷰당 비용 절감과 PR당 더 빠른 검토 시간을 의미합니다.
후속 훈련 고려 사항 (Considerations for post-training)
SFT가 유용한 경우 (When SFT makes sense)
SFT는 애플리케이션이 반복적인 작업을 수행하고, 해당 작업의 행동 방식에 대한 예시를 가지고 있을 때 특히 유용합니다. 모델이 학습하기를 원하는 일관된 패턴(consistent patterns), 예를 들어 워크플로우 따르기, 다음으로 무엇을 할지 결정하는 데 도구 결과를 사용하기, 그리고 자신의 작업 검증과 같은 것을 찾아보세요.
저희는 팀들이 먼저 harness engineering을 시작하여 더 나은 harness가 좋은 성능을 제공하는지 이해할 것을 권장합니다. 만약 에이전트들이 여전히 특정 작업에서 반복적인 실수를 저지르고, 그 작업을 올바르게 수행하는 방법을 보여주는 트래젝토리가 있다면, SFT는 시도해 볼 훌륭한 후보입니다.
데이터 선택 (Data selection)
저희는 가장 성공적인 후속 훈련 실행(post-training runs)은 훈련을 위한 데이터 선택에 시간을 투자하는 것에서 나온다는 것을 일관되게 발견했습니다. smithtune
이는 사용자에게 에이전트와 함께 데이터를 검토할 수 있는 기능을 명시적으로 제공하며, 도메인 전문가가 에이전트와 협력하여 SFT(Supervised Fine-Tuning)를 위한 트레이스를 검토하는 것이 성공적인 사후 훈련 실행의 가능성을 높인다는 것을 발견했습니다.
LangSmith Fine-Tuning 시작하기
LangSmith Fine-Tuning이 현재 Public Beta로 제공됩니다. 시작하려면 다음이 필요합니다:
- 에이전트의 트레이스가 포함된 LangSmith 계정
- Fireworks 또는 Baseten용 API 키
smithtuneCLI
GitHub에서 smithtune을 사용해보고, 다음에 어떤 기능이 추가되기를 원하는지 알려주세요. LangSmith에서 파인튜닝 워크플로우를 계속 개선하는 데 여러분의 피드백을 받고 싶습니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 LangChain Blog의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기