
keys-SM121-Optimized-MiniMax-H3 + NVIDIA Sol-Engine + kijai SolAttn_Triton - 단일
요약
본 문서는 MiniMax-H3 모델을 NVIDIA DGX Spark (sm_121) 환경에서 최적화하여 실행한 결과를 보고합니다. Sol-Engine 가속 라인을 단일 GPU에 포팅하고 모든 커널을 검증했으며, 그 결과 5초 클립 처리 시간이 기존 대비 약 1.54배, 디노이징 단계당 1.72배 단축되었습니다. 이는 DGX Spark 사용자가 직면할 수 있는 잠재적인 소프트웨어 오류를 사전에 방지하고, 전체 워크플로우의 속도를 크게 향상시키는 데 초점을 맞추고 있습니다.
핵심 포인트
- MiniMax-H3 모델을 NVIDIA DGX Spark (sm_121)에서 최적화하여 실행함.
- 엔드투엔드 처리 시간이 기존 대비 1.54배, 디노이징 단계당 1.72배 단축됨.
- DGX Spark 환경에서 발생할 수 있는 잠재적인 소프트웨어 오류를 사전에 방지하는 방법을 제시함.
- 단일 스크립트 실행으로 복잡한 워크플로우의 조립 과정을 간소화함.
keys-SM121-Optimized-MiniMax-H3 + NVIDIA Sol-Engine + kijai SolAttn_Triton — single DGX Spark
MiniMax-H3 (33 B audio+video Omni-DiT)를 ComfyUI에서 하나의 NVIDIA DGX Spark (GB10, sm_121, 128 GB unified)에서 실행하며, NVIDIA의 Sol-Engine 가속 라인을 단일 GPU에 포팅하고 모든 커널을 이 아키텍처에서 수치적으로 검증했습니다.
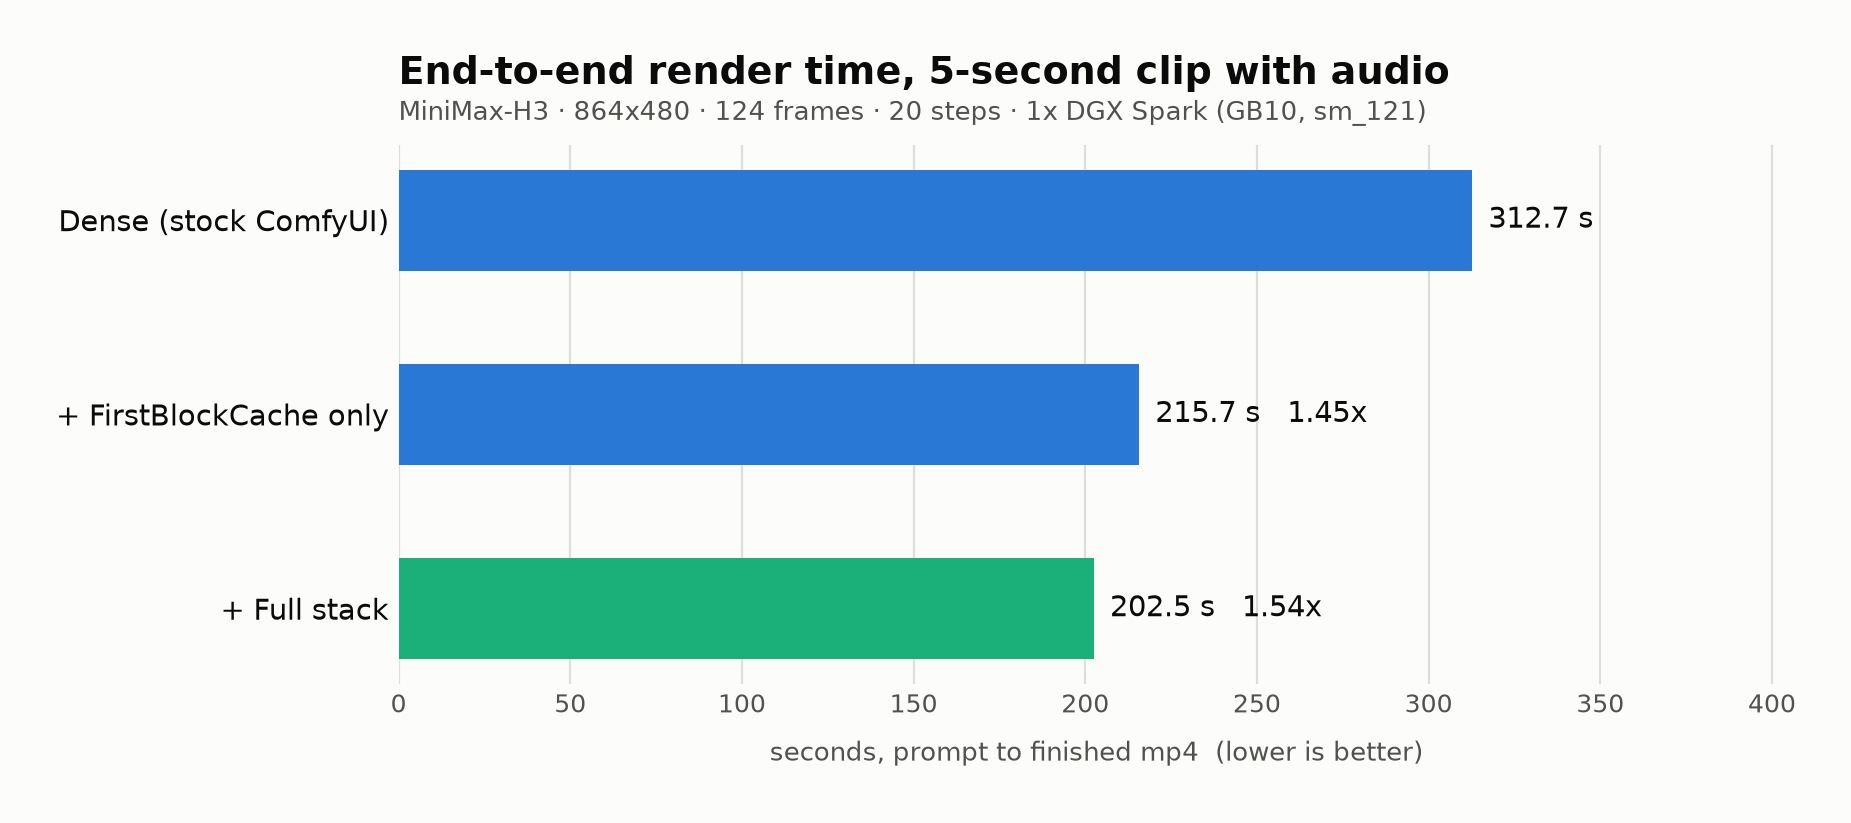
5초 분량의 864×480 클립(네이티브 스테레오 오디오 포함)을 처리하는 시간이 312.7초 → 202.5초로 단축되었습니다 (종단 간(end-to-end) 1.54배, 디노이징 단계당 1.72배) — A/B 프레임에서 품질 저하가 눈에 띄지 않습니다.
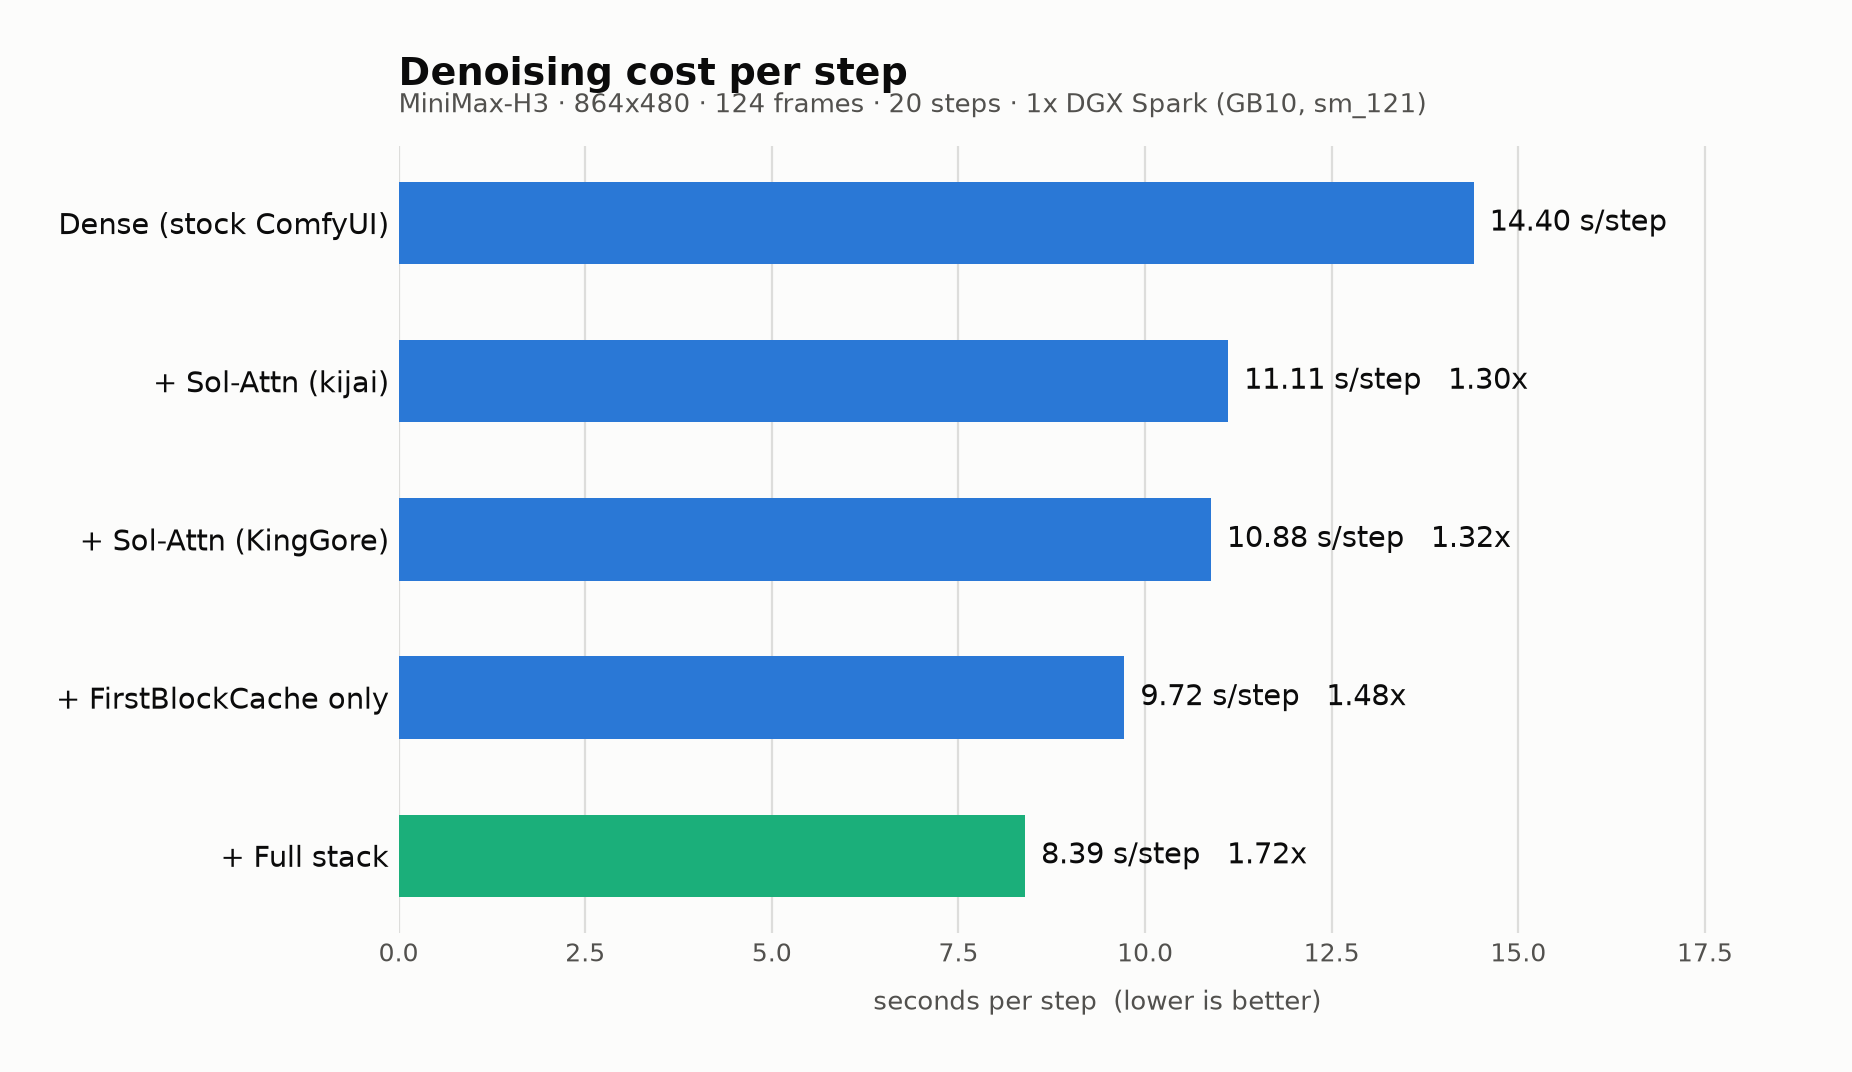
여기에 보고된 모든 수치는
bench/results.md의 기기에서, 유휴 GPU 상태로, 시드(seed)-매칭을 통해 측정되었습니다. 경쟁적인 실행 시간은 단순히 평균화하여 보고하는 것이 아니라 별도로 보고됩니다.
결과 (Results)
| Config | s/step | End-to-end | vs stock |
|---|---|---|---|
| Dense — stock ComfyUI | 14.40 | 312.7 s | 1.00× |
| ... |  |
격리된 작업(Isolated): 배치 처리 VAE 타일 디코딩 시간이 4.87초에서 청크당 2.93초로 단축 (1.66×).
이것이 실제로 사용자에게 주는 이점 (What this actually does for you)
DGX Spark를 소유하고 MiniMax-H3를 사용하려는 경우, 이 레포지토리는 네 가지 역할을 수행합니다:
1. H3가 이 칩에서 쓰레기를 생성하는 것을 방지합니다. 가장 명확하지 않지만 가장 가치 있는 부분입니다. 기존 Sol-Attn 플러그인을 Spark에 설치하면 Blackwell을 감지하고 flex_attention 경로를 선택하는데, 이 경로가 sm_121에서 조용히 잘못 컴파일됩니다. 오류나 경고는 없지만, 마치 고장 난 모델처럼 보이는 결과만 나옵니다. 사용자는 체크포인트, 양자화(quantization), 또는 ComfyUI 탓을 할 것이며 여기에 며칠을 허비할 수 있습니다. 이 레포지토리는 compute 12.1에서 올바른 Triton 커널을 강제하고 증상을 미리 명시하여 이미 어려움을 겪고 있는 누구나 이를 인식할 수 있도록 합니다.
2. 렌더링 속도를 약 1.5배 빠르게 만듭니다. FirstBlockCache와 배치 처리 VAE 디코드를 통해 5초 클립의 시간이 313초에서 202초로 단축되었습니다. 이 두 NVIDIA 기술은 이전까지 멀티 GPU SGLang 스택 내부에서만 존재했습니다.
3. 조립 과정(assembly)을 생략합니다. ./install.sh 스크립트 하나로 모든 것이 완료됩니다: ComfyUI를 고정하고, 41 GB의 가중치(weights), 네 가지 가속기 모두 연결하며, 최적화된 워크플로우가 디스크에 준비됩니다. 혹은 코딩 에이전트에게 RECIPE.md 파일을 건네주면, 모든 노브(knob)에 대한 설명과 함께 동일한 스택을 구축해 줍니다.
4. 시도하지 말아야 할 것을 알려줍니다. Spark를 하나 이상 사용하는 사람이라면 누구나 렌더링을 여러 노드에 분산할 수 있는지 물어봅니다. 측정된 답변은 다음과 같습니다: 패브릭(fabric)이 5.52 GB/s로 이동하는 반면, NVLink가 가정하는 503 GB/s와 비교했을 때, CP=2는 단일 최적화 노드보다 느립니다. 이 정보는 일주일 동안 찾아보지 않아도 되는 시간입니다.
이것이 하지 않는 것: 이것은 오직 GB10 / sm_121에만 도움이 됩니다. install.sh는 다른 곳에서는 실행을 거부하며, RTX 5090 소유자는 상위 플러그인(upstream plugins)을 패치하지 않은 상태로 사용해야 합니다. 또한 NVIDIA의 3.97배 성능(이것은 NVLink를 통해 여덟 개의 GB200이 필요함; 단일 Spark가 지원하는 것은 1.54배임)에 도달하지 못하며, 노드를 추가하여 단일 클립을 더 빠르게 만들지도 않습니다. 이 다중 노드 스크립트는 지연 시간(latency)이 아닌 처리량(throughput)을 확장합니다.
설치 (Install)
git clone https://github.com/drowzeys/keys-SM121-Optimized-MiniMax-H3-Nvidia-Sol-Engine-Kijai-SolAttn_Triton-Single-DGX-Spark.git
cd keys-SM121-*
./install.sh              # ComfyUI v0.30.1 + 41 GB 가중치 + 네 가지 가속기 모두
...
http://<host>:8188을 열고, ~/comfy/h3-fullstack.json 파일을 캔버스에 끌어다 놓고, 실행(Run) 버튼을 누릅니다.
헤드리스 환경:
curl -X POST http://127.0.0.1:8188/prompt -H 'Content-Type: application/json' \
  -d

H3는 텍스트, 오디오 및 비디오를 **하나의** 시퀀스(1344×768/124f에서 38,247개 행)로 통합하고 모든 요소에 대해 완전한 self-attention을 수행합니다. 제거할 CFG 브랜치도 없고 캐시할 cross-attention도 없습니다. 따라서 attention이 전체 hot path의 약 70%를 차지합니다. 그러므로 개선점은 다음과 같습니다: attention을 희소하게 만들고, 변화가 없는 단계에서는 네트워크를 완전히 건너뛰며, DiT 외부에서 실행 경계(launch-bound) 작업을 수정하는 것입니다.

| 최적화 (Optimization) | 출처 (Origin) | 기능 (What it does) | 측정치 (Measured) |
|---|---|---|---|
| **Sol-Attn** | [NVIDIA Sol-Engine](https://github.com/NVlabs/Sana/tree/sol-engine) 커널, [KingGore](https://github.com/KingGore/ComfyUI_sol-attn_Blackwell) & [kijai](https://github.com/kijai/ComfyUI-SolAttn_triton)에 의해 패키징됨 | 각 query 블록을 가장 높은 점수를 받은 KV 블록으로만 라우팅합니다. | 단계당 1.32× |
| ... |
**고의적으로 제외된 내용** (단일 GPU 현실 점검): context parallelism / Ulysses (NVIDIA의 3.97×는 503 GB/s NVLink를 사용하는 8×GB200에서 사용됨), fused-QKV collective 및 Triton relayout 커널 (이들은 all-to-all을 공급하기 위해 존재함), 그리고 elementwise DiT fusion — NVIDIA 자체 README에 따르면 여기의 정직한 최대치는 약 3%이며, ComfyUI는 이미 `_mod_gate`/`_mod_scale_shift`를 제자리에서 병합(fuses)합니다.

## 모르면 하루가 걸릴 세 가지 것

**1. `flex_attention`은 `sm_121`에서 조용히 잘못 작동합니다.** torch 2.11.0+cu130으로 컴파일되고 실행되며 아무것도 발생시키지 않지만, SDPA와 비교하여 코사인 유사도 0.92–0.97을 반환합니다. 50개 블록 × 20단계에 걸쳐 이는 눈에 띄는 쓰레기(garbage)로 누적되어 깨진 체크포인트처럼 보입니다. 상위 Sol-Attn 플러그인은 Blackwell에서 이 경로를 선호하며, `patches/`의 패치는 12.1에서 Triton 커널을 강제합니다. **이 아키텍처의 모든 커널은 수치적으로 확인해야 합니다.**

**2. H3의 블록들은 입력값을 제자리(in place)에서 변형시킵니다.** `DiTBlock.forward`는 `x[a:b].addcmul_(...)`로 끝나며 *동일한 텐서 객체*를 반환합니다. 캐싱을 수행하는 모든 `output - input`은 정확히 0이 되어, 모델이 절대 변하지 않는다고 결론 내리고, 모든 것을 건너뛰며, 체커보드 패턴을 방출합니다. 블록 전에 복제(Clone)해야 합니다.

<details>
<summary>실패가 어떻게 보이는지</summary>

캐시는 매 단계마다 `diff_ratio=0.0000 -> skip`을 보고하며 디코딩 결과는 순수한 체커보드 노이즈입니다. 수정 방법은 `nodes/h3_fbc_node.py` 파일 내에서 두 개의 `.clone()` 호출을 추가하는 것입니다.

**3. NVIDIA의 캐시 임계값은 50 단계를 가정합니다.** 20단계에서는 행별 `diff_ratio`가 U자형(10단계에서 0.18 → 0.066 → 0.25)을 보이며, 단순한 임계값 설정으로는 잘못된 위치에 캐싱이 발생합니다. 이 포트는 드리프트(drift)를 제한하기 위해 `start_step`, `end_dense_steps`, 그리고 `max_consecutive_skips`를 추가합니다. 또한: 그들의 전역 평균(global-mean) 지표는 패킹된 텍스트/오디오 접두사 행에 의해 희석되므로, 이 포트는 마지막 60%의 행에 걸쳐 행별 비율을 측정합니다.

또한 두 가지 환경적인 주의사항이 있습니다: **H3와 `--use-sage-attention`을 절대 함께 사용하지 마십시오** (순수 노이즈, [ComfyUI#15263](https://github.com/Comfy-Org/ComfyUI/issues/15263)), 그리고 **바쁜 GB10은 절대로 벤치마킹하지 마십시오** — 백그라운드 CUDA 작업이 열 스로틀링(thermal throttling)과 정확히 같은 방식으로 읽힙니다 (저희의 경우 10.88 → 20.77 s/step).

## NVIDIA 자체 Sol-Engine 코드 실행하기

NVIDIA의 공식 `sol_attn` 패키지는 `sm_121`에서 **실행됩니다** — 그들의 CuTe 테이블은 `sm_120`에서 멈추지만, 모든 Capability ≥ 8.0에 대해서는 번들링된 Triton 구현으로 폴백(fallback)합니다. H3 형태의 호출에서 측정 결과는 3.51 ms 대 kijai의 3.33 ms였으며 정확도는 동일했습니다. 그들의 전체 *런타임*(runtime)은 맞지 않습니다 (bf16이 사용 가능한 121 GB 대비 141 GB 필요). 또한 Spark 패브릭 위에서의 컨텍스트 병렬성(context parallelism) 측정값은, 그들이 가정했던 3.97배의 503 GB/s NVLink에 비해 **5.52 GB/s**로 측정되어 CP=2는 순손실이 됩니다. 수치와 추론 과정은 [`RECIPE.md`](RECIPE.md#appendix-running-nvidias-own-sol-engine-code-measured-not-speculated)를 참조하십시오.

## 저장소 구조 (Repo layout)
install.sh 일회성 설치 프로그램 (ComfyUI + 가중치 + 모든 가속 기능)
RECIPE.md 최적화별 근거가 제시된 에이전트 실행 가능한 레시피
nodes/h3_fbc_node.py FirstBlockCache 포트 (본 저장소, Apache-2.0)
...
## 요구 사항 (Requirements)

DGX Spark / GB10 (`sm_121`), 128 GB 통합 메모리, aarch64, CUDA 13, torch ≥ 2.9
(테스트 버전: 2.11.0+cu130), ComfyUI v0.30.1, 가중치용 여유 디스크 공간 약 45 GB.
`install.sh`는 컴퓨트 능력을 확인하고 다른 환경에서는 실행을 거부합니다. 여기에 포함된 패치는 특히 12.1에 관한 것이며, 12.0 (RTX 5090)의 경우 업스트림 플러그인을 수정하지 않고 사용해야 합니다.

5초 렌더링 중 최대 사용량은 약 26 GB를 남기고 121 GB가 여유 있습니다. 15초 클립(362 프레임, 모델의 최대치)을 렌더링하면 10–13 GB가 남아 있으며 약 32분이 소요됩니다.

## 크레딧 (Credits)

- **[MiniMax](https://huggingface.co/MiniMaxAI/MiniMax-H3)** — H3 모델과 오픈 가중치(open weights).
- **[NVIDIA NVlabs Sol-Engine](https://github.com/NVlabs/Sana/tree/sol-engine)** (Apache-2.0) —
  Sol-Attn, FirstBlockCache 및 batched-VAE 기술. 여기에 포함된 두 포트는 해당들의 `models/minimax_h3/optimized/` 코드에서 파생되었습니다. README의 분석 내용이 이 포트를 다루기 쉽게 만들었습니다. [논문](https://arxiv.org/abs/2607.24027).
- **[KingGore](https://github.com/KingGore/ComfyUI_sol-attn_Blackwell)** (Apache-2.0) —
  Blackwell용 Sol-Attn의 최초 ComfyUI 패키징입니다. Apache-2.0 §4b에 따라 변경 사항을 알리는 NOTICE가 포함되어 여기에 사전 수정된 형태로 보관되었습니다.
- **[kijai](https://github.com/kijai/ComfyUI-SolAttn_triton)** — 이 스택이 기본으로 사용하는 INT8/TMA 및 sigma-window gating을 갖춘 Triton Sol-Attn 구현체.
  *포함되지 않음:* 해당 저장소는 라이선스 파일이 없으므로, `install.sh`가 재배포하는 대신 업스트림에서 클론합니다.
- **[Comfy-Org](https://huggingface.co/Comfy-Org/MiniMax-H3)** — 패키징된 INT8/NVFP4 가중치와 ComfyUI의 day-0 H3 노드 및 템플릿.

## 라이선스 (License)

Apache-2.0 (라이선스 참조 [LICENSE](LICENSE)) — `nodes/h3_fbc_node.py`와 `nodes/h3_vae_batch.py`가 파생된 NVIDIA의 Sol-Engine과 일치합니다. 포함된 타사 코드는 자체 라이선스와 공지 사항을 유지합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub ML Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기