
InstructRL: Jax 기반 InstructRL 방법 구현체
요약
InstructRL의 Jax 기반 구현체는 지시사항(instructions)을 활용한 RL 방법론을 제공합니다. 이 코드는 From scratch, CLIP-RL, Instruct*RL 등 다양한 방법을 지원하며, 연속적/이산화된 로봇 액션 학습 및 평가가 가능합니다.
핵심 포인트
- Jax 기반으로 구현되어 높은 효율성을 자랑함.
- From scratch부터 CLIP-RL, Instruct*RL까지 다중 방법론을 지원.
- GPU와 Google Cloud TPU 환경에서 테스트되었으며 멀티 호스트 트레이닝이 가능함.
- 로봇 액션 학습 및 평가를 위한 상세한 사용법과 스크립트를 제공함.
InstructRL
이것은 InstructRL 방법을 위한 Jax 구현체입니다.
논문: Instruction-Following Agents with Jointly Pre-Trained Vision-Language Models.
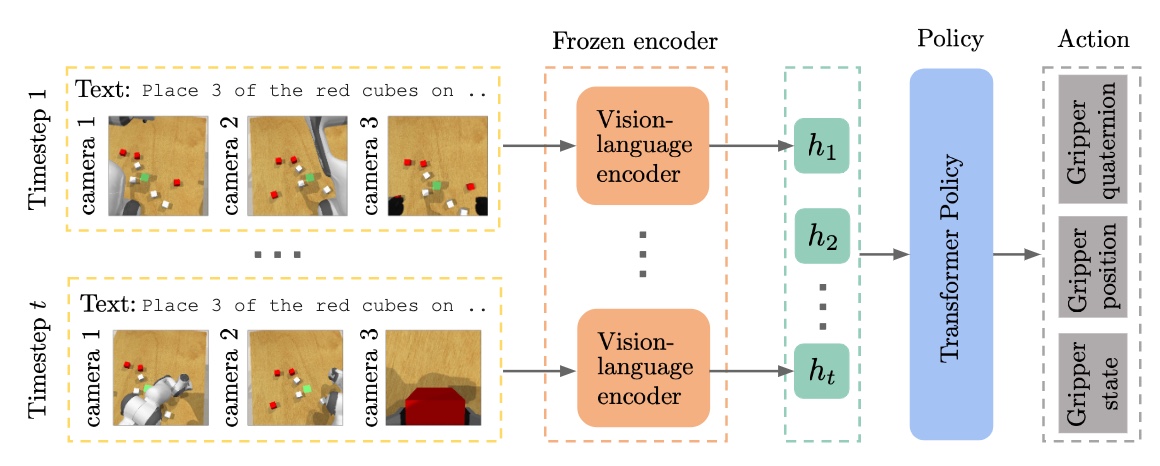
이 구현체는 GPU와 Google Cloud TPU에서 테스트되었으며, TPU Pod를 사용한 멀티 호스트 트레이닝을 지원합니다.
이 코드는 다음 방법론과 베이스라인을 지원합니다:
- From scratch: 지시사항(instructions) 유무에 따라 트랜스포머 정책(transformer policy)을 처음부터 학습(training from scratch).
- CLIP-RL: 미리 학습된 OpenAI CLIP-VIT를 사용하여 지시사항 유무에 따라 트랜스포머 정책을 학습.
- InstructRL: 미리 학습된 멀티모달 MAE 인코딩을 사용하여 지시사항 유무에 따라 트랜스포머 정책을 학습.
이 코드는 또한 연속적(continuous) 및 이산화된(discretized) 로봇 액션 모두를 사용한 학습과 평가를 지원합니다.
설치 (Installation)
GPU 환경인 경우, coppeliasim 스크립트로 CoppeliaSim을 설치한 후, pip으로 의존성(dependencies)을 설치하세요.
cat gpu_requirements.txt | xargs -n 1 -L 1 pip install
TPU 환경인 경우, TPU 설정 스크립트를 사용하여 의존성을 설치합니다.
의존성 설치 후, 이 저장소 디렉터리를 PYTHONPATH 환경 변수에 추가하세요.
export PYTHONPATH="$PYTHONPATH:$(pwd)"
사용법 (Usage)
실험은 다음 명령어를 통해 실행할 수 있습니다.
미리 학습된 멀티모달 MAE 인코딩을 사용하여 정책 트랜스포머를 학습하는 예시:
export PYTHONPATH="$PYTHONPATH:$PROJECT_DIR"
export PYTHONPATH="$PYTHONPATH:$PROJECT_DIR/instructrl/models"
echo $PYTHONPATH
...
model.transfer_type 인수는 미리 학습된 트랜스포머를 결정하며, 다음 옵션들이 지원됩니다:
- VIT: 처음부터 학습(from scratch) 시 "None"
- M3AE: 미리 학습된 모델인 "m3ae_vit_b16" (더 큰 모델은 곧 출시 예정)
- CLIP: 미리 학습된 모델인 "clip_vit_b32" 및 "clip_vit_b16"
model.model_type 인수는 처음부터 학습한 정책 트랜스포머의 유형을 결정하며, vit_small, vit_base, vit_large 중 하나일 수 있습니다.
대규모 학습(예: 약 100개 태스크에 대한 학습)의 경우, 대형 TPU pod 사용이 권장됩니다.
저희는 jobs에서 대규모 학습을 시작하기 위한 작업 스크립트를 제공합니다.
모델 평가
export PYTHONPATH="$PYTHONPATH:$PROJECT_DIR"
export PYTHONPATH="$PYTHONPATH:$PROJECT_DIR/instructrl/models"
echo $PYTHONPATH
...
데이터 생성
저희가 전처리한 단일 태스크 및 다중 태스크 데이터는 곧 공개될 예정입니다.
클라우드에서 대규모 학습을 용이하게 하기 위해, 모든 데이터셋은 HDF5 파일로 저장되며 클라우드 스토리지 버킷에서 읽어옵니다.
HDF5 데이터에는 이미지, 상태(states), 행동(actions)이 포함되어 있습니다.
데이터 생성의 예시는 collect_data script에서 확인할 수 있습니다.
감사의 글
Multimodal MAE 구현은 주로 m3ae를 기반으로 하며, CLIP 구현은 주로 scenic을 기반으로 합니다.
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub AI Research의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기