
HAMi: AI 인프라를 위한 쿠버네티스 GPU 가상화 및 이종 가속기 스케줄링 미들웨어
요약
HAMi는 AI 인프라 환경을 위해 설계된 쿠버네티스 기반의 GPU 가상화 및 이종 가속기 스케줄링 미들웨어입니다. 이를 통해 다양한 종류의 하드웨어를 효율적으로 관리하고 자원을 할당할 수 있게 합니다. 특히, 여러 유형의 가속기를 통합하여 복잡한 AI 워크로드를 최적화하는 데 중점을 둡니다.
핵심 포인트
- 쿠버네티스 기반 GPU 가상화 및 스케줄링 솔루션 제공
- 다양한 이종 가속기(Heterogeneous Accelerators) 지원
- AI 인프라의 자원 효율성 극대화에 기여


HAMi
AI 인프라를 위한 쿠버네티스 GPU 가상화 및 이종 가속기 스케줄링.
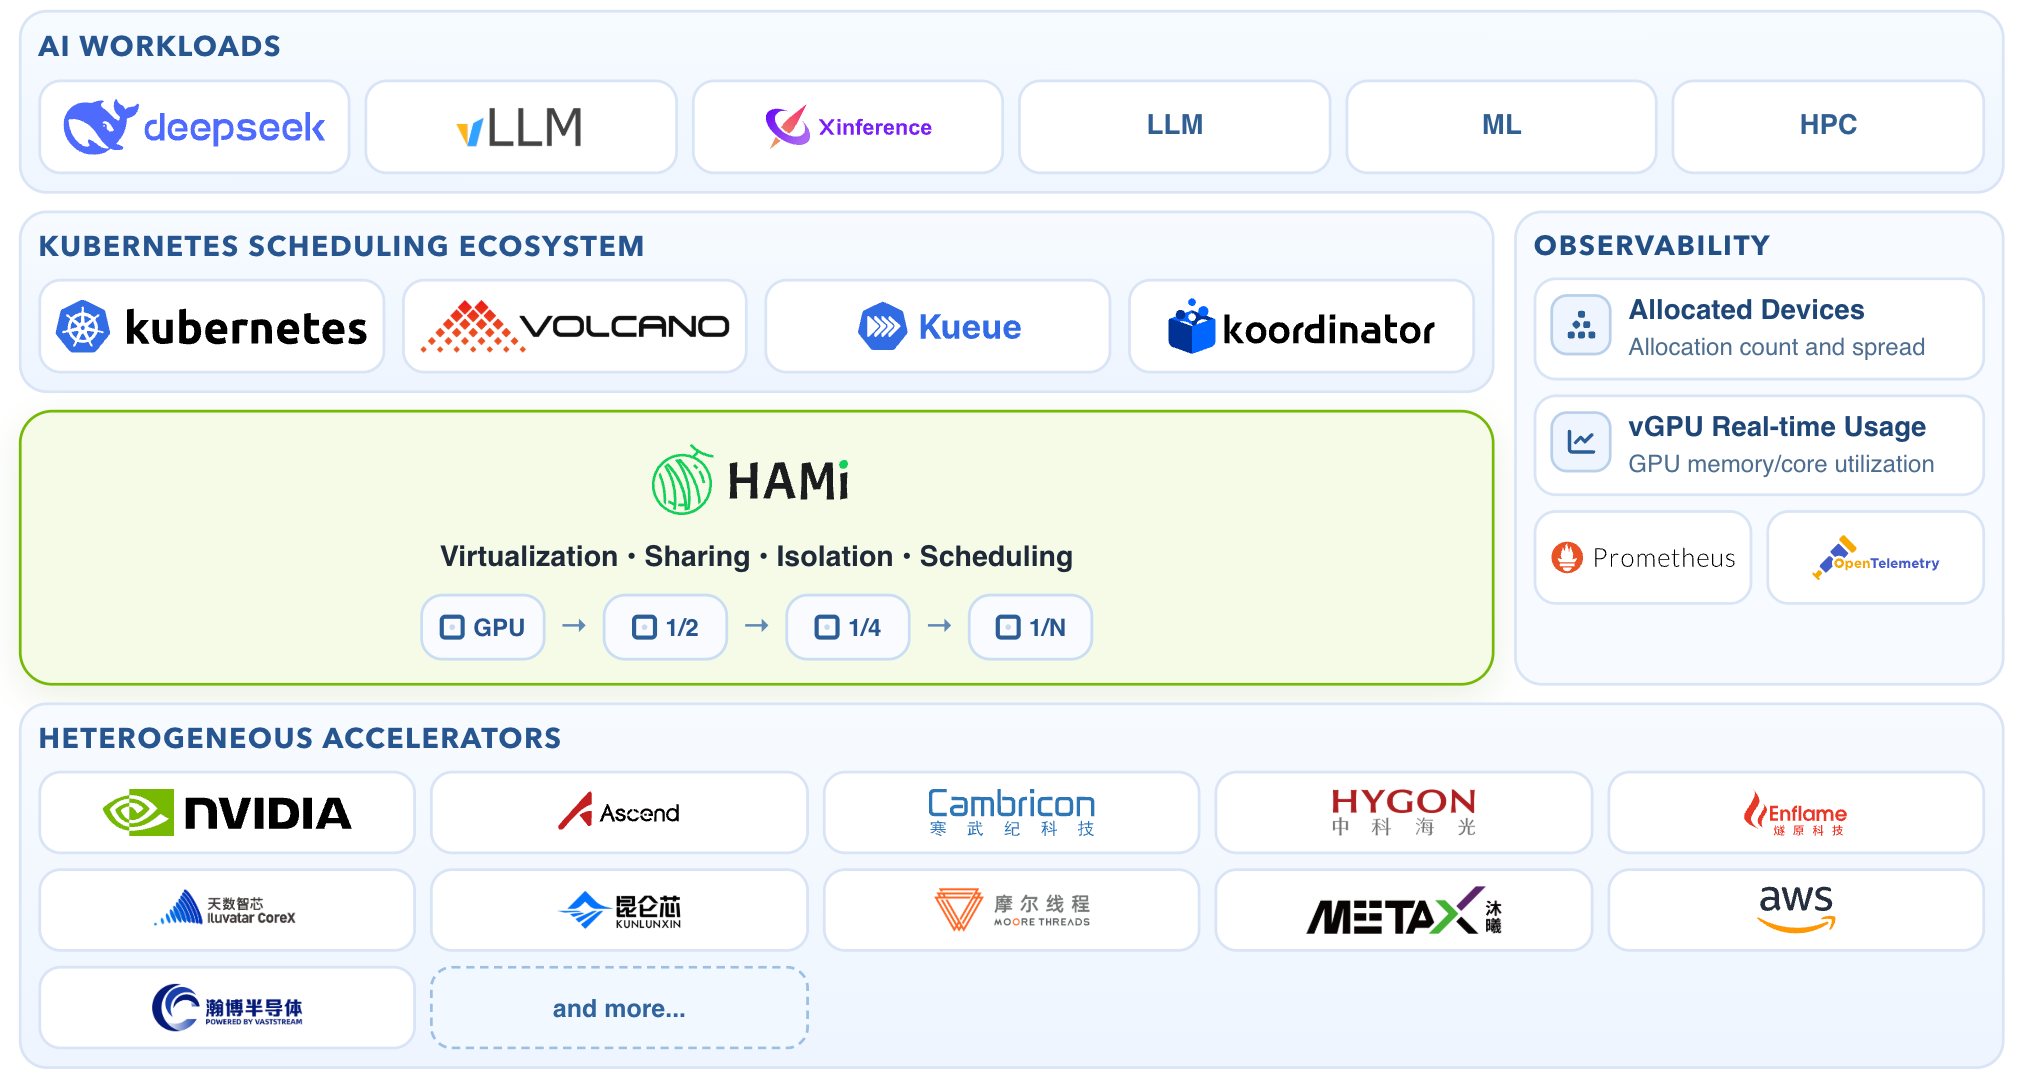
HAMi는 Heterogeneous AI Computing Virtualization Middleware(이종 AI 컴퓨팅 가상화 미들웨어)의 약자입니다. 이전에는 k8s-vGPU-scheduler로 알려졌던 HAMi는 플랫폼 팀이 쿠버네티스 워크로드 전반에 걸쳐 값비싼 GPU 및 기타 AI 가속기를 공유하고, 장치 메모리와 컴퓨팅을 격리하며, 애플리케이션 코드를 변경하지 않고도 장치 인식 정책(device-aware policies)으로 파드(pod)를 스케줄링할 수 있도록 돕습니다.
HAMi는 CNCF Incubating 프로젝트이자 CNCF Landscape 프로젝트입니다. 또한 CNAI Landscape에도 등재되어 있습니다.
HAMi가 필요한 이유?
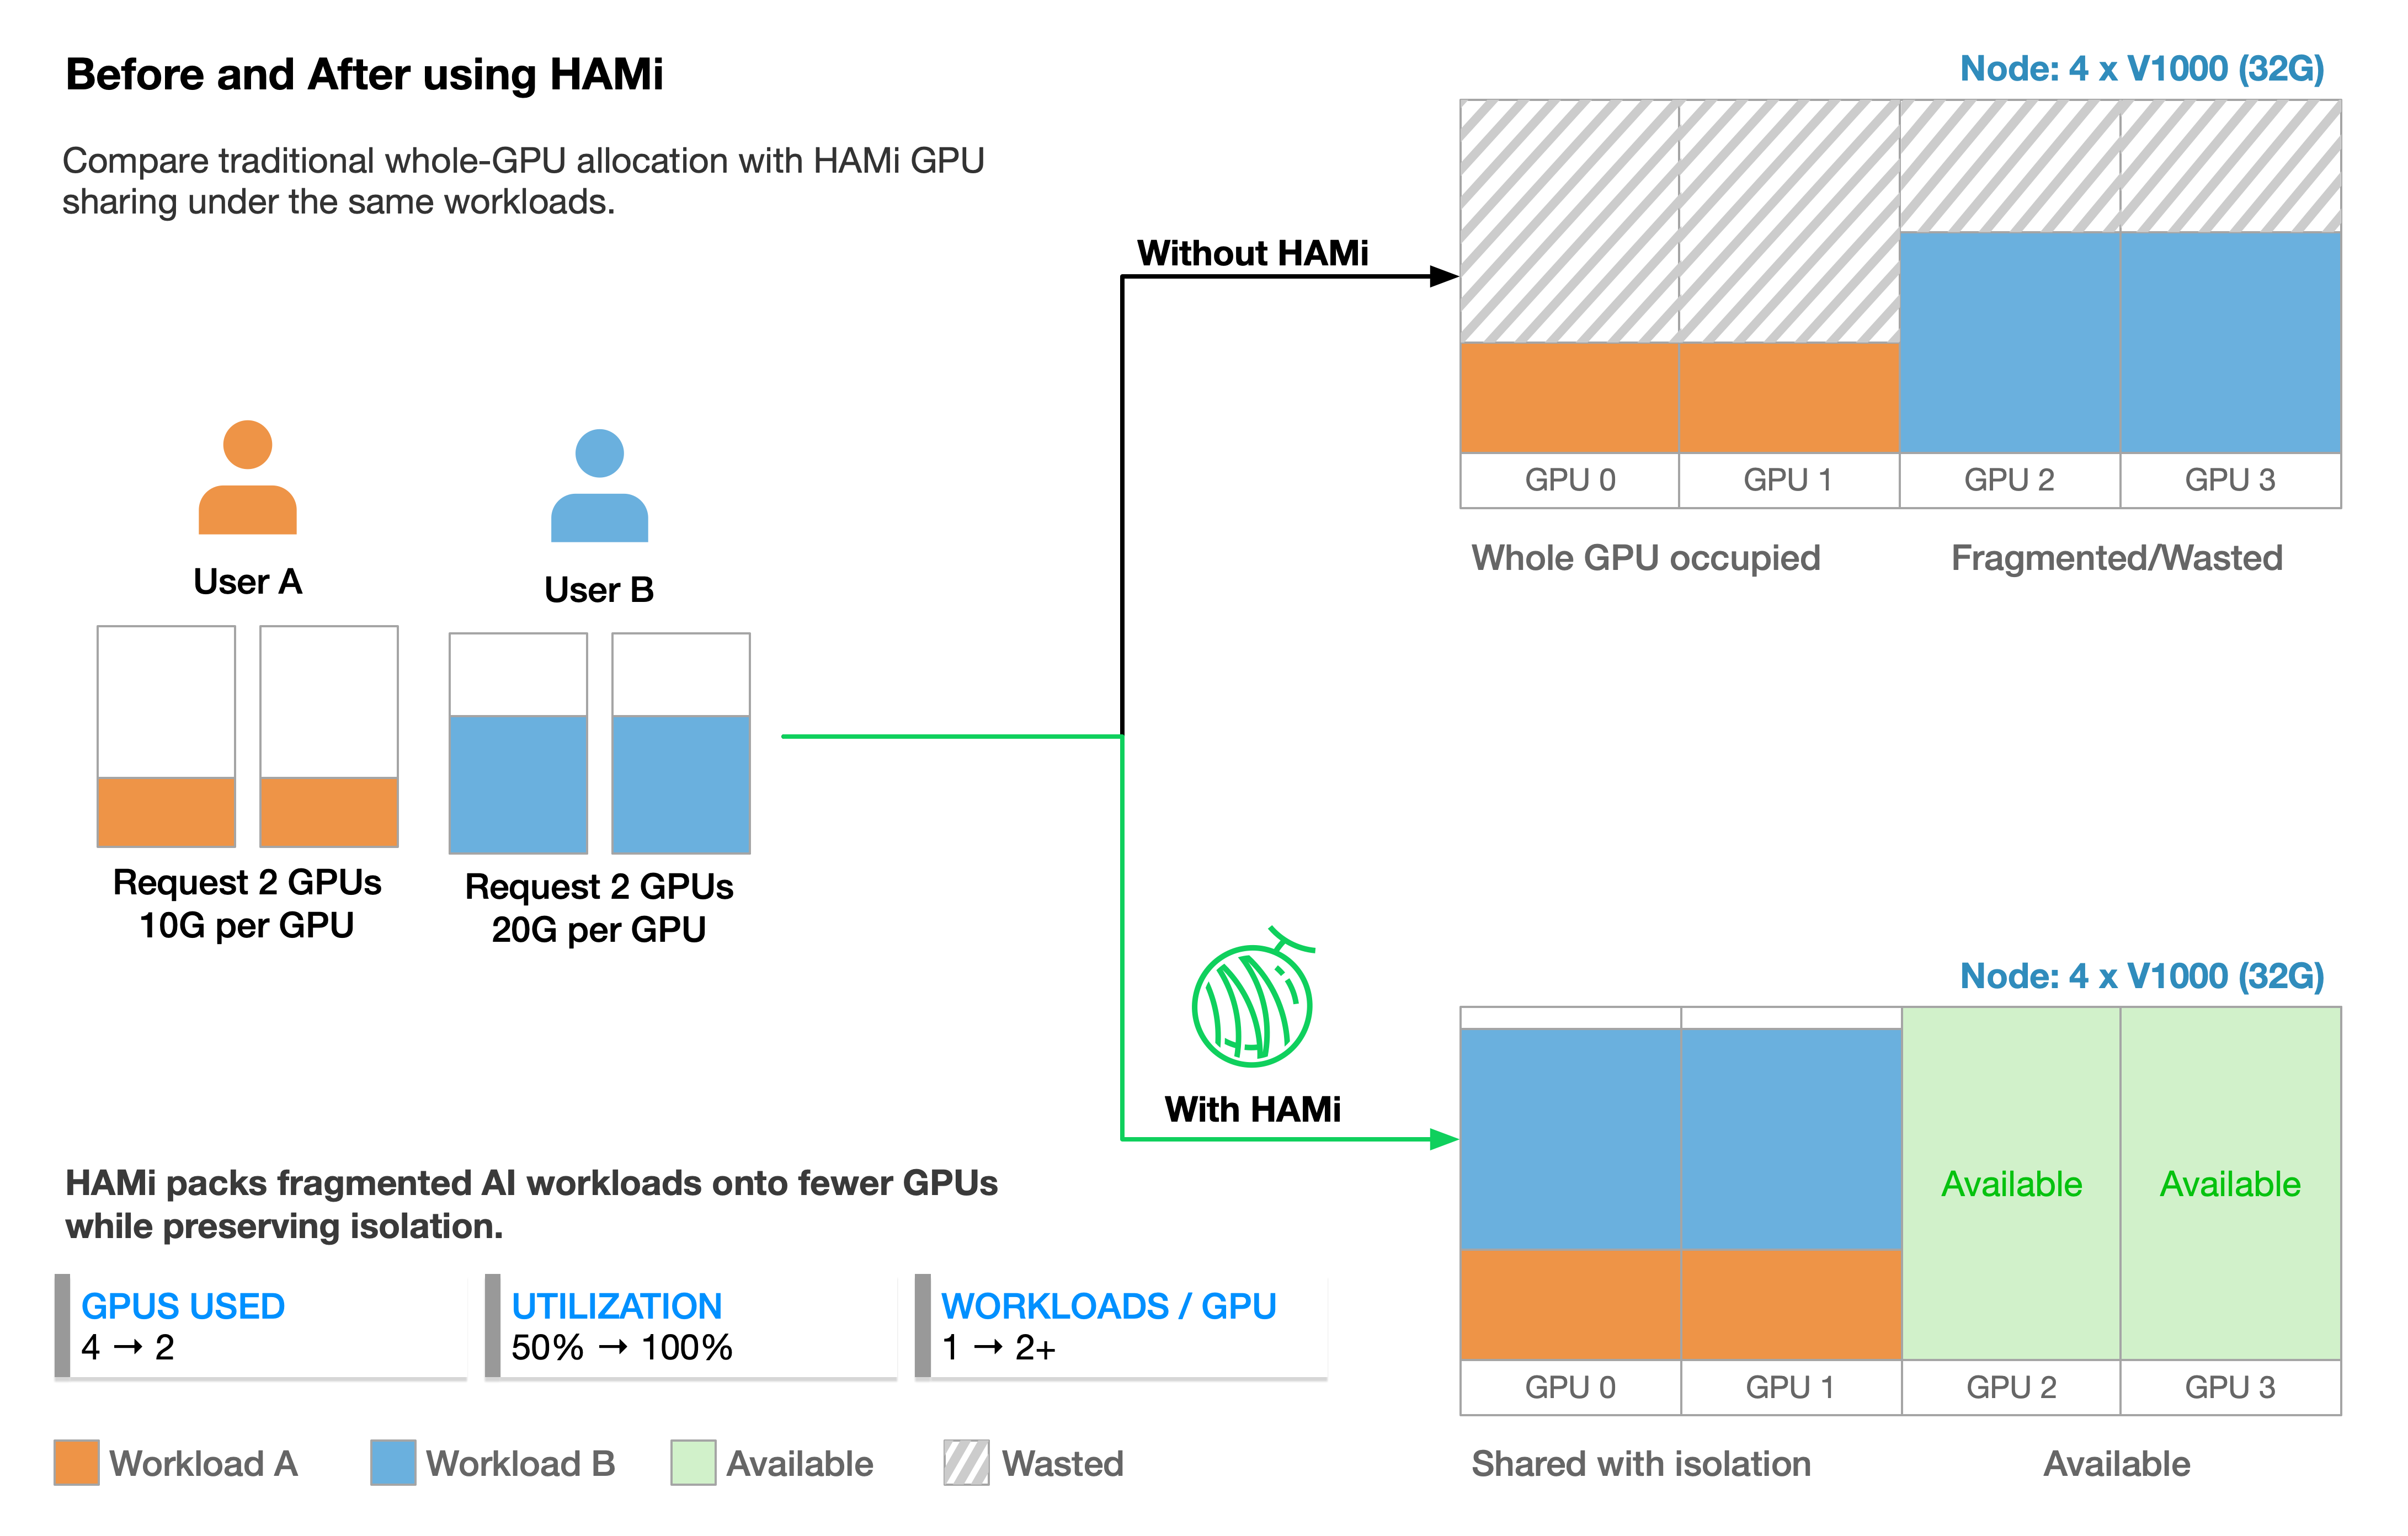
AI 인프라 팀은 종종 다음과 같은 쿠버네티스 가속기 문제에 직면합니다. 전체 GPU가 소규모 작업에 할당되고, 팀들이 희소한 장치 자원을 두고 경쟁하며, 다양한 가속기 벤더가 서로 다른 운영 모델을 노출하고, 스케줄러가 워크로드를 효율적으로 배치하기에 충분한 장치 컨텍스트(device context)를 갖추지 못하는 경우입니다.
HAMi는 다음 기능을 위한 Kubernetes 네이티브 계층을 제공합니다:
- 장치 공유 (Device sharing): 메모리, 코어 또는 장치 개수 단위로 물리적 가속기의 일부를 할당할 수 있습니다.
- 리소스 격리 (Resource isolation): 장치 백엔드가 지원하는 경우 워크로드별 가속기 메모리 및 컴퓨팅 제한을 강제합니다.
- 장치 인식 스케줄링 (Device-aware scheduling): 토폴로지 인식(topology-aware), 빈팩(binpack), 분산(spread) 및 장치별 스케줄링 정책을 가진 파드를 배치할 수 있습니다.
- 이종 AI 클러스터 (Heterogeneous AI clusters): NVIDIA GPU, NPU, HCU, MLU 및 기타 가속기 유형을 단일 스케줄링 및 할당 워크플로우를 통해 관리합니다.
- 애플리케이션 변경 없음 (Zero application changes): 표준 Kubernetes 리소스 요청(resource requests) 및 제한(limits) 사용을 유지할 수 있습니다.
- 운영 환경 지원 (Production operations): 메트릭, 대시보드, WebUI, Helm 설치 및 커뮤니티 지원 배포 가이드를 제공합니다.
사용 사례 (Use Cases)
- 공유 Kubernetes AI 클러스터의 GPU 활용률을 높입니다.
- 동일한 가속기 풀에서 다중 테넌트 노트북, 학습(training) 및 추론(inference) 워크로드를 실행합니다.
- 공정한 장치 할당과 쿼터 제어를 통해 프라이빗 클라우드 AI 플랫폼을 구축합니다.
- NVIDIA, Ascend, Cambricon, Hygon, Iluvatar, Kunlunxin, MetaX, Moore Threads 및 기타 벤더의 이종 가속기 클러스터를 운영합니다.
- 배치(batch) AI 워크로드를 위해 kube-scheduler나 Volcano와 같은 Kubernetes 스케줄러에 HAMi를 결합합니다.
작동 방식 (How It Works)
HAMI는 뮤테이팅 웹훅(mutating webhook), 스케줄러 익스텐더(scheduler extender), 장치 플러그인(device plugins) 및 장치별 컨테이너 내 가상화 구성 요소로 구성됩니다.
Pod 제출
  -> HAMi 뮤테이팅 웹훅
  -> HAMi 스케줄러 필터 / 점수 / 바인드
...
장치 가상화 (Device Virtualization)
HAMI를 사용하면 워크로드가 필요한 가속기 리소스만 요청할 수 있습니다. 예를 들어, 다음 파드는 3 GiB의 GPU 메모리를 가진 물리적 NVIDIA GPU 1개를 요청합니다:
resources:
  limits:
    nvidia.com/gpu: 1
...
워크로드는 컨테이너 내부에서 할당된 장치 리소스를 확인하며, HAMi가 스케줄링, 할당 및 격리를 조정합니다.
참고 사항:
- HAMi를 설치한 후, 노드에 등록되는
nvidia.com/gpu값은 vGPU의 개수로 기본 설정됩니다. - 파드에서 리소스를 요청할 때,
nvidia.com/gpu는 현재 파드가 요구하는 물리적 GPU의 개수를 의미합니다.
지원 장치 (Supported Devices)
HAMI는 GPU, NPU, HCU, MLU, GCU, XPU 등 다양한 이종 가속기 백엔드를 지원합니다. 장치 기능은 벤더, 모델, 드라이버 및 하드웨어 세대에 따라 다릅니다.
이 저장소의 장치 백엔드는 NVIDIA GPU (MIG 포함), AMD GPU, Huawei Ascend NPU, Cambricon MLU, Hygon HCU, Iluvatar GPU, Kunlunxin XPU, MetaX GPU, Moore Threads GPU, Enflame GCU, Biren GPU, VastAI, AWS Neuron, 그리고 Lupine이 제공하는 원격 NVIDIA GPU를 포함합니다. 각 벤더별 파드 예제는 examples/에서 확인할 수 있습니다.
유지되는 지원 매트릭스는 현재 HAMi 지원 장치(HAMi supported devices) 페이지를 참조하십시오.
빠른 시작 (Quick Start)
전제 조건 (Prerequisites)
NVIDIA 장치 플러그인 경로를 위해 다음을 준비해야 합니다:
- NVIDIA 드라이버 >= 440
- NVIDIA Container Toolkit (
nvidia-docker2의 후속 버전) - containerd, Docker 또는 CRI-O의 기본 런타임으로 설정된 NVIDIA
- Kubernetes >= 1.23
- glibc >= 2.17
- Linux 커널 >= 3.10
- Helm > 3.0
Helm으로 설치 (Install With Helm)
HAMI가 관리할 수 있도록 GPU 노드에 레이블을 지정합니다:
kubectl label nodes <node-name> gpu=on
HAMi Helm 저장소를 추가합니다:
helm repo add hami-charts https://project-hami.github.io/HAMi/
helm repo update
HAMI를 설치합니다:
helm install hami hami-charts/hami -n kube-system
스케줄러와 장치 플러그인이 실행 중인지 확인합니다:
kubectl get pods -n kube-system
hami-device-plugin과 hami-scheduler가 모두 Running 상태일 때, 예제 워크로드를 제출합니다:
kubectl apply -f examples/nvidia/default_use.yaml
벤더 설정은 values.yaml의 devices.<vendor> 아래에 있습니다. chart README에서 구성 가능한 값과 이전 레이아웃에서 이동하는 방법을 문서화했습니다.
전체 설치 가이드 및 구성 옵션은 HAMi 문서를 참조하십시오.
배포 옵션
- 고가용성(High availability):
scheduler.leaderElect=true로 설정하고scheduler.replicas를 1보다 크게 설정하여 여러 스케줄러 복제본을 하나의 리더 뒤에 실행합니다. 이를 위해 PodDisruptionBudget이 생성됩니다. - OpenShift 및 SELinux: OpenShift의 경우
platform.openshift=true로, SELinux가 활성화된 노드의 경우selinux.enabled=true로 설정합니다. - NetworkPolicy:
scheduler.networkPolicy.enabled=true는 스케줄러의 웹훅(webhook) 및/refit포트로의 접근을 제한합니다. 일부 CNI는 호스트 네트워크가 구성된 kube-apiserver 트래픽을namespaceSelector와 일치시키지 못할 수 있으며, 이는 웹훅에 도달할 수 없게 만들 수 있습니다. 이 경우scheduler.admissionWebhook.failurePolicy=Ignore를 사용하면 HAMi의 변경 사항 없이 Pod가 승인됩니다. - Prometheus Operator:
prometheus.enabled=true는 ServiceMonitor API가 사용 가능한 경우 스케줄러와 디바이스 플러그인(device plugin)에 대한 ServiceMonitors를 생성합니다. 디바이스 플러그인의 경우 또한devicePlugin.enabled가 필요합니다.
스케줄링 정책
HAMi는 AI 워크로드를 위해 여러 스케줄링 모드를 지원합니다:
- binpack: 통합(consolidation)을 개선하기 위해 워크로드를 더 적은 노드 또는 장치에 패킹(pack)합니다.
- spread: 경합(contention)을 줄이기 위해 워크로드를 노드 또는 장치 전반에 분산(distribute)합니다.
- topology-aware scheduling: 지원되는 경우 GPU 토폴로지 기반으로 장치 조합을 선택합니다.
- mutex: 유휴(idle) GPU만 할당하여 워크로드가 장치를 공유하지 않도록 합니다.
- numa: NUMA 노드별로 장치를 그룹화하는 정렬 키(sort key)이며, binpack 또는 spread와 연결될 수 있습니다. Pod는
nvidia.com/numa-bind어노테이션을 사용하여 GPU 간의 NUMA 공동 배치(co-location)를 요청할 수 있습니다.
클러스터 기본 설정을 scheduler.defaultSchedulerPolicy.nodeSchedulerPolicy와 gpuSchedulerPolicy로 지정할 수 있습니다. 파드(pod)는 각각 hami.io/node-scheduler-policy 및 hami.io/gpu-scheduler-policy 어노테이션으로 이를 재정의하며, GPU 정책은 binpack,numa와 같은 쉼표로 구분된 조합을 허용합니다.
- dynamic MIG: 지원되는 카드와 모드에 대해 NVIDIA MIG 인스턴스를 동적으로 생성(create), 캐시(cache), 재사용(reuse) 및 회수(reclaim)합니다. Dynamic MIG 인스턴스 수명 주기를 참조하십시오.
HAMi는 기본 Kubernetes 스케줄러 경로와 함께 작동하며, 배치 기반 AI 워크로드에는 Volcano와도 사용할 수 있습니다. 최신 스케줄러 통합 가이드는 HAMi 웹사이트에서 확인하십시오.
관측 가능성 및 WebUI (Observability And WebUI)
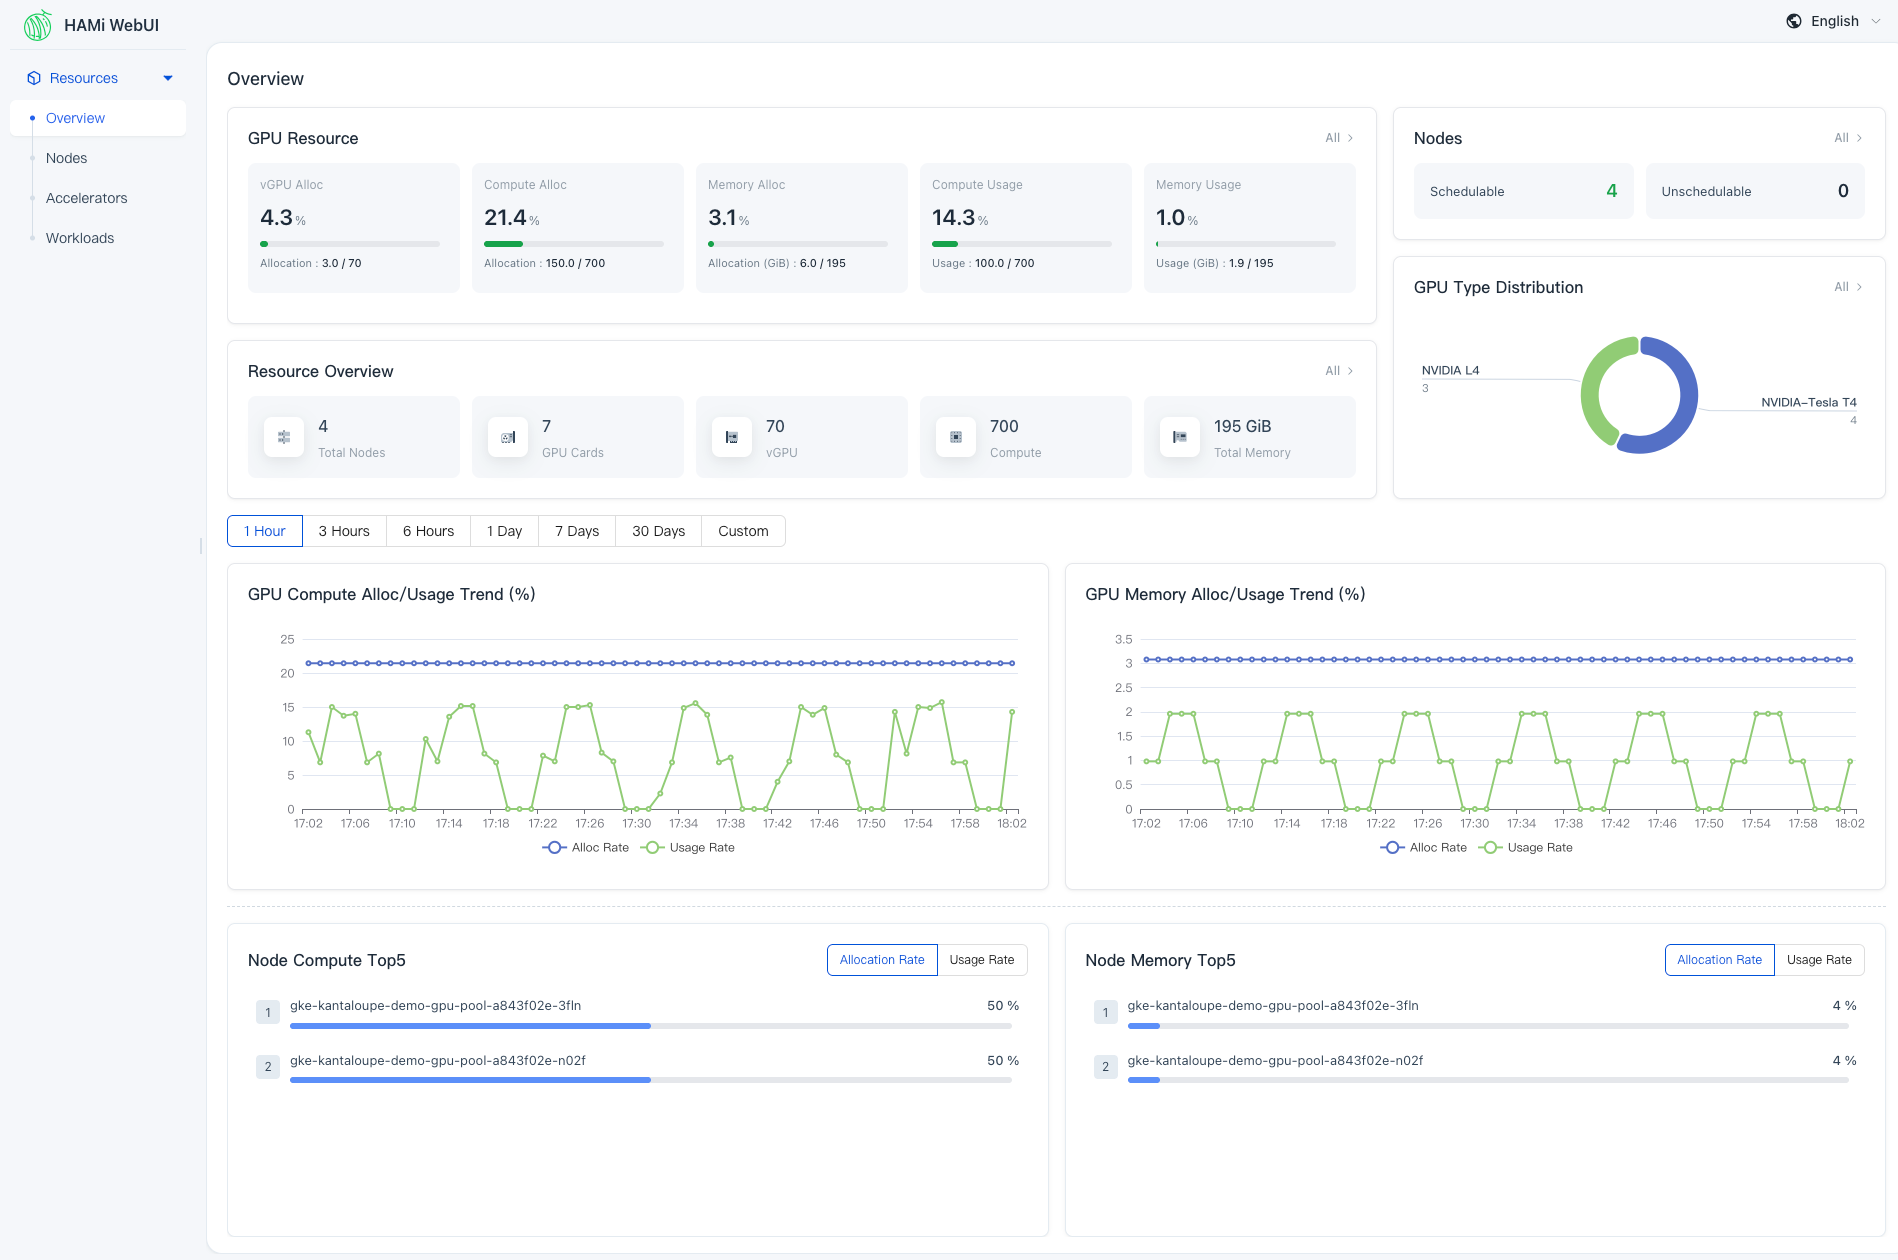
HAMI는 클러스터 가속기 사용량을 모니터링하기 위한 메트릭을 노출합니다. 설치 후, 메트릭은 스케줄러 모니터 엔드포인트를 통해 확인할 수 있습니다:
기본 모니터 포트는 31993입니다. --set scheduler.service.monitorPort=<port>와 같은 Helm 값을 사용하여 변경할 수 있습니다.
HAMI는 또한 다음을 제공합니다:
- 시각적인 클러스터 및 장치 관리를 위한 HAMi-WebUI.
- GPU 파드 디버깅 및 vGPU 메트릭 요약을 위한 skill/의 에이전트 스킬.
- 가속기 모니터링을 위한 Grafana 대시보드.
- 워크로드 동작 및 스케줄링 효과를 평가하기 위한 벤치마크 자료.
에코시스템 통합 (Ecosystem Integrations)
| 프로젝트 | 통합 기능 |
|---|---|
| vLLM | GPU 메모리 제한을 갖춘 추론 서버 실행, 여러 모델이 하나의 GPU를 공유할 수 있도록 지원 |
| ... |
로드맵, 거버넌스 및 기여 (Roadmap, Governance, And Contributing)
HAMI는 유지보수자와 기여자에 의해 관리됩니다. 거버넌스는 HAMi 커뮤니티 리포지토리에서 설명합니다.
코드 기여(documentation, tests, or device backend improvements 등)를 하려면 CONTRIBUTING.md 파일을 참고하세요.
커뮤니티
HAMi 커뮤니티는 Kubernetes 기반 AI 인프라를 구축하는 사용자, 기여자, 하드웨어 벤더 및 플랫폼 팀을 환영합니다.
- 웹사이트: project-hami.io
- 디스코드: HAMi 디스코드 참여하기 (권장)
- 슬랙: #hami-dev on CNCF Slack
- 메일링 리스트: hami-project
- 회의록 및 안건
- 중국 커뮤니티 회의: 매주 금요일 16:00 UTC+8, 회의 링크
- 영어 커뮤니티 회의: 격주 수요일 16:00 UTC+8, 회의 링크
발표 및 참고 자료
| 이벤트 | 발표 내용 |
|---|---|
| CHINA CLOUD COMPUTING INFRASTRUCTURE DEVELOPER CONFERENCE, Beijing 2024 | k8s 클러스터에서 이종 AI 인프라 잠금 해제하기 |
| ... |
라이선스
HAMi는 Apache License 2.0에 따라 라이선스가 부여됩니다. 자세한 내용은 LICENSE를 참조하세요.
Copyright Contributors to HAMi, established as HAMi a Series of LF Projects, LLC.
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub Trending Go (weekly)의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기