
Gemma4.pas: Delphi로 구현된 Gemma 4 E4B를 위한 완전한 멀티모달 AI 추론 엔진
요약
Gemma4.pas는 Delphi 언어로만 작성된 완전한 멀티모달 AI 추론 엔진입니다. Google의 Gemma 4 E4B 모델을 로컬에서 실행하며, Python이나 외부 종속성 없이 단일 VPK 아카이브로 GPU 가속화가 가능합니다. 텍스트, 비전, 오디오, 비디오 등 다양한 모달리티를 지원하여 높은 개인 정보 보호와 독립적인 배포 환경에 최적화되어 있습니다.
핵심 포인트
- Delphi/Pascal 개발자를 위한 로컬 LLM 추론 엔진 제공
- Python이나 외부 종속성 없이 단일 파일로 GPU 가속화 가능
- 텍스트, 비전, 오디오, 비디오를 아우르는 완전한 멀티모달 지원
- 데이터가 장치를 벗어나지 않는 높은 개인 정보 보호 보장


Gemma4.pas란 무엇인가?
Google의 Gemma 4 E4B를 위한 완전한 멀티모달 AI 추론 엔진으로, Delphi로만 작성되었습니다. Python도 없고, C/C++도 없으며, llama.cpp 기반도 아닙니다. 서드파티 종속성(third-party dependencies)이 전혀 없습니다. 단일 VPK 아카이브를 로드하고 TInference.Generate를 호출하여 GPU에서 토큰을 스트리밍합니다.
uses
  Gemma4.Types,
  Gemma4.Inference;
...
Gemma4.pas는 전체 Gemma 4 E4B 모델을 실행합니다: 사고/추론 채널을 통한 텍스트 생성, 비전(vision), 오디오(audio), 그리고 비디오(video)를 모두 GPU의 Vulkan compute shaders를 통해 가속화합니다. 또한 시맨틱 검색 및 RAG를 위한 EmbeddingGemma-300m 인코더도 번들로 제공합니다. 이 엔진은 폐기된 체크포인트(abliterated checkpoint)—거절 행동(refusal behavior)이 제거됨—를 로드하여, 모델이 모든 합법적인 사용에 대해 진정으로 유용하게 유지되도록 합니다. 모든 것이 로컬에서 실행됩니다. 아무것도 장치를 벗어나지 않습니다.
🎬 미디어
<div align="center"> <br/>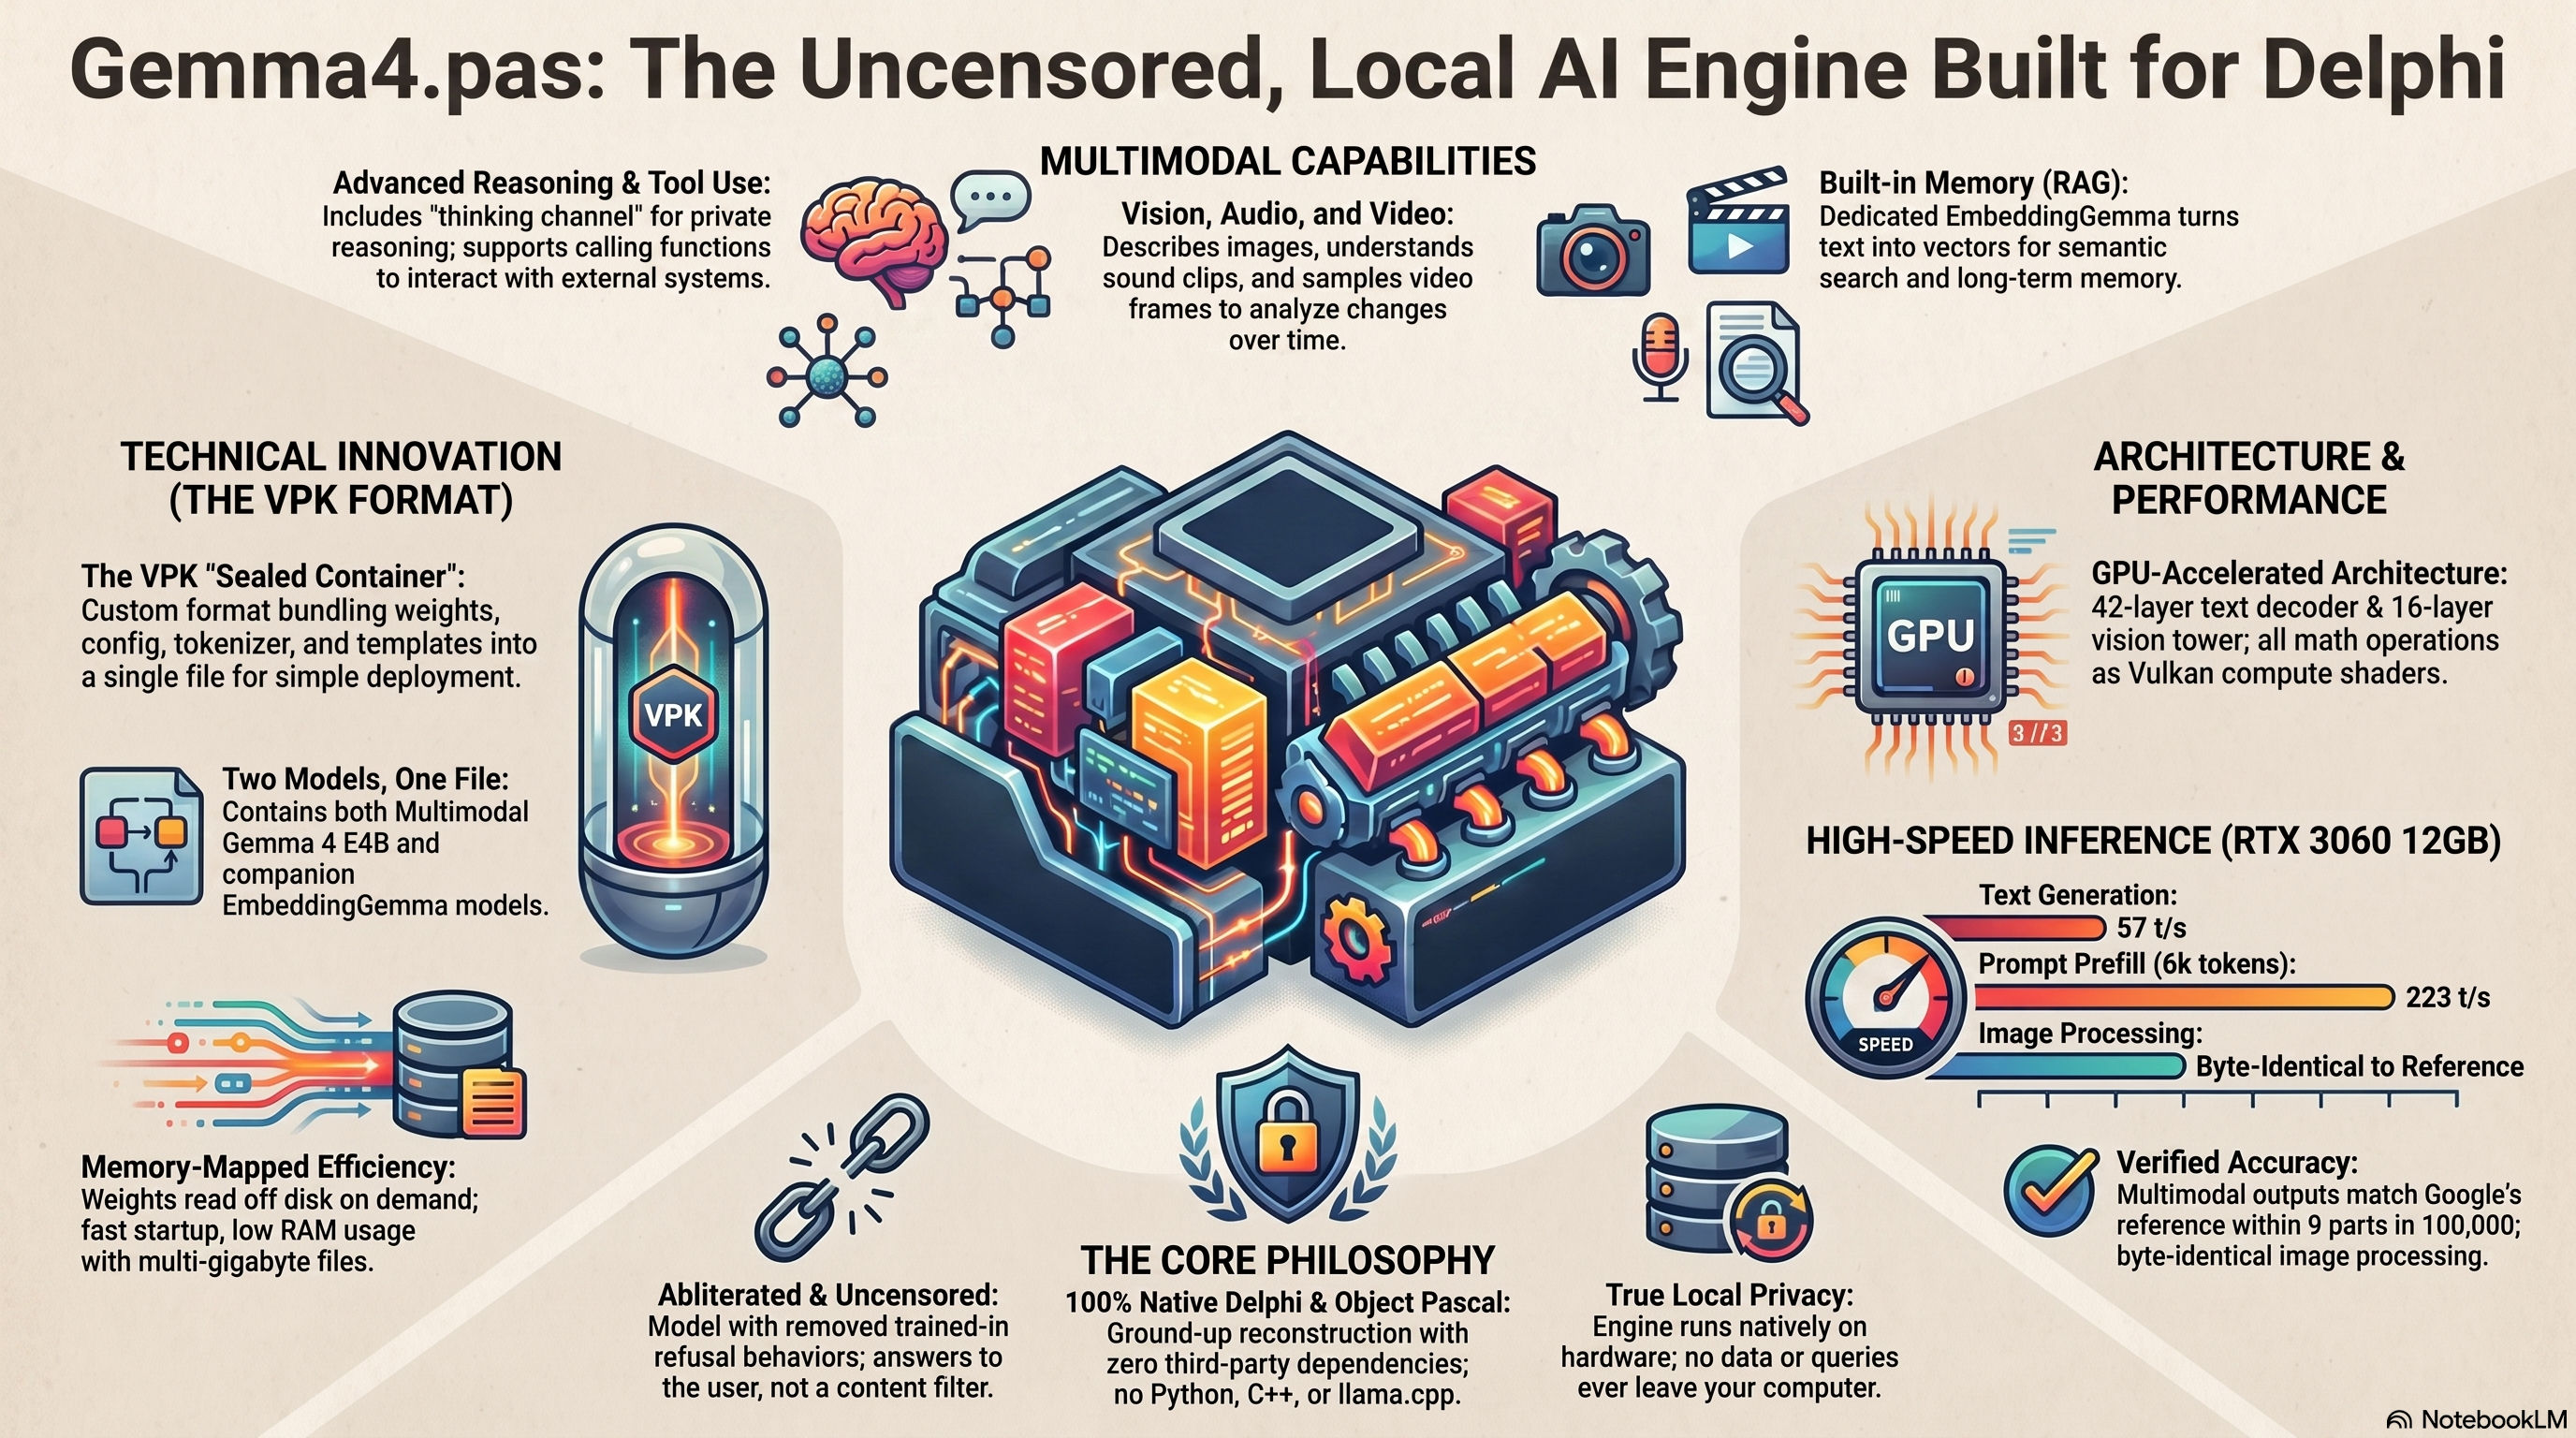
🎯 Gemma4.pas는 누구를 위한 것인가?
- Delphi 및 Pascal 개발자: Delphi 생태계를 벗어나거나 외부 런타임에 의존하지 않고 애플리케이션에 로컬 LLM 추론을 통합하려는 경우.
- 애플리케이션 개발자: 텍스트, 이미지, 오디오, 비디오, 임베딩 등 완전한 멀티모달 지원을 갖추고 소비자 하드웨어에서 실행되는 자체 포함형 단일 파일 AI 엔진이 필요한 경우.
- 개인 정보 보호에 민감한 사용자: 네트워크 호출이나 원격 측정(telemetry), 콘텐츠 필터링 없이 전적으로 자신의 장치에서 실행되는 모델이 필요한 경우.
✨ 주요 기능
- 텍스트 생성(Text generation): 설정 가능한 샘플링(temperature, top-k, top-p)을 사용한 스트리밍 토큰 출력과, 모델이 답변 전에 내부적으로 추론하는 사고/추론 채널을 제공합니다.
- 도구 사용(Tool use): 구조화된 도구 선언 및 완벽한 Jinja 채팅 템플릿 엔진을 통해 함수를 호출할 수 있습니다.
- 비전(Vision): 가변적인 상세 수준(70~1120 soft tokens)으로 이미지를 설명합니다. VCL Graphics 디코딩을 사용하며, 외부 이미지 라이브러리는 필요하지 않습니다.
- 오디오(Audio): WAV 파일(PCM16/F32, 모든 샘플링 속도)에서 음성과 소리를 이해합니다. 12개 레이어의 conformer 인코더를 사용합니다.
- 비디오(Video): 클립 전반에 걸쳐 프레임을 샘플링하고 시간적 콘텐츠를 설명합니다. Windows Media Foundation 프레임 추출을 사용하며, 비전 타워를 재사용합니다.
- 임베딩 및 RAG: 시맨틱 검색, 문서 검색 및 메모리를 위해 EmbeddingGemma-300m(24개 레이어 양방향, 768차원 출력)이 번들로 제공됩니다.
- 단일 파일 배포(Single-file deployment): 하나의 VPK 아카이브에 두 모델(Gemma 4 E4B + EmbeddingGemma-300m)을 모두 담아 메모리 매핑하여 실행할 준비가 되어 있습니다.
- 4비트 양자화(4-bit quantization): DP4A 정수 내적점을 가진 Q4_0 디코더 가중치를 사용하며, 비전/오디오/임베딩 인코더는 전체 F32 정밀도를 유지합니다.
- Vulkan 컴퓨팅: 모든 행렬 연산, 어텐션(attention), 소프트맥스(softmax), 정규화(normalization)가 컴파일된 SPIR-V 셰이더로 GPU에서 실행됩니다.
- 제로 의존성(Zero dependencies): 순수 Delphi를 사용하며, DLL이나 Python, C 런타임은 필요하지 않습니다.
애플리케이션 계층 (선택 사항)
엔진 위에 구축되었으며, 단순히 생성 기능만 필요한 경우 무시하기 쉽습니다:
- 도구 호출 (Tool calling): 유연한
TToolRegistry와 준비된 카탈로그(날씨, 웹 검색, 파일, Python)를 제공하여 모델이 함수를 호출하고 그 결과에 따라 행동할 수 있게 합니다. - 영속 메모리 (Persistent memory):
TMemory-- FTS5 키워드 검색과 HNSW 벡터 리콜을 결합한 SQLite 대화 아카이브(번들된 임베딩 모델 기반). - 무한 메모리 (Infinite memory): 이전 턴은 만료되기 전에 요약되어, 컨텍스트가 갑자기 끊어지지 않고 무기한으로 대화를 진행할 수 있습니다.
- 대화 정책 (Conversation policy):
TSession이 단일Ask호출 내에서 생성(generate) -> 실행(execute) -> 재생성(regenerate) 에이전트 루프, 리콜 주입(recall injection), 그리고 히스토리 예산 책정(history budgeting)을 구동합니다. - 대화형 채팅 (Interactive chat):
TChat/TConsoleChat-- 콘솔 프론트엔드와 전체 슬래시 명령어 세트를 갖춘 추상적인 채팅 루프입니다. - KV 상태 저장/로드: GPU KV 캐시(
.g4kv)를 영속화하고 복원하여 따뜻한 접두사(warm prefix)로 대화를 재개할 수 있습니다.
🚀 시작하기 (Getting Started)
모델 다운로드 (Download the Model)
HuggingFace에서 미리 패키징된 VPK 아카이브를 다운로드하세요:
이 파일을 C:\Dev\LLM\VPK\Gemma4.vpk에 배치하세요. 이것은 테스트베드 데모가 찾는 기본 경로입니다. 다른 곳에 배치할 경우, 코드의 경로 상수(path constant)를 변경해야 합니다.
테스트베드 실행 (Run the Testbed)
- 저장소를 클론합니다:
git clone https://github.com/tinyBigGAMES/Gemma4.pas.git - Delphi 12 Athens 이상에서
projects\Testbed\Testbed.dproj를 엽니다. - 빌드하고 실행합니다 (Win64 타겟).
- 테스트베드 메뉴에는 네 가지 데모가 제공됩니다: Pack, Inference, Embedding, 그리고 Multimedia
최소 예제 (Minimal Example)
LInf := TInference.Create();
try
  LInf.LoadModel('C:\Dev\LLM\VPK\Gemma4.vpk');
...
모델의 채팅 템플릿이 자동으로 적용됩니다 -- 프롬프트 텍스트를 수동으로 구성할 필요가 없습니다. 다중 턴 대화의 경우, 응답을 다시 공급하세요:
LInf.AddMessage(CRoleAssistant, LInf.ResponseText);
LInf.AddMessage(CRoleUser, 'Tell me more.');
LInf.Generate(1024);
멀티모달 (Multimodal)
이미지, 오디오 및 비디오는 일급 메시지 파트입니다:
// Image (모델 카드에 명시된 텍스트 이전의 이미지)
LInf.AddMessage(CRoleUser, [
  TMessagePart.ImagePart('photo.png'),
...
임베딩(Embeddings)
LEmb := TEmbeddings.Create();
try
  LEmb.Open('C:\\\Dev\LLM\VPK\Gemma4.vpk');
...
🧰 애플리케이션 계층(Application Layer)
원시 엔진을 에이전트 또는 어시스턴트로 변환합니다. 도구를 등록하고 TSession에 전달하면, 하나의 Ask 호출로 전체 generate -> execute -> regenerate 루프가 실행됩니다:
uses
  Gemma4.Inference, Gemma4.Tools, Gemma4.Tools.Utils, Gemma4.Session;

...
지속적인 회상을 위해 TMemory를 연결하거나 (SQLite + FTS5 + HNSW), 슬래시 명령어(/addfact, /addfile, /summary, /state, /restore, ...)가 있는 완전한 대화형 어시스턴트인 TConsoleChat으로 바로 넘어갈 수 있습니다:
LChat := TConsoleChat.Create();
try
  LChat.ModelPath := 'C:\\Dev\LLM\VPK\Gemma4.vpk';
...
[!NOTE]
web_search도구는 Tavily API를 사용합니다. 이는 선택 사항이며, 다른 모든 것은 키 없이 작동합니다. 활성화하려면 무료 Tavily 키(월 1000 크레딧; pricing 참조)를 생성하고TAVILY_API_KEY환경 변수를 설정하십시오.
⚡ 성능(Performance)
NVIDIA RTX 3060 (12 GB VRAM)에서 측정:
| 지표(Metric) | 값(Value) |
|---|---|
| 텍스트 생성(Text generation) | ~57 tokens/sec |
| ... |
📖 문서화(Documentation)
전체 API 레퍼런스, 아키텍처 가이드 및 사용 방법 레시피는 단일 문서에 포함되어 있습니다:
| 문서(Document) | 설명(Description) |
|---|---|
| Gemma4.pas Documentation | 전체 투어: TInference API (로딩, 메시지, 생성, 사고 과정, 멀티모달, 통계), TEmbeddings API, 애플리케이션 계층 (도구, TMemory, THNSW, TSession, TChat, KV 상태), 아키텍처 (42개 레이어 디코더, Vulkan 파이프라인, Q4_0 양자화, VPK 형식, 비전/오디오/비디오 인코더, 임베딩 모델), 그리고 검증된 테스트베드 코드를 포함한 실용적인 사용 방법 레시피. |
🗂️ 모듈 맵(Module Map)
추론 엔진(Inference engine)
| Unit | 역할 |
|---|---|
Gemma4.Types | 공유 타입(Shared types), 레코드(records), 상수(constants), 열거형(enums) |
| ... | |
애플리케이션 계층 (Application layer) (선택 사항, Gemma4.Inference를 기반으로 빌드) |
| Unit | 역할 |
|---|---|
Gemma4.Common | 공유 리소스 경로 해석 및 상수(Shared resource-path resolution and constants) |
| ... |
🔨 소스 코드에서 빌드하기 (Building from Source)
전제 조건 (Prerequisites)
| 요구 사항 | |
|---|---|
| 호스트 OS | Windows x64 |
| ... |
소스 코드 받기 (Get the Source)
git clone https://github.com/tinyBigGAMES/Gemma4.pas.git
컴파일하기 (Compile)
- Delphi 12 Athens 이상 버전에서
projects estbed estbed.dproj열기 - 빌드 (Win64 타겟)
- Gemma4.vpk를
C:\Dev\\\LLM\VPK\Gemma4.vpk로 다운로드하기 - 테스트베드를 실행합니다 -- 추론(Inference), 임베딩(Embedding), 멀티미디어(Multimedia), 패키지(Pack) 데모를 제공합니다
🤝 기여 (Contributing)
Gemma4.pas는 오픈 프로젝트이며 모든 수준에서 기여를 환영합니다:
- 버그 보고: 최소 재현 사례, 사용된 정확한 코드, 그리고 GPU 모델을 포함하여 이슈(issue)를 생성하세요.
- 기능 제안: 먼저 사용 사례(use case)를 설명하고, 그 다음 제안하는 API나 동작 방식을 기술하세요.
- 풀 리퀘스트 제출 (Submit pull requests): 버그 수정, 문서 개선, 새로운 테스트 케이스, 그리고 범위가 잘 정의된 기능들을 제출하세요.
개발 논의에 참여하거나 질문을 하거나 Gemma4.pas로 만들고 있는 것을 공유하려면 Discord에 참여하세요.
💙 프로젝트 지원 (Support the Project)
만약 Gemma4.pas가 시간을 절약해주거나, 아이디어를 촉발시키거나, 여러분이 배포하는 무언가의 일부가 된다면:
- :star: 저장소 별표 표시: 비용이 들지 않으며 다른 사람들이 프로젝트를 찾도록 도와줍니다
- :speech_balloon: 정보 공유하기: 게시물을 작성하거나 속한 커뮤니티에 언급해 주세요
- :busts_in_silhouette: Discord에서 참여하기: 만들고 있는 것을 공유하고 다음에 올 내용을 만드는 데 도움을 주세요
- :sparkling_heart: 스폰서가 되기: 스폰서십은 개발 및 문서화에 직접 자금을 지원합니다
- :butterfly: Bluesky에서 팔로우하기: 출시 및 개발 소식을 계속 받아보세요.
📄 라이선스
Gemma4.pas는 Apache License 2.0에 따라 라이선스가 부여되었습니다. 자세한 내용은 LICENSE를 참조하세요.
Apache 2.0은 개방형 소스 및 상업적 프로젝트 모두에서 StdApp을 자유롭게 사용, 수정 및 배포할 수 있게 해주는 관대한 오픈소스 라이선스입니다. 자체 소스 코드를 공개해야 할 의무는 없습니다. 이 라이선스에는 명시적인 특허 부여가 포함됩니다. 출처 표기가 필요하며, 저작권 고지 및 라이선스 파일을 유지해야 합니다.
🔗 링크
<div align="center">Gemma4.pas™ - Pascal에서 로컬 LLM 추론.
Copyright © 2026-present tinyBigGAMES™ LLC
All Rights Reserved.
AI 자동 생성 콘텐츠
본 콘텐츠는 GitHub ML Hardware의 원문을 AI가 자동으로 요약·번역·분석한 것입니다. 원 저작권은 원저작자에게 있으며, 정확한 내용은 반드시 원문을 확인해 주세요.
원문 바로가기